Im vorherigen Artikel habe ich dir gezeigt, dass es seit Java 9 keine Rolle mehr spielt, ob du ein int mit String.valueOf(i) oder mit "" + i in einen String umwandelst – und dass String.format() dafür die falsche Methode ist.
Heute geht es in die entgegengesetzte Richtung: Was ist beim Parsen von Strings in ints zu beachten? Den Quellcode zum Artikel findest du in meinem GitHub-Repository.
Zahlen im Dezimalsystem parsen
Schauen wir uns zunächst einmal die Möglichkeiten an, einen String in ein int (bzw. Integer) zu parsen. Die beiden klassischen Methoden, die es seit Java 1.0 gibt:
Die zweite Methode ruft intern die erste Methode auf und verpackt das Ergebnis in ein Integer-Objekt.
Der übergebene String darf nur Ziffern enthalten, optional mit einem vorangestellten Plus- oder Minuszeichen. Folgendes ist also erlaubt:
Integer.parseInt("47")Integer.parseInt("+86400")Integer.parseInt("-1")
Folgende Aufrufe hingegen führen zu einer NumberFormatException:
Integer.parseInt("") // Leerer String nicht erlaubtInteger.parseInt(null) // NumberFormatException, keine NullPointerExceptionInteger.parseInt(" 1") // Leerzeichen nicht erlaubtInteger.parseInt("3,14") // Komma nicht erlaubtInteger.parseInt("1.000") // Tausender-Punkt nicht erlaubtInteger.parseInt("1_000") // Unterstrich nur im Literal
Den Unterstrich als Tausendertrenner erlaubt Java seit Version 7 nur in Zahlenliteralen wie 1_000 – für Integer.parseInt() bleibt er ein ungültiges Zeichen.
Hexadezimal- und Binärzahlen parsen
Die zuvor genannten Methoden parsen Dezimalzahlen. Um andere Zahlensysteme zu parsen, stehen folgende überladene Methoden zur Verfügung:
Der Parameter radix gibt dabei die Basis des Zahlensystems an. Eine hexadezimale Zahl parst du z. B. so:
Integer.parseInt("CAFE", 16)
Und eine Binärzahl so:
Integer.parseInt("101111", 2)
Seit Java 9 gibt es außerdem Integer.parseInt(s, beginIndex, endIndex, radix) (→ JavaDoc). Die Methode parst einen Ausschnitt aus dem String, ohne dass du vorher mit substring() ein neues String-Objekt erzeugen musst: Integer.parseInt("Port: 8080", 6, 10, 10) liefert 8080. Für parseUnsignedInt(), das ich dir im nächsten Abschnitt zeige, gibt es dieselbe Variante.
Integer.decode() (→ JavaDoc) erkennt die Basis am Präfix: Integer.decode("0xCAFE") und Integer.decode("#CAFE") ergeben beide 51.966. Vorsicht bei einer führenden Null: Wie im Java-Quellcode steht sie für eine Oktalzahl. Integer.decode("010") ergibt deshalb 8 – und Integer.decode("09") wirft eine NumberFormatException, weil 9 keine Oktalziffer ist.
Java 17 hat mit HexFormat (→ JavaDoc) eine weitere Klasse gebracht, gedacht vor allem für die Umwandlung zwischen byte-Arrays und hexadezimalen Strings: HexFormat.of().parseHex("cafebabe") liefert ein byte-Array mit vier Bytes. Für einzelne Zahlen hat sie statische Methoden: HexFormat.fromHexDigits("CAFE") liefert 51.966, HexFormat.fromHexDigitsToLong(s) ein long, und eine Variante mit Start- und Endindex parst einen Ausschnitt. Anders als parseInt() akzeptiert sie weder Vorzeichen noch Präfix – 0x führt zu einer NumberFormatException –, sondern höchstens acht Hex-Ziffern, die sie als Bitmuster liest. Was das für CAFEBABE bedeutet, siehst du im nächsten Abschnitt.
Signed vs. unsigned ints
In allen vorgenannten Fällen muss die zu parsende Zahl im Bereich Integer.MIN_VALUE (= -2³¹ = -2.147.483.648) bis Integer.MAX_VALUE (= 2³¹ - 1 = 2.147.483.647) liegen.
Interessant (um nicht zu sagen: verwirrend) wird es, wenn du z. B. den gültigen int-Wert 0xCAFEBABE (die magische Zahl für Java-Klassendateien) in einen hexadezimalen String umwandelst und dann zurück in ein int:
int hex = 0xCAFEBABE;
String s = Integer.toHexString(hex);
int i = Integer.parseInt(s, 16);
Dieser Versuch führt zu folgendem Fehler (den Zusatz „under radix 16“ gibt es seit Java 12):
java.lang.NumberFormatException: For input string: "cafebabe" under radix 16Warum ist das so?
Zunächst einmal: Die Variable s enthält wie erwartet cafebabe. Warum kann dieser String nicht zurück in ein int umgewandelt werden?
Der Grund ist, dass die parseInt()-Methode davon ausgeht, dass die übergebene Zahl positiv ist, sofern ihr nicht ein Minuszeichen vorangestellt ist. Konvertierst du cafebabe ins Dezimalsystem, erhältst du 3.405.691.582. Diese Zahl ist größer als Integer.MAX_VALUE und kann somit nicht als int dargestellt werden.
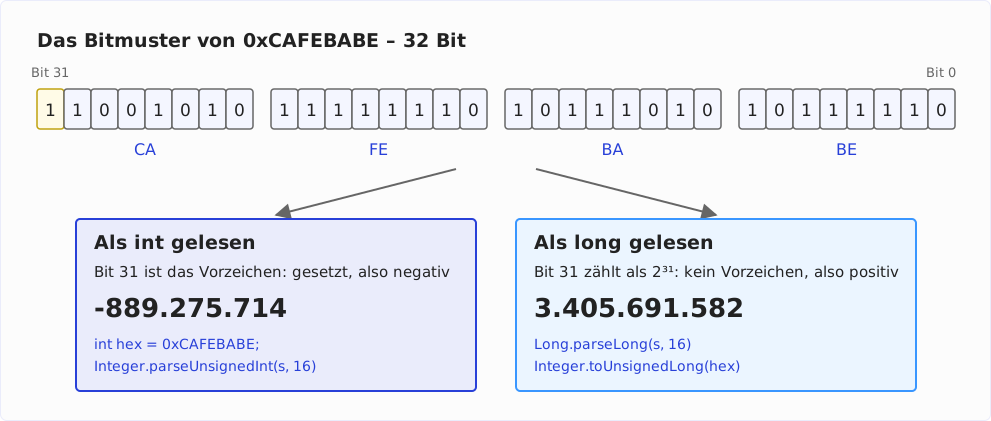
Warum aber können wir die Zahl dann der int-Variablen hex zuweisen? Hier spielt uns die Binärdarstellung der Zahlen einen (beabsichtigten) Streich. 0xCAFEBABE entspricht binär 11001010 11111110 10111010 10111110 – einer 32-stelligen Binärzahl, deren erstes Bit eine 1 ist. Bei einem – in Java immer vorzeichenbehafteten – int steht das erste Bit für das Vorzeichen. Steht dort eine 1, ist die Zahl negativ (für Details zur Darstellung negativer Zahlen verweise ich auf diesen Wikipedia-Artikel). Erweitern wir den Code oben wie folgt um Debug-Ausgaben:
int hex = 0xCAFEBABE;
System.out.println("hex        = " + hex);
System.out.println("hex binary = " + Integer.toBinaryString(hex));

String s = Integer.toHexString(hex);
System.out.println("s          = " + s);

int i = Integer.parseInt(s, 16);
System.out.println("i          = " + i);
Dann sehen wir, dass hex den negativen Wert -889.275.714 enthält (die Tausenderpunkte habe ich hier der Übersicht halber eingefügt). Hexadezimal wird diese negative Zahl als positiver Wert cafebabe dargestellt, der wiederum durch die parseInt()-Methode nicht zurückgewandelt werden kann.
Um dies doch noch zu ermöglichen, wurden in Java 8 folgende Methoden hinzugefügt:
int i = Integer.parseUnsignedInt(s);(→ JavaDoc)int i = Integer.parseUnsignedInt(s, radix);(→ JavaDoc)
Diese Methoden erlauben uns, Zahlen im Bereich 0 bis 4.294.967.295 (= 0xffffffff hexadezimal bzw. 32 Einsen im Binärsystem) zu parsen. Ab Java 8 können wir somit die vorletzte Zeile des obigen Beispiels wie folgt anpassen:
int i = Integer.parseUnsignedInt(s, 16);Als Ausgabe erhalten wir aber nicht etwa 3.405.691.582 – sondern, da int in Java nun eben immer signed (vorzeichenbehaftet) ist: -889.275.714, also denjenigen int-Wert, den wir auch erhalten, wenn wir 0xCAFEBABE einem int zuweisen. Dasselbe Ergebnis liefert übrigens HexFormat.fromHexDigits(s) aus Java 17: Die Methode liest die acht Hex-Ziffern als Bitmuster und fragt nicht nach dem Vorzeichen.
Und wie kommen wir an die 3.405.691.582? Seit Java 8 direkt aus dem int: Integer.toUnsignedLong(i) (→ JavaDoc) liefert 3.405.691.582 als long, Integer.toUnsignedString(i) als String. Oder du parst cafebabe (oder CAFEBABE – die Groß-/Kleinschreibung ist unbedeutend) gleich in ein long:
long l = Long.parseLong(s, 16);Und wie sieht 3.405.691.582 in Binär- und Hexadezimaldarstellung aus?
System.out.println("l binary = " + Long.toBinaryString(l));
System.out.println("l hex    = " + Long.toHexString(l));
Wir erhalten wiederum die gleichen Darstellungen wie für den int-Wert -889.275.714, also 11001010 11111110 10111010 10111110 und cafebabe. Ein- und dieselbe Binär- bzw. Hexadezimalzahl führt also – je nachdem, ob sie in einem int oder einem long gespeichert wird – zu einer unterschiedlichen Dezimalzahl (sofern sie größer ist als Integer.MAX_VALUE). Die folgende Grafik zeigt das Bitmuster von 0xCAFEBABE und seine beiden Lesarten:
Im folgenden Abschnitt schauen wir uns das noch einmal an weiteren Beispielen an.
parseInt() vs. parseUnsignedInt()
Um den Unterschied zwischen parseInt() und parseUnsignedInt() noch einmal zu verdeutlichen, habe ich ein kleines Programm geschrieben, das du hier in meinem GitHub-Repository findest und das verschiedene (Grenz-)Werte mit beiden Methoden parst.
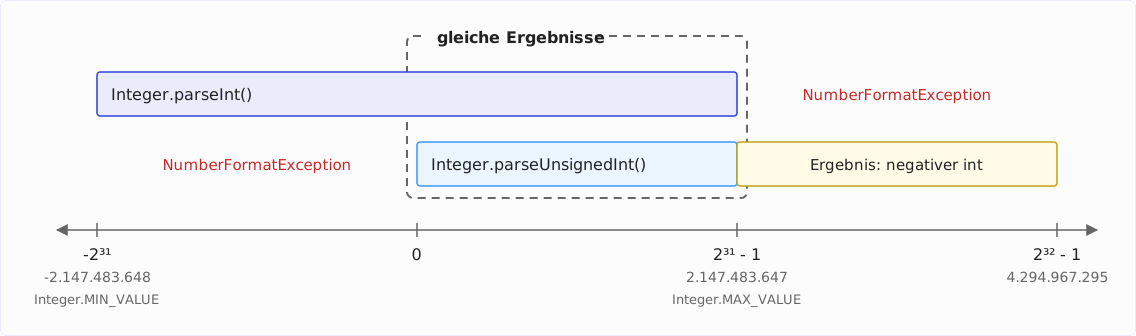
Die beiden Methoden decken unterschiedliche Wertebereiche ab, die sich von 0 bis Integer.MAX_VALUE überlappen:
Hier das Ergebnis des Programms zusammengefasst (✗ steht für eine NumberFormatException):
String | Bemerkung | parseInt() | → Hex | parseUnsignedInt() | → Hex |
|---|---|---|---|---|---|
| -2147483649 | MIN_VALUE - 1 | ✗ | ✗ | ✗ | ✗ |
| -2147483648 | MIN_VALUE | -2147483648 | 80000000 | ✗ | ✗ |
| -1000000000 | -1000000000 | c4653600 | ✗ | ✗ | |
| -1 | -1 | ffffffff | ✗ | ✗ | |
| 0 | 0 | 0 | 0 | 0 | |
| 1000000000 | 1000000000 | 3b9aca00 | 1000000000 | 3b9aca00 | |
| 2147483647 | MAX_VALUE | 2147483647 | 7fffffff | 2147483647 | 7fffffff |
| 2147483648 | MAX_VALUE + 1 | ✗ | ✗ | -2147483648 | 80000000 |
| 3000000000 | ✗ | ✗ | -1294967296 | b2d05e00 | |
| 4294967295 | 2 * MAX_VALUE + 1 | ✗ | ✗ | -1 | ffffffff |
| 4294967296 | 2 * MAX_VALUE + 2 | ✗ | ✗ | ✗ | ✗ |
Hier ist noch einmal schön zu sehen:
- Im Bereich
0bisInteger.MAX_VALUEliefernparseInt()undparseUnsignedInt()die gleichen Ergebnisse. parseInt()deckt darüber hinaus den Bereich bisInteger.MIN_VALUEab und liefert exakt den Wert, der übergeben wurde.parseUnsignedInt()deckt hingegen den Bereich bis2 * Integer.MAX_VALUE + 1mit ab – das Ergebnis ist jedoch im Bereich überInteger.MAX_VALUEimmer eine negative Zahl. Deren hexadezimale Darstellung entspricht, umgerechnet ins Dezimalsystem, wiederum dem Eingabewert.
Auto-Boxing und -Unboxing des Ergebnisses
Wir haben oben gesehen, dass es separate Methoden gibt, um Strings in ein int bzw. ein Integer-Objekt zu konvertieren. Doch was passiert, wenn wir die falsche Methode anwenden?
Integer i = Integer.parseInt("42");int i = Integer.valueOf("555");
Der erste Fall ist nicht besonders elegant, stellt aber kein Problem dar: Integer.parseInt() arbeitet intern mit primitiven Werten und das Ergebnis wird – genau wie bei Integer.valueOf() – letztlich durch Auto-Boxing in ein Integer-Objekt umgewandelt.
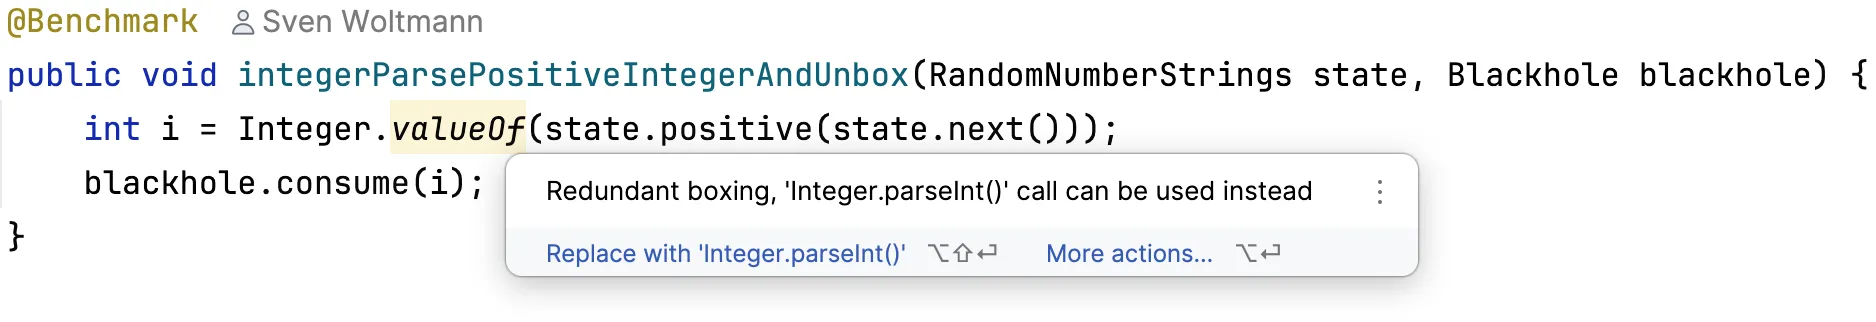
Anders sieht es im zweiten Fall aus: Hier wird das Ergebnis innerhalb von Integer.valueOf() in ein Integer-Objekt umgewandelt und dann bei der Zuweisung an i wieder zurück in ein int-Primitiv. Das ist der Unterschied zum ersten Fall: Dort gibt es eine Umwandlung, und die ist nötig – ein Integer entsteht nur durch Boxing. Hier sind es zwei, die sich gegenseitig aufheben. Genau dieses Paar meldet IntelliJ als redundant und empfiehlt, valueOf() durch parseInt() zu ersetzen:
Ob HotSpot uns diesen Umweg verzeiht, prüfen wir im nächsten Kapitel mit dem Profiler.
Performance der String-zu-int-Umwandlung
Gemessen habe ich mit dem Java Microbenchmark Harness (JMH), mit demselben Aufbau wie im Schwesterartikel: zwei Rechner – ein Dell XPS 17 mit Intel Core i7-12700H (x86) unter WSL2 und ein Mac mit Apple M5 Pro (arm64) –, Java 8 bis 27, drei Forks mit je fünf Aufwärm- und fünf Messiterationen, dazu der GC-Profiler für die allokierten Bytes pro Aufruf. Jede Version habe ich mehrfach gemessen, fünfmal auf dem i7 und viermal auf dem M5 Pro; die Tabellen zeigen den Mittelwert. Warum das nötig ist und wann ich einen Unterschied zwischen zwei Versionen überhaupt einen Unterschied nenne, steht in der Info-Box im Schwesterartikel.
Drei Fragen wollte ich beantworten:
- Unterscheiden sich die Parse-Methoden – positive, negative, vorzeichenlose Zahlen?
- Was kostet das Boxing in ein
Integer? - Wie hat sich
Integer.parseInt()von Java 8 bis 27 entwickelt?
Der Benchmark
Den Benchmark findest du in meinem GitHub-Repository. Hier ein Ausschnitt mit drei der acht Methoden:
public class StringToIntMultiBenchmark {

  @Benchmark
  public void integerParsePositiveInt(RandomNumberStrings state,
      Blackhole blackhole) {
    int i = Integer.parseInt(state.positive(state.next()));
    blackhole.consume(i);
  }

  @Benchmark
  public void integerParsePositiveInteger(RandomNumberStrings state,
      Blackhole blackhole) {
    Integer i = Integer.valueOf(state.positive(state.next()));
    blackhole.consume(i);
  }

  @Benchmark
  public void integerParsePositiveIntegerAndUnbox(RandomNumberStrings state,
      Blackhole blackhole) {
    int i = Integer.valueOf(state.positive(state.next()));
    blackhole.consume(i);
  }

}
Der State liefert 1.024 zufällige siebenstellige Zahlen als Strings – einmal pur, einmal mit Plus, einmal mit Minus – und wird einmal pro Messlauf gefüllt:
@State(Scope.Thread)
public class RandomNumberStrings {

  private static final int SIZE = 1024;

  private final String[] positive = new String[SIZE];
  private final String[] positiveWithPlus = new String[SIZE];
  private final String[] negative = new String[SIZE];
  private int index;

  @Setup(Level.Trial)
  public void doSetup() {
    ThreadLocalRandom random = ThreadLocalRandom.current();
    for (int k = 0; k < SIZE; k++) {
      String digits = Integer.toString(1_000_000 + random.nextInt(9_000_000));
      positive[k] = digits;
      positiveWithPlus[k] = "+" + digits;
      negative[k] = "-" + digits;
    }
  }

  public int next() {
    return index++ & (SIZE - 1);
  }

  public String positive(int k) {
    return positive[k];
  }

  // positiveWithPlus(int k) und negative(int k) analog

}
Warum die Zahlen einmal pro Messlauf gezogen werden und nicht vor jedem Aufruf, erkläre ich in der Info-Box im Schwesterartikel. Kurzfassung: Ein Parse-Aufruf dauert fünf bis acht Nanosekunden, und ein Setup pro Aufruf würde JMH zwingen, jeden einzelnen Aufruf mit Zeitstempeln zu umrahmen – dann misst man die Uhr statt des Parsers. Die Messungen der ersten Fassung dieses Artikels hatten genau diesen Fehler.
Die Parse-Methoden im Vergleich
Alle acht Methoden auf Java 27: die Zeit pro Aufruf in Nanosekunden, gemittelt über zwei JMH-Läufe pro Rechner mit je drei Forks und fünf Messiterationen, und, in der letzten Spalte, die Bytes, die ein Aufruf allokiert – die Zahl, auf die es im übernächsten Abschnitt ankommt. Die Rohdaten mit Fehlerintervallen liegen als JMH-JSON im results/-Verzeichnis des Benchmark-Repositorys.
| Methode | x86 | arm64 | Bytes pro Aufruf |
|---|---|---|---|
parseInt(), positiver Wert | 7,4 | 5,4 | 0 |
parseInt(), positiver Wert mit Plus | 7,1 | 5,4 | 0 |
parseInt(), negativer Wert | 7,0 | 5,2 | 0 |
parseUnsignedInt(), positiver Wert | 6,9 | 5,1 | 0 |
parseUnsignedInt(), positiver Wert mit Plus | 7,4 | 5,2 | 0 |
parseInt() mit anschließendem Boxing | 7,5 | 5,8 | 16 |
valueOf(), positiver Wert | 7,6 | 5,8 | 16 |
valueOf() mit anschließendem Unboxing | 7,3 | 5,4 | 0 |
Das Diagramm zeigt die Zeiten; die Bytes stehen nur in der Tabelle.
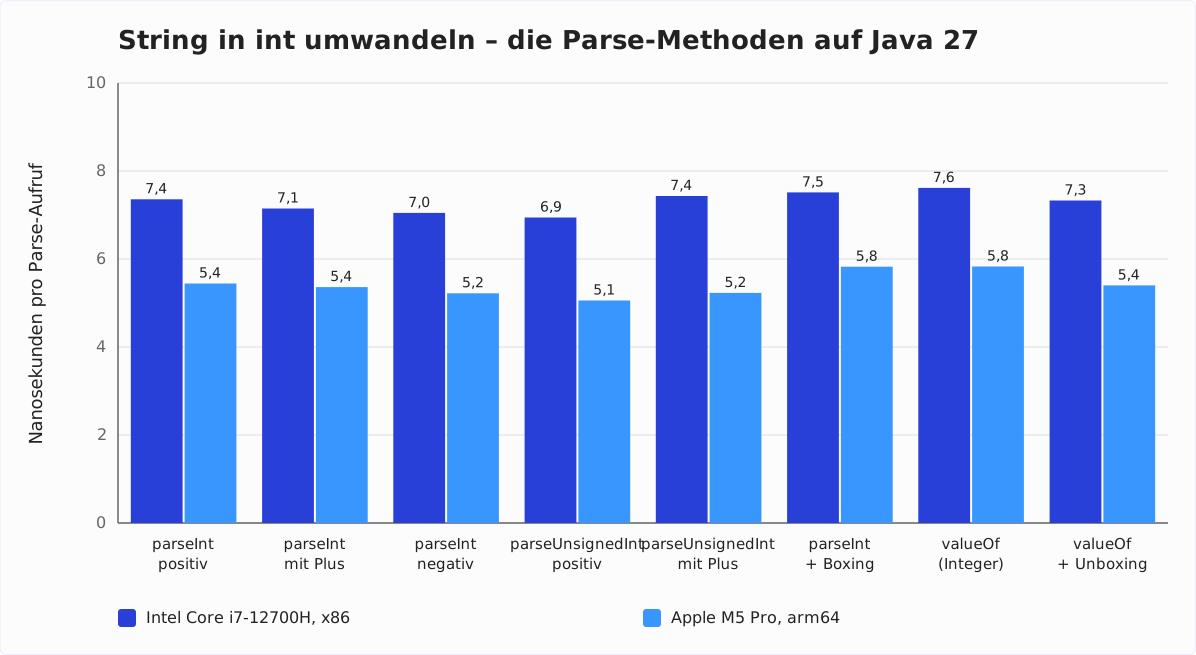
Die fünf Zeilen ohne Boxing – parseInt() und parseUnsignedInt() in allen Vorzeichen-Varianten – liegen dicht beieinander: 6,9 bis 7,4 ns auf dem i7, 5,1 bis 5,4 ns auf dem M5 Pro. Auf jedem der beiden Rechner liegen die fünf Werte also innerhalb einer halben Nanosekunde, und zwei Läufe pro Methode können in einem so schmalen Band keine Rangfolge belegen. Dass die Unterschiede Rauschen sind und keine Eigenschaft der Methoden, siehst du auch daran, dass die Reihenfolge auf den beiden Rechnern nicht dieselbe ist: parseInt() mit positivem Wert ist auf dem M5 Pro die langsamste der fünf, parseUnsignedInt() mit Plus auf dem i7.
Das ist auch zu erwarten, denn der Code dahinter ist praktisch derselbe. parseUnsignedInt() hat zwar eine eigene Ziffernschleife, sie unterscheidet sich von der in parseInt() aber nur in der Überlaufprüfung – die eine rechnet vorzeichenbehaftet, die andere vorzeichenlos. Und ob ein Plus, ein Minus oder gar kein Vorzeichen vor der Zahl steht, kostet eine Verzweigung, die der Branch Predictor nach dem ersten Durchlauf kennt.
Was Boxing kostet
Die drei Zeilen mit Boxing – parseInt() mit anschließendem Boxing, valueOf() und valueOf() mit anschließendem Unboxing – erzählen eine andere Geschichte als die erste Fassung dieses Artikels.
Integer.valueOf(s) liefert ein Integer-Objekt. Für Werte außerhalb des Caches von -128 bis 127 – also für alle unsere siebenstelligen Zahlen – muss es allokiert werden: 16 Bytes pro Aufruf, die der GC-Profiler auch zeigt. Auf dem M5 Pro kostet das 7 % Zeit – 5,8 statt 5,4 ns –, auf dem i7 zwei bis vier Prozent. Ob du Integer.valueOf(s) schreibst oder Integer i = Integer.parseInt(s): Es ist dasselbe Boxing, mit denselben 16 Bytes.
Und der Umweg int i = Integer.valueOf(s), also Boxing mit sofortigem Unboxing? Der kostet nichts. Null Bytes pro Aufruf, und die Zeit ist von parseInt() nicht zu unterscheiden. HotSpot erkennt, dass das Integer-Objekt die Methode nie verlässt, und lässt die Allokation weg – das nennt sich Escape-Analyse.
Die Empfehlung von 2019 – „achte darauf, nicht unnötig zu boxen“ – bleibt trotzdem richtig, nur aus einem anderen Grund: Lesbarkeit. Wer ein int braucht, schreibt parseInt(); wer ein Integer braucht, valueOf(). Die IntelliJ-Warnung von oben hat also recht, auch wenn HotSpot den Umweg wegoptimiert.
Integer.parseInt() von Java 8 bis 27
Die drei Boxing-Varianten rufen am Ende Integer.parseInt() auf, und die fünf Varianten ohne Boxing liegen, wie oben gezeigt, dicht beieinander. Deshalb habe ich stellvertretend Integer.parseInt() mit positivem Wert über die Java-Versionen gemessen – Nanosekunden pro Aufruf:
| Architektur | Java 8 | Java 11 | Java 17 | Java 21 | Java 22 | Java 23 | Java 24 | Java 25 | Java 27 |
|---|---|---|---|---|---|---|---|---|---|
| x86 | 13,9 | 9,2 | 9,0 | 8,2 | 7,8 | 7,2 | 7,2 | 7,5 | 7,4 |
| arm64 | 7,2 | 5,6 | 5,9 | 6,0 | 5,4 | 5,4 | 5,3 | 5,3 | 5,5 |
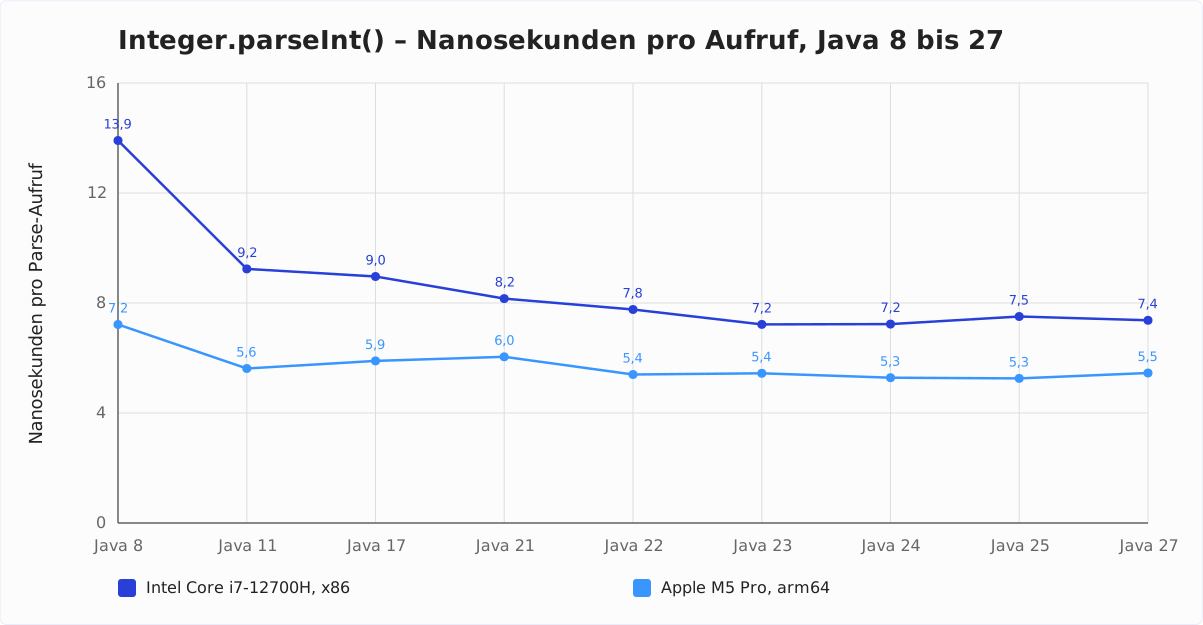
Den großen Schritt siehst du zwischen Java 8 und 11: 34 % weniger Zeit auf x86, 22 % auf arm64. Danach gehen die beiden Rechner verschiedene Wege. Auf dem i7 fällt die Zeit bis Java 23 in jedem Schritt – um 3, 9, 5 und 7 % –, danach passiert nichts mehr, was sich mit fünf Durchläufen vom Messrauschen unterscheiden ließe: Java 23, 24, 25 und 27 liegen innerhalb ihrer Streuung.
Auf dem M5 Pro geht es auf und ab: Java 17 ist 5 % langsamer als 11, Java 21 noch einmal 3 % langsamer, Java 22 macht das mit 11 % mehr als wett – und Java 27 ist 3,7 % langsamer als Java 25, über vier Durchläufe hinweg eindeutig. Von Java 8 bis 27 hat sich die Zeit für parseInt() auf x86 fast halbiert, auf arm64 um ein Viertel verringert.
Am Parser selbst hat sich in dieser Zeit wenig getan. Der größte Teil des Gewinns kommt von den Compact Strings (JEP 254), mit denen Java 9 Strings aus Latin-1-Zeichen in einem byte-Array statt einem char-Array speichert – halb so viele Bytes pro Zeichen, die der Parser lesen muss. Das lässt sich nachmessen, indem man Compact Strings mit der JVM-Option -XX:-CompactStrings abschaltet – in einer eigenen Messreihe, jeweils gegen einen Lauf mit eingeschalteten Compact Strings: parseInt() braucht dann auf dem M5 Pro 6,8 statt 5,7 ns auf Java 11 und 6,8 statt 5,4 ns auf Java 25 – fast wieder das Java-8-Niveau von 7,2 ns.
Der Rest des Gewinns kommt vom JIT-Compiler – und von dort müssen auch die kleinen Verlangsamungen auf dem M5 Pro auf Java 17, 21 und 27 kommen; untersucht habe ich sie nicht. Die erste Fassung dieses Artikels hatte übrigens gemessen, dass parseInt() in Java 9 und 10 langsamer geworden sei – das war der Messfehler mit dem Setup pro Aufruf, nicht Java.
Zusammenfassung
Zahlen im Dezimalsystem parst du mit parseInt(), andere Zahlensysteme über den radix-Parameter, Teilstrings seit Java 9 über die Variante mit Start- und Endindex. parseUnsignedInt() deckt den Bereich bis 4.294.967.295 ab – liefert aber oberhalb von Integer.MAX_VALUE einen negativen int, dessen Bitmuster dem Eingabewert entspricht.
Alle Parse-Methoden sind gleich schnell: fünf bis acht Nanosekunden je nach Rechner. Boxing in ein Integer allokiert 16 Bytes pro Aufruf und kostet zwei bis sieben Prozent Zeit, je nach Rechner; den Umweg über Boxing und Unboxing in ein int optimiert HotSpot weg. Ich empfehle trotzdem: parseInt() für ein int, valueOf() für ein Integer – nicht wegen der Nanosekunden, sondern weil der Code dann sagt, was er tut.
Was soll ich als Nächstes vertiefen? Das erfahre ich am besten durch dein Feedback: Eine Bewertung auf meinem ProvenExpert-Profil zeigt mir, welche Themen dir wichtig sind – und motiviert mich, weitere Artikel zu schreiben.