Mit der Klasse Files legst du Dateien und Verzeichnisse an, prüfst, ob sie existieren, kopierst, verschiebst, benennst um und löschst sie. Jede dieser Operationen ist ein einziger Methodenaufruf, und jeder Fehler kommt als Exception, die Pfad und Ursache nennt.
Eine Log-Rotation beispielsweise sieht damit so aus:
Path logDir = Path.of("target/logs");
Path log = logDir.resolve("server.log");

Files.createDirectories(logDir);
if (Files.exists(log)) {
  Files.move(log, logDir.resolve("server.log.1"), REPLACE_EXISTING);
}
Files.createFile(log);
Danach liegt in target/logs/ die bisherige Log-Datei (sofern sie existierte) unter dem neuen Namen und eine neue, leere Datei unter dem alten:
server.log (0 bytes)
server.log.1 (276 bytes)
Files.createDirectories() legt das Verzeichnis an, samt fehlender übergeordneter Verzeichnisse, und tut nichts, wenn es das Verzeichnis schon gibt. Files.move() benennt die vorhandene Log-Datei um; REPLACE_EXISTING ersetzt dabei die Datei server.log.1 aus der vorigen Rotation. Files.createFile() legt schließlich die neue, leere Log-Datei an.
Die Klasse Files gehört zur NIO.2-API, die mit dem JSR 203 in Java 7 eingeführt wurde. Alle Methoden in diesem Artikel gibt es seit Java 7 – bis auf Files.writeString() aus Java 11 und Files.mismatch() aus Java 12.
In diesem Artikel erfährst du,
- warum ich
FilesstattFileempfehle und welcheFiles-Methode welcheFile-Methode ersetzt, - wie du prüfst, ob eine Datei existiert – und warum
exists()undnotExists()beidefalseliefern können, - warum „erst prüfen, dann anlegen“ zu einer Race Condition führen kann und wie
createFile()sie vermeidet, - worin sich
createDirectory()undcreateDirectories()unterscheiden, - wie du temporäre Dateien anlegst und wieder löschst,
- was
copy()mit Attributen, symbolischen Links und einem Verzeichnis als Ziel macht, - wie du Dateien verschiebst, umbenennst und mit
ATOMIC_MOVEatomar ersetzt, - wie du ein Verzeichnis samt Inhalt kopierst und löschst,
- wie du symbolische Links und Hard Links anlegst,
- wie schnell
Files.copy()im Vergleich zutransferTo()und einer Kopierschleife ist.
Die Beispiele in diesem Artikel
Jedes Beispiel beginnt mit einem frischen Verzeichnis target/logs/, in dem eine Kopie der Datei files/server.log liegt – die Log-Datei mit fünf Zeilen aus dem Artikel über den BufferedReader, 276 Bytes groß. Die Methode Examples.reset() aus dem Beispiel-Repository legt dieses Verzeichnis an, und Examples.printTree() gibt nach einer Operation aus, was darin liegt: Verzeichnisse mit Schrägstrich, Dateien mit ihrer Größe.
Den vollständigen Code findest du im GitHub-Repository java-file-io, im Package eu.happycoders.files. Jeder Abschnitt hat dort eine eigene Klasse mit main()-Methode, die die gezeigten Ausgaben erzeugt. Starte die Klassen im Hauptverzeichnis des Repositorys; alles, was die Beispiele anlegen, landet im Verzeichnis target/.
Die Beispiele verwenden Sprachmittel aus Java 25 und laufen deshalb erst ab dieser Version. Die einzelnen Files-Aufrufe funktionieren ab Java 7; vor Java 11 ersetzt du dabei Path.of() durch Paths.get(). Die Ausgaben stammen von macOS; wo Linux oder Windows abweichen, steht es im Text.
Files vs. File: Welche API nimmst du?
Für jede Operation in diesem Artikel gibt es zwei APIs: die Klasse java.io.File aus Java 1.0 und die Klasse java.nio.file.Files aus Java 7.
Ich empfehle Files – wegen der Fehlermeldungen: Die Methoden von File liefern true oder false. Schlägt eine Operation fehl, erfährst du nicht, warum. Die Methoden von Files werfen stattdessen eine Exception, die den Pfad und die Ursache nennt.
Das folgende Beispiel versucht, die Log-Datei in ein Verzeichnis zu verschieben, das es nicht gibt – einmal mit File.renameTo() und einmal mit Files.move():
File log = new File("target/logs/server.log");
File target = new File("target/old/server.log");
System.out.println("renameTo(): " + log.renameTo(target));
try {
  Files.move(log.toPath(), target.toPath());
} catch (IOException e) {
  System.out.println(e);
}
renameTo(): false
java.nio.file.NoSuchFileException: target/logs/server.log -> target/old/server.logrenameTo() liefert false, und die Datei liegt noch an ihrem Platz. Warum die Operation fehlgeschlagen ist – etwa ein fehlendes Zielverzeichnis, fehlende Rechte oder ein Ziel auf einem anderen Laufwerk –, steht nirgends. Files.move() wirft dagegen eine NoSuchFileException mit beiden Pfaden. Die Javadoc von renameTo() nennt das Verhalten der Methode selbst „inherently platform-dependent“ und verweist auf Files.move().
Die folgende Tabelle zeigt, welche Files-Methode welche File-Methode ersetzt. In der Spalte File steht ✗, wo die Klasse keine Methode für die Operation hat:
| Operation | java.io.File | java.nio.file.Files |
|---|---|---|
| Existenz prüfen | exists(), isFile(), isDirectory() | exists(), notExists(), isRegularFile(), isDirectory() |
| Datei anlegen | createNewFile() | createFile() |
| Verzeichnis anlegen | mkdir(), mkdirs() | createDirectory(), createDirectories() |
| Temporäre Datei anlegen | createTempFile() | createTempFile(), createTempDirectory() |
| Kopieren | ✗ | copy() |
| Verschieben, umbenennen | renameTo() | move() |
| Löschen | delete(), deleteOnExit() | delete(), deleteIfExists() |
| Links anlegen | ✗ | createSymbolicLink(), createLink() |
Alle Files-Methoden nehmen ein Path-Objekt entgegen. Bekommst du von einer älteren API ein File-Objekt, wandelst du es mit file.toPath() in ein Path-Objekt um. Wie du Path-Objekte konstruierst, zeigt der Artikel über Datei- und Verzeichnisnamen mit File, Path und Paths.
Prüfen, ob eine Datei existiert: Files.exists(), notExists(), isRegularFile() und isDirectory()
Files.exists() liefert true, wenn am angegebenen Pfad etwas existiert – eine Datei, ein Verzeichnis, ein Link oder eine Gerätedatei. Ob es eine Datei oder ein Verzeichnis ist, sagen dir Files.isRegularFile() und Files.isDirectory(). Das folgende Beispiel fragt die Log-Datei, ihr Verzeichnis und eine Datei ab, die es nicht gibt:
Path logDir = Path.of("target/logs");
Path log = logDir.resolve("server.log");
Path missing = logDir.resolve("missing.log");

System.out.println("exists(log):          " + Files.exists(log));
System.out.println("isRegularFile(log):   " + Files.isRegularFile(log));
System.out.println("isDirectory(log):     " + Files.isDirectory(log));
System.out.println("isDirectory(logDir):  " + Files.isDirectory(logDir));
System.out.println("exists(missing):      " + Files.exists(missing));
System.out.println("notExists(missing):   " + Files.notExists(missing));
exists(log): true
isRegularFile(log): true
isDirectory(log): false
isDirectory(logDir): true
exists(missing): false
notExists(missing): trueLiefern isRegularFile() und isDirectory() beide false, obwohl exists() true liefert, ist der Eintrag eine Datei vom Typ „other“ – z. B. eine Named Pipe, eine Gerätedatei oder ein Socket. Einen symbolischen Link verfolgen alle drei Methoden bis zu seinem Ziel; ob der Pfad selbst ein symbolischer Link ist, verrät dir Files.isSymbolicLink().
Keine der vier Methoden wirft eine IOException. Kann die Methode die Frage nicht beantworten, liefert sie false – auch notExists(). Was das bedeutet, zeigen die nächsten beiden Abschnitte.
Ein symbolischer Link ohne Ziel
exists(), isRegularFile() und isDirectory() folgen symbolischen Links: Sie beantworten die Frage für die Datei, auf die der Link zeigt. Das folgende Beispiel legt den Link current.log auf die Log-Datei an und löscht danach die Log-Datei:
Path link = logDir.resolve("current.log");
Files.createSymbolicLink(link, Path.of("server.log"));
System.out.println("exists(link):                 " + Files.exists(link));
Files.delete(log);
System.out.println("exists(link) after delete:    " + Files.exists(link));
System.out.println("exists(link, NOFOLLOW_LINKS): "
    + Files.exists(link, NOFOLLOW_LINKS));
System.out.println("isSymbolicLink(link):         " + Files.isSymbolicLink(link));
exists(link): true
exists(link) after delete: false
exists(link, NOFOLLOW_LINKS): true
isSymbolicLink(link): trueNach dem Löschen der Log-Datei liefert exists(link) false, obwohl der Link noch im Verzeichnis liegt. Mit der Option LinkOption.NOFOLLOW_LINKS fragst du nach dem Link selbst, und die Antwort ist true. Dieselbe Option nehmen isRegularFile(), isDirectory() und notExists() entgegen.
Wenn sich die Existenz nicht feststellen lässt
notExists() ist nicht das Gegenteil von exists(). Kann die Methode nicht feststellen, ob die Datei existiert, liefern beide false. Das folgende Beispiel legt die Datei secret.log in einem Verzeichnis an, entzieht dem Verzeichnis danach alle Rechte und gibt sie ihm im finally-Block zurück – ohne Rechte ließe sich das Verzeichnis nicht mehr löschen, auch nicht beim nächsten Lauf des Beispiels:
Path locked = logDir.resolve("locked");
Path secret = locked.resolve("secret.log");
Files.createDirectory(locked);
Files.createFile(secret);
Files.setPosixFilePermissions(locked, PosixFilePermissions.fromString("---------"));
try {
  System.out.println("exists(secret):    " + Files.exists(secret));
  System.out.println("notExists(secret): " + Files.notExists(secret));
} finally {
  Files.setPosixFilePermissions(locked, PosixFilePermissions.fromString("rwx------"));
}
exists(secret): false
notExists(secret): falseDie Datei existiert, aber ohne das Recht, das Verzeichnis zu durchsuchen, antwortet das Betriebssystem auf die Frage nach ihr mit „permission denied“ – weder ja noch nein. Unter Linux und macOS ruft exists() dafür die Systemfunktion access() auf und liefert false, sobald diese einen Fehler meldet. notExists() stellt dieselbe Frage, liefert aber nur bei einer NoSuchFileException true – bei jeder anderen IOException, hier einer AccessDeniedException, ebenfalls false.
Ein if (!Files.exists(file)) heißt also nicht „die Datei fehlt“, sondern „ich konnte sie nicht sehen“. Willst du handeln, weil eine Datei fehlt – etwa eine Standard-Konfiguration anlegen –, dann frag mit notExists(). Das ist der Zweck der Methode.
Erst prüfen, dann anlegen? Die Race Condition
Die Javadoc von exists() sagt: Das Ergebnis ist in dem Moment veraltet, in dem die Methode zurückkehrt. Zwischen deiner Prüfung und deiner nächsten Operation kann ein anderer Thread oder ein anderes Programm die Datei anlegen, löschen oder ersetzen. Einen solchen Fehler, bei dem das Ergebnis davon abhängt, wer zuerst zum Zug kommt, nennt man Race Condition. Diese Variante hat einen eigenen Namen: Time-of-check to time-of-use, kurz TOCTOU.
Wie oft das passiert, zeigt das folgende Programm. Zwei Threads durchlaufen dieselbe Schleife: Für jede von 10.000 Dateien prüfen sie mit notExists(), ob die Datei fehlt, und legen sie dann mit createFile() an. Scheitert createFile() trotz der Prüfung, zählt der Thread einen Zusammenstoß:
AtomicInteger collisions = new AtomicInteger();
CountDownLatch start = new CountDownLatch(1);
Runnable checkThenCreate =
    () -> {
      try {
        start.await();
        for (int i = 0; i < FILES; i++) {
          Path file = dir.resolve("file-" + i + ".log");
          if (Files.notExists(file)) {
            try {
              Files.createFile(file);
            } catch (FileAlreadyExistsException e) {
              collisions.incrementAndGet();
            }
          }
        }
      } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
      } catch (IOException e) {
        throw new UncheckedIOException(e);
      }
    };

Thread first = Thread.ofPlatform().start(checkThenCreate);
Thread second = Thread.ofPlatform().start(checkThenCreate);
start.countDown();
first.join();
second.join();

System.out.println(FILES + " files, " + collisions
    + " times notExists() was true and createFile() failed");
10000 files, 8114 times notExists() was true and createFile() failedFILES ist eine Konstante mit dem Wert 10.000, dir das Verzeichnis target/logs/race/. In meinem Lauf war die Prüfung 8.114-mal schon veraltet, bevor createFile() aufgerufen wurde: Beide Threads sahen „fehlt“, beide riefen createFile() auf, und nur einer von beiden hat die Datei angelegt. Die beiden Threads laufen hier im Gleichschritt, deshalb die hohe Zahl – in einem Programm, in dem zwei Prozesse nur gelegentlich dieselbe Datei anlegen, passiert es seltener, und deshalb bleibt so ein Fehler lange unbemerkt.
Das folgende Diagramm zeigt einen solchen Zusammenstoß am Beispiel der Datei file-0.log:
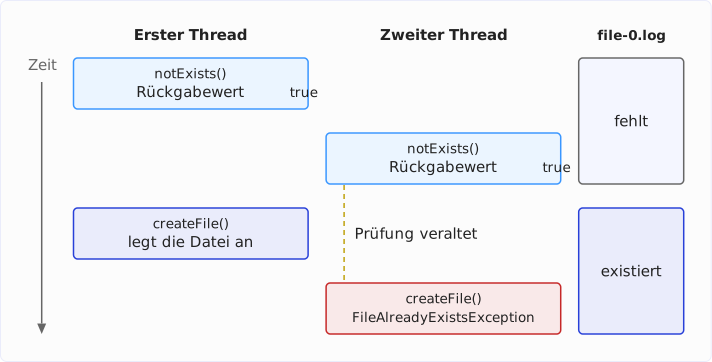
Die explizite Prüfung ist auch gar nicht notwendig, denn createFile() prüft selbst – und zwar atomar: Prüfen und Anlegen sind eine einzige Operation des Dateisystems, und von zwei gleichzeitigen Aufrufen gelingt genau einer. Dasselbe gilt für createDirectory() und delete().
Ich empfehle exists() und notExists() deshalb nur für Entscheidungen, bei denen die Race Condition keinen Schaden anrichten kann: eine optionale Konfigurationsdatei überspringen, eine Meldung ausgeben, die Log-Rotation aus der Einleitung. Vor dem Anlegen, Verschieben oder Löschen hingegen solltest du nicht prüfen, sondern die Operation aufrufen und die Exception fangen – wie es die folgenden Abschnitte zeigen.
Dateien anlegen mit Files.createFile()
Files.createFile() legt eine neue, leere Datei an und liefert ihren Pfad zurück:
Path app = logDir.resolve("app.log");
Files.createFile(app);
System.out.println(app + ": " + Files.size(app) + " bytes");
target/logs/app.log: 0 bytesExistiert die Datei schon, wirft die Methode eine FileAlreadyExistsException. Fehlt das Verzeichnis, in dem die Datei liegen soll, wirft sie eine NoSuchFileException – createFile() legt keine Verzeichnisse an:
try {
  Files.createFile(app);
} catch (FileAlreadyExistsException e) {
  System.out.println(e);
}
try {
  Files.createFile(Path.of("target/logs/2026/app.log"));
} catch (NoSuchFileException e) {
  System.out.println(e);
}
java.nio.file.FileAlreadyExistsException: target/logs/app.log
java.nio.file.NoSuchFileException: target/logs/2026/app.logEine FileAlreadyExistsException bekommst du auch, wenn am Pfad keine reguläre Datei, sondern ein Verzeichnis oder ein symbolischer Link liegt.
Eine Datei anlegen, wenn sie noch nicht existiert
Soll eine Datei angelegt werden, falls sie fehlt, und sonst unverändert bleiben, rufst du createFile() auf und fängst die FileAlreadyExistsException ab. Das folgende Beispiel tut das zweimal hintereinander:
for (int run = 1; run <= 2; run++) {
  Path audit = logDir.resolve("audit.log");
  try {
    Files.createFile(audit);
    System.out.println("Run " + run + ": created " + audit);
  } catch (FileAlreadyExistsException e) {
    System.out.println("Run " + run + ": " + audit + " already exists");
  }
}
Run 1: created target/logs/audit.log
Run 2: target/logs/audit.log already existsDer erste Durchlauf legt die Datei an, der zweite bekommt die Exception. Eine vorherige Prüfung mit notExists() würde nur das Risiko einer Race Condition bergen, wie sie der Abschnitt Erst prüfen, dann anlegen? Die Race Condition zeigt.
Das Gegenstück aus der alten API, File.createNewFile(), arbeitet ebenso atomar, liefert aber nur true oder false:
File legacy = new File("target/logs/app.log");
System.out.println("createNewFile(): " + legacy.createNewFile());
createNewFile(): falseEine Datei mit Inhalt anlegen
Soll die neue Datei mit Inhalt erzeugt werden, brauchst du createFile() nicht: Files.writeString() – seit Java 11 – legt die Datei an, wenn sie fehlt, und überschreibt sie, wenn sie existiert. Mit der Option StandardOpenOption.CREATE_NEW legt sie die Datei nur an und wirft sonst eine FileAlreadyExistsException:
Path notes = logDir.resolve("notes.txt");
Files.writeString(notes, "Rotated at 08:16\n");
System.out.println(notes + ": " + Files.size(notes) + " bytes");
try {
  Files.writeString(notes, "Rotated at 08:16\n", CREATE_NEW);
} catch (FileAlreadyExistsException e) {
  System.out.println(e);
}
target/logs/notes.txt: 17 bytes
java.nio.file.FileAlreadyExistsException: target/logs/notes.txtDieselben Optionen wie Files.writeString() nehmen Files.write(), Files.newBufferedWriter() und Files.newOutputStream() entgegen. Welche Optionen es gibt und wie du an eine Datei anhängst, zeigt der Artikel über das Schreiben von Dateien.
Zugriffsrechte beim Anlegen setzen
Unter Linux und macOS bekommt eine neue Datei die Rechte, die sich aus 0666 und der umask des Prozesses ergeben – mit der üblichen Prozess-umask 022 also rw-r--r--: Jeder Account auf dem System darf sie lesen. Soll das nicht sein, übergibst du createFile() die Rechte als FileAttribute:
FileAttribute<Set<PosixFilePermission>> ownerOnly =
    PosixFilePermissions.asFileAttribute(
        PosixFilePermissions.fromString("rw-------"));
Path secret = Files.createFile(logDir.resolve("secret.log"), ownerOnly);
System.out.println(
    PosixFilePermissions.toString(Files.getPosixFilePermissions(secret)));
System.out.println(
    PosixFilePermissions.toString(Files.getPosixFilePermissions(app)));
rw-------
rw-r--r--Die erste Zeile zeigt die Rechte der so angelegten Datei secret.log, die zweite zum Vergleich die der Datei app.log aus dem ersten Beispiel. createFile() setzt die Rechte beim Anlegen, nicht danach – es gibt keinen Moment, in dem die Datei mit den Standardrechten existiert. Ein nachträgliches Files.setPosixFilePermissions() ließe diese Lücke offen.
Dasselbe FileAttribute nehmen createDirectory(), createDirectories(), createTempFile() und createTempDirectory() entgegen. Unter Windows wirft createFile() mit einem POSIX-Attribut eine UnsupportedOperationException.
Verzeichnisse anlegen: createDirectory() und createDirectories()
Ein einzelnes Verzeichnis legst du mit Files.createDirectory() an. Das folgende Beispiel erstellt im Log-Verzeichnis das Verzeichnis archive:
Path archive = logDir.resolve("archive");
Files.createDirectory(archive);
System.out.println("isDirectory(archive): " + Files.isDirectory(archive));
isDirectory(archive): trueExistiert das Verzeichnis schon, wirft createDirectory() eine FileAlreadyExistsException. Fehlt das übergeordnete Verzeichnis, wirft es eine NoSuchFileException:
try {
  Files.createDirectory(archive);
} catch (FileAlreadyExistsException e) {
  System.out.println(e);
}
try {
  Files.createDirectory(logDir.resolve("archive/2026/10"));
} catch (NoSuchFileException e) {
  System.out.println(e);
}
java.nio.file.FileAlreadyExistsException: target/logs/archive
java.nio.file.NoSuchFileException: target/logs/archive/2026/10Files.createDirectories() legt dagegen auch alle fehlenden übergeordneten Verzeichnisse an und wirft keine Exception, wenn es das Verzeichnis schon gibt. Das folgende Beispiel erstellt archive/2026/10 – samt 2026 – und ruft die Methode danach ein zweites Mal auf:
Path month = logDir.resolve("archive/2026/10");
Files.createDirectories(month);
Files.createDirectories(month);
Examples.printTree(logDir);
archive/
archive/2026/
archive/2026/10/
server.log (276 bytes)Eine FileAlreadyExistsException wirft createDirectories() nur, wenn am Pfad etwas liegt, das kein Verzeichnis ist:
try {
  Files.createDirectories(logDir.resolve("server.log"));
} catch (FileAlreadyExistsException e) {
  System.out.println(e);
}
java.nio.file.FileAlreadyExistsException: target/logs/server.logSchlägt createDirectories() fehl, können die ersten Verzeichnisse des Pfads trotzdem angelegt worden sein – die Methode räumt nicht wieder auf.
Ich empfehle createDirectories() – außer, ein schon vorhandenes Verzeichnis ist ein fachlicher Fehler. Dann nimm createDirectory(), denn bei dieser Methode sind die Prüfung und das Anlegen eine einzige atomare Operation: Wollen zwei Prozesse gleichzeitig dasselbe Arbeitsverzeichnis anlegen, gelingt das genau einem, und der andere bekommt die FileAlreadyExistsException.
Die Gegenstücke aus der alten API, File.mkdir() und File.mkdirs(), liefern bei jedem Fehler nur false. Im folgenden Beispiel gibt es archive schon, und server.log ist eine Datei, unter der sich kein Verzeichnis anlegen lässt – beide Aufrufe scheitern, aber der Rückgabewert sagt nicht, warum:
System.out.println("mkdir():  " + new File("target/logs/archive").mkdir());
System.out.println("mkdirs(): " + new File("target/logs/server.log/x").mkdirs());
mkdir(): false
mkdirs(): falseTemporäre Dateien und Verzeichnisse
Für Dateien, die nur vorübergehend gebraucht werden – z. B. ein Upload einer Datei, die nach dem Verarbeiten nicht mehr benötigt wird –, gibt es Files.createTempFile(). Die Methode legt eine leere Datei mit eindeutigem Namen im temporären Verzeichnis des Systems an:
System.out.println("java.io.tmpdir = " + System.getProperty("java.io.tmpdir"));
for (int i = 0; i < 3; i++) {
  Path tempFile = Files.createTempFile("upload-", ".part");
  System.out.println(tempFile.getFileName() + " " + Files.size(tempFile) + " bytes "
      + PosixFilePermissions.toString(Files.getPosixFilePermissions(tempFile)));
  Files.delete(tempFile);
}
java.io.tmpdir = /var/folders/wt/np9sw9515z117kn393z4t4k00000gn/T/
upload-2989293313358349324.part 0 bytes rw-------
upload-7453209811048085771.part 0 bytes rw-------
upload-15558908968731794954.part 0 bytes rw-------Die beiden Parameter sind ein Präfix und ein Suffix. Dazwischen setzt createTempFile() eine Zufallszahl aus einem SecureRandom, als vorzeichenlose Zahl mit bis zu 20 Stellen. Das Verzeichnis ist das aus der System-Property java.io.tmpdir: unter macOS ein Verzeichnis pro Account unter /var/folders/, unter Linux /tmp, unter Windows C:\Users\<Name>\AppData\Local\Temp.
Unter Linux und macOS darf nur der Account, der die Datei angelegt hat, sie lesen und schreiben (Rechte rw-------) – auch dann, wenn die umask freizügiger ist, denn das JDK setzt die Rechte beim Anlegen explizit.
Soll die temporäre Datei woanders liegen, übergibst du das Verzeichnis als erstes Argument. Das brauchst du, wenn du die Datei am Ende mit ATOMIC_MOVE an ihren Platz verschieben willst, denn das geht nur innerhalb eines Dateisystems, und das temporäre Verzeichnis des Systems kann auf einem anderen Dateisystem liegen als das Ziel – mehr dazu im Abschnitt Atomar ersetzen: ATOMIC_MOVE:
Path part = Files.createTempFile(logDir, "server-", ".part");
System.out.println(part);target/logs/server-12176482355420645255.partEin temporäres Verzeichnis legst du mit Files.createTempDirectory() an. Es landet ebenfalls im Verzeichnis aus java.io.tmpdir, sofern du nicht als erstes Argument ein anderes übergibst, und bekommt die Rechte rwx------:
Path workDir = Files.createTempDirectory("rotation-");
System.out.println(workDir + " "
    + PosixFilePermissions.toString(Files.getPosixFilePermissions(workDir)));
/var/folders/wt/np9sw9515z117kn393z4t4k00000gn/T/rotation-955022758507380045 rwx------Weder temporäre Datei noch temporäres Verzeichnis werden von selbst wieder gelöscht. Lösch sie daher, sobald du sie nicht mehr brauchst – am besten in einem finally-Block, damit das auch nach einer Exception passiert:
Path tempFile = Files.createTempFile("upload-", ".part");
try {
  Files.writeString(tempFile,
      "2026-10-17 08:15:02 INFO  Server started on port 8080\n");
  System.out.println("Written: " + Files.size(tempFile) + " bytes");
} finally {
  Files.delete(tempFile);
}
System.out.println("exists(tempFile): " + Files.exists(tempFile));
Written: 54 bytes
exists(tempFile): falseDie alte API hat dafür File.deleteOnExit(), das du über tempFile.toFile().deleteOnExit() auch für einen Path aufrufen kannst. Die Methode löscht die Datei aber erst, wenn die JVM regulär beendet wird – bei einem Absturz oder einem kill -9 gar nicht –, und sie merkt sich bis dahin jeden registrierten Pfad. In einem Server, der Tage läuft und Millionen Uploads verarbeitet, bleibt so jede dieser Dateien bis zum nächsten Neustart liegen.
Ein temporäres Verzeichnis löschst du am besten mit der selbst geschriebenen Methode deleteDirectory() aus dem Abschnitt Ein Verzeichnis samt Inhalt löschen.
Dateien kopieren mit Files.copy()
Files.copy() kopiert eine Datei an einen neuen Pfad und liefert diesen Pfad zurück. Das folgende Beispiel kopiert die Log-Datei in das Verzeichnis archive:
Path archive = Files.createDirectory(logDir.resolve("archive"));
Path copy = Files.copy(log, archive.resolve(log.getFileName()));
System.out.println(copy + ": " + Files.size(copy) + " bytes");
target/logs/archive/server.log: 276 bytesDer zweite Parameter ist der Pfad der Zieldatei, nicht des Zielverzeichnisses. Deshalb hängt das Beispiel den Dateinamen mit archive.resolve(log.getFileName()) an das Verzeichnis an. Übergibst du statt Dateinamen ein Verzeichnis, bekommst du eine FileAlreadyExistsException – aus Sicht von copy() existiert am Zielpfad schon etwas, nämlich das Verzeichnis:
try {
  Files.copy(log, archive);
} catch (FileAlreadyExistsException e) {
  System.out.println(e);
}
java.nio.file.FileAlreadyExistsException: target/logs/archiveGegenüber einer selbst geschriebenen Schleife mit FileInputStream und FileOutputStream hat Files.copy() zwei Vorteile: Erstens ist der Aufruf viel kürzer – eine Zeile statt Puffer, Schleife und zwei Streams. Zweitens überlässt die Methode das Kopieren dem Betriebssystem. Seit Java 20 ruft sie unter Linux copy_file_range() auf, das die Daten im Kernel von Datei zu Datei bewegt, ohne sie in den Speicher des Java-Prozesses zu holen, und unter macOS die Bibliotheksfunktion fcopyfile(); unter Windows nutzt sie dafür CopyFileEx(). Wie viel das ausmacht, zeigt der Abschnitt Wie schnell ist Files.copy()?
Kopieren ist nicht atomar: Wirft copy() eine IOException, kann die Zieldatei unvollständig sein. Wie du eine Datei so ablegst, dass andere Prozesse sie nie halb sehen, zeigt der Abschnitt Atomar ersetzen: ATOMIC_MOVE.
Vorhandene Zieldatei überschreiben: REPLACE_EXISTING
Existiert die Zieldatei schon, wirft copy() eine FileAlreadyExistsException. Mit der Option StandardCopyOption.REPLACE_EXISTING überschreibt die Methode die Zieldatei stattdessen:
try {
  Files.copy(log, copy);
} catch (FileAlreadyExistsException e) {
  System.out.println(e);
}
Files.copy(log, copy, REPLACE_EXISTING);
System.out.println("Replaced: " + copy);
java.nio.file.FileAlreadyExistsException: target/logs/archive/server.log
Replaced: target/logs/archive/server.logEin nicht leeres Verzeichnis lässt sich so nicht ersetzen; dafür wirft copy() eine DirectoryNotEmptyException. Ist die Zieldatei ein symbolischer Link, ersetzt copy() den Link, nicht die Datei, auf die er zeigt.
Attribute mitkopieren: COPY_ATTRIBUTES
Ohne weitere Option bekommt die Kopie den Zeitpunkt des Kopierens als Änderungszeit. Mit StandardCopyOption.COPY_ATTRIBUTES übernimmt sie die Änderungszeit der Quelldatei. Das folgende Beispiel setzt die Änderungszeit der Log-Datei auf den Zeitpunkt der letzten Log-Zeile und kopiert sie dann ohne und mit der Option:
Files.setLastModifiedTime(log,
    FileTime.from(Instant.parse("2026-10-17T06:15:12Z")));
Path plain = Files.copy(log, archive.resolve("plain.log"));
Path withAttributes =
    Files.copy(log, archive.resolve("with-attributes.log"), COPY_ATTRIBUTES);
System.out.println("Source:          " + Files.getLastModifiedTime(log));
System.out.println("Copy:            " + Files.getLastModifiedTime(plain));
System.out.println("COPY_ATTRIBUTES: " + Files.getLastModifiedTime(withAttributes));
Source: 2026-10-17T06:15:12Z
Copy: 2026-10-25T18:13:07.733076214Z
COPY_ATTRIBUTES: 2026-10-17T06:15:12ZGarantiert wird nur die Übernahme der Änderungszeit. Welche weiteren Attribute mitkommen – Zugriffsrechte, Besitzer, erweiterte Attribute –, hängt vom Betriebssystem und vom Dateisystem ab. Ohne die COPY_ATTRIBUTES-Option garantiert copy() gar nicht, dass Attribute kopiert werden.
Unter macOS legt copy() mit COPY_ATTRIBUTES seit Java 20 sogar einen Klon an: Per Systemaufruf clonefile() teilen sich Original und Kopie auf APFS ihre Datenblöcke, bis eine der beiden Dateien geändert wird. Die Kopie belegt dann zunächst keinen zusätzlichen Speicherplatz, und das Kopieren dauert unabhängig von der Dateigröße nur Mikrosekunden (JDK-8293122).
Symbolische Links kopieren: NOFOLLOW_LINKS
Ist die Quelle ein symbolischer Link, kopiert copy() die Datei, auf die der Link zeigt. Mit LinkOption.NOFOLLOW_LINKS kopiert es den Link selbst:
Path link = logDir.resolve("current.log");
Files.createSymbolicLink(link, Path.of("server.log"));
Path followed = Files.copy(link, archive.resolve("followed.log"));
Path notFollowed =
    Files.copy(link, archive.resolve("not-followed.log"), NOFOLLOW_LINKS);
System.out.println("isSymbolicLink(followed):    " + Files.isSymbolicLink(followed));
System.out.println("isSymbolicLink(notFollowed): "
    + Files.isSymbolicLink(notFollowed));
System.out.println("readSymbolicLink(notFollowed): "
    + Files.readSymbolicLink(notFollowed));
isSymbolicLink(followed): false
isSymbolicLink(notFollowed): true
readSymbolicLink(notFollowed): server.logcurrent.log ist ein symbolischer Link auf die Log-Datei server.log. Die ohne Optionen erstellte Kopie followed.log ist eine eigenständige Datei mit dem Inhalt der Log-Datei. Die mit NOFOLLOW_LINKS erstellte Kopie not-followed.log ist ein Link, der wie das Original auf den relativen Pfad server.log zeigt. Ein relativer Pfad in einem Link gilt aber relativ zu dem Verzeichnis, in dem der Link liegt: target/logs/current.log zeigt auf target/logs/server.log, target/logs/archive/not-followed.log hingegen auf target/logs/archive/server.log. Kopierst du einen relativen Link in ein anderes Verzeichnis, zeigt er also, sofern vorhanden, auf eine andere Datei, ansonsten ins Leere.
Von einem InputStream in eine Datei und von einer Datei in einen OutputStream
Nicht jede Quelle ist eine Datei. Kommen die Daten beispielsweise aus einem Netzwerk-Stream, aus einem Archiv oder von einem anderen Prozess, hast du einen InputStream – und für den gibt es Files.copy(InputStream, Path). Damit das folgende Beispiel ohne Netzwerk und ohne externen Prozess auskommt, nimmt es einen InputStream, der die mit gzip komprimierte Datei files/server.log.gz beim Lesen entpackt – die entpackten Daten gibt es nur im Stream, nicht als Datei:
Path gz = Path.of("files/server.log.gz");
Path unpacked = logDir.resolve("unpacked.log");
try (InputStream in = new GZIPInputStream(Files.newInputStream(gz))) {
  long bytes = Files.copy(in, unpacked);
  System.out.println(bytes + " bytes copied");
}
276 bytes copiedDie Methode liest den InputStream bis zu seinem Ende und liefert die Anzahl der kopierten Bytes zurück. Sie legt die Zieldatei an und wirft eine FileAlreadyExistsException, wenn sie schon existiert – außer, du übergibst REPLACE_EXISTING. Den InputStream schließt sie nicht; dafür ist das Try-with-resources im Beispiel da.
Umgekehrt schreibt Files.copy(Path, OutputStream) eine Datei in einen OutputStream – z. B. in eine Netzwerkverbindung, in die HTTP-Antwort eines Servlets oder, wie hier, auf die Konsole:
Files.copy(unpacked, System.out);2026-10-17 08:15:02 INFO Server started on port 8080
2026-10-17 08:15:07 INFO GET /java/java-bufferedreader/ 200
2026-10-17 08:15:09 WARN GET /java/bufferedreader/ 404
2026-10-17 08:15:11 INFO GET /java/java-streams/ 200
2026-10-17 08:15:12 ERROR Connection reset by peerDie Kopie prüfen: isSameFile() und mismatch()
Ob zwei Dateien denselben Inhalt haben, sagt dir Files.mismatch() aus Java 12. Die Methode liefert -1, wenn beide Dateien Byte für Byte gleich sind, und sonst die Position des ersten Bytes, das sich unterscheidet. Sind die Dateien verschieden groß und stimmt die kleinere bis zu ihrem Ende mit der größeren überein, liefert mismatch() die Größe der kleineren Datei.
Das folgende Beispiel vergleicht die Log-Datei mit ihrer Kopie, ändert dann in der Kopie den Log-Level der ersten Zeile von INFO auf WARN und vergleicht erneut:
System.out.println("mismatch(log, copy):   " + Files.mismatch(log, copy));
System.out.println("isSameFile(log, copy): " + Files.isSameFile(log, copy));
String changed = Files.readString(copy).replaceFirst("INFO ", "WARN ");
Files.writeString(copy, changed);
System.out.println("\nAfter the change:");
System.out.println("mismatch(log, copy):   " + Files.mismatch(log, copy));
System.out.println("isSameFile(log, copy): " + Files.isSameFile(log, copy));
System.out.println("isSameFile(log, link): " + Files.isSameFile(log, link));
mismatch(log, copy): -1
isSameFile(log, copy): false
After the change:
mismatch(log, copy): 20
isSameFile(log, copy): false
isSameFile(log, link): trueDer erste Unterschied liegt an Position 20 – dort beginnt in jeder Zeile der Log-Level.
Files.isSameFile() beantwortet eine andere Frage: ob zwei Pfade auf dieselbe Datei zeigen. Für die Kopie liefert die Methode sowohl vor als auch nach der Änderung false, für den symbolischen Link current.log aus dem Abschnitt Symbolische Links kopieren: NOFOLLOW_LINKS true.
Vergleicht mismatch() zwei Pfade, die auf dieselbe Datei zeigen, liefert es -1, ohne ein Byte zu lesen.
Ein Verzeichnis samt Inhalt kopieren
Rufst du Files.copy() auf einem Verzeichnis auf, legt es am Ziel nur ein leeres Verzeichnis an – die Einträge kopiert es nicht:
Path emptyCopy = Files.copy(logDir, Path.of("target/logs-copy"));
try (Stream<Path> entries = Files.list(emptyCopy)) {
  System.out.println(emptyCopy + ": " + entries.count() + " entries");
}
target/logs-copy: 0 entriesEinen ganzen Verzeichnisbaum kopierst du mit Files.walkFileTree(). Die Methode besucht jeden Eintrag unterhalb eines Verzeichnisses und ruft dafür die vier Methoden eines FileVisitor auf:
preVisitDirectory(), bevor sie ein Verzeichnis betritt,visitFile()für jede Datei,visitFileFailed(), wenn sich ein Eintrag nicht besuchen lässt, etwa weil sich ein Verzeichnis nicht öffnen lässt,postVisitDirectory(), nachdem sie alle Einträge eines Verzeichnisses besucht hat.
Zum Kopieren brauchst du nur zwei davon: In preVisitDirectory() legst du jedes Verzeichnis am Ziel an, in visitFile() kopierst du jede Datei. Damit du die anderen beiden nicht selbst schreiben musst, erbst du von SimpleFileVisitor. Die Klasse implementiert alle vier Methoden: preVisitDirectory() und visitFile() tun nichts und lassen walkFileTree() weiterlaufen, visitFileFailed() und postVisitDirectory() werfen eine aufgetretene IOException weiter. Du überschreibst nur die beiden, in denen etwas passieren soll.
Die folgende Methode copyDirectory() macht genau das:
private static void copyDirectory(Path sourceDir, Path targetDir)
      throws IOException {
  Files.walkFileTree(sourceDir, new SimpleFileVisitor<>() {
    @Override
    public FileVisitResult preVisitDirectory(Path dir, BasicFileAttributes attrs)
          throws IOException {
      Files.createDirectories(targetDir.resolve(sourceDir.relativize(dir)));
      return FileVisitResult.CONTINUE;
    }

    @Override
    public FileVisitResult visitFile(Path file, BasicFileAttributes attrs)
          throws IOException {
      Files.copy(file, targetDir.resolve(sourceDir.relativize(file)),
            NOFOLLOW_LINKS);
      return FileVisitResult.CONTINUE;
    }
  });
}
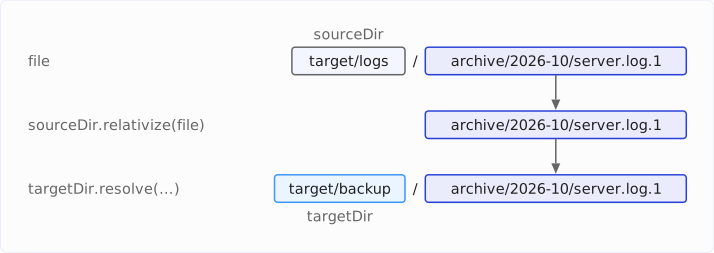
Den Zielpfad bildet relativize(): Für target/logs/archive/2026-10/server.log.1 liefert sourceDir.relativize() den relativen Pfad archive/2026-10/server.log.1, und targetDir.resolve() hängt ihn an das Zielverzeichnis an:
Die Option NOFOLLOW_LINKS kopiert einen symbolischen Link als Link; ohne sie würde copy() die Datei kopieren, auf die der Link zeigt.
Das folgende Beispiel legt unter target/logs/archive/2026-10/ zwei archivierte Log-Dateien an und kopiert dann das ganze Log-Verzeichnis nach target/backup/:
Path month = Files.createDirectories(logDir.resolve("archive/2026-10"));
Files.copy(log, month.resolve("server.log.1"));
Files.copy(log, month.resolve("server.log.2"));

Path backup = Path.of("target/backup");
copyDirectory(logDir, backup);
Examples.printTree(backup);
archive/
archive/2026-10/
archive/2026-10/server.log.1 (276 bytes)
archive/2026-10/server.log.2 (276 bytes)
server.log (276 bytes)Existiert eine Zieldatei schon, bricht copyDirectory() mit einer FileAlreadyExistsException ab – wie ein zweiter Aufruf zeigt:
try {
  copyDirectory(logDir, backup);
} catch (FileAlreadyExistsException e) {
  System.out.println(e);
}
java.nio.file.FileAlreadyExistsException: target/backup/archive/2026-10/server.log.1Mit REPLACE_EXISTING als weiterem Argument von Files.copy() in visitFile() überschreibt die Methode vorhandene Dateien stattdessen. Die bis zur Exception kopierten Dateien bleiben in jedem Fall liegen.
Wie walkFileTree() einen Verzeichnisbaum durchläuft, in welcher Reihenfolge es die vier Methoden des FileVisitor aufruft und wie du mit Files.walk() und Files.find() nach Dateien suchst, zeigt der Artikel über das Auslesen von Verzeichnissen.
Dateien und Verzeichnisse verschieben und umbenennen mit Files.move()
Files.move() verschiebt eine Datei an einen neuen Pfad. Wie bei copy() ist der zweite Parameter die Zieldatei, nicht das Zielverzeichnis. Das folgende Beispiel verschiebt die Log-Datei in das Verzeichnis archive:
Path archive = Files.createDirectory(logDir.resolve("archive"));
Path archived = Files.move(log, archive.resolve(log.getFileName()));
Examples.printTree(logDir);
archive/
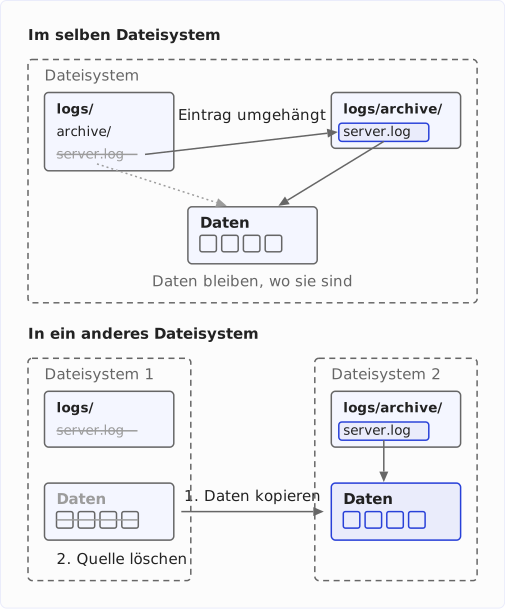
archive/server.log (276 bytes)Liegen Quelle und Ziel im selben Dateisystem, ändert move() nur den Verzeichniseintrag – die Daten bleiben, wo sie sind, und die Operation dauert bei einer Datei von 100 GB nicht länger als bei einer von 100 Bytes. Liegt das Ziel in einem anderen Dateisystem, etwa auf einem anderen Laufwerk, kopiert move() die Datei und löscht danach die Quelle. Das folgende Diagramm zeigt beide Fälle für die Log-Datei aus dem Beispiel:
Umbenennen mit resolveSibling()
Umbenennen ist Verschieben innerhalb desselben Verzeichnisses. Den neuen Pfad liefert resolveSibling(), das den Dateinamen austauscht und das Verzeichnis behält:
Path renamed = Files.move(archived, archived.resolveSibling("server.log.1"));
Examples.printTree(logDir);
archive/
archive/server.log.1 (276 bytes)archived.resolveSibling("server.log.1") ist eine Kurzform für archived.getParent().resolve("server.log.1").
Ein Verzeichnis verschieben
Ein Verzeichnis verschiebst du genauso wie eine Datei. Das folgende Beispiel benennt archive samt Inhalt in old um:
Path old = Files.move(archive, logDir.resolve("old"));
Examples.printTree(logDir);
old/
old/server.log.1 (276 bytes)Innerhalb eines Dateisystems ändert move() auch hier nur den Verzeichniseintrag; die Einträge des Verzeichnisses bleiben, wo sie sind. Liegt das Ziel in einem anderen Dateisystem, müsste move() jeden Eintrag einzeln kopieren. Das tut es nicht – bei einem nicht leeren Verzeichnis wirft es stattdessen eine IOException, unter Linux und macOS eine DirectoryNotEmptyException.
Einen Verzeichnisbaum auf ein anderes Dateisystem bringst du deshalb in zwei Schritten: erst kopieren, dann löschen.
Vorhandene Zieldatei ersetzen: REPLACE_EXISTING
Existiert die Zieldatei schon, wirft move() eine FileAlreadyExistsException. Mit REPLACE_EXISTING ersetzt es die Zieldatei:
Files.copy(Path.of("files/server.log"), log);
Path target = old.resolve("server.log.1");
try {
Files.move(log, target);
} catch (FileAlreadyExistsException e) {
System.out.println(e);
}
Files.move(log, target, REPLACE_EXISTING);
Examples.printTree(logDir);java.nio.file.FileAlreadyExistsException: target/logs/old/server.log.1
old/
old/server.log.1 (276 bytes)Das Beispiel legt zuerst eine neue Log-Datei an, dann schlägt der erste move()-Aufruf fehl, und der zweite ersetzt die archivierte Datei. Wie bei copy() lässt sich ein nicht leeres Verzeichnis nicht ersetzen, und ein symbolischer Link am Ziel wird als Link ersetzt.
Atomar ersetzen: ATOMIC_MOVE
Schreibst du eine Datei, die ein anderer Prozess liest – z. B. eine Konfigurationsdatei oder eine Datei in einem überwachten Verzeichnis –, dann darf dieser Prozess sie nie halb geschrieben sehen. Dafür schreibst du die neue Fassung in eine temporäre Datei im selben Verzeichnis und verschiebst sie dann mit StandardCopyOption.ATOMIC_MOVE an ihren Platz:
Path config = logDir.resolve("app.properties");
Files.writeString(config, "port=8080\n");
Path temp = Files.createTempFile(logDir, "app-", ".tmp");
Files.writeString(temp, "port=8443\n");
Files.move(temp, config, ATOMIC_MOVE);
System.out.print(Files.readString(config));
Examples.printTree(logDir);
port=8443
app.properties (10 bytes)
old/
old/server.log.1 (276 bytes)Mit ATOMIC_MOVE ist das Verschieben eine einzige Operation des Dateisystems: Andere Prozesse sehen unter app.properties entweder die alte oder die neue Datei, nie einen Zwischenzustand. Eine vorhandene Zieldatei ersetzt das JDK dabei unter Linux, macOS und Windows, ohne dass du REPLACE_EXISTING angibst – alle anderen Optionen ignoriert move() zusammen mit ATOMIC_MOVE.
Atomar verschieben geht nur innerhalb eines Dateisystems. Liegt die temporäre Datei in einem anderen Dateisystem – etwa im Verzeichnis aus java.io.tmpdir, das unter Linux ein eigenes Dateisystem sein kann –, wirft move() eine AtomicMoveNotSupportedException. Deshalb legt das Beispiel die temporäre Datei mit createTempFile(logDir, …) neben der Zieldatei an.
Ich empfehle ATOMIC_MOVE überall dort, wo ein anderer Prozess die Zieldatei liest. Ein move() ohne diese Option prüft erst, ob das Ziel existiert, und verschiebt dann – dazwischen könnte ein anderer Prozess eine Datei gleichen Namens anlegen.
Dateien löschen mit Files.delete() und deleteIfExists()
Files.delete() löscht eine Datei:
Files.delete(log);
System.out.println("exists(log): " + Files.exists(log));
exists(log): falseExistiert die Datei nicht, wirft delete() eine NoSuchFileException. Willst du in diesem Fall keine Exception, nimm Files.deleteIfExists(). Die Methode liefert true, wenn sie die Datei gelöscht hat, und false, wenn es die Datei nicht gab:
try {
  Files.delete(log);
} catch (NoSuchFileException e) {
  System.out.println(e);
}
System.out.println("deleteIfExists(log): " + Files.deleteIfExists(log));
java.nio.file.NoSuchFileException: target/logs/server.log
deleteIfExists(log): falseEin Verzeichnis löscht delete() nur, wenn es leer ist. Sonst wirft die Methode eine DirectoryNotEmptyException:
Path archive = Files.createDirectory(logDir.resolve("archive"));
Files.copy(Path.of("files/server.log"), archive.resolve("server.log.1"));
try {
  Files.delete(archive);
} catch (DirectoryNotEmptyException e) {
  System.out.println(e);
}
java.nio.file.DirectoryNotEmptyException: target/logs/archiveEin symbolischer Link wird als Link gelöscht; die Datei, auf die er zeigt, bleibt erhalten:
Path link = logDir.resolve("current.log");
Files.createSymbolicLink(link, Path.of("archive/server.log.1"));
Files.delete(link);
Examples.printTree(logDir);
archive/
archive/server.log.1 (276 bytes)Unter Linux und macOS löscht delete() auch eine Datei, die ein anderer Prozess gerade geöffnet hat: Der Verzeichniseintrag verschwindet sofort, die Daten erst, wenn der letzte Prozess die Datei schließt. Unter Windows schlägt das Löschen einer geöffneten Datei in der Regel mit einer FileSystemException fehl.
Das Gegenstück aus der alten API, File.delete(), liefert in allen diesen Fällen false:
System.out.println("File.delete(): " + new File("target/logs/archive").delete());File.delete(): falseEin Verzeichnis samt Inhalt löschen
Ein Verzeichnis mit Inhalt löschst du von unten nach oben: erst die Dateien, dann die leeren Verzeichnisse. Genau diese Reihenfolge liefert Files.walkFileTree(), denn es ruft postVisitDirectory() erst auf, wenn alle Einträge eines Verzeichnisses besucht sind.
Die folgende Methode deleteDirectory() löscht in visitFile() jede Datei und in postVisitDirectory() jedes Verzeichnis, sobald es leer ist:
private static void deleteDirectory(Path dirToDelete) throws IOException {
  Files.walkFileTree(dirToDelete, new SimpleFileVisitor<>() {
    @Override
    public FileVisitResult visitFile(Path file, BasicFileAttributes attrs)
          throws IOException {
      Files.delete(file);
      return FileVisitResult.CONTINUE;
    }

    @Override
    public FileVisitResult postVisitDirectory(Path dir, IOException exc)
          throws IOException {
      if (exc != null) {
        throw exc;
      }
      Files.delete(dir);
      return FileVisitResult.CONTINUE;
    }
  });
}
Ist der Parameter exc von postVisitDirectory() nicht null, konnte walkFileTree() das Verzeichnis nicht vollständig durchlaufen. Die Implementierung wirft die Exception dann weiter, denn sie nennt die Ursache. Würde sie exc ignorieren, würde Files.delete() mit einer DirectoryNotEmptyException scheitern, ohne dass du erfährst, warum das Verzeichnis nicht leer ist.
Das folgende Beispiel legt unter archive/2026-10/ eine archivierte Log-Datei und einen symbolischen Link auf die aktuelle Log-Datei an und löscht dann das Verzeichnis archive:
Path month = Files.createDirectories(logDir.resolve("archive/2026-10"));
Files.copy(log, month.resolve("server.log.1"));
Files.createSymbolicLink(month.resolve("latest.log"), Path.of("../../server.log"));
deleteDirectory(logDir.resolve("archive"));
Examples.printTree(logDir);
server.log (276 bytes)Die Log-Datei server.log außerhalb des gelöschten Verzeichnisses, auf die der Link zeigte, ist noch da. walkFileTree() folgt symbolischen Links standardmäßig nicht, deshalb löscht deleteDirectory() einen Link als Link – und nicht die Datei, auf die der Link zeigt.
Löschen mit Files.walk()
Kürzer geht das Löschen eines Verzeichnisses samt Inhalt mit Files.walk(): Du sortierst die Pfade in umgekehrter Reihenfolge und löschst sie dann einzeln:
private static void deleteDirectoryWithWalk(Path dirToDelete) throws IOException {
  try (Stream<Path> paths = Files.walk(dirToDelete)) {
    paths
        .sorted(Comparator.reverseOrder())
        .forEach(
            path -> {
              try {
                Files.delete(path);
              } catch (IOException e) {
                throw new UncheckedIOException(e);
              }
            });
  }
}
Die umgekehrte Sortierung bringt jeden Eintrag vor sein Verzeichnis: Der Pfad eines Verzeichnisses ist ein Präfix der Pfade seiner Einträge und steht in aufsteigender Sortierung deshalb vor ihnen – in absteigender Sortierung also dahinter.
Allerdings sammelt sorted() alle Pfade des Verzeichnisbaums im Speicher, bevor die erste Datei gelöscht wird – ein Path-Objekt pro Eintrag. Für große Verzeichnisbäume empfehle ich deshalb die Variante mit walkFileTree().
Wenn das Verzeichnis nicht existiert
Existiert das Verzeichnis nicht, werfen beide Varianten – deleteDirectory() und deleteDirectoryWithWalk() – eine NoSuchFileException:
try {
  deleteDirectory(logDir.resolve("archive"));
} catch (NoSuchFileException e) {
  System.out.println(e);
}
java.nio.file.NoSuchFileException: target/logs/archiveSoll ein fehlendes Verzeichnis kein Fehler sein, musst du diese Exception abfangen. Eine Prüfung mit Files.exists() davor reicht nicht: Löscht ein anderer Prozess das Verzeichnis zwischen Prüfung und Löschen, bekommst du die NoSuchFileException trotzdem.
Symbolische Links und Hard Links
Einen symbolischen Link legst du mit Files.createSymbolicLink() an. Achtung: Link und Ziel übergibst du hier in umgekehrter Reihenfolge als bei copy() und move() – zuerst den Pfad des Links, dann den Pfad, auf den er zeigen soll. Das folgende Beispiel legt den Link current.log auf die Log-Datei an:
Path link = logDir.resolve("current.log");
Files.createSymbolicLink(link, Path.of("server.log"));
System.out.println("readSymbolicLink(): " + Files.readSymbolicLink(link));
System.out.println("isSymbolicLink():   " + Files.isSymbolicLink(link));
System.out.println("size(link):         " + Files.size(link));
System.out.println("isSameFile():       " + Files.isSameFile(link, log));
readSymbolicLink(): server.log
isSymbolicLink(): true
size(link): 276
isSameFile(): trueFiles.readSymbolicLink() liefert den Pfad zum Ziel so, wie er im Link steht – hier der relative Pfad server.log, den das Dateisystem relativ zum Verzeichnis des Links auflöst. Alle anderen Methoden folgen dem Link: size() liefert die Größe der verlinkten Log-Datei, und isSameFile() bestätigt, dass Link und Log-Datei dieselbe Datei sind.
Ein Hard Link ist dagegen ein zweiter Verzeichniseintrag für dieselbe Datei. Du legst ihn mit Files.createLink() an, wieder mit dem Link als erstem Argument:
Path hardLink = Files.createLink(logDir.resolve("server-hardlink.log"), log);
System.out.println("isSymbolicLink():   " + Files.isSymbolicLink(hardLink));
System.out.println("isSameFile():       " + Files.isSameFile(hardLink, log));
isSymbolicLink(): false
isSameFile(): trueDer Unterschied zeigt sich, wenn du die ursprüngliche Datei löschst:
Files.delete(log);
System.out.println("size(hardLink): " + Files.size(hardLink));
System.out.println("exists(link):   " + Files.exists(link));
size(hardLink): 276
exists(link): falseDie Daten bleiben erhalten, solange ein Verzeichniseintrag auf sie zeigt – der Hard Link ist weiterhin eine vollständige Datei mit 276 Bytes. Der symbolische Link zeigt dagegen ins Leere. Ein Hard Link muss im selben Dateisystem liegen wie die Datei, und auf Verzeichnisse lässt er sich in der Regel nicht anlegen.
Diese Beispiele funktionieren unter Linux und macOS ohne Einschränkungen.
Wie schnell ist Files.copy()?
Wie schnell Files.copy() kopiert, habe ich mit dem Java Microbenchmark Harness (JMH) gemessen. Das Testprogramm CopyBenchmark kopiert eine Datei mit 100.000.000 zufälligen Bytes auf vier Wegen: mit Files.copy(), mit FileChannel.transferTo(), mit InputStream.transferTo() zwischen den Streams aus Files.newInputStream() und Files.newOutputStream() und mit einer selbst geschriebenen Schleife, die über ein byte-Array von 8.192 Bytes aus einem FileInputStream liest und in einen FileOutputStream schreibt.
Das folgende Diagramm zeigt, wie lange jede Variante für die ganze Datei braucht, in Millisekunden. Blau ist Files.copy(), grau sind die Alternativen:
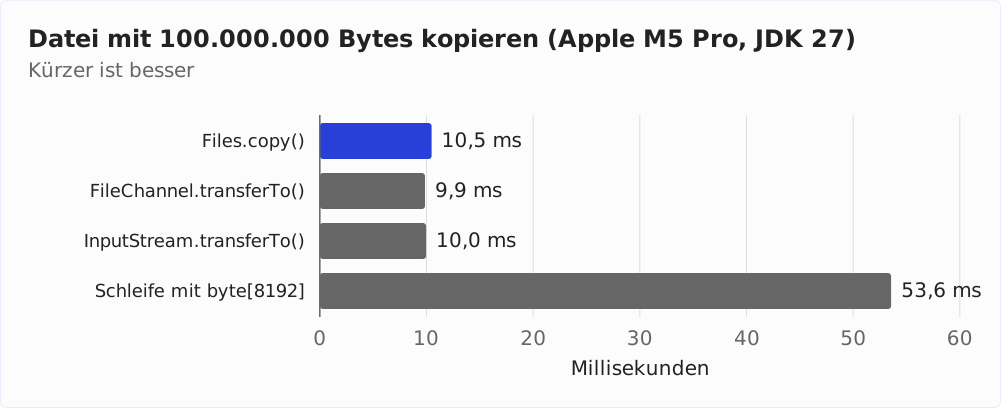
Files.copy() (Zeile 1 im Diagramm) braucht 10,5 ms. Die Schleife (Zeile 4) braucht 53,6 ms, gut fünfmal so lange. Sie ruft das Betriebssystem jeweils rund 12.200-mal zum Lesen und zum Schreiben auf, und bei jedem Aufruf kopiert das JDK den Block zwischen einem eigenen Puffer und dem byte-Array. Files.copy() hingegen übergibt die ganze Datei mit einem einzigen Aufruf an fcopyfile().
Die beiden transferTo()-Varianten (Zeilen 2 und 3) sind mit 9,9 und 10,0 ms sogar etwas schneller als Files.copy(). FileChannel.transferTo() versucht zuerst, das Betriebssystem die Daten direkt ins Ziel schreiben zu lassen – unter Linux mit copy_file_range() oder sendfile(), unter macOS mit sendfile(). Das schreibt unter macOS aber nur in Sockets, nicht in Dateien. Für eine Zieldatei blendet das JDK deshalb die Quelldatei in Abschnitten von bis zu 8 MiB in den Speicher ein und schreibt sie von dort in die Zieldatei. InputStream.transferTo() landet beim selben Code, denn die Streams aus Files.newInputStream() und Files.newOutputStream() reichen den Aufruf an ihre FileChannel-Objekte weiter.
Mit COPY_ATTRIBUTES legt Files.copy() auf APFS einen Klon an, wie der Abschnitt Attribute mitkopieren: COPY_ATTRIBUTES zeigt. Das Programm CloneSizeCheck misst dafür im Median zwischen 0,10 und 0,11 ms – bei einer Datei mit 1.000.000 Bytes genauso wie bei einer mit 1.000.000.000 Bytes. Das Diagramm zeigt den Klon nicht, denn sein Balken wäre kaum zu sehen.
Ich empfehle Files.copy() für jede Kopie von Datei zu Datei: Es ist fast so schnell wie transferTo(), braucht nur eine Zeile, und mit COPY_ATTRIBUTES kopiert es auf APFS gar keine Daten. Unter Linux und Windows habe ich nicht gemessen; dort arbeiten Files.copy() und transferTo() mit anderen Systemaufrufen, und die Abstände können anders ausfallen.
Häufige Fehler
Die folgenden Fehler zeigen die Abschnitte oben jeweils ausführlich:
- Das Zielverzeichnis statt der Zieldatei:
Files.copy(file, dir)undFiles.move(file, dir)werfen eineFileAlreadyExistsException, denn am Zielpfad existiert schon etwas – das Verzeichnis. Richtig als Ziel istdir.resolve(file.getFileName()). - Erst
exists(), danncreateFile(): Zwischen Prüfung und Anlegen kann ein anderer Prozess die Datei anlegen.createFile()prüft selbst, atomar. !Files.exists(file)als „die Datei fehlt“: Ohne Zugriffsrechte liefernexists()undnotExists()beidefalse.Files.copy()auf einem Verzeichnis: Es entsteht nur ein leeres Verzeichnis; die Einträge kopiert erstwalkFileTree().Files.delete()auf einem vollen Verzeichnis: Die Methode wirft eineDirectoryNotEmptyException; löschen musst du von unten nach oben.ATOMIC_MOVEaus dem Temp-Verzeichnis: Liegt die temporäre Datei in einem anderen Dateisystem, wirftmove()eineAtomicMoveNotSupportedException. Leg die temporäre Datei am besten neben die Zieldatei.File.renameTo(),File.delete(),File.mkdirs()ohne Prüfung des Rückgabewerts: Die Methoden melden Fehler nur mitfalse. Prüfst du den Rückgabewert nicht, bleibt der Fehler unbemerkt.deleteOnExit()für Dateien eines lang laufenden Servers: Die Dateien bleiben bis zum Neustart liegen.
Zusammenfassung
Die Klasse Files legt Dateien und Verzeichnisse an, kopiert, verschiebt und löscht sie – mit je einem Methodenaufruf, der im Fehlerfall eine Exception mit Pfad und Ursache wirft. Die Methoden von File liefern im Fehlerfall stattdessen false.
createFile(), createDirectory() und delete() prüfen selbst, ob ihre Voraussetzungen stimmen, und zwar atomar. Eine Prüfung mit exists() davor kann zu einer Race Condition führen: Im Beispiel mit zwei Threads war die Prüfung 8.114-mal von 10.000 schon veraltet, bevor die auf die Prüfung folgende Operation lief. exists() und notExists() sind zudem keine Gegenteile – kann das Betriebssystem die Frage nicht beantworten, liefern beide false.
copy() und move() erwarten als Ziel die Datei, nicht das Verzeichnis. Beide ersetzen eine vorhandene Zieldatei nur mit REPLACE_EXISTING, und beide behandeln ein Verzeichnis als einzelnen Eintrag: copy() legt ein leeres Verzeichnis an, move() benennt es innerhalb eines Dateisystems um und verweigert ein volles Verzeichnis über Dateisystemgrenzen. Für ganze Verzeichnisbäume – kopieren, löschen – ist Files.walkFileTree() das Werkzeug.
Meine Empfehlungen:
- Nimm
FilesstattFile; einFile-Objekt aus einer älteren API wandelst du mittoPath()um. - Ruf die Operation auf und fang die Exception, statt vorher mit
exists()zu prüfen.exists()undnotExists()sind für Entscheidungen, bei denen eine Race Condition keinen Schaden anrichten kann. - Leg Verzeichnisse mit
createDirectories()an – und mitcreateDirectory(), wenn ein vorhandenes Verzeichnis ein fachlicher Fehler ist. - Lösch temporäre Dateien in einem
finally-Block, nicht mitdeleteOnExit(). - Gib
COPY_ATTRIBUTESan, wenn die Kopie die Änderungszeit behalten soll – unter macOS ist sie dann ein Klon. - Schreib Dateien, die andere lesen, in eine temporäre Datei im selben Verzeichnis und verschieb sie mit
ATOMIC_MOVE. - Lösch Verzeichnisbäume mit
walkFileTree(); die Variante mitwalk()undsorted()hält alle Pfade im Speicher.
Wie du eine Datei liest und schreibst, zeigen die Artikel über das Lesen von Dateien und das Schreiben von Dateien aus derselben Serie. Wie du mit Path Datei- und Verzeichnispfade konstruierst, steht im Artikel über Datei- und Verzeichnisnamen mit File, Path und Paths.
Konntest du etwas aus diesem Artikel mitnehmen? Mit einer Bewertung auf meinem ProvenExpert-Profil hilfst du anderen Entwickler:innen einzuschätzen, ob sich das Lesen lohnt – und mir zu verstehen, welche Inhalte dir weiterhelfen.