Artikel über Monorepos gibt es zahlreiche, deshalb werde ich in diesem Artikel insbesondere auf die praktischen Aspekte eingehen: Performance und das Mergen von bestehenden Repositories.
Folgende Fragen wird dieser Artikel im Detail klären:
- Was ist ein Monorepo?
- Was sind die Vor- und Nachteile eines Monorepos?
- Wie performant ist ein Git-Monorepo?
- Wie kann man mehrere Git-Repositories in ein Monorepo zusammenführen (mergen) und dabei deren History beibehalten?
Was ist ein Monorepo?
Ein Monorepo (kurz für „monolithic repository“) ist ein Repository, das den Quellcode mehrerer oder aller Projekte eines Teams oder eines Unternehmens enthält. Jedes Projekt liegt darin in einem eigenen Verzeichnis.
Das Gegenstück ist das Polyrepo (auch Multirepo genannt): Jedes Projekt hat sein eigenes Repository.
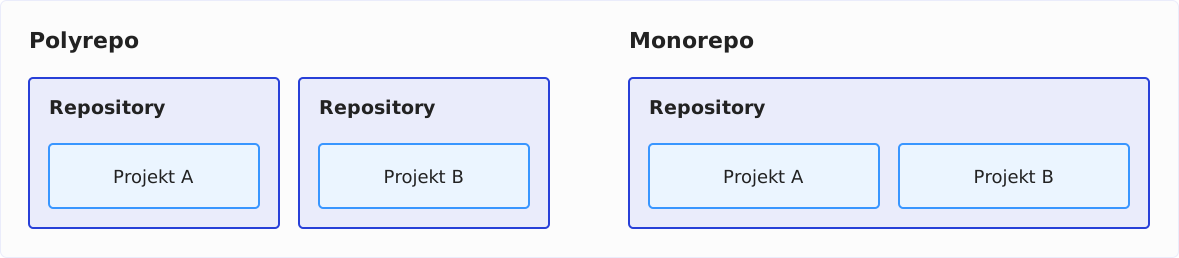
Ein Monorepo ist kein Monolith: Die Projekte darin bleiben eigenständige Libraries oder Services, die getrennt gebaut und deployt werden können. Nur ihr Quellcode liegt an einem gemeinsamen Ort.
Einige der größten Internetunternehmen arbeiten mit Monorepos, darunter Google, Meta (Facebook) und Microsoft.
Warum kenne ich mich mit Monorepos aus?
Bei AndroidPIT haben wir im August 2016 ein neues Produkt, das 2019 aus 25 Microservices und 23 Libraries bestand, als Git-Monorepo aufgesetzt. Zu Beginn waren alle Entwickler:innen zögerlich, doch unser Team entschied gemeinsam, es auszuprobieren. Wir hielten uns die Option offen, das Repository wieder aufzusplitten, falls wir unzufrieden sein sollten. Zwei Jahre später – nachdem wir überwiegend positive Erfahrungen gemacht hatten – entschieden wir uns, alle anderen Produkte ebenfalls in Monorepos zusammenzuführen.
Vor- und Nachteile von Monorepos
Zwei lesenswerte, englischsprachige Artikel zu diesem Thema sind:
- Monorepos: Please don’t! – ein Appell gegen Monorepos
- Monorepos and the Fallacy of Scale – eine Verteidigung von Monorepos als direkte Antwort auf den ersten Artikel
Im Folgenden findest du die Vor- und Nachteile, wie ich sie im Entwicklungsalltag erfahren habe, und meine Sicht auf die verbreiteten Kritikpunkte.
Was sind die Vorteile eines Monorepos?
Reduzierung von Aufwand / Kosten:
- Weniger Repositories:
Entwickler:innen müssen nur ein (oder wenige) Repositories auschecken und aktualisieren. Neue Projekte werden in Unterverzeichnissen erstellt und somit automatisch an alle im Team verteilt, ohne dass diese weitere Repositories auschecken müssen. - Konsistenz des Gesamtprojekts:
Entwickler:innen haben zu jeder Zeit einen konsistenten Stand des Gesamtprojekts – nicht nur im main-Branch, sondern auch auf Branches und alten Commits. Bei vielen Einzelrepositories kommt es hingegen schnell zu Inkompatibilitäten. - Atomare Commits:
Zusammengehörige Änderungen an mehreren Teilprojekten können gemeinsam eingecheckt werden. - Einfacher mergen:
Das Anlegen und Mergen von Branches für Änderungen, die mehrere Teilprojekte umfassen, ist aufwändig, wenn die Projekte in separaten Repositories liegen. In einem Monorepo muss man nur einmal mergen. - Einfachere Auflösung von Merge-Konflikten:
Das Behandeln von Merge-Konflikten wird vereinfacht, da sich in einem Monorepo während der Behandlung des Konflikts die komplette Codebasis in einem konsistenten Zustand befindet. Bei mehreren Repositories muss man diese ggf. erst mühsam auf einen einheitlichen Zustand bringen.
Verbesserte Wartbarkeit:
- Code verschieben:
Code kann deutlich einfacher zwischen den Verzeichnissen eines Monorepos verschoben werden als von einem Repository in ein anderes. Somit können Entwickler:innen die Modulgrenzen bei Änderungen von Anforderungen oder Refactorings problemlos anpassen. - Zentrale Dokumentation:
Projektübergreifende Dokumentation kann im Root-Folder des Monorepos abgelegt werden.
Organisation:
- Transparenz:
Monorepos führen dazu, dass alle Entwickler:innen Zugriff auf die gesamte Codebasis haben. In den meisten Fällen ist dies erwünscht, fördert die teamübergreifende Zusammenarbeit und erlaubt es Entwickler:innen, an Code anderer Teams mitzuarbeiten. - Reduzierte Konfiguration:
Monorepos reduzieren den Konfigurationsaufwand der Source Code Management Tools.
Was sind die Nachteile eines Monorepos?
Echte Nachteile sehe ich vor allem in der Organisation:
- Transparenz:
Der unter den Vorteilen aufgeführte Aspekt, dass alle Entwickler:innen Zugriff auf die gesamte Codebasis haben, ist nicht in allen Organisationen erwünscht. Beispielsweise sollten Projekte, die ein Dienstleister für unterschiedliche Kunden entwickelt, nicht in einem Monorepo abgelegt werden. - Open-Source-Libraries:
Auch wenn Teilprojekte als Open-Source-Komponenten freigegeben werden sollen, ist ein Monorepo hinderlich.
Andere häufig genannte Nachteile teile ich nicht:
- Performance-Probleme:
Kritiker:innen bemängeln, dass Monorepos zu Performance-Problemen führen. Ich konnte in Projekten der Größe, in der die meisten von uns sich bewegen, bisher keine Performance-Einbußen feststellen (s. u. „Performance und Skalierbarkeit eines Git-Monorepos“). - Erhöhter Speicherbedarf:
Ebenso wird ein erhöhter Speicherbedarf kritisiert, da alle Entwickler:innen die gesamte Codebasis auschecken müssen. Dies dürfte heutzutage in den meisten Projekten unerheblich sein: Das Git-Repository des Linux-Kernels bspw. belegt samt seiner kompletten History gut 6 GB. Die Repositories der meisten Unternehmen dürften kleiner sein. Und wer nur einen Teil braucht, muss nicht alles herunterladen (s. u. „Große Monorepos: Partial Clone und Sparse Checkout“). - Komplexere Builds:
Monorepos machen vermeintlich die Build-Pipeline komplexer. Auch das entspricht nicht meiner Erfahrung. Mittels Sparse Checkouts und Pfadfiltern in der CI-Pipeline kann man problemlos Teilprojekte bauen. - Komplizierte Versionierung:
Angeblich wird die Versionierung komplizierter. Auch dies kann ich nicht nachvollziehen. Es ist sowohl möglich, die komplette Codebasis zu versionieren (mit Tags wie „v1.0“), als auch einzelne Teilprojekte (mit Tags wie „project-a-v1.0“). - Schlechtere Modularisierung:
Einige sind der Meinung, dass ein Monorepo einer sauberen und effektiven Modularisierung entgegenwirkt, da die Entwickler:innen nicht gezwungen sind, den Code auf separate Repositories aufzuteilen. Ich sehe das als Vorteil, da Modulgrenzen durch Monorepos nicht in Stein gemeißelt werden (s. o. „Verbesserte Wartbarkeit“).
Performance und Skalierbarkeit eines Git-Monorepos
Ein weit verbreiteter Kritikpunkt an Monorepos ist deren schlechte Performance und Skalierbarkeit.
Aus meiner Erfahrung bei AndroidPIT und IONOS kann ich sagen, dass es in den meisten Teams keine Performance-Probleme geben sollte. In den meisten Unternehmen dürfte die gesamte Codebasis kleiner sein als der Linux-Kernel (rund 28 Mio. Zeilen C-Code in gut 64.000 Dateien laut cloc, Stand Oktober 2026), welcher ebenfalls mit Git verwaltet wird (und für den Git ursprünglich entwickelt wurde).
Von 2019 bis 2023 habe ich bei IONOS an einem Java-Backend gearbeitet, dessen Monorepo kleiner als der Linux-Kernel war, aber in einer vergleichbaren Größenordnung lag. Das Klonen des gesamten Repositories dauerte weniger als eine Minute, das Umschalten von Branches je nach Alter des Branches zwischen 0,2 und 1,5 Sekunden.
Die meisten von uns arbeiten in Unternehmen dieser Größenordnung; von daher sehe ich keine praktischen Probleme bei der Skalierbarkeit eines Monorepos.
Große Monorepos: Partial Clone und Sparse Checkout
Wird ein Monorepo doch einmal groß, bringt Git zwei Werkzeuge mit, mit denen du nur den Teil herunterlädst und auscheckst, an dem du arbeitest:
- Partial Clone:
git clone --filter=blob:nonelädt beim Klonen nur die Commits und Verzeichnisstrukturen herunter, aber keine Dateiinhalte. Die holt Git erst, wenn es sie braucht. - Sparse Checkout:
git sparse-checkout setbeschränkt das Arbeitsverzeichnis auf die angegebenen Verzeichnisse und die Dateien im Wurzelverzeichnis.
Für das Monorepo, das wir im folgenden Abschnitt zusammenführen, sieht das so aus:
git clone --filter=blob:none --sparse \
  https://github.com/SvenWoltmann/sparse-checkout-demo.git
cd sparse-checkout-demo
git sparse-checkout set project-a
Mit --sparse enthält das Arbeitsverzeichnis nach dem Klonen nur die Dateien im Wurzelverzeichnis; git sparse-checkout set project-a fügt das Verzeichnis project-a hinzu. project-b bleibt außen vor.
Zusammenführen (Mergen) mehrerer Git-Repositories unter Beibehaltung der History
Nehmen wir an, wir haben zwei Projekte, „project-a“ (beispielhaft angelegt unter https://github.com/SvenWoltmann/project-a) und „project-b“ (https://github.com/SvenWoltmann/project-b), die wir zu einem Repository „sparse-checkout-demo“ zusammenfassen wollen. Die zwei Projekte sollen dabei in Unterverzeichnissen mit den jeweiligen Projektnamen angeordnet werden:
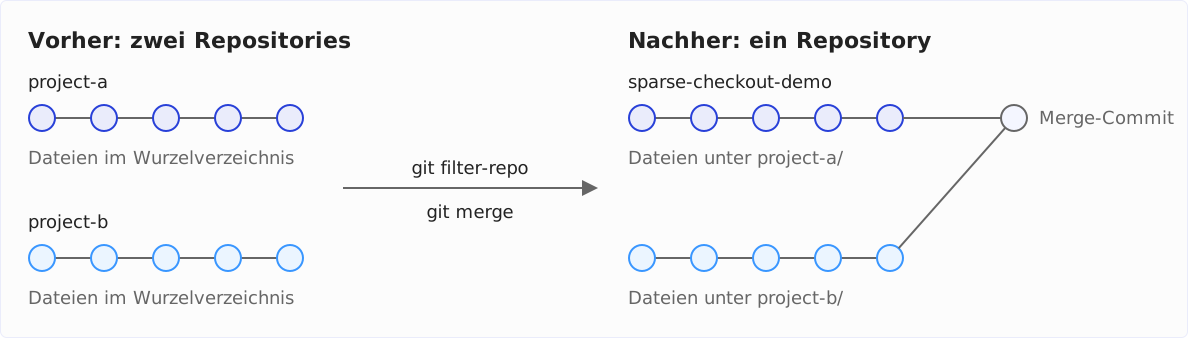
Um die History der Projekte umzuschreiben, verwenden wir git filter-repo. Git bringt zwar selbst git filter-branch mit, rät in dessen Dokumentation aber davon ab und empfiehlt stattdessen git filter-repo. Das Tool gehört nicht zum Lieferumfang von Git; du installierst es über deinen Paketmanager (z. B. brew install git-filter-repo) oder mit pipx install git-filter-repo.
Zunächst klonen wir beide Projekte, erstellen das Verzeichnis für das Monorepo und initialisieren dort ein Git-Repository (alternativ eines via GitHub erstellen und klonen):
git clone https://github.com/SvenWoltmann/project-a.git
git clone https://github.com/SvenWoltmann/project-b.git

mkdir sparse-checkout-demo
git init sparse-checkout-demo
Klone die Projekte auch dann frisch, wenn du sie schon lokal hast. git filter-repo schreibt die History unwiderruflich um und verweigert deshalb die Arbeit in einem Repository, das nicht wie ein frischer Klon aussieht.
Mit folgenden Kommandos mergen wir Projekt A in das Monorepo:
cd project-a
git filter-repo --to-subdirectory-filter project-a
cd ../sparse-checkout-demo
git remote add project-a ../project-a
git fetch project-a
git merge --allow-unrelated-histories project-a/main
git remote rm project-a
--to-subdirectory-filter project-a verschiebt in jedem Commit alle Dateien in das Unterverzeichnis project-a. Die Ausgabe von git filter-repo beginnt mit diesem Hinweis:
NOTICE: Removing 'origin' remote; see 'Why is my origin removed?'
        in the manual if you want to push back there.
        (was https://github.com/SvenWoltmann/project-a.git)
Das ist Absicht: Jeder umgeschriebene Commit hat eine neue ID, und ohne origin kann die alte History nicht versehentlich wieder mit der neuen zusammengeführt werden.
git merge gibt danach nichts aus. Da das Monorepo noch leer ist, übernimmt Git die History von Projekt A, ohne einen Merge-Commit anzulegen.
Das Gleiche wiederholen wir für Projekt B:
cd ../project-b
git filter-repo --to-subdirectory-filter project-b
cd ../sparse-checkout-demo
git remote add project-b ../project-b
git fetch project-b
git merge --allow-unrelated-histories project-b/main
git remote rm project-b
Diesmal legt git merge einen Merge-Commit an, der die beiden Historien verbindet. Git öffnet dafür einen Editor mit einer vorbereiteten Commit-Message, die du übernehmen kannst. Danach siehst du diese Ausgabe:
Merge made by the 'ort' strategy.
 project-b/.gitignore                               |   2 +
 project-b/README.md                                |  60 +++++++++++++++++++++
 project-b/img/big-o-cheat-sheet-mockup.png         | Bin 0 -> 120226 bytes
 project-b/img/java-versions-cheat-sheet-mockup.png | Bin 0 -> 475522 bytes
 .../mastering-data-structures-product-mockup.png   | Bin 0 -> 130068 bytes
 project-b/pom.xml                                  |  13 +++++
 .../src/main/java/eu/happycoders/demo/b/B.java     |   7 +++
 7 files changed, 82 insertions(+)
 create mode 100644 project-b/.gitignore
 create mode 100644 project-b/README.md
 create mode 100644 project-b/img/big-o-cheat-sheet-mockup.png
 create mode 100644 project-b/img/java-versions-cheat-sheet-mockup.png
 create mode 100644 project-b/img/mastering-data-structures-product-mockup.png
 create mode 100644 project-b/pom.xml
 create mode 100644 project-b/src/main/java/eu/happycoders/demo/b/B.java
Und das war es schon!
Mit ls und git log --oneline --graph kannst du sehen, dass beide Teilprojekte und deren Commits im Monorepo enthalten sind:
ls
git log --oneline --graph
project-a project-b
* 79ed240 Merge remote-tracking branch 'project-b/main'
|\
| * bf0bdc6 README: append the shared resources block
| * 0ba7fdf Update README links to GitHub
| * 8c6f410 Add link to project website to README.md.
| * f93dd81 Initial commit of project-b.
| * bd7057a Initial commit
* 2b5d62d README: append the shared resources block
* e63b16b Update README links to GitHub
* 14a9568 Add link to project website to README.md.
* c103177 Initial commit of project-a.
* d8bf9fa Initial commitWie das fertige Monorepo aufgebaut ist, zeigt das Repository sparse-checkout-demo auf GitHub.
In diesem Beispiel brauchte git filter-repo jeweils weniger als eine Sekunde. Als wir bei AndroidPIT die Module, aus denen die Website besteht, noch mit git filter-branch zusammengefasst haben, hat das etwa dreieinhalb Stunden gedauert. Laut seiner Dokumentation ist git filter-repo um mehrere Größenordnungen schneller.
Fazit
In diesem Artikel habe ich die Vor- und Nachteile von Git-Monorepos gegenübergestellt – meiner Meinung nach überwiegen die Vorteile deutlich, sodass Monorepos für die meisten Teams eine gute Wahl sind. Die häufig kritisierten Performance- und Skalierbarkeitsprobleme kommen bei den Teamgrößen der meisten Unternehmen nicht zum Tragen, und das einfachere Refactoring von Code über Modulgrenzen hinweg erhöht die Wartbarkeit des Codes.
Ich habe Schritt für Schritt gezeigt, wie existierende Repositories unter Beibehaltung ihrer History zusammengeführt werden können.
Wer nicht alle Projekte in einem einzigen Repository haben möchte, kann Monorepos auch auf diejenigen Projekte beschränken, die eng miteinander verwoben sind und bei denen gemeinsames Branchen und Mergen sinnvoll ist. Auch kannst du deine Projekte nach und nach in Monorepos überführen und – ebenso problemlos – Monorepos und Einzelprojekte nebeneinander laufen lassen.
Konntest du etwas aus diesem Artikel mitnehmen? Mit einer Bewertung auf meinem ProvenExpert-Profil hilfst du anderen Entwickler:innen einzuschätzen, ob sich das Lesen lohnt – und mir zu verstehen, welche Inhalte dir weiterhelfen.