Alle bisher in dieser Artikelserie behandelten Sortierverfahren basieren auf dem Vergleich, ob zwei Zahlen kleiner, größer oder gleich sind. Counting Sort basiert auf einer komplett anderen, nicht-vergleichsbasierten Herangehensweise.
Dieser Artikel beantwortet folgende Fragen:
- Wie funktioniert Counting Sort?
- Worin unterscheiden sich die vereinfachte und die allgemeine Form von Counting Sort?
- Wie sieht der Quellcode von Counting Sort aus?
- Wie bestimmt man die Zeitkomplexität von Counting Sort?
- Warum ist Counting Sort trotz exakt gleicher Anzahl an Operationen für vorsortierte Zahlenfolgen knapp siebenmal schneller als für unsortierte?
Counting Sort Algorithmus (Vereinfachte Form)
Anstatt Elemente zu vergleichen, wird bei Counting Sort gezählt, wie oft welche Elemente in der zu sortierenden Menge vorkommen.
Eine vereinfachte Form von Counting Sort kann angewendet werden, wenn Zahlen (z. B. int-Primitive) sortiert werden sollen – für Objekte, die entsprechend ihrer Keys sortiert werden sollen, wirst du im Anschluss die allgemeine Form von Counting Sort kennenlernen.
Die vereinfachte Form besteht aus zwei Phasen:
Counting Sort Algorithmus – Phase 1: Elemente zählen
Zunächst wird ein zusätzliches Array angelegt, dessen Länge der Größe des Zahlenraums entspricht (z. B. ein Array der Größe 256, um Bytes zu sortieren). Dann iteriert man einmal über die zu sortierenden Elemente und erhöht für jedes Element den Wert im Array an derjenigen Position, die der zu sortierenden Zahl entspricht, um eins.
Hier ein Beispiel mit dem Zahlenraum 0–9 (d. h. in dem zu sortierenden Array kommen nur Zahlen von 0 bis 9 vor).
Folgendes Array soll sortiert werden:

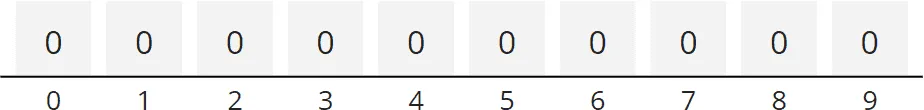
Wir erstellen ein zusätzliches Array der Länge 10, das mit Nullen initialisiert ist. In der Grafik wird unter der Linie der Array-Index mit angezeigt:
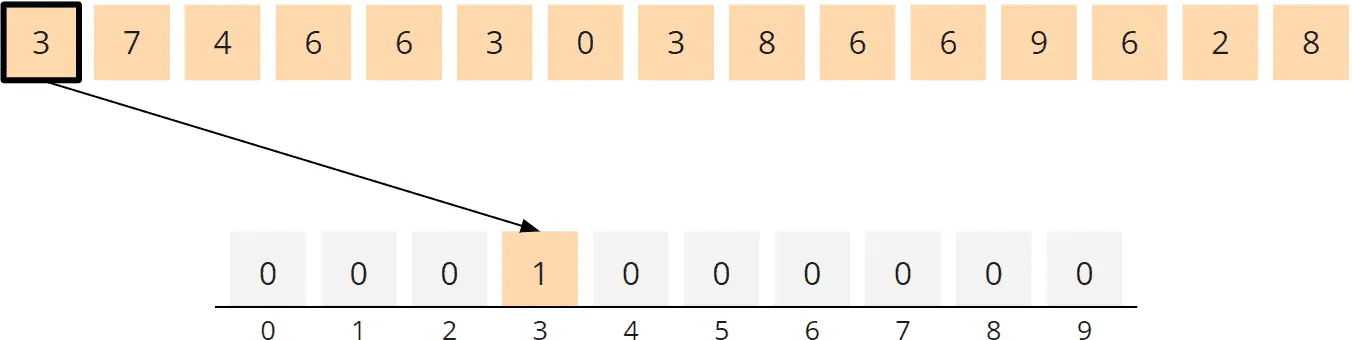
Nun iterieren wir über das zu sortierende Array. Das erste Element ist eine 3 – dementsprechend erhöhen wir den Wert im Hilfsarray an der Position 3 um eins:
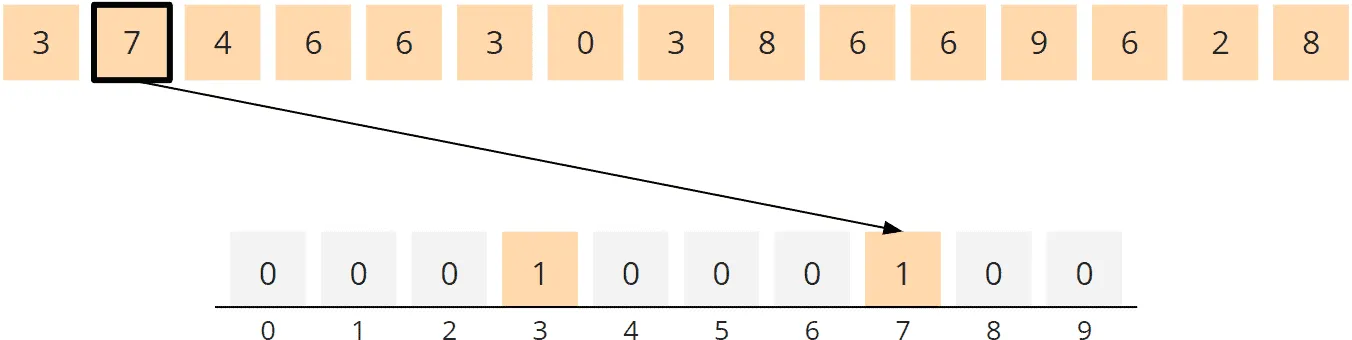
Das zweite Element ist eine 7. Wir erhöhen im Hilfsarray das Feld an Position 7 um eins:
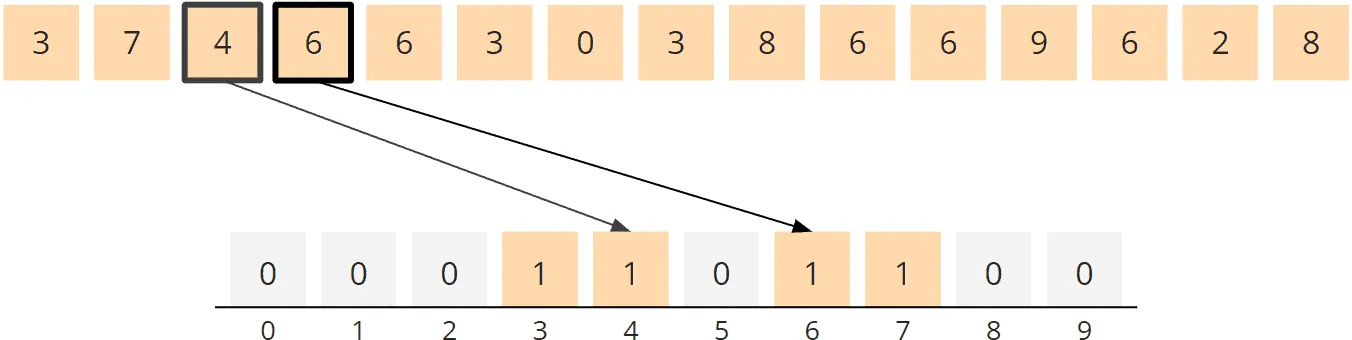
Es folgen die Elemente 4 und 6 – dementsprechend erhöhen wir auch die Werte an den Positionen 4 und 6 jeweils um eins:
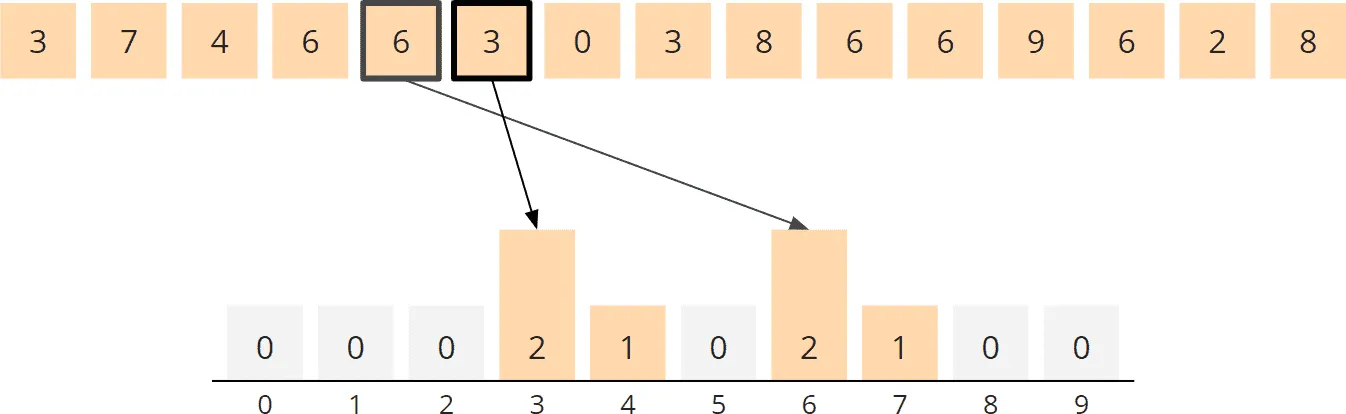
Mit den nächsten zwei Elementen – der 6 und der 3 – folgen zwei Elemente, die schon einmal vorkamen. Entsprechend werden die Felder im Hilfsarray von 1 auf 2 erhöht:
Das Prinzip sollte nun klar sein. Nachdem auch die Hilfsarray-Werte für die restlichen zu sortierenden Elemente entsprechend erhöht wurden, sieht das Hilfsarray am Ende wie folgt aus:
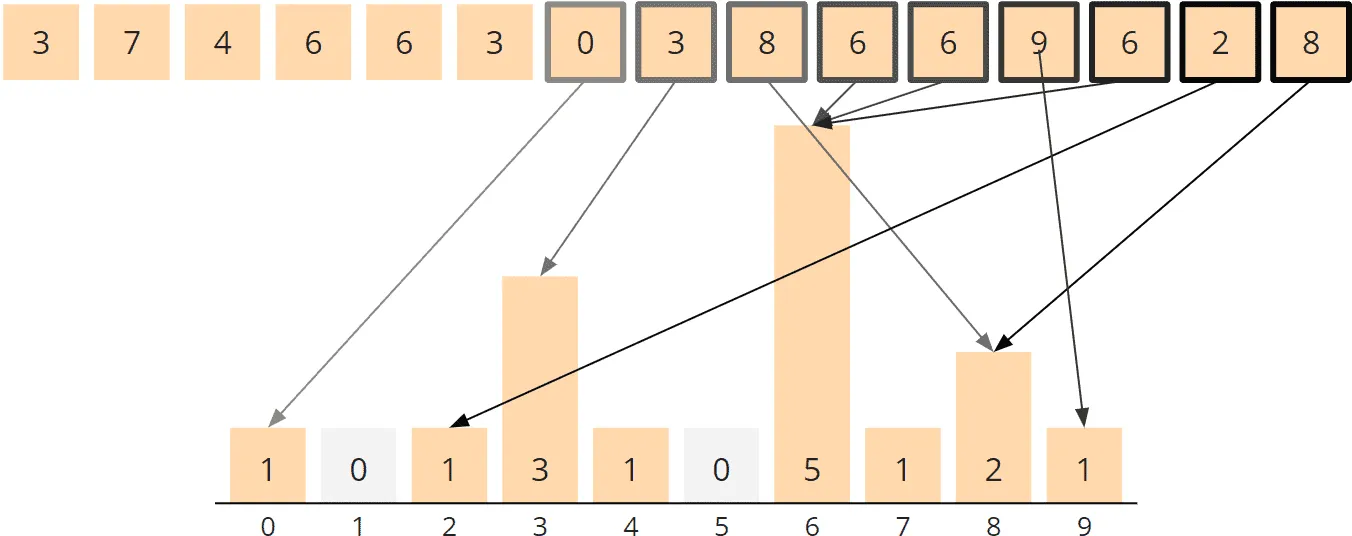
Aus diesem sogenannten Histogramm lässt sich Folgendes ablesen:
Die zu sortierenden Elemente enthalten:
- 1-mal die 0,
- 0-mal die 1,
- 1-mal die 2,
- 3-mal die 3,
- 1-mal die 4,
- 0-mal die 5,
- 5-mal die 6,
- 1-mal die 7,
- 2-mal die 8 und
- 1-mal die 9.
Diese Informationen werden wir in Phase 2 verwenden, um das zu sortierende Array neu anzuordnen.
Counting Sort Algorithmus – Phase 2: Elemente neu anordnen
In Phase zwei iterieren wir einmal über das Histogramm-Array. Dabei schreiben wir den jeweiligen Array-Index so oft in das zu sortierende Array, wie es das Histogramm an der entsprechenden Stelle anzeigt.
Im Beispiel starten wir an Position 0 im Hilfsarray. Dort steht die 1, wir schreiben daher die 0 genau ein Mal in das zu sortierende Array.
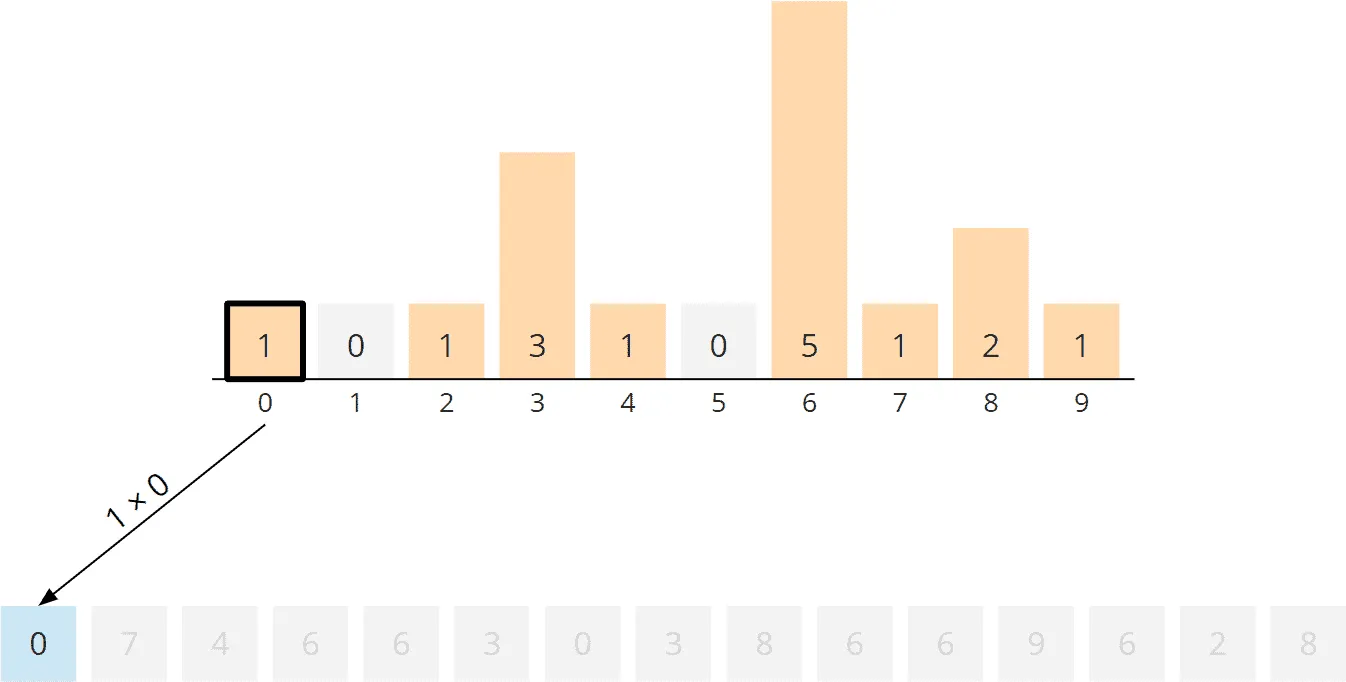
(Die restlichen Zahlen habe ich ausgegraut, da sie zwar nach wie vor im Array stehen, wir sie aber nicht mehr benötigen, da wir diese Informationen jetzt komplett im Histogramm haben.)
An Position 1 im Histogramm steht eine 0, d. h. wir überspringen dieses Feld – es wird keine 1 in das zu sortierende Array geschrieben.
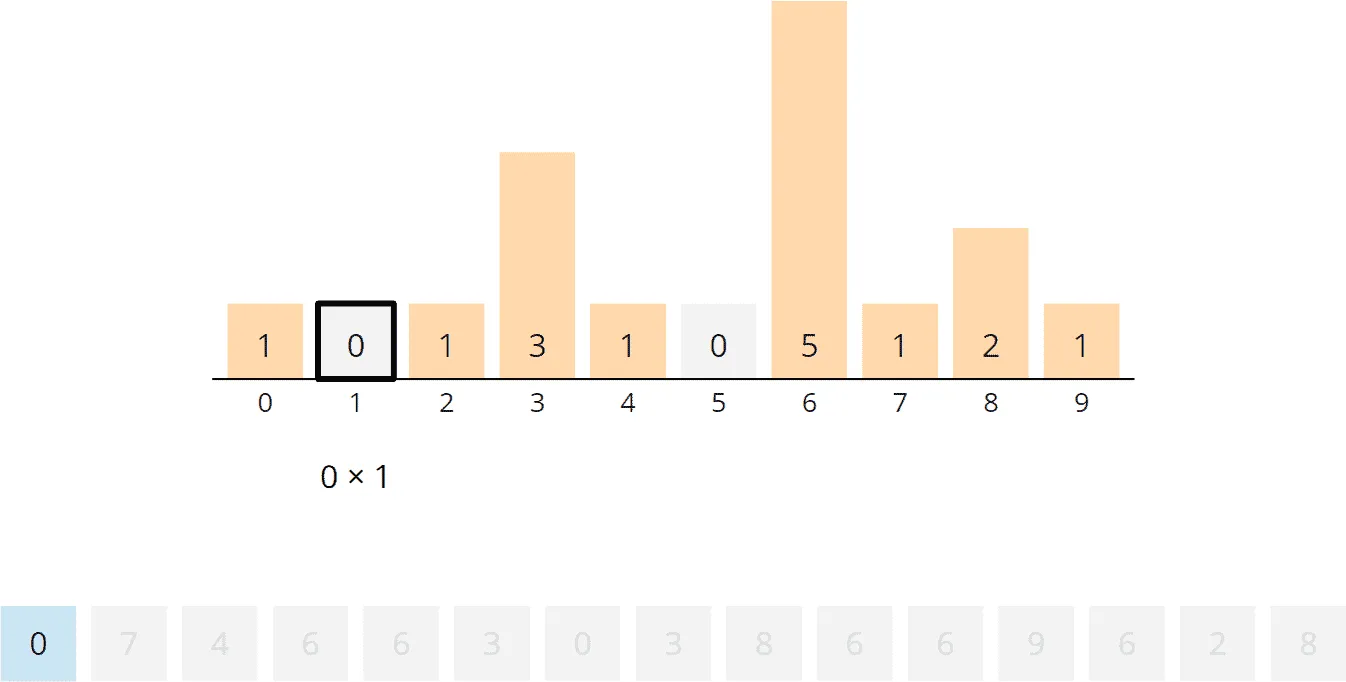
Position 2 des Histogramms enthält wieder eine 1; wir schreiben also einmal eine 2 in das zu sortierende Array:
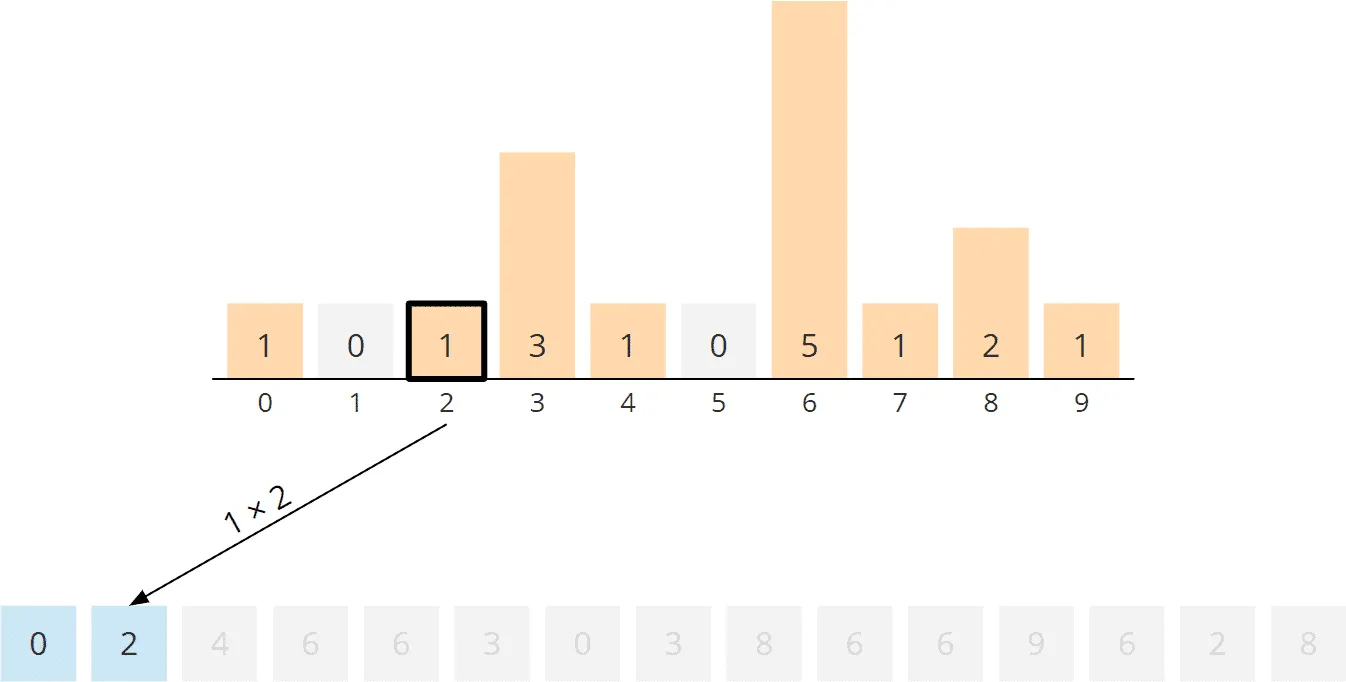
Kommen wir zu Position 3, diese enthält eine 3, wir schreiben also drei Mal eine 3 in das Array:
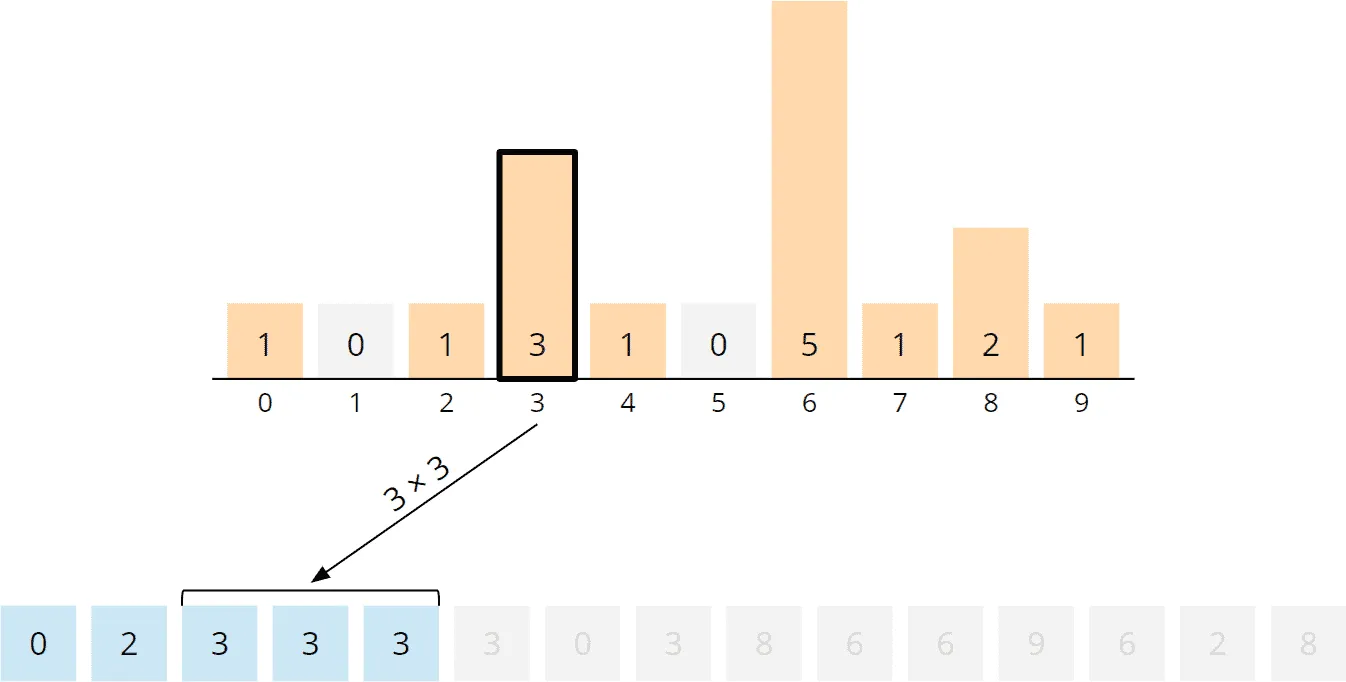
Und so geht es weiter: Wir schreiben einmal die 4, fünfmal die 6, einmal die 7, zweimal die 8 und zuletzt einmal die 9 in das zu sortierende Array:
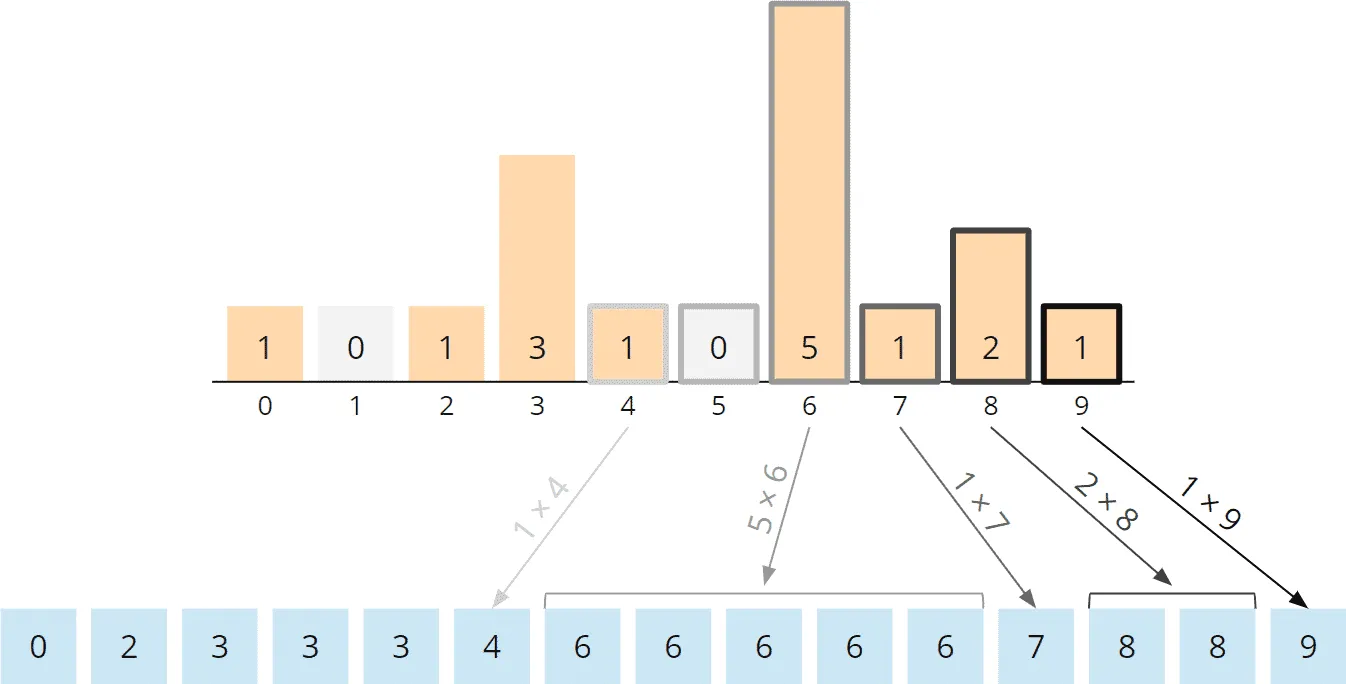
Die Zahlen sind sortiert, der Algorithmus ist beendet.
Counting Sort Java Code Beispiel (Vereinfachte Form)
Im Folgenden findest du eine sehr einfache Form des Counting-Sort-Quellcodes – diese funktioniert ausschließlich für nicht-negative int-Primitive (z. B. für das Array aus dem Beispiel oben).
Zunächst wird über die findMax()-Methode das größte Element im Array gefunden. Dann wird das Hilfsarray counts der entsprechenden Größe angelegt, wobei die Größe um eins größer ist als das größte Element, um auch die 0 mitzählen zu können.
Im mit „Phase 1“ kommentierten Block werden die Elemente gezählt, so dass das counts-Array schließlich das Histogramm enthält.
Im mit „Phase 2“ kommentierten Block werden die Elemente in aufsteigender Reihenfolge und entsprechend der im Histogramm hinterlegten Häufigkeit zurück in das zu sortierende Array geschrieben.
public class CountingSortSimple {

  public void sort(int[] elements) {
    int maxValue = findMax(elements);
    int[] counts = new int[maxValue + 1];

    // Phase 1: Count
    for (int element : elements) {
      counts[element]++;
    }

    // Phase 2: Write results back
    int targetPos = 0;
    for (int i = 0; i < counts.length; i++) {
      for (int j = 0; j < counts[i]; j++) {
        elements[targetPos++] = i;
      }
    }
  }

  private int findMax(int[] elements) {
    int max = 0;
    for (int element : elements) {
      if (element < 0) {
        throw new IllegalArgumentException(
            "This implementation does not support negative values.");
      }
      if (element > max) {
        max = element;
      }
    }
    return max;
  }

}
Das Maximum könnte auch mittels Arrays.stream(elements).max().getAsInt() ermittelt werden. Dann müssten wir allerdings die Prüfung auf negative Werte entweder weglassen oder in einem separaten Schritt durchführen.
Den Code findest du im GitHub-Repository in der Klasse CountingSortSimple.
Counting Sort Quellcode auch für negative Zahlen
Sollen auch negative Zahlen erlaubt sein, wird der Code etwas komplizierter, da wir mit einem sogenannten Offset arbeiten müssen, um die zu sortierende Zahl auf die Position im Hilfsarray zu mappen.
Berechnung des Offset
Der Offset ist: null minus die kleinste zu sortierende Zahl.
Ist beispielsweise −5 die kleinste zu sortierende Zahl, dann ist der Offset 5, d. h. der Index im Hilfsarray ist jeweils die zu sortierende Zahl plus 5.
Die −5 wird also beispielsweise an Position −5 + 5 = 0 gezählt; die 0 wird an Position 0 + 5 = 5 gezählt; die 11 wird an Position 11 + 5 = 16 gezählt.
Quellcode
Den folgenden Quellcode findest du in der Klasse CountingSort im GitHub-Repository. Er ähnelt dem oben gezeigten Quellcode bis auf folgende Unterschiede:
- Die Methode
findMax()ist ersetzt durch die MethodefindBoundaries(), die nicht nur den Maximal-, sondern auch den Minimalwert zurückgibt – als RecordBoundaries. findBoundaries()prüft außerdem, dass alle Elemente zwischenInteger.MIN_VALUE / 2undInteger.MAX_VALUE / 2liegen. Ohne diese Prüfung könnte die Berechnung der Hilfsarray-Längeboundaries.max() - boundaries.min() + 1denint-Wertebereich überschreiten.- Beim Zugriff auf das
counts-Array in der Zählphase wird dem jeweiligen Index der Offset-boundaries.min()hinzuaddiert (bzw.-Byte.MIN_VALUEoder-Short.MIN_VALUE). - Beim Zurückschreiben der sortierten Zahlen in das Array wird der Offset wieder abgezogen, indem
boundaries.min()(bzw.Byte.MIN_VALUEoderShort.MIN_VALUE) addiert wird.
public class CountingSort {

  private static final int MAX_VALUE_TO_SORT = Integer.MAX_VALUE / 2;
  private static final int MIN_VALUE_TO_SORT = Integer.MIN_VALUE / 2;

  public void sort(int[] elements) {
    Boundaries boundaries = findBoundaries(elements);
    int[] counts = new int[boundaries.max() - boundaries.min() + 1];

    // Phase 1: Count
    for (int element : elements) {
      counts[element - boundaries.min()]++;
    }

    // Phase 2: Write results back
    int targetPos = 0;
    for (int i = 0; i < counts.length; i++) {
      for (int j = 0; j < counts[i]; j++) {
        elements[targetPos++] = i + boundaries.min();
      }
    }
  }

  private Boundaries findBoundaries(int[] elements) {
    int min = Integer.MAX_VALUE;
    int max = Integer.MIN_VALUE;
    for (int element : elements) {
      if (element > MAX_VALUE_TO_SORT) {
        throw new IllegalArgumentException("Element " + element +
              " is greater than maximum " + MAX_VALUE_TO_SORT);
      }
      if (element < MIN_VALUE_TO_SORT) {
        throw new IllegalArgumentException("Element " + element +
              " is less than minimum " + MIN_VALUE_TO_SORT);
      }
      if (element > max) {
        max = element;
      }
      if (element < min) {
        min = element;
      }
    }
    return new Boundaries(min, max);
  }

  private record Boundaries(int min, int max) {}

}
Diese Variante hat nicht nur den Vorteil, auch negative Zahlen zählen zu können, sondern belegt auch weniger zusätzlichen Speicher als die erste Variante, falls der Zahlenraum nicht bei 0 beginnt: Für Zahlen von 1.000 bis 2.000 beispielsweise würde die erste Variante ein Hilfsarray mit 2.001 Feldern benötigen, Variante 2 hingegen nur 1.001 Felder.
Counting Sort Algorithmus (Allgemeine Form)
Mit Counting Sort können nicht nur Arrays von Primitiven (also byte, int, long, double usw.) sortiert werden, sondern auch Arrays von Objekten. Dazu müssen wir den Algorithmus, wie im folgenden Abschnitt beschrieben, erweitern.
Allgemeiner Algorithmus – Phase 1: Elemente zählen
Phase 1, die Zählphase, bleibt nahezu unverändert. Statt der Objekte selbst werden nun deren Schlüsselwerte (z. B. ermittelt durch eine getKey()-Methode) gezählt.
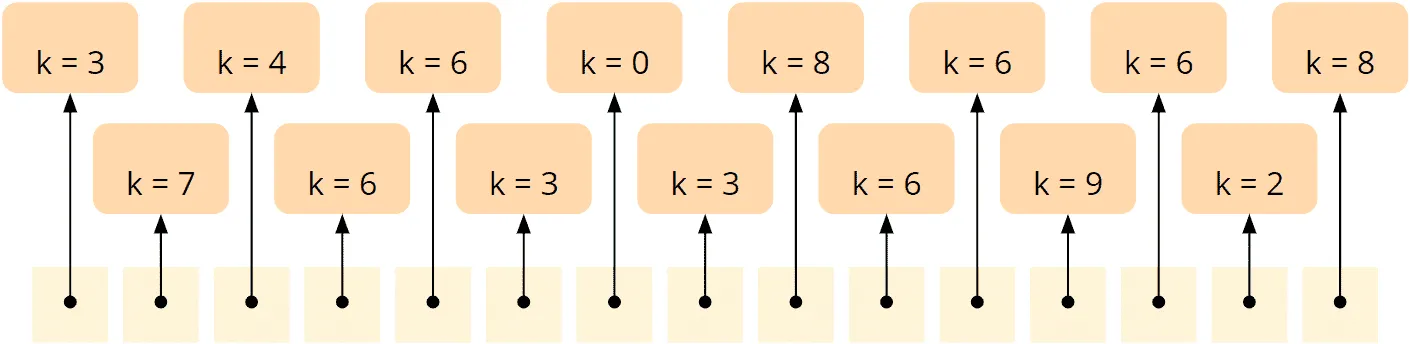
Das Array in der folgenden Grafik referenziert Objekte, deren Keys den Zahlen aus dem vorherigen Beispiel entsprechen, also 3, 7, 4, 6, 6 usw.:
Entsprechend gleicht das daraus entstandene Histogramm dem aus dem ersten Beispiel:
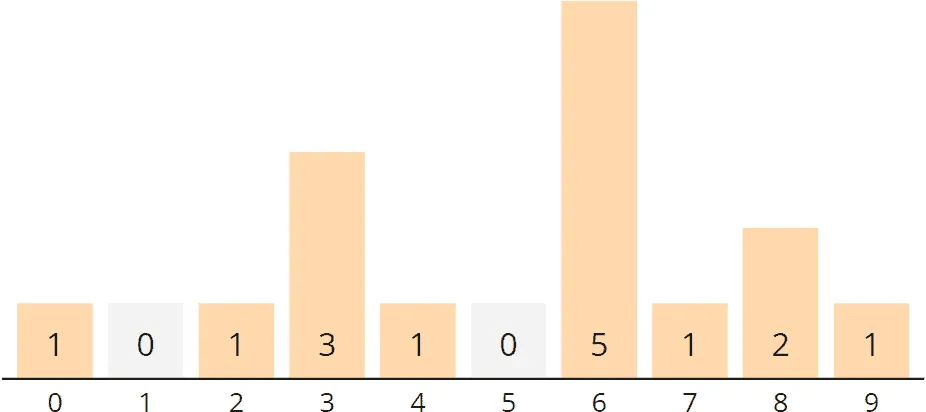
Allgemeiner Algorithmus – Phase 2: Histogramm aggregieren
Jetzt wird der Unterschied zum vereinfachten Algorithmus deutlich: Wir wissen jetzt zwar, dass das Element mit dem Key 0 ein Mal vorkommt, können aber nicht einfach eine 0 in das zu sortierende Array schreiben – vielmehr benötigen wir das Objekt mit dem Key 0!
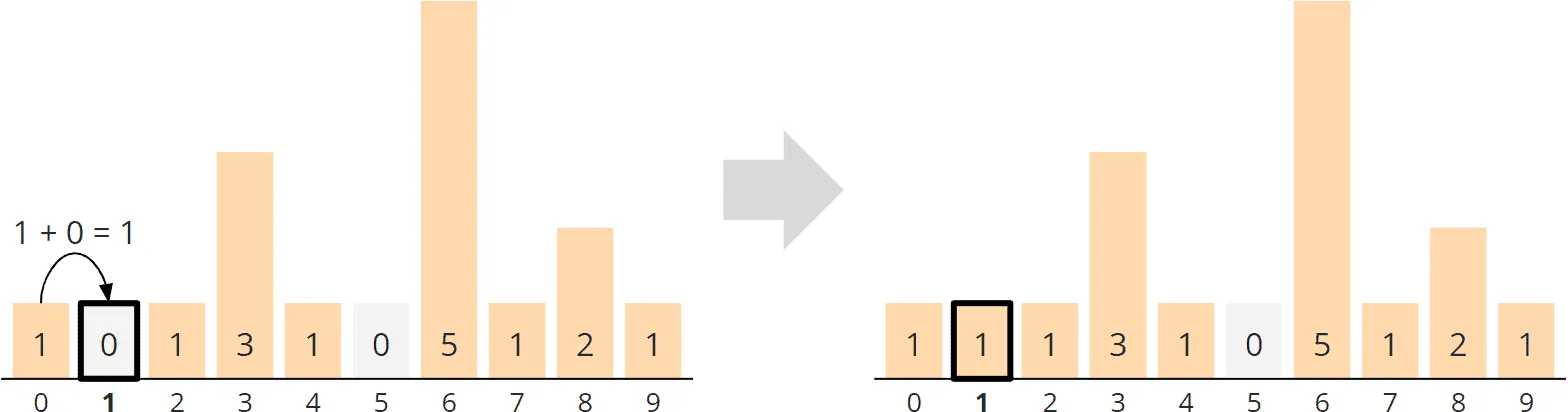
Um dies effizient zu finden, aggregieren wir zunächst die Werte im Histogramm. Dazu iterieren wir, beginnend bei Index 1, über das Hilfsarray und addieren zu jedem Feld den Wert des linken Nachbarfeldes.
An Position 1 addieren wir zur 0 den Wert von Feld 0, also die 1. Die Summe ist 1:
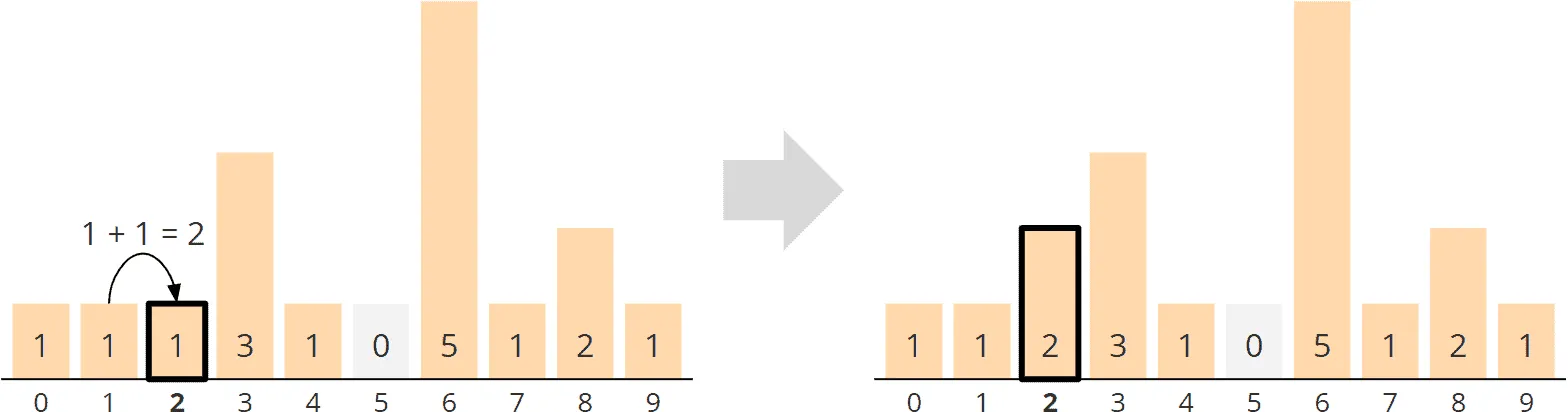
An Position 2 addieren wir zur 1 die 1 von Feld 1 und erhalten eine 2:
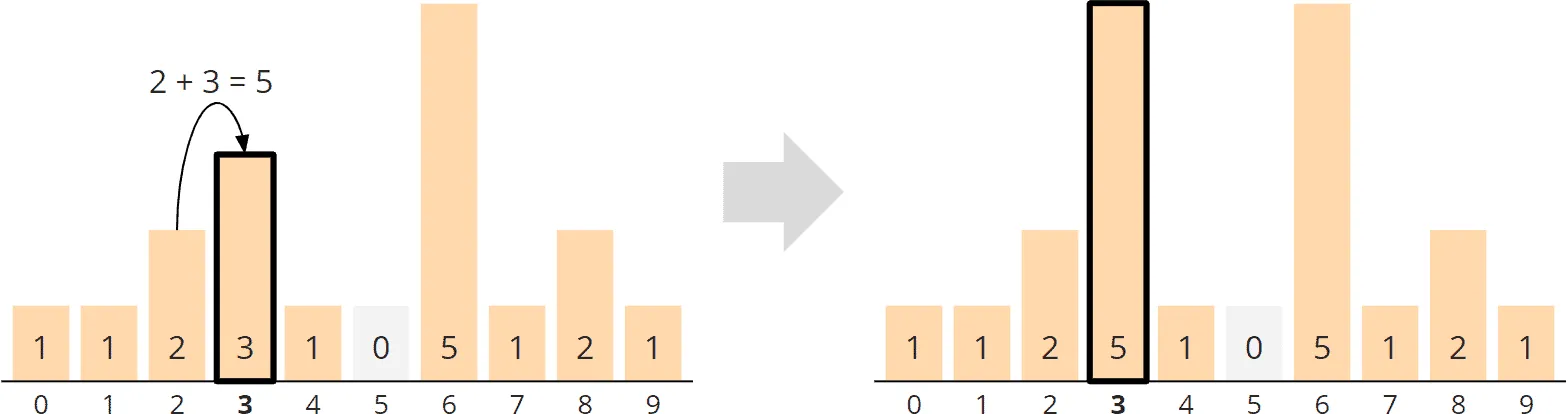
Zur 3 an Position 3 addieren wir die 2 von Feld 2 – die Summe ist 5:
Und so fahren wir fort, bis wir letztendlich zur 1 in Feld 9 die 14 von Feld 8 addieren und 15 erhalten:
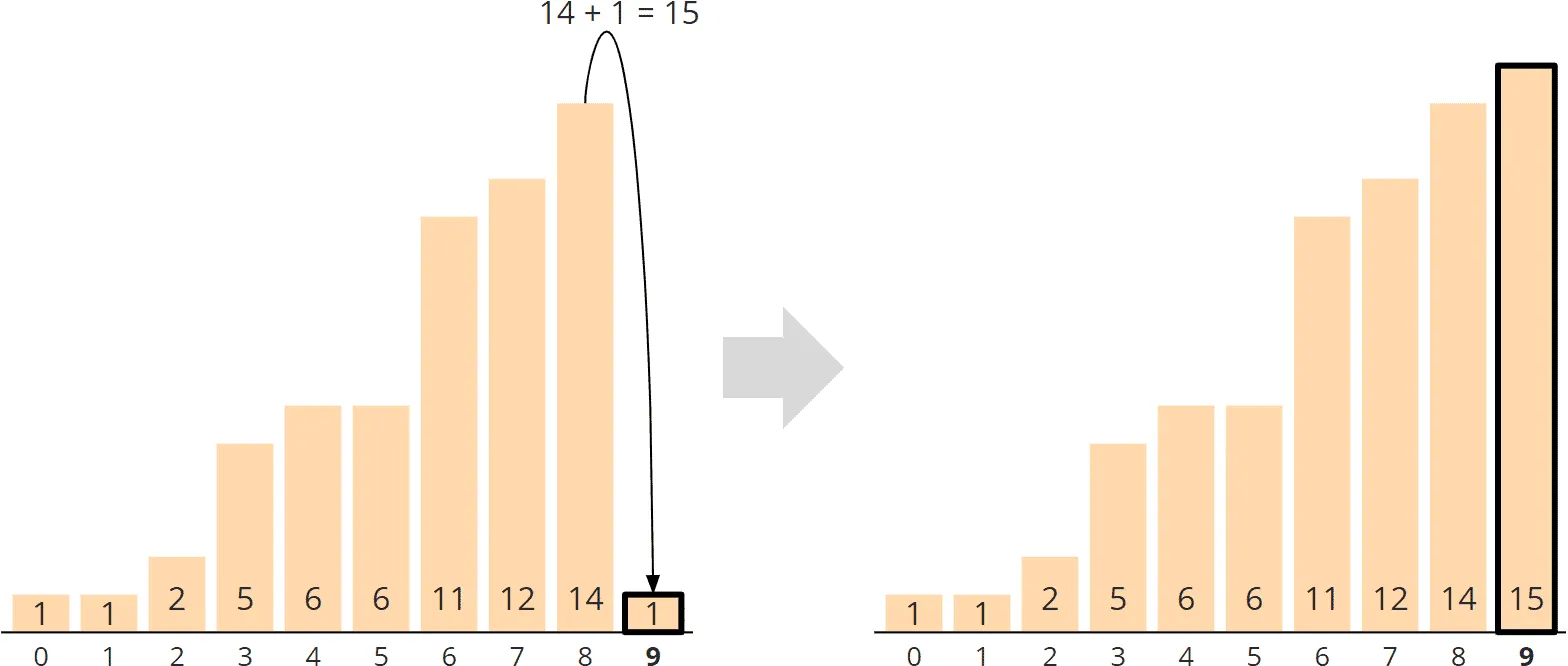
Dieses aggregierte Histogramm sagt uns jetzt nicht mehr, wie oft die Objekte mit bestimmten Keys vorkommen, sondern an welche Position das letzte Element mit dem entsprechenden Key gehört. Die Position ist hierbei 1-basiert, nicht 0-basiert.
Beispielsweise gehört das Objekt mit Key 0 an Position 1 (entspricht Index 0 im Array), das Objekt mit Key 2 an Position 2 (Array-Index 1) und die drei Objekte mit Key 3 an die Positionen 3, 4 und 5 (Array-Indexe 2, 3, 4).
Allgemeiner Algorithmus – Phase 3: Objekte sortiert zurückschreiben
Um die Objekte zu sortieren, benötigen wir ein zusätzliches Array in der Größe des Eingabearrays:
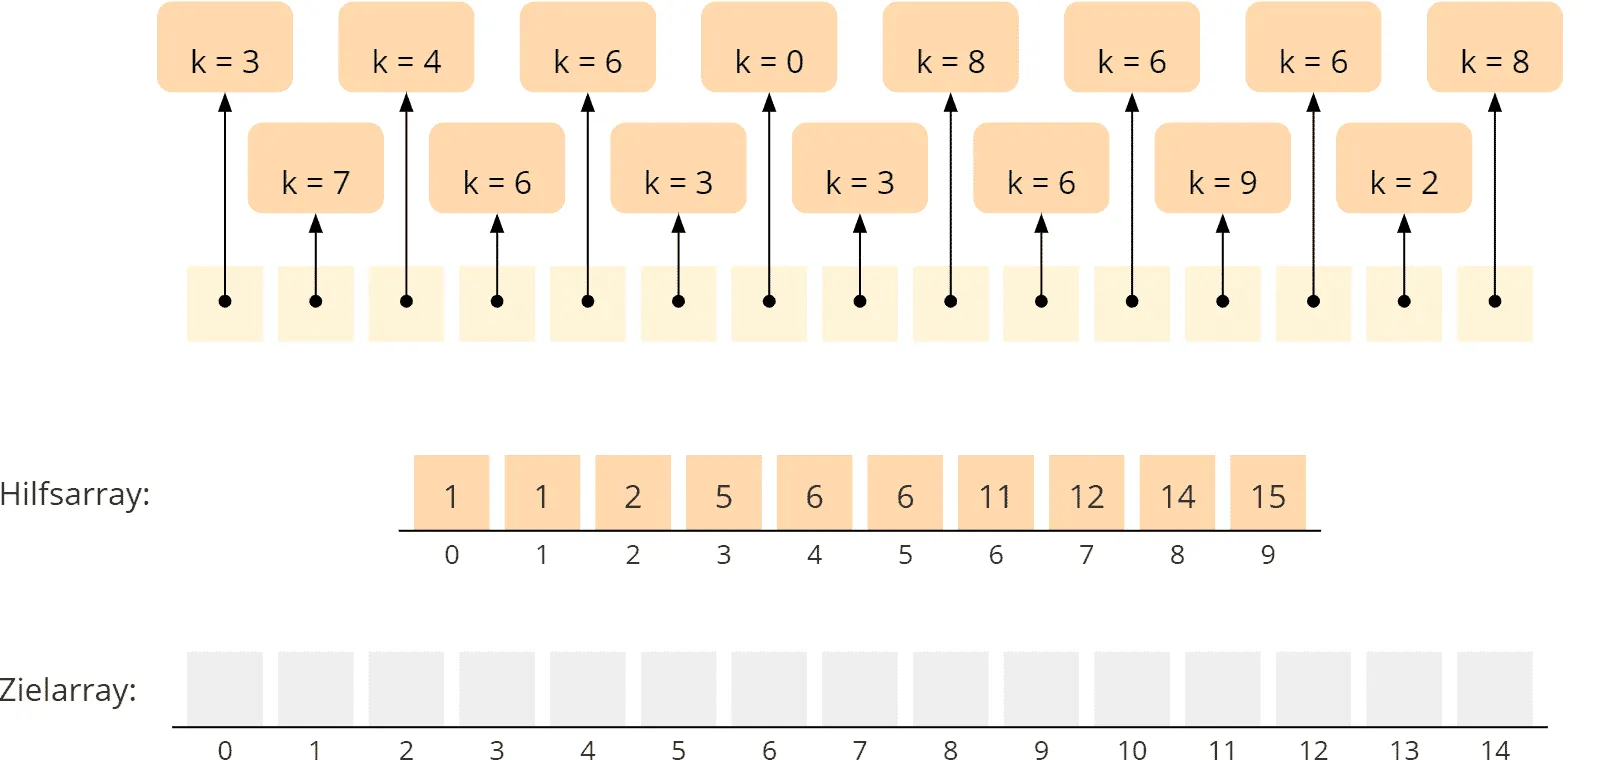
Wir iterieren nun rückwärts über das zu sortierende Array und schreiben jedes Objekt im Zielarray an diejenige Position, die durch das Hilfsarray angezeigt wird. Wir dekrementieren den entsprechenden Wert im Hilfsarray um 1, um ggf. das nächste Objekt mit demselben Key ein Feld weiter links einzusortieren.
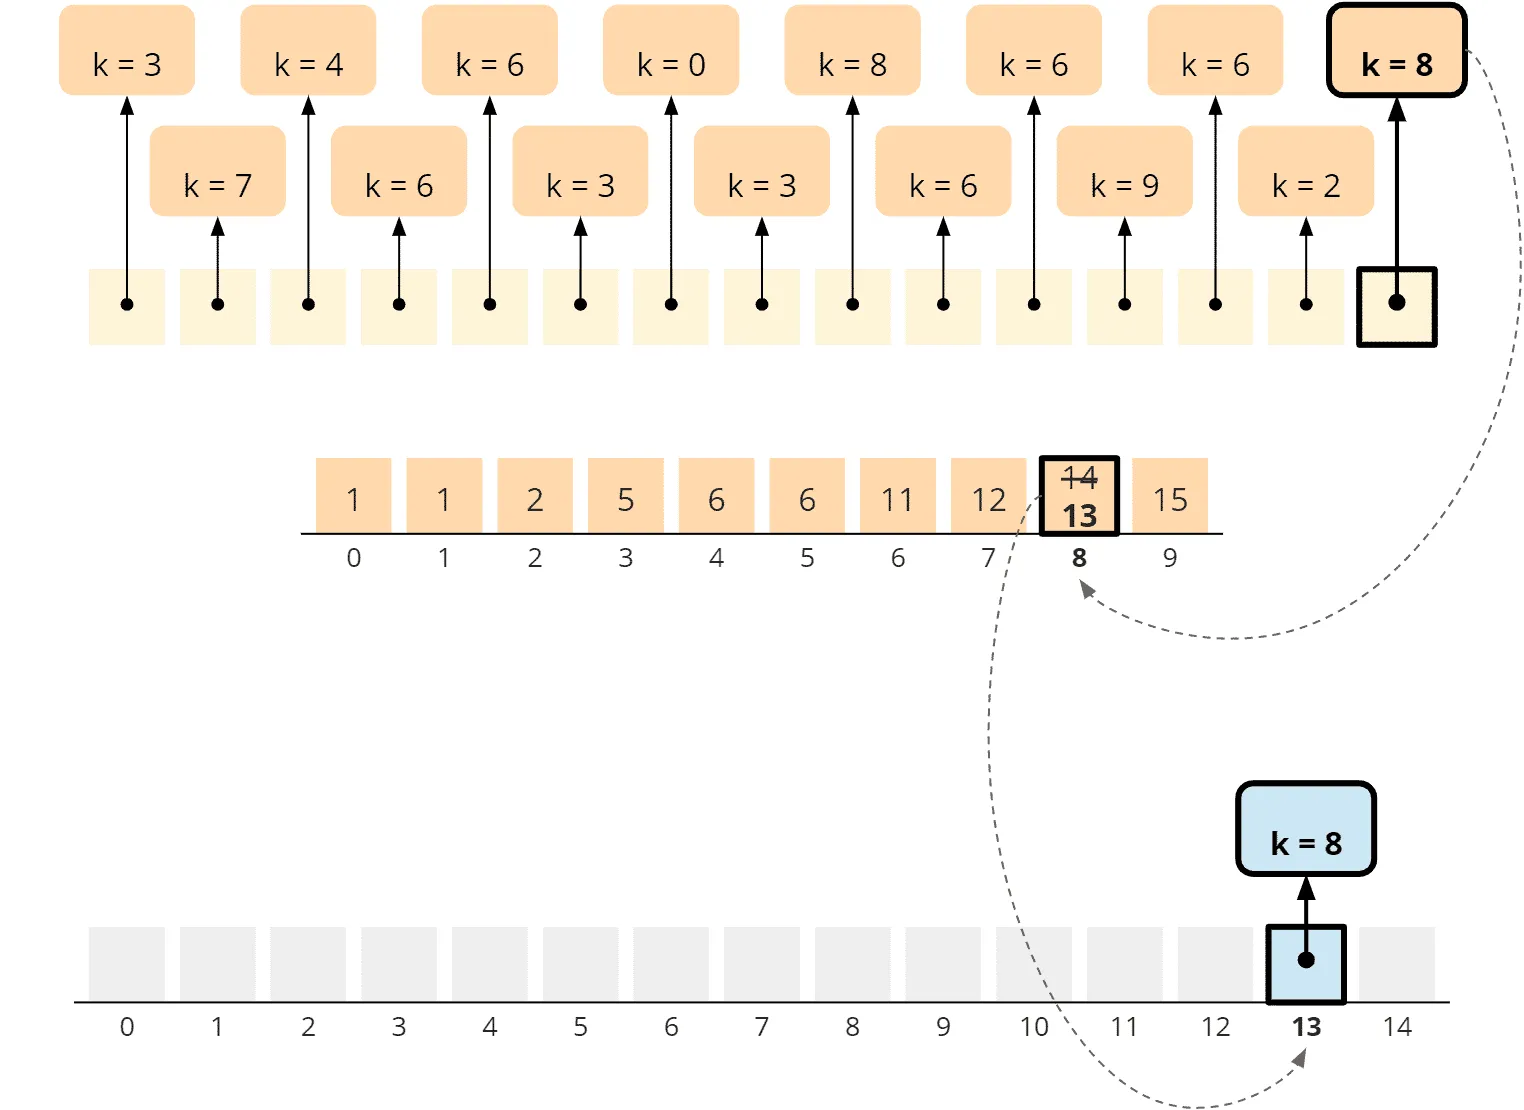
Beginnen wir im Eingabearray ganz rechts – mit dem Objekt mit dem Key 8. Im Hilfsarray steht an Position 8 der Wert 14. Wir dekrementieren den Wert auf 13 und kopieren das Objekt mit dem Key 8 in das Zielarray an Position 13 (zur Erinnerung: die Positionsangaben im Hilfsarray sind 1-basiert, deshalb schreiben wir auf Position 13, nicht 14).
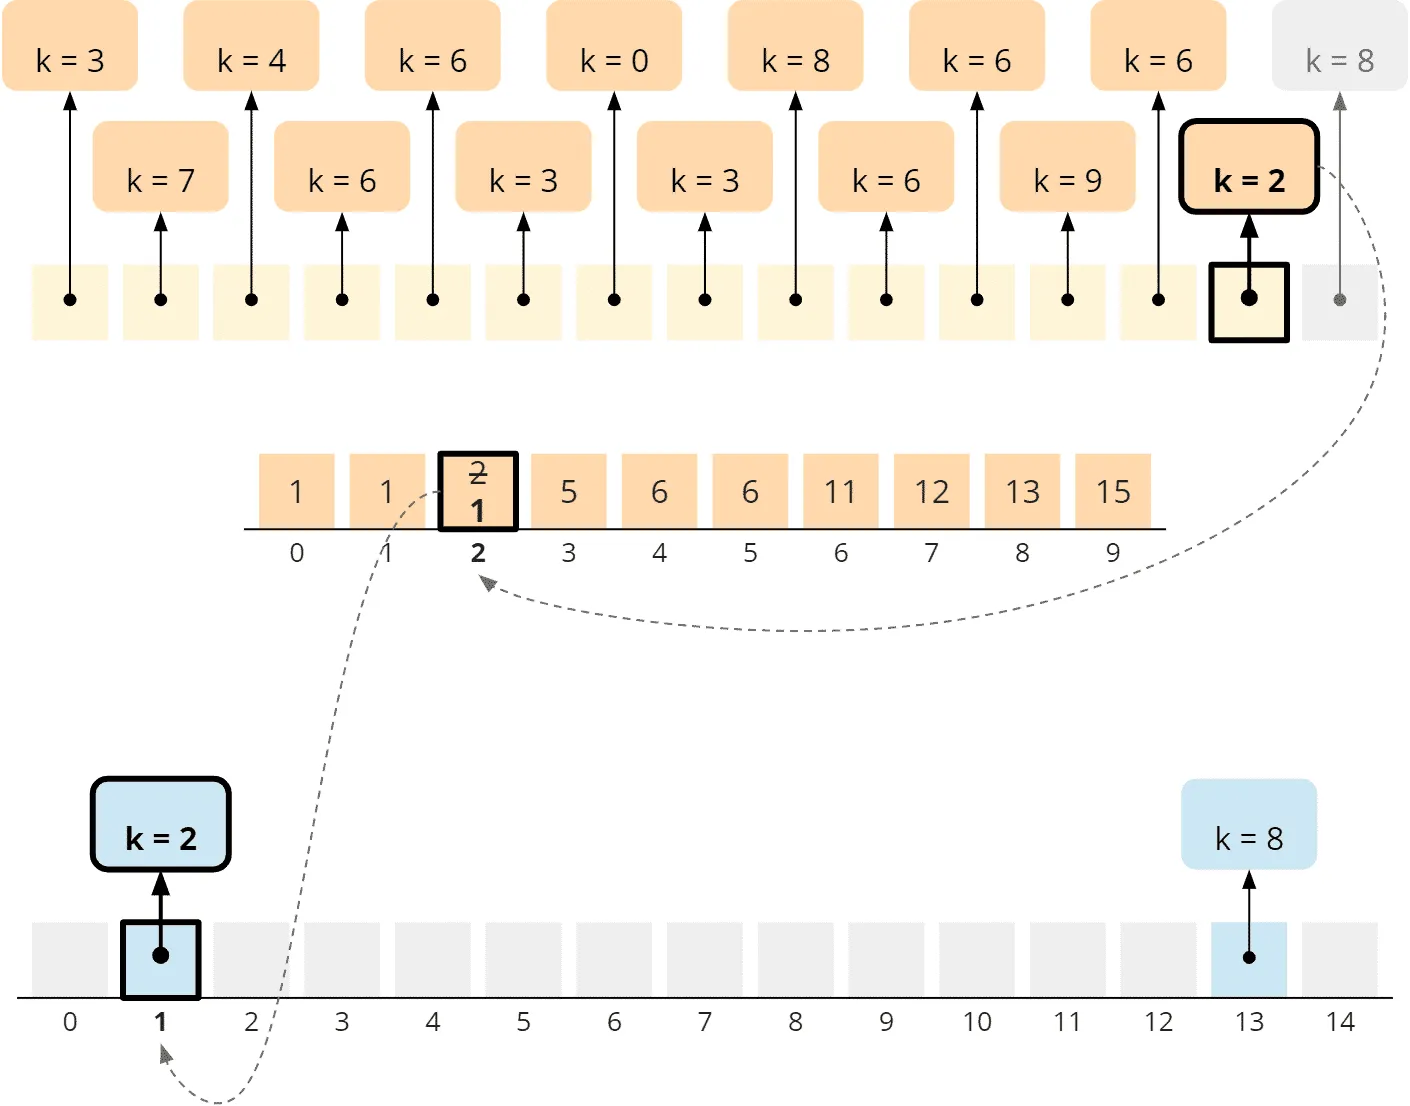
Das zweite Objekt von rechts hat den Key 2. Im Hilfsarray steht an Position 2 der Wert 2. Wir dekrementieren den Wert im Hilfsarray auf 1 und kopieren das Objekt an die entsprechende Position im Zielarray:
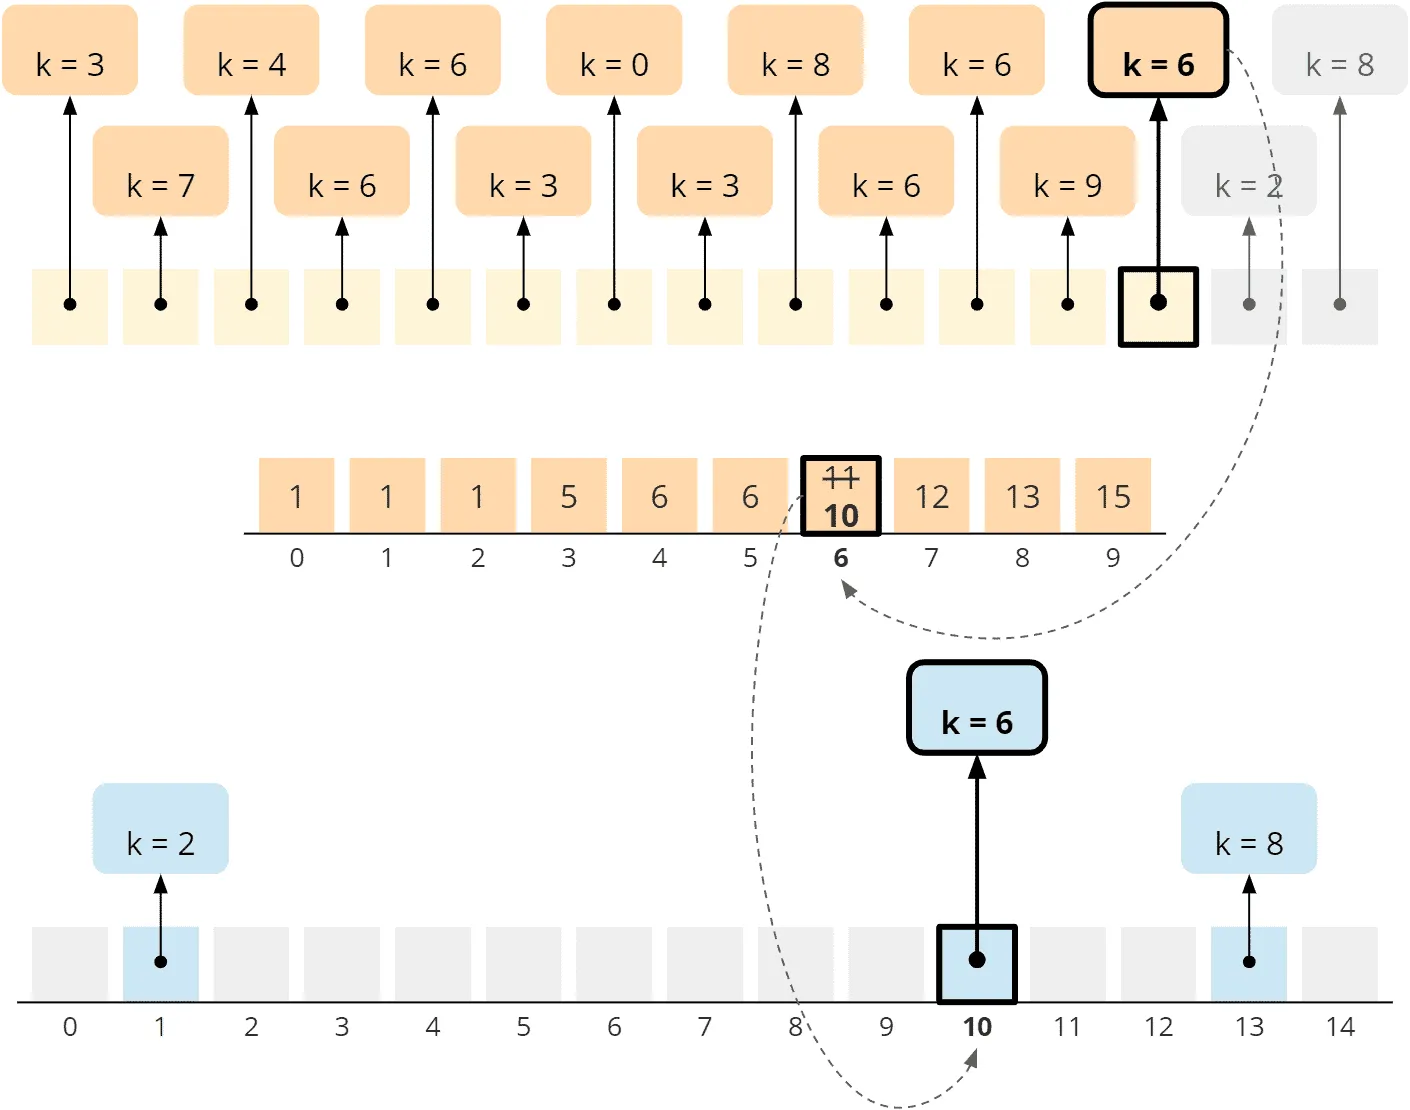
Das nächste Objekt hat den Key 6. Im Hilfsarray steht an Position 6 die 11. Wir dekrementieren das Feld auf 10 und kopieren das Objekt nach Feld 10 im Zielarray:
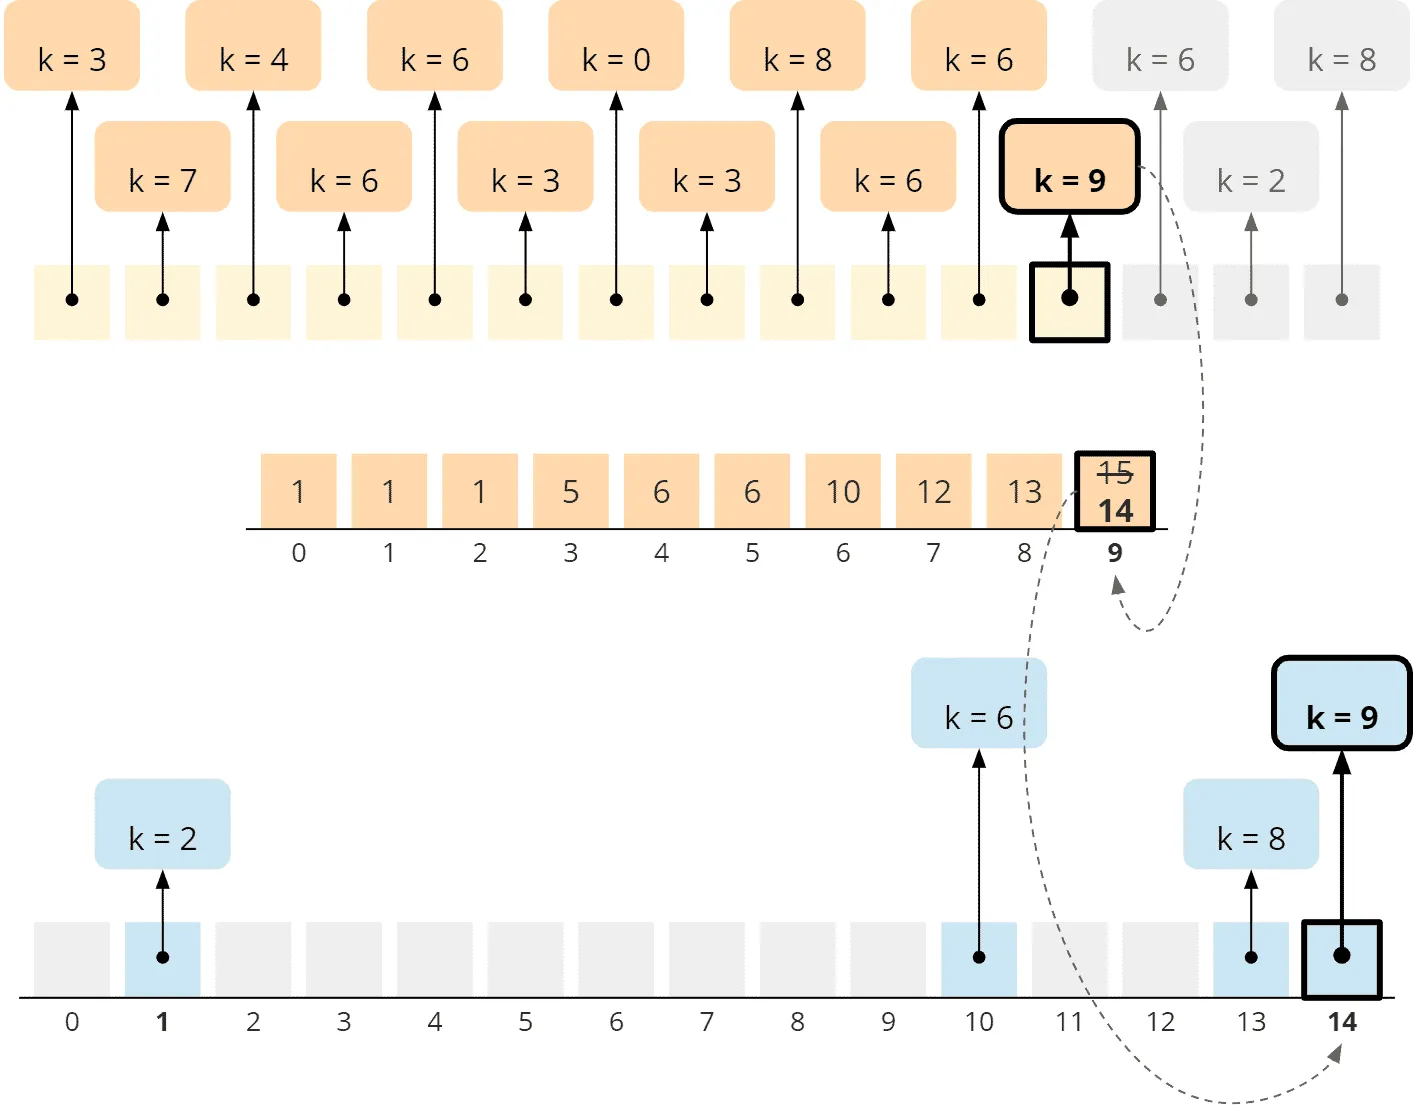
Derselben Logik folgend kopieren wir das Objekt mit dem Key 9 an Position 14 des Zielarrays:
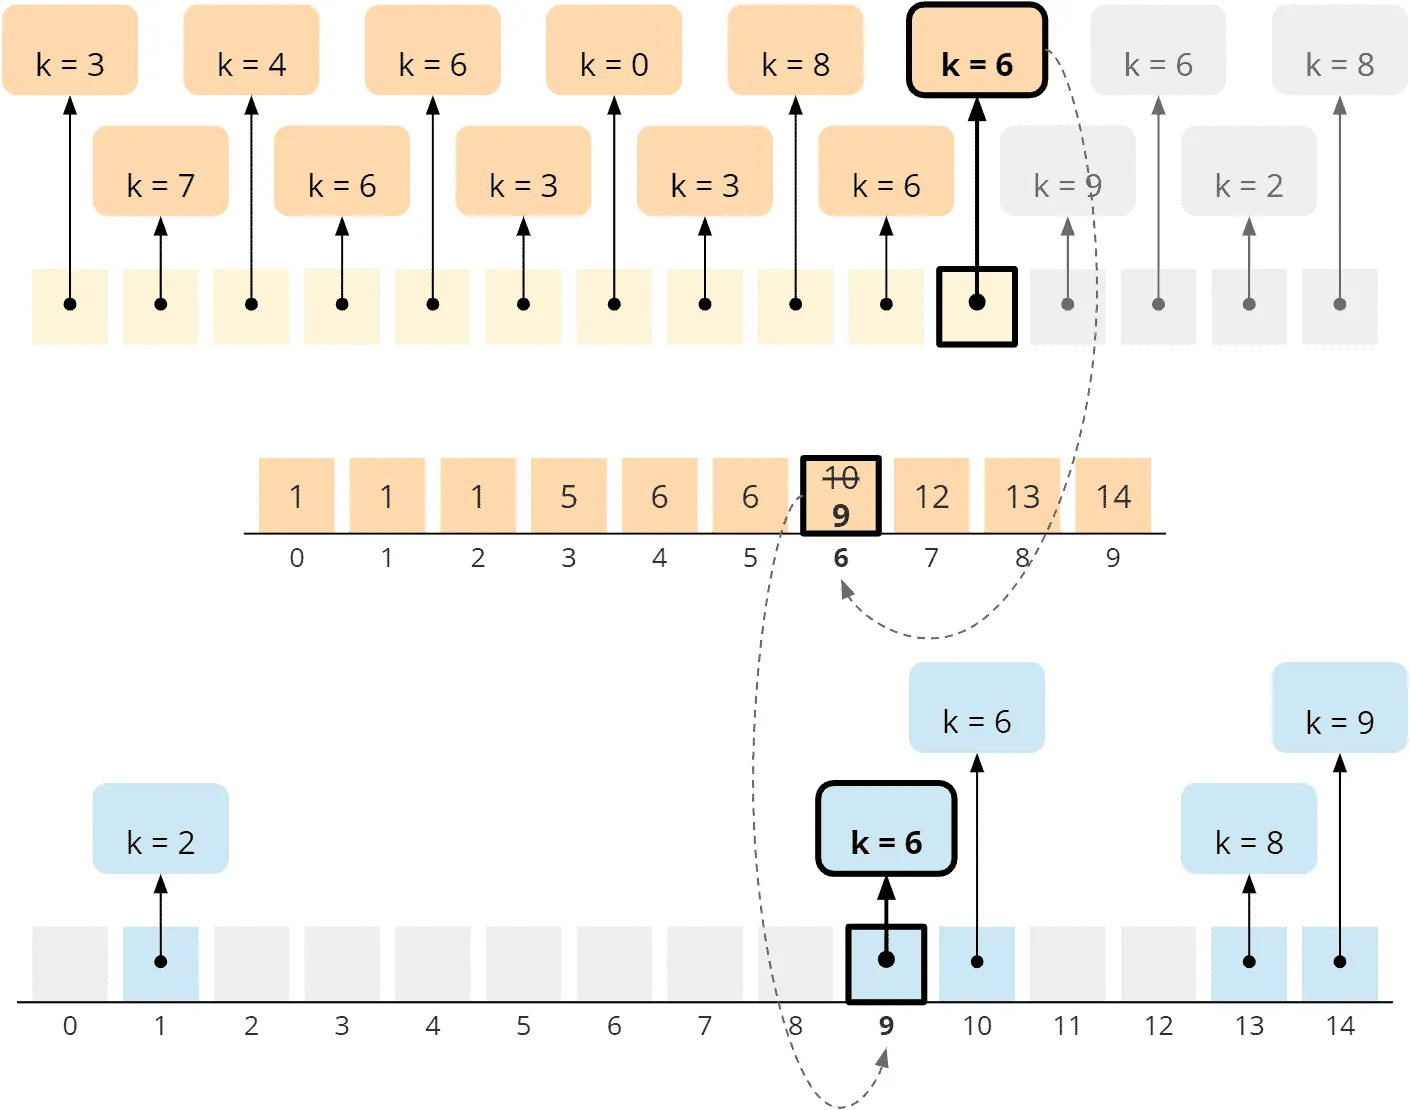
Es folgt eine weitere 6. Im Hilfsarray steht an Position 6 jetzt die 10 (nachdem wir zuvor dort die 11 dekrementiert hatten). Wir dekrementieren das Feld erneut auf 9 und kopieren das Objekt nach Position 9 im Zielarray, also links neben das andere Objekt mit dem Key 6:
Wir wiederholen diese Schritte für alle Elemente und kommen als Letztes zum Objekt mit dem Key 3. An Feld 3 im Hilfsarray steht nun eine 3. Diese dekrementieren wir auf 2 und kopieren das Objekt auf Position 2, die letzte freie Position, des Zielarrays:
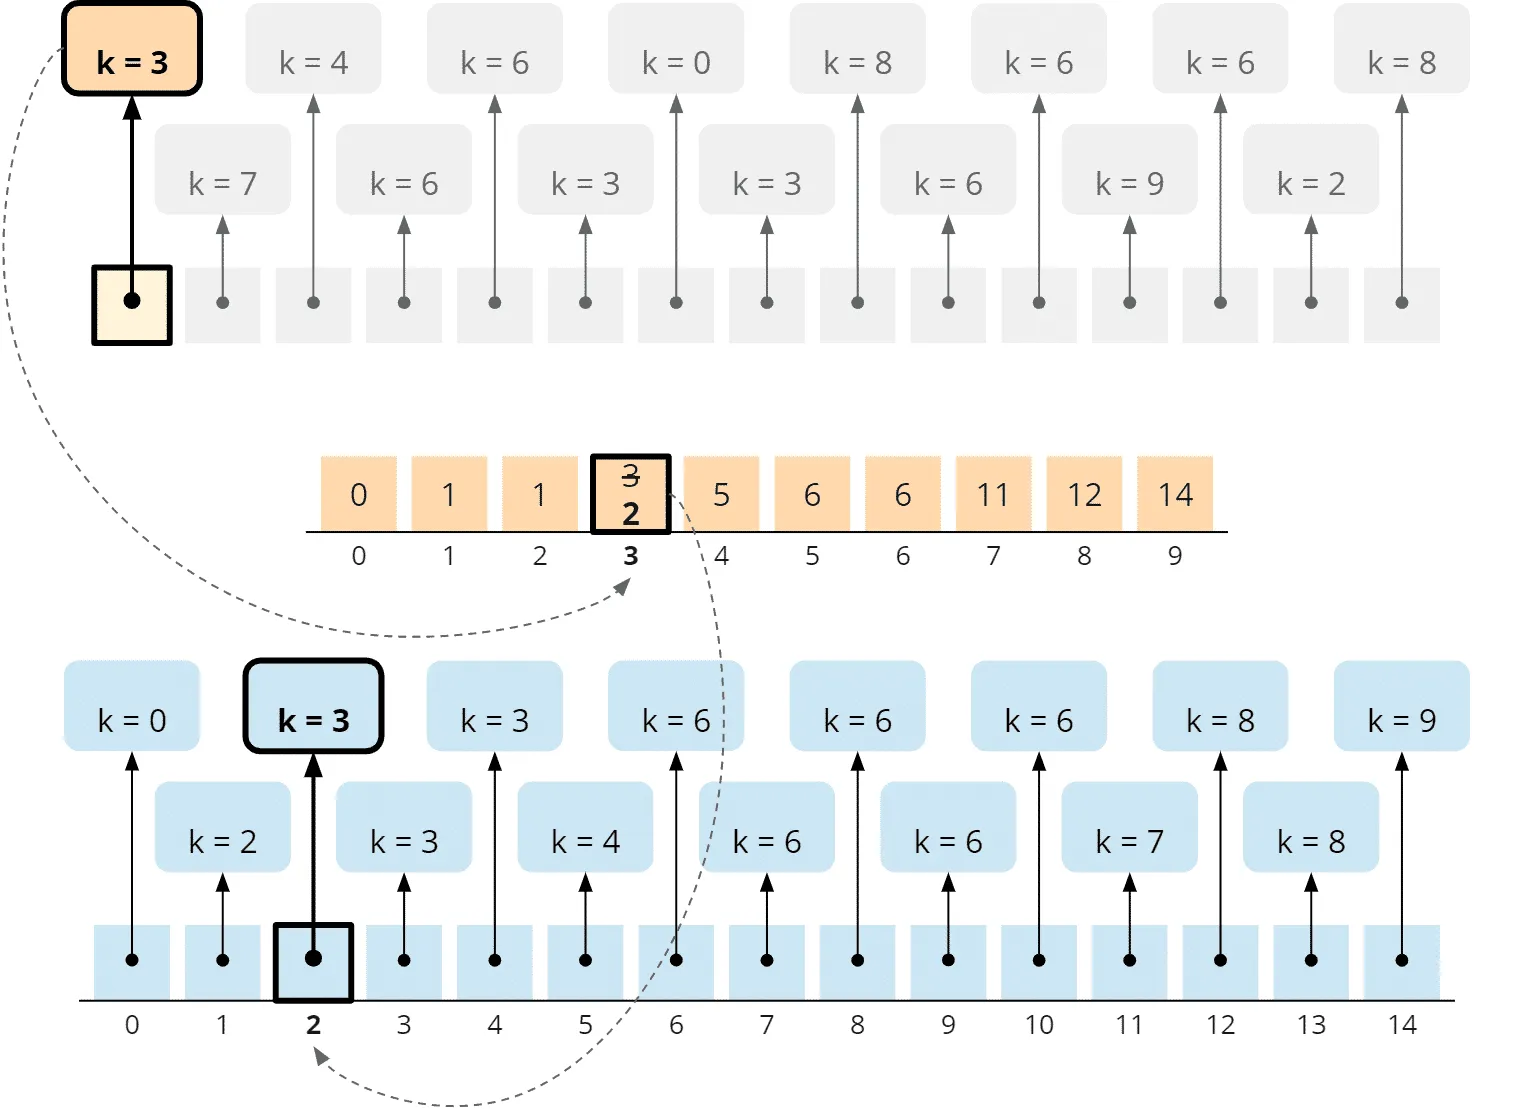
Die Objekte sind sortiert, der Algorithmus ist beendet.
Counting Sort Java Code Beispiel (Allgemeine Form)
Der folgende Code demonstriert die allgemeine Form von Counting Sort der Einfachheit halber an int-Primitiven. Die findMax()-Methode gleicht der im ersten Quellcode-Beispiel, ich habe sie daher hier nicht noch einmal mit abgedruckt.
public class CountingSortGeneral {

  public void sort(int[] elements) {
    int maxValue = findMax(elements);
    int[] counts = new int[maxValue + 1];

    // Phase 1: Count
    for (int element : elements) {
      counts[element]++;
    }

    // Phase 2: Aggregate
    for (int i = 1; i <= maxValue; i++) {
      counts[i] += counts[i - 1];
    }

    // Phase 3: Write to target array
    int[] target = new int[elements.length];
    for (int i = elements.length - 1; i >= 0; i--) {
      int element = elements[i];
      target[--counts[element]] = element;
    }

    // Copy target back to input array
    System.arraycopy(target, 0, elements, 0, elements.length);
  }

  [...]

}
Du findest den Quellcode in der Klasse CountingSortGeneral im GitHub-Repository.
Counting Sort Zeitkomplexität
Die Zeitkomplexität von Counting Sort ist aufgrund des sehr einfachen Algorithmus leicht bestimmbar.
Sei n die Anzahl der zu sortierenden Elemente und k die Größe des Zahlenraums der Elemente.
Der Algorithmus enthält eine oder mehrere Schleifen, die bis n iterieren, und eine Schleife, die bis k iteriert.
Konstante Faktoren sind für die Zeitkomplexität irrelevant; somit gilt:
Die Zeitkomplexität von Counting Sort beträgt: O(n + k).
Laufzeit des Java Counting Sort Beispiels
Das GitHub-Repository enthält das Programm UltimateTest, mit dem wir die Geschwindigkeit von Counting Sort und aller anderen Sortieralgorithmen dieser Artikelserie messen können.
Die folgende Tabelle zeigt die benötigte Zeit zum Sortieren von unsortierten sowie aufsteigend und absteigend vorsortierten Elementen für die jeweils angegebene Anzahl von Elementen n, die in diesen Messungen auch der Größe des Zahlenraums k entspricht:
| n, k | unsortiert | aufsteigend | absteigend |
|---|---|---|---|
| ... | ... | ... | ... |
| 33.554.432 | 263 ms | 43 ms | 47 ms |
| 67.108.864 | 552 ms | 85 ms | 94 ms |
| 134.217.728 | 1.130 ms | 169 ms | 188 ms |
| 268.435.456 | 2.286 ms | 338 ms | 377 ms |
| 536.870.912 | 4.613 ms | 676 ms | 756 ms |
Das folgende Diagramm stellt die Messwerte grafisch dar:
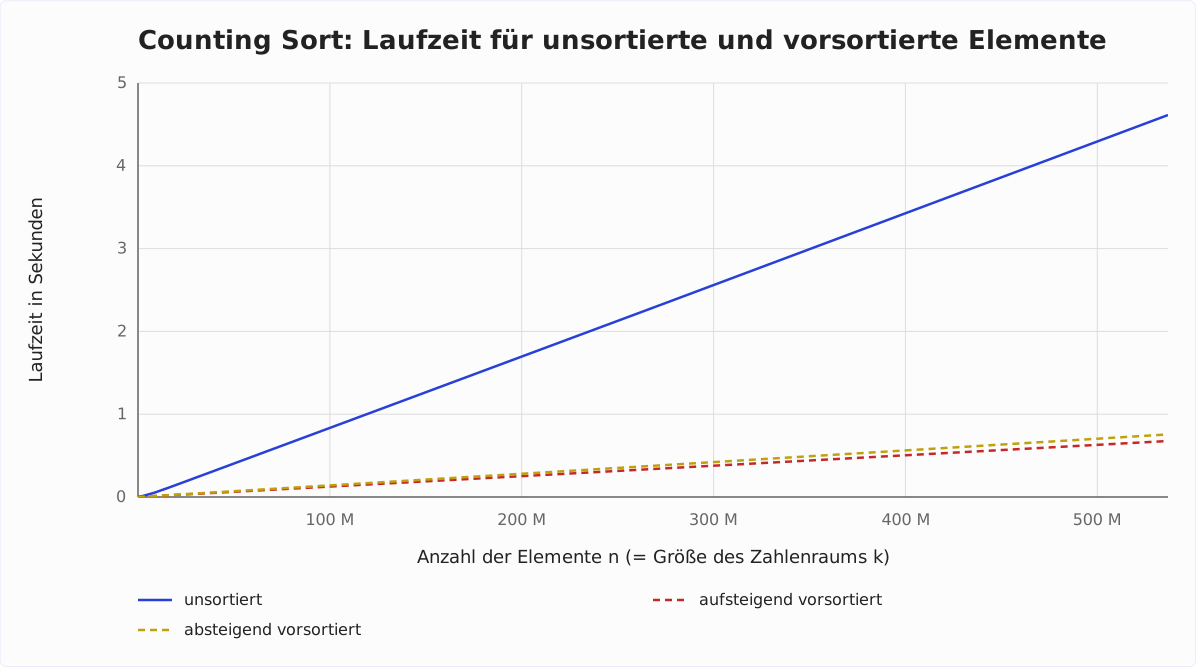
Es lässt sich Folgendes ablesen:
- Vorsortierte Ausgangsfolgen mit einer halben Milliarde Elemente werden knapp siebenmal so schnell sortiert wie unsortierte (676 ms statt 4.613 ms). Auf dem Intel-Laptop von 2020 war es Faktor neun (2.945 ms statt 27.249 ms).
- Bei vorsortierten Ausgangsfolgen entsprechen die Messwerte der erwarteten linearen Zeitkomplexität O(n + k).
- Für unsortierte Ausgangsfolgen liegen die Messwerte etwas darüber: Bei einer Verdopplung der Arraygröße nimmt die benötigte Zeit um Faktor 2,02 bis 2,10 zu – 2020 waren es 2,1 bis 2,2.
- Absteigend sortierte Ausgangsfolgen werden 10 bis 12 Prozent langsamer sortiert als aufsteigend vorsortierte; 2020 waren es 2 bis 8 Prozent.
Wenn Elemente nicht umsortiert, sondern gezählt und einmal komplett neu angeordnet werden, dürfte doch die Ausgangsreihenfolge keine Auswirkung auf die zum Sortieren benötigte Zeit haben!?
Mit dem Programm CountOperations können wir messen, wie viele Operationen für das Sortieren benötigt werden. Und tatsächlich bestätigt das Ergebnis (s. Datei CountOperations_Counting_Sort.log):
- Die Anzahl der Operationen ist unabhängig von der Ausgangsreihenfolge der Elemente.
- Die Anzahl der Operationen entspricht der erwarteten Zeitkomplexität O(n + k), steigt also linear mit der Anzahl der zu sortierenden Elemente und der Größe des Zahlenraums.
Wie kommen dann diese abweichenden Messwerte zustande? Erklärungen findest du in den folgenden Abschnitten.
Warum ist Counting Sort für vorsortierte Elemente schneller als für unsortierte Elemente?
Ein Hilfsarray mit einer halben Milliarde Elemente ist 2 GB groß. Wenn dessen Elemente in zufälliger Reihenfolge inkrementiert werden, muss beinahe für jedes Element eine neue Cache-Line (64 Byte auf x86-CPUs, 128 Byte auf Apple Silicon) zwischen RAM und CPU-Cache ausgetauscht werden. Die Wahrscheinlichkeit, dass die benötigte Cache-Line im CPU-Cache liegt, ist umso niedriger, je größer das Array ist.
Wird das Array hingegen von vorne nach hinten (oder von hinten nach vorne) inkrementiert, können jeweils 16 aufeinanderfolgende int-Werte (bei 128-Byte-Cache-Lines 32) in einem Block aus dem RAM geladen und wieder dorthin geschrieben werden.
Die folgende Grafik zeigt das Hilfsarray als Folge von Cache-Lines zu 64 Byte, also je 16 int-Zählern – ein Kästchen pro Zähler. Hervorgehoben sind die Zähler, die die gezeigten Inkremente treffen. Oben landen sechs aufeinanderfolgende Inkremente einer sortierten Eingabe in derselben Cache-Line, unten trifft bei unsortierter Eingabe jedes Inkrement eine andere:
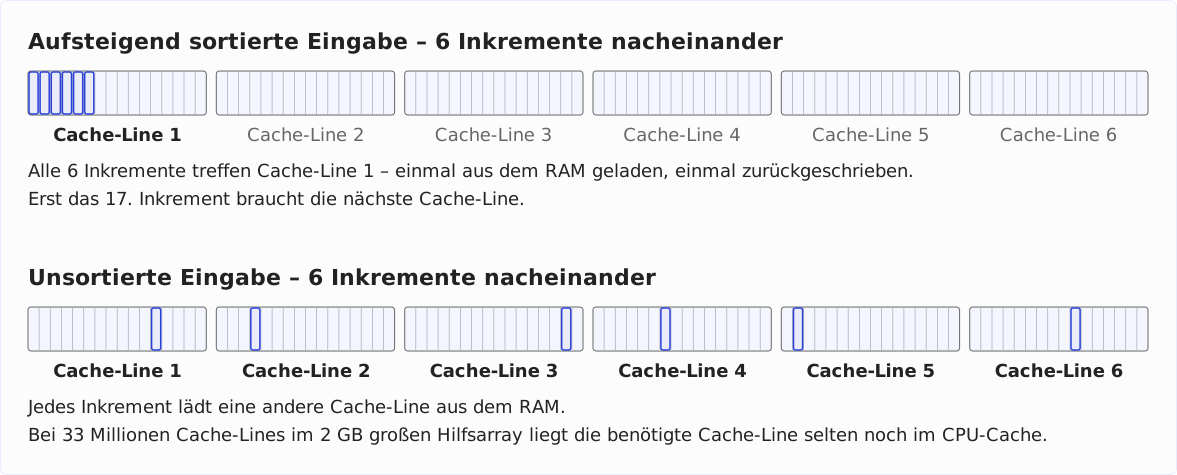
Das theoretische Maximum von Faktor 16 – auf dem M5 Pro mit seinen 128-Byte-Cache-Lines sogar 32 – wird nicht erreicht: Es bleibt bei knapp Faktor sieben, auf dem Intel-Laptop von 2020 waren es neun.
Warum erreicht Counting Sort in der Praxis keine lineare Zeitkomplexität für unsortierte Ausgangsfolgen?
Je größer das zu sortierende Array, desto höher wird bei einem unsortierten Ausgangsarray das Verhältnis von Cache Misses zu Cache Hits beim Zugriff auf das Hilfsarray (denn die Größe des CPU-Caches bleibt ja gleich).
Bei einem doppelt so großen Array haben wir also nicht doppelt so viele Cache Misses, sondern etwas mehr als doppelt so viele. Dementsprechend erhöht sich die benötigte Zeit auch um etwas mehr als Faktor zwei.
Warum ist Counting Sort für aufsteigend sortierte Elemente schneller als für absteigend sortierte?
Der Unterschied entsteht in Phase 1. Bei aufsteigend sortierter Eingabe werden die Zähler im Hilfsarray von vorne nach hinten inkrementiert, bei absteigend sortierter Eingabe von hinten nach vorne – Phase 2 läuft in beiden Fällen identisch ab.
Vorwärts laufende Zugriffe sind der Fall, für den der Hardware-Prefetcher der CPU optimiert ist: Er erkennt das Muster und lädt die nächsten Cache-Lines, bevor das Programm sie anfordert. Rückwärts laufende Zugriffe unterstützt er weniger gut. Der Preis sind die 10 bis 12 Prozent, die du in der Tabelle oben siehst; auf dem Intel-Laptop von 2020 waren es 2 bis 8 Prozent.
Weitere Eigenschaften von Counting Sort
In diesem Kapitel bestimmen wir die Platzkomplexität, die Stabilität und die Parallelisierbarkeit von Counting Sort.
Platzkomplexität von Counting Sort
Der vereinfachte Algorithmus benötigt ein zusätzliches Array der Größe k; es gilt entsprechend:
Die Platzkomplexität des vereinfachten Counting-Sort-Algorithmus ist: O(k).
Der allgemeine Algorithmus benötigt neben dem Hilfsarray der Größe k ein temporäres Zielarray der Größe n; somit gilt:
Die Platzkomplexität des allgemeinen Counting-Sort-Algorithmus ist: O(n + k).
Stabilität von Counting Sort
Die allgemeine Form des Counting-Sort-Algorithmus iteriert in Phase 3 von rechts nach links über das Eingabearray und kopiert dabei Objekte mit demselben Key ebenfalls von rechts nach links in das Zielarray. Somit gilt:
Counting Sort ist ein stabiler Sortieralgorithmus.
Parallelisierbarkeit von Counting Sort
Counting Sort kann parallelisiert werden, indem das Eingabearray in so viele Partitionen geteilt wird, wie Prozessoren zur Verfügung stehen.
In Phase 1 zählt jeder Prozessor die Elemente „seiner“ Partition in einem separaten Hilfsarray.
In Phase 2 werden alle Hilfsarrays zu einem aufaddiert.
In Phase 3 kopiert jeder Prozessor die Elemente „seiner“ Partition ins Zielarray. Das Dekrementieren und Auslesen der Felder im Hilfsarray muss dabei atomar erfolgen – und damit geht die Stabilität verloren: Welcher Prozessor bei gleichem Key zuerst dekrementiert, ist Zufall. Die Elemente landen also nicht mehr in ihrer ursprünglichen Reihenfolge im Zielarray.
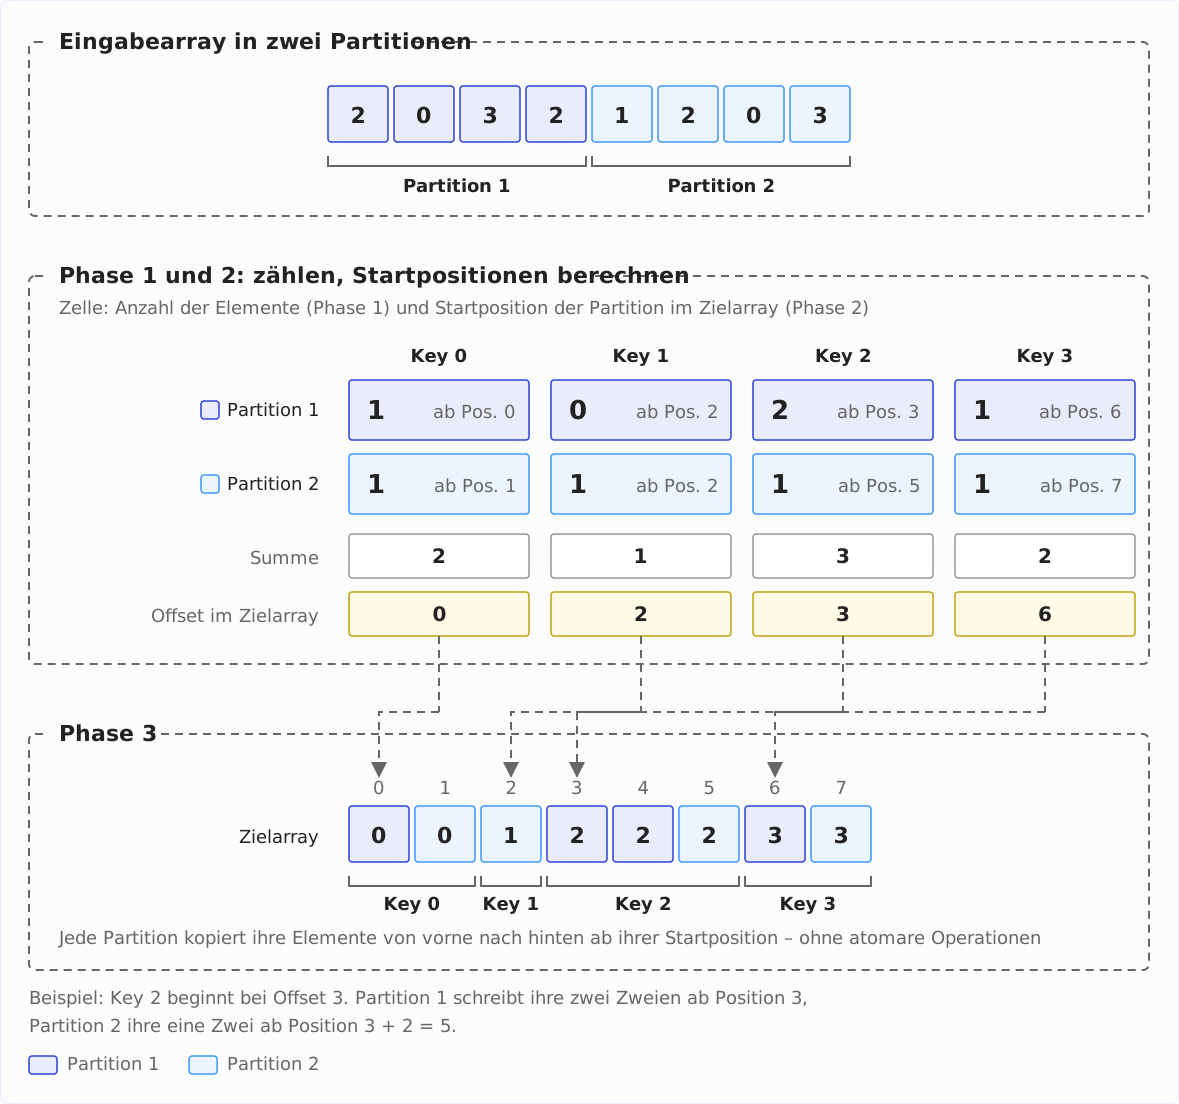
Stabil bleibt die parallele Variante, wenn Phase 2 aus den Hilfsarrays der Partitionen für jede Partition und jeden Key eine eigene Startposition berechnet: die Summe aller Zähler kleinerer Keys plus die Zähler desselben Keys in den vorangehenden Partitionen. Jeder Prozessor schreibt dann in Phase 3 ohne atomare Operationen in seinen eigenen Bereich des Zielarrays, von vorne nach hinten – die Reihenfolge gleicher Keys bleibt erhalten. Auf demselben Prinzip beruht paralleles Radix Sort.
Die folgende Grafik zeigt die stabile Variante an acht Elementen in zwei Partitionen mit den Keys 0 bis 3: oben das Eingabearray, in der Mitte die Zähler und Startpositionen pro Partition und Key, unten das Zielarray:
Zusammenfassung
Counting Sort ist ein sehr effizienter, stabiler Sortieralgorithmus mit einer Zeit- und Platzkomplexität von O(n + k).
Solange der Zahlenraum k nicht wesentlich größer ist als die Anzahl der Elemente n, ist Counting Sort linear. Ein Array mit zehn Elementen aus dem gesamten int-Wertebereich hingegen bräuchte ein Hilfsarray mit vier Milliarden Feldern. Für große Zahlenräume wie int und long kommt deshalb Radix Sort zum Einsatz, das die allgemeine Form von Counting Sort ziffernweise anwendet.
Counting Sort wird hauptsächlich für kleine Zahlenräume eingesetzt. Im JDK beispielsweise für:
byte-Arrays mit mehr als 64 Elementen (darunter wird Insertion Sort eingesetzt)short- oderchar-Arrays mit mehr als 1.750 Elementen (darunter wird Insertion Sort oder Dual-Pivot Quicksort verwendet – und erneut Counting Sort, sobald die Rekursionstiefe von Dual-Pivot Quicksort einen Grenzwert überschreitet)
Die beiden Grenzwerte stehen in der Klasse DualPivotQuicksort als MIN_BYTE_COUNTING_SORT_SIZE und MIN_SHORT_OR_CHAR_COUNTING_SORT_SIZE; sie gelten seit Java 14 unverändert, Stand JDK 27.
Wenn dir der Artikel weitergeholfen hat, würde ich mich sehr über eine positive Bewertung auf meinem ProvenExpert-Profil freuen. Dein Feedback hilft mir, meine Inhalte weiter zu verbessern und motiviert mich, neue informative Artikel zu schreiben.