Structured Concurrency wurde – zusammen mit virtuellen Threads und Scoped Values – in Project Loom entwickelt. Sie durchlief zwei Incubator-Runden (Java 19 und Java 20) und seit Java 21 mehrere Preview-Runden. In der aktuellen Version Java 27 liegt sie als siebter Preview vor (JDK Enhancement Proposal 533). Für Java 28 schlägt JEP 543 vor, sie ohne weitere Änderungen an der API zu finalisieren.
In Java 25 wurde die StructuredTaskScope-API durch JEP 505 grundlegend überarbeitet: StructuredTaskScope und die Join-Strategie wurden entkoppelt – Stichwort „Composition over inheritance“. Die Beispiele in diesem Artikel verwenden durchgehend die aktuelle API von Java 27. Wo sich von Java 26 auf Java 27 etwas geändert hat, weise ich jeweils in einer Infobox darauf hin; die kleineren Änderungen von Java 25 auf Java 26 findest du gesammelt im Abschnitt „Historie“.
In diesem Artikel erfährst du:
- Warum benötigen wir Structured Concurrency?
- Was ist Structured Concurrency?
- Wie wird
StructuredTaskScopeverwendet? - Was ist eine Policy? Welche Policies gibt es, und wie können wir selbst eine schreiben?
- Was ist der Vorteil von Structured Concurrency?
Eine begleitende Demo-Anwendung findest du in diesem GitHub-Repository.
Schauen wir uns zuerst einmal an, wie wir nebenläufige Teilaufgaben bisher implementiert haben.
Warum benötigen wir Structured Concurrency?
Wenn eine Aufgabe aus verschiedenen – vor allem blockierenden – Teilaufgaben besteht, die nebenläufig erledigt werden können (z. B. Zugriff auf Daten aus einer Datenbank oder Aufruf einer Remote-API), so konnten wir hierfür bisher das Java-Executor-Framework einsetzen.
Das könnte dann z. B. so aussehen (Klasse InvoiceGenerator3_ThreadPool in der Demo-Anwendung):
Invoice createInvoice(int orderId, int customerId, String language)
        throws InterruptedException, ExecutionException {
    Future<Order> orderFuture =
            executor.submit(() -> orderService.getOrder(orderId));

    Future<Customer> customerFuture =
            executor.submit(() -> customerService.getCustomer(customerId));

    Future<InvoiceTemplate> invoiceTemplateFuture =
            executor.submit(() -> invoiceTemplateService.getTemplate(language));

    Order order = orderFuture.get();
    Customer customer = customerFuture.get();
    InvoiceTemplate invoiceTemplate = invoiceTemplateFuture.get();

    return Invoice.generate(order, customer, invoiceTemplate);
}
Wir übergeben die drei Teilaufgaben an den Executor und warten auf die Teilergebnisse. Der Happy Path ist schnell implementiert. Aber wie behandeln wir Ausnahmen?
- Wenn in einem Subtask ein Fehler auftritt – wie können wir dann die anderen Subtasks abbrechen? Wenn im Beispiel oben
orderService.getOrder(…)fehlschlägt, dann wirftorderFuture.get()eine Exception, diecreateInvoice(…)-Methode endet, und wir haben evtl. zwei noch weiterlaufende Threads. - Wie können wir die Subtasks abbrechen, wenn der Parent Task („Erstelle eine Rechnung“) abgebrochen wird – oder wenn die komplette Anwendung heruntergefahren wird?
- Wie können wir – in einem alternativen Use Case – verbleibende Subtasks abbrechen, wenn lediglich das Ergebnis eines einzigen Subtasks benötigt wird?
Alles ist machbar, erfordert aber äußerst komplexen, schwer wartbaren Code (im GitHub-Repository findest du zwei Beispiele dafür: InvoiceGenerator2b_CompletableFutureCancelling und InvoiceGenerator4b_NewVirtualThreadPerTaskCancelling).
Und was, wenn wir Code dieser Art debuggen möchten? Ein Thread-Dump z. B. würde uns haufenweise Threads mit dem Namen „pool-X-thread-Y“ liefern – wir wüssten aber nicht, welcher Pool-Thread zu welchem aufrufenden Thread gehört, da sich alle aufrufenden Threads den Thread-Pool des Executors teilen.
Was ist Unstructured Concurrency?
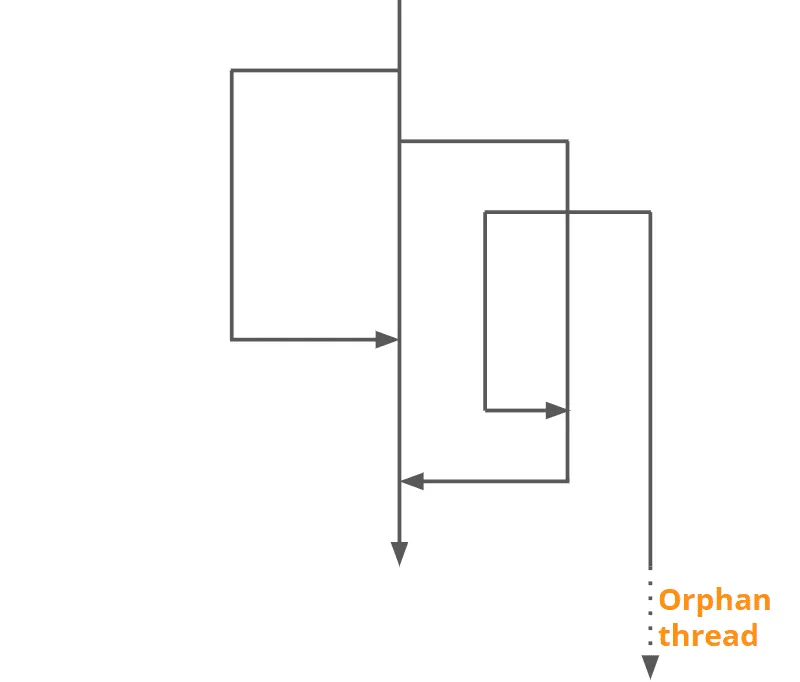
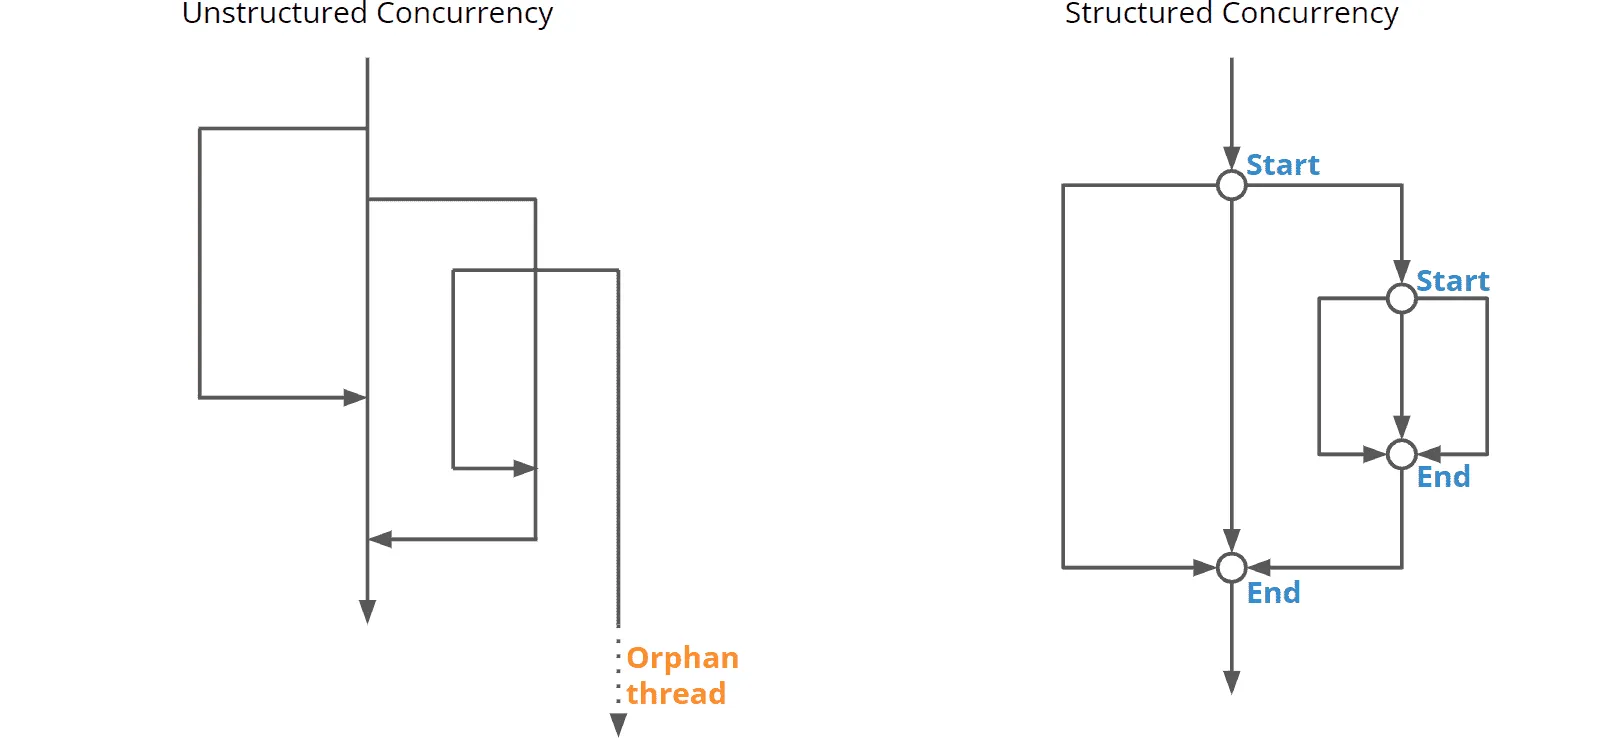
„Unstructured Concurrency“ bedeutet, dass unsere Tasks in einem Netz von Threads ablaufen, deren Start und Ende im Code schwer erkennbar ist. Eine saubere Fehlerbehandlung ist meist nicht vorhanden, und oft kommt es zu verwaisten Threads, wenn eine Kontrollstruktur (im Beispiel oben: die createInvoice(…)-Methode) endet:
Was ist Structured Concurrency?
Structured Concurrency ist ein Konzept, das die Implementierung, Lesbarkeit und Wartbarkeit von Code für die Aufteilung einer Aufgabe in Teilaufgaben und deren nebenläufige Abarbeitung erheblich verbessert.
Dazu führt sie mit dem Interface StructuredTaskScope eine Kontrollstruktur ein, die
- einen klaren Scope definiert, an dessen Anfang die Threads der Teilaufgaben starten und an dessen Ende die Threads der Teilaufgaben enden,
- eine saubere Fehlerbehandlung ermöglicht,
- und einen sauberen Abbruch von Teilaufgaben erlaubt, deren Ergebnisse nicht mehr benötigt werden.
Was das genau bedeutet, zeige ich dir in den folgenden Abschnitten an mehreren Beispielen.
StructuredTaskScope – ein erstes Beispiel
Structured Concurrency wird mit dem Interface StructuredTaskScope implementiert. Damit können wir das Beispiel von oben wie folgt umschreiben (Klasse InvoiceGenerator5_StructuredTaskScope in der Demo-Anwendung):
Invoice createInvoice(int orderId, int customerId, String language)
    throws InterruptedException, ExecutionException {
  try (var scope = StructuredTaskScope.open()) {
    Subtask<Order> orderSubtask =
        scope.fork(() -> orderService.getOrder(orderId));

    Subtask<Customer> customerSubtask =
        scope.fork(() -> customerService.getCustomer(customerId));

    Subtask<InvoiceTemplate> invoiceTemplateSubtask =
        scope.fork(() -> invoiceTemplateService.getTemplate(language));

    scope.join();

    Order order = orderSubtask.get();
    Customer customer = customerSubtask.get();
    InvoiceTemplate template = invoiceTemplateSubtask.get();

    return Invoice.generate(order, customer, template);
  }
}
Erläuterung
Verglichen mit dem Unstructured-Concurrency-Beispiel ersetzen wir den im Scope der Klasse liegenden ExecutorService durch einen im Scope der Methode liegenden StructuredTaskScope – und executor.submit() durch scope.fork(). Den Scope öffnen wir über die statische Methode StructuredTaskScope.open().
Mit scope.fork(…) starten wir die Subtasks; jeder läuft standardmäßig in einem eigenen virtuellen Thread. Mit scope.join() warten wir darauf, dass alle Tasks erledigt sind. Das Risiko verwaister Tasks besteht damit nicht mehr.
Danach können wir über Subtask.get() die Ergebnisse der drei Tasks auslesen.
Fehlerbehandlung mit StructuredTaskScope
Was passiert, wenn einer der drei Subtasks fehlschlägt?
Ein mit StructuredTaskScope.open() (ohne Argument) geöffneter Scope verwendet die Standard-Policy: Sobald ein Subtask eine Exception wirft, werden alle anderen Subtasks abgebrochen, und scope.join() wirft die aufgetretene Exception – verpackt in eine ExecutionException mit der ursprünglichen Exception als „Cause“. Das ist dieselbe Wrapper-Exception, die du von Future.get() kennst. Sie ist eine Checked Exception; deshalb deklariert createInvoice(…) sie in ihrer throws-Klausel.
Möchtest du die Exception nach dem Schließen des Scopes behandeln, ergänzt du einen catch-Block:
try (var scope = StructuredTaskScope.open()) {
  // fork(…) und join() ...
} catch (ExecutionException e) {
  Throwable cause = e.getCause();
  switch (cause) {
    case OrderNotFoundException onfe -> // ...
    default -> // ...
  }
}Den Beispielcode ausführen
Falls du das Beispiel selbst ausprobieren möchtest: StructuredTaskScope ist auch in Java 27 noch ein Preview-Feature und muss explizit freigeschaltet werden. Beim Kompilieren mit javac --release 27 --enable-preview, beim Ausführen mit java --enable-preview. Preview-Features lassen sich nur mit genau der Java-Version kompilieren, zu der sie gehören – für die Beispiele brauchst du also ein JDK 27. Mit der für Java 28 vorgeschlagenen Finalisierung (JEP 543) entfällt das Flag – in den Early-Access-Builds von Java 28 ist es noch nötig. Eine genaue Anleitung findest du in der README der Demo-Anwendung; für Java 21, 25 und 26 gibt es im Repository Tags mit den passenden Ständen.
Im Beispielcode werfen die drei Subtasks mit einer gewissen Wahrscheinlichkeit eine Exception. Wenn du das Programm ein paar Mal startest, wirst du sehen, wie eine Exception in einem Task zu einer Interruption in den anderen Tasks und einer Beendigung des Programms führt:
$ java -cp target/classes --enable-preview \
    eu.happycoders.structuredconcurrency.demo1_invoice.InvoiceGenerator5_StructuredTaskScope

[Thread[#3,main,5,main]] Forking tasks
[VirtualThread[#34]/runnable@ForkJoinPool-1-worker-1] Loading order
[VirtualThread[#36]/runnable@ForkJoinPool-1-worker-2] Loading customer
[Thread[#3,main,5,main]] Waiting for all tasks to finish
[VirtualThread[#39]/runnable@ForkJoinPool-1-worker-3] Loading template
[VirtualThread[#39]/runnable@ForkJoinPool-1-worker-1] Error loading template
[VirtualThread[#34]/runnable@ForkJoinPool-1-worker-2] Order loading was interrupted
[VirtualThread[#36]/runnable@ForkJoinPool-1-worker-2] Customer loading was interrupted
Exception in thread "main" java.util.concurrent.ExecutionException: java.lang.RuntimeException: Error loading template
        [...]
An dieser Ausgabe siehst du übrigens auch, dass alle Tasks in virtuellen Threads ausgeführt werden.
Policies über Joiner
Eine sogenannte Policy definiert, was passiert, wenn ein Subtask beendet wird oder eine Exception wirft. Außerdem kann eine Policy einen Rückgabewert für scope.join() definieren.
Im Beispiel oben haben wir die Standard-Policy verwendet: alle Subtasks abwarten, beim ersten Fehler abbrechen. Andere Policies wählst du, indem du der open()-Methode einen Joiner übergibst. Ein Joiner behandelt die Fertigstellung der Subtasks und erzeugt das Ergebnis für scope.join(). Je nach Joiner liefert join() ein einzelnes Ergebnis, eine Liste oder null zurück.
„Any Successful Result“
Manchmal brauchen wir nicht alle Ergebnisse, sondern nur das erste erfolgreiche. Beispiel: Wir wollen eine Kundenadresse über mehrere externe APIs gleichzeitig verifizieren und nur das erste Ergebnis verwenden.
Dafür gibt es den Joiner anySuccessfulOrThrow(). Sobald ein Subtask erfolgreich war, wird der Scope abgebrochen und die übrigen Subtasks werden unterbrochen. scope.join() liefert dann das Ergebnis des erfolgreichen Subtasks (Klasse AddressVerification2_AnySuccessful in der Demo-Anwendung):
AddressVerificationResponse verifyAddress(Address address)
    throws InterruptedException, ExecutionException {
  try (var scope = StructuredTaskScope.open(
      Joiner.<AddressVerificationResponse>anySuccessfulOrThrow())) {
    log("Forking tasks");

    scope.fork(() -> verificationService.verifyViaServiceA(address));
    scope.fork(() -> verificationService.verifyViaServiceB(address));
    scope.fork(() -> verificationService.verifyViaServiceC(address));

    log("Waiting for one task to finish");

    return scope.join();
  }
}
Sollten wider Erwarten alle drei Aufrufe eine Exception werfen, wirft scope.join() eine davon, verpackt in eine ExecutionException.
Wenn du den Beispielcode ausführst, siehst du, wie der erste erfolgreiche Subtask zu einem Ergebnis führt und die anderen Tasks abgebrochen werden:
$ java -cp target/classes --enable-preview \
    eu.happycoders.structuredconcurrency.demo2_address.AddressVerification2_AnySuccessful

[Thread[#3,main,5,main]] Forking tasks
[Thread[#3,main,5,main]] Waiting for one task to finish
[VirtualThread[#34]/runnable@ForkJoinPool-1-worker-1] Verifying address via service A
[VirtualThread[#38]/runnable@ForkJoinPool-1-worker-2] Verifying address via service C
[VirtualThread[#36]/runnable@ForkJoinPool-1-worker-4] Verifying address via service B
[VirtualThread[#34]/runnable@ForkJoinPool-1-worker-2] Error loading address via service A
[VirtualThread[#38]/runnable@ForkJoinPool-1-worker-2] Finished loading address via service C
[VirtualThread[#36]/runnable@ForkJoinPool-1-worker-5] Verifying address via service B was interrupted
[Thread[#3,main,5,main]] Response: AddressVerificationResponse[value=Verification response from service C]
Alle Joiner im Überblick
In Java 27 stehen dir die folgenden vordefinierten Joiner zur Verfügung:
| Joiner | Beschreibung |
|---|---|
ohne Joiner oder Joiner.awaitAllSuccessfulOrThrow() | Eine Exception in einem Subtask führt umgehend zum Abbruch des Scopes; scope.join() wirft die Exception verpackt in eine ExecutionException. Sind alle Subtasks erfolgreich, endet scope.join() ohne Exception und gibt null zurück. Die Ergebnisse müssen aus den von scope.fork() zurückgegebenen Subtask-Objekten ausgelesen werden. |
Joiner.anySuccessfulOrThrow() | scope.join() liefert das Ergebnis des ersten erfolgreichen Subtasks; die anderen Subtasks werden abgebrochen. Schlagen alle fehl, wirft scope.join() die Exception eines der fehlgeschlagenen Subtasks verpackt in eine ExecutionException. |
Joiner.allSuccessfulOrThrow() | Wie ohne Joiner bzw. mit awaitAllSuccessfulOrThrow() – mit dem Unterschied, dass scope.join() bei Erfolg eine List der Ergebnisse zurückliefert. Eine Exception führt zum Abbruch des Scopes und einer ExecutionException. |
Joiner.allUntil( | scope.join() wartet, bis entweder alle Subtasks beendet sind – egal ob erfolgreich oder nicht – oder das übergebene Predicate auf einen beendeten Subtask matcht. Liefert eine List der Subtask-Objekte zurück. |
Die drei …OrThrow-Joiner gibt es seit Java 27 zusätzlich in einer Variante, der du eine Funktion übergibst, die die Wrapper-Exception erzeugt. Soll join() keine ExecutionException werfen, sondern z. B. eine CompletionException (die nicht deklariert werden muss), schreibst du:
try (var scope = StructuredTaskScope.open(
    Joiner.<SupplierDeliveryTime, CompletionException>allSuccessfulOrThrow(
        CompletionException::new))) {
  // fork(…) ...

  return scope.join(); // wirft CompletionException statt ExecutionException
}Eigene Policy: ein benutzerdefinierter Joiner
Sollte keiner der vordefinierten Joiner für deinen Einsatzzweck geeignet sein, kannst du mit geringem Aufwand einen eigenen schreiben.
Nehmen wir an, wir wollen die Verfügbarkeit eines Produkts bei mehreren Lieferanten prüfen – und zwar nicht das erste Ergebnis verwenden, sondern das mit der schnellsten Verfügbarkeit. Gleichzeitig wollen wir fehlgeschlagene Anfragen nur dann propagieren, wenn die Anfragen bei allen Lieferanten fehlgeschlagen sind.
Das lässt sich überraschend einfach – und zugleich für andere Einsatzszenarien wiederverwendbar – realisieren, indem wir das Joiner-Interface implementieren (Klasse BestResultJoiner in der Demo-Anwendung). Seine drei Typparameter Joiner<T, R, R_X> stehen für den Ergebnistyp der Subtasks, den Rückgabetyp von join() und den Exception-Typ, den join() werfen darf:
public class BestResultJoiner<T>
    implements Joiner<T, T, SupplierDeliveryTimeCheckException> {

  private final Comparator<T> comparator;

  private T bestResult;
  private final List<Throwable> exceptions =
      Collections.synchronizedList(new ArrayList<>());

  public BestResultJoiner(Comparator<T> comparator) {
    this.comparator = comparator;
  }

  @Override
  public boolean onComplete(Subtask<T> subtask) {
    switch (subtask.state()) {
      case UNAVAILABLE -> {
        // Ignore
      }
      case SUCCESS -> {
        T result = subtask.get();
        synchronized (this) {
          if (bestResult == null
              || comparator.compare(result, bestResult) > 0) {
            bestResult = result;
          }
        }
      }
      case FAILED -> exceptions.add(subtask.exception());
    }

    return false; // Don't cancel the scope
  }

  @Override
  public T result() throws SupplierDeliveryTimeCheckException {
    if (bestResult != null) {
      return bestResult;
    } else {
      SupplierDeliveryTimeCheckException exception =
          new SupplierDeliveryTimeCheckException();
      exceptions.forEach(exception::addSuppressed);
      throw exception;
    }
  }

  @Override
  public T timeout() throws SupplierDeliveryTimeCheckException {
    if (bestResult != null) {
      return bestResult; // The best result received before the timeout
    } else {
      SupplierDeliveryTimeCheckException exception =
          new SupplierDeliveryTimeCheckException(new CancelledByTimeoutException());
      exceptions.forEach(exception::addSuppressed);
      throw exception;
    }
  }
}
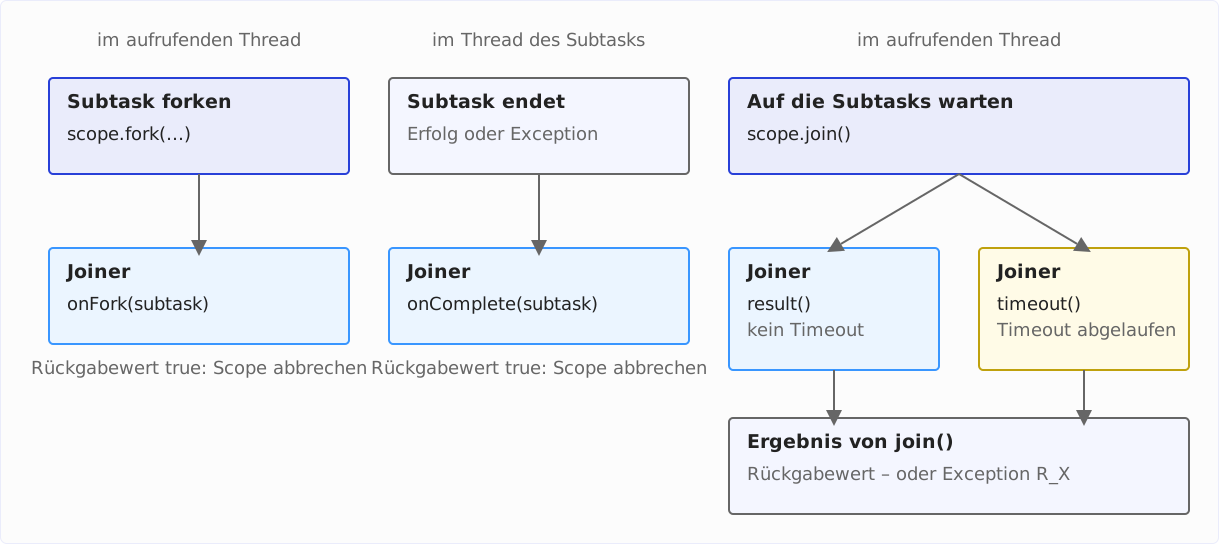
Die onComplete()-Methode wird für jeden beendeten Subtask aufgerufen – sowohl für erfolgreiche als auch für solche, die eine Exception geworfen haben. Welcher Fall eingetreten ist, prüfen wir mit subtask.state(). Im Erfolgsfall holen wir mit subtask.get() das Resultat und schreiben es – sofern es besser ist als das bisher beste – threadsicher in das Feld bestResult. Im Fall einer Exception sammeln wir diese threadsicher in einer Liste. Threadsicher muss beides sein, weil onComplete() nicht im aufrufenden Thread läuft, sondern im Thread des jeweiligen Subtasks.
Der Rückgabewert von onComplete() gibt an, ob der Scope abgebrochen werden soll (true steht für abbrechen). Da wir auf alle Lieferanten warten wollen, geben wir hier immer false zurück.
Die result()-Methode wird von scope.join() aufgerufen, sobald alle Subtasks beendet sind oder der Scope abgebrochen wurde. Sie prüft, ob ein erfolgreiches Ergebnis vorliegt, und gibt dieses zurück. Andernfalls wirft sie eine SupplierDeliveryTimeCheckException, an die sie die gesammelten Exceptions als „suppressed exceptions“ anhängt.
Die timeout()-Methode wird stattdessen aufgerufen, wenn für den Scope ein Timeout konfiguriert ist und es abläuft, bevor alle Subtasks fertig sind (dazu gleich mehr). Unser Joiner gibt dann das beste bis dahin eingetroffene Ergebnis zurück. Liegt noch keines vor, wirft er eine SupplierDeliveryTimeCheckException mit einer CancelledByTimeoutException als „Cause“ – so verlangt es der Vertrag des Joiner-Interfaces.
Eine vierte Methode, onFork(), ruft scope.fork(…) vor dem Start jedes Subtasks auf; auch sie kann den Scope mit true abbrechen. Unser Joiner belässt sie bei der Default-Implementierung, die false zurückgibt.
Die folgende Grafik zeigt, welche Methode des Joiners wann und in welchem Thread aufgerufen wird:
Den Joiner setzen wir wie folgt ein (Klasse SupplierDeliveryTimeCheck2_StructuredTaskScope in der Demo-Anwendung):
SupplierDeliveryTime getSupplierDeliveryTime(
    String productId, List<String> supplierIds)
    throws InterruptedException, SupplierDeliveryTimeCheckException {
  try (var scope = StructuredTaskScope.open(
      new BestResultJoiner<SupplierDeliveryTime>(
          Comparator.comparing(
              SupplierDeliveryTime::deliveryTimeHours).reversed()))) {
    for (String supplierId : supplierIds) {
      scope.fork(() -> service.getDeliveryTime(productId, supplierId));
    }

    return scope.join();
  }
}
scope.join() liefert hier das Ergebnis der result()-Methode unseres Joiners zurück. Schlagen alle Lieferanten-Anfragen fehl, wirft result() eine SupplierDeliveryTimeCheckException – und scope.join() wirft sie unverändert weiter. Über den dritten Typparameter des Joiners steht dieser Exception-Typ in der Signatur von join(); aufrufender Code bekommt so einen präzisen, vom Compiler geprüften Exception-Vertrag.
Beachte, dass wir den Joiner direkt in open() erzeugen: Ein Joiner hält Zustand und gehört zu genau einem Scope – er darf weder von mehreren Scopes geteilt noch nach dem Schließen des Scopes wiederverwendet werden.
Die Ausgabe des Beispielprogramms könnte z. B. so aussehen:
$ java -cp target/classes --enable-preview \
    eu.happycoders.structuredconcurrency.demo3_suppliers.SupplierDeliveryTimeCheck2_StructuredTaskScope

[VirtualThread[#34]/runnable@ForkJoinPool-1-worker-1] Retrieving delivery time from supplier A
[VirtualThread[#36]/runnable@ForkJoinPool-1-worker-3] Retrieving delivery time from supplier B
[VirtualThread[#38]/runnable@ForkJoinPool-1-worker-4] Retrieving delivery time from supplier D
[VirtualThread[#39]/runnable@ForkJoinPool-1-worker-5] Retrieving delivery time from supplier E
[VirtualThread[#37]/runnable@ForkJoinPool-1-worker-1] Retrieving delivery time from supplier C
[VirtualThread[#34]/runnable@ForkJoinPool-1-worker-1] Finished retrieving delivery time from supplier A: 12 hours
[VirtualThread[#37]/runnable@ForkJoinPool-1-worker-1] Finished retrieving delivery time from supplier C: 144 hours
[VirtualThread[#39]/runnable@ForkJoinPool-1-worker-1] Finished retrieving delivery time from supplier E: 64 hours
[VirtualThread[#38]/runnable@ForkJoinPool-1-worker-1] Error retrieving delivery time from supplier D
[VirtualThread[#36]/runnable@ForkJoinPool-1-worker-1] Error retrieving delivery time from supplier B
[Thread[#3,main,5,main]] Response: SupplierDeliveryTime[supplier=A, deliveryTimeHours=12]
Schön zu sehen: Zwar waren die Aufrufe für die Lieferanten B und D fehlerhaft, die übrigen Lieferanten haben aber Ergebnisse geliefert – und schließlich wird das beste Ergebnis zurückgeliefert: Lieferant A mit 12 Stunden Lieferzeit.
Verschachtelte StructuredTaskScopes
Falls wir nicht nur die Lieferanten für ein Produkt gleichzeitig abfragen möchten, sondern die Lieferanten für mehrere Produkte, lösen wir das ganz einfach mit verschachtelten Scopes (Klasse SupplierDeliveryTimeCheck3_NestedStructuredTaskScope in der Demo-Anwendung). Dieses Mal verwenden wir Joiner.allSuccessfulOrThrow(), um von scope.join() direkt eine Liste der Ergebnisse zu bekommen:
List<SupplierDeliveryTime> getSupplierDeliveryTimes(
    List<String> productIds, List<String> supplierIds)
    throws InterruptedException, ExecutionException {
  try (var scope = StructuredTaskScope.open(
      Joiner.<SupplierDeliveryTime>allSuccessfulOrThrow())) {
    productIds.forEach(productId ->
        scope.fork(() -> getSupplierDeliveryTime(productId, supplierIds)));

    return scope.join();
  }
}
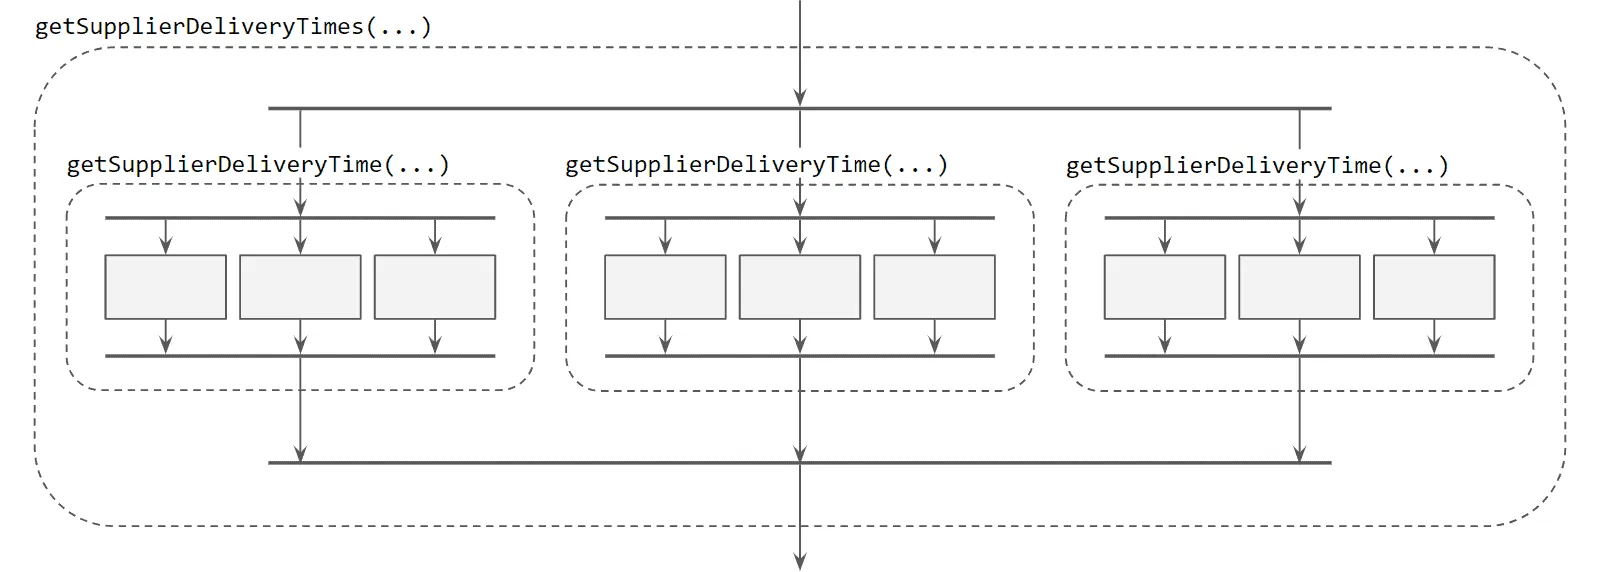
Wir erzeugen einen StructuredTaskScope – und innerhalb dieses Scopes forken wir Subtasks, die wiederum die im vorherigen Abschnitt gezeigte Methode getSupplierDeliveryTime(…) aufrufen. Diese öffnet ihrerseits einen Scope, der damit innerhalb des Scopes von getSupplierDeliveryTimes(…) verschachtelt ist.
Die folgende Grafik zeigt diese Scopes als gestrichelte Linien:
Timeout für einen Scope
Was, wenn wir nicht beliebig lange auf die Subtasks warten wollen? Über die konfigurierende Variante der open()-Methode kannst du dem Scope ein Timeout mitgeben – hier für das verschachtelte Beispiel aus dem vorherigen Abschnitt (Klasse SupplierDeliveryTimeCheck5_Timeout in der Demo-Anwendung):
List<SupplierDeliveryTime> getSupplierDeliveryTimes(
    List<String> productIds, List<String> supplierIds, Duration timeout)
    throws InterruptedException, ExecutionException {
  try (var scope = StructuredTaskScope.open(
      Joiner.<SupplierDeliveryTime>allSuccessfulOrThrow(),
      cf -> cf.withTimeout(timeout))) {
    productIds.forEach(productId ->
        scope.fork(() -> getSupplierDeliveryTime(productId, supplierIds)));

    return scope.join();
  }
}
Das Timeout ist eine von drei Einstellungen der Configuration, die das Lambda als cf entgegennimmt: Mit withName(…) gibst du dem Scope einen Namen für Monitoring und Management, mit withThreadFactory(…) eine ThreadFactory – etwa um den Threads der Subtasks Namen zu geben.
Läuft das Timeout ab, bevor alle Subtasks fertig sind, wird der Scope abgebrochen, alle noch laufenden Subtasks werden unterbrochen, und scope.join() ruft die timeout()-Methode des Joiners auf. Die drei …OrThrow-Joiner werfen dann eine ExecutionException mit einer CancelledByTimeoutException als „Cause“; allUntil() liefert die Liste der Subtask-Objekte, egal wie weit sie gekommen sind; und unser BestResultJoiner gibt das beste bis dahin eingetroffene Ergebnis zurück.
Ob ein Subtask fehlgeschlagen oder das Timeout abgelaufen ist, unterscheidest du am besten mit einem Pattern-Matching-switch über die „Cause“ – so macht es die main()-Methode der Demo-Klasse:
} catch (ExecutionException e) {
  switch (e.getCause()) {
    case CancelledByTimeoutException _ ->
        log("Timeout while retrieving delivery times");
    case Throwable cause -> log("Error retrieving delivery times: " + cause);
  }
}
Mit einem Timeout von 500 ms – die simulierten Lieferanten brauchen zwischen 250 ms und einer Sekunde – sieht ein Lauf des Beispielprogramms z. B. so aus:
$ java -cp target/classes --enable-preview \
    eu.happycoders.structuredconcurrency.demo3_suppliers.SupplierDeliveryTimeCheck5_Timeout

[VirtualThread[#47]/runnable@ForkJoinPool-1-worker-5] Retrieving delivery time from supplier B
[VirtualThread[#48]/runnable@ForkJoinPool-1-worker-12] Retrieving delivery time from supplier C
[VirtualThread[#50]/runnable@ForkJoinPool-1-worker-1] Retrieving delivery time from supplier E
        [...]
[VirtualThread[#52]/runnable@ForkJoinPool-1-worker-10] Error retrieving delivery time from supplier C
[VirtualThread[#42]/runnable@ForkJoinPool-1-worker-10] Finished retrieving delivery time from supplier A: 15 hours
[VirtualThread[#60]/runnable@ForkJoinPool-1-worker-10] Finished retrieving delivery time from supplier C: 110 hours
[VirtualThread[#53]/runnable@ForkJoinPool-1-worker-10] Finished retrieving delivery time from supplier D: 104 hours
[VirtualThread[#65]/runnable@ForkJoinPool-1-worker-5] Retrieving delivery time from supplier D interrupted
[VirtualThread[#49]/runnable@ForkJoinPool-1-worker-3] Retrieving delivery time from supplier D interrupted
        [...]
[Thread[#3,main,5,main]] Timeout while retrieving delivery timesVorteile von Structured Concurrency
Structured Concurrency zeichnet sich durch klar im Code ersichtliche Start- und Endpunkte nebenläufiger Subtasks aus. Fehler in den Subtasks werden an den Eltern-Scope propagiert. Das macht den Code besser les- und wartbar und stellt sicher, dass zum Ende eines Scopes alle gestarteten Threads beendet sind.
Die folgende Grafik zeigt Unstructured und Structured Concurrency gegenübergestellt:
Vorteile von StructuredTaskScope
Mit StructuredTaskScope haben wir ein Sprachkonstrukt für Structured Concurrency:
- Task und Subtasks bilden im Code eine abgeschlossene Einheit – es gibt keinen
ExecutorServicein einem höheren Scope, wie z. B. dem der Klasse. Die Threads kommen nicht aus einem Thread-Pool; stattdessen wird jeder Subtask in einem neuen virtuellen Thread ausgeführt. - Durch den mittels try-with-resources-Block aufgespannten Scope ergeben sich klare Start- und Endpunkte aller Threads.
- Am Ende des Scopes sind alle Threads beendet.
- Fehler innerhalb der Subtasks werden sauber an den Eltern-Scope propagiert.
- Je nach Policy werden die verbleibenden Subtasks abgebrochen, wenn ein Subtask erfolgreich war oder wenn in einem Subtask ein Fehler auftrat.
- Wenn der aufrufende Thread abgebrochen wird, werden auch die Subtasks abgebrochen.
Darüber hinaus hilft StructuredTaskScope beim Debuggen: Wenn wir einen Thread-Dump im JSON-Format ausgeben (jcmd <pid> Thread.dump_to_file -format=json <file>), dann ist darin die Aufrufhierarchie zwischen Eltern- und Kind-Threads ersichtlich.
StructuredTaskScope und Scoped Values
Die seit Java 25 finalisierten Scoped Values werden beim Einsatz von StructuredTaskScope innerhalb eines Scopes automatisch an alle durch StructuredTaskScope.fork(…) erzeugten Kind-Threads weitervererbt.
Wie das genau funktioniert, zeige ich dir an folgendem Code-Beispiel (Klasse SupplierDeliveryTimeCheck4_NestedStructuredTaskScopeUsingScopedValue in der Demo-Anwendung).
Wir erzeugen ein ScopedValue – im Beispiel für einen API-Key –, binden dieses an den API-Key und rufen dann die im Abschnitt „Verschachtelte StructuredTaskScopes“ gezeigte Methode getSupplierDeliveryTimes(…) innerhalb des Scopes per call() auf:
public static final ScopedValue<String> API_KEY = ScopedValue.newInstance();

List<SupplierDeliveryTime> getSupplierDeliveryTimes(List<String> productIds,
        List<String> supplierIds, String apiKey) throws Exception {
    return ScopedValue.where(API_KEY, apiKey)
            .call(() -> getSupplierDeliveryTimes(productIds, supplierIds));
}
Durch die Vererbung des Scoped Values API_KEY kann auf diesen auch innerhalb der SupplierDeliveryTimeService.getDeliveryTime(…)-Methode zugegriffen werden, ohne ihn über Methodenargumente durchschleifen zu müssen – und das selbst dann, wenn die Methoden nicht in demjenigen Thread ausgeführt werden, der ScopedValue.where(…) aufruft, sondern in den durch StructuredTaskScope.fork(…) erzeugten Kind- bzw. in diesem Beispiel sogar Enkel-Threads.
Historie
Structured Concurrency wurde in folgenden JDK Enhancement Proposals definiert:
- Java 19: JEP 428: Structured Concurrency (Incubator)
- Java 20: JEP 437: Structured Concurrency (Second Incubator)
- Java 21: JEP 453: Structured Concurrency (Preview)
- Java 22: JEP 462: Structured Concurrency (Second Preview)
- Java 23: JEP 480: Structured Concurrency (Third Preview)
- Java 24: JEP 499: Structured Concurrency (Fourth Preview)
- Java 25: JEP 505: Structured Concurrency (Fifth Preview)
- Java 26: JEP 525: Structured Concurrency (Sixth Preview)
- Java 27: JEP 533: Structured Concurrency (Seventh Preview)
- Java 28: JEP 543: Structured Concurrency – zur Finalisierung vorgeschlagen, ohne Änderungen gegenüber Java 27
Die Änderungen von Java 26 auf Java 27 stehen in den Infoboxen oben. Die kleineren Änderungen von Java 25 auf Java 26 (JEP 525) im Überblick:
Joiner.anySuccessfulResultOrThrow()wurde inanySuccessfulOrThrow()umbenannt – das Wort „Result“ kommt in den anderen Joiner-Namen auch nicht vor.- Mit
allSuccessfulOrThrow()liefertjoin()direkt eineListder Ergebnisse statt einesStreamderSubtask-Objekte; ausscope.join().map(Subtask::get).toList()wurdescope.join(). - Die konfigurierende
open()-Methode nimmt einenUnaryOperator<Configuration>statt einerFunctionentgegen. - Das
Joiner-Interface bekam die MethodeonTimeout()– die Java 27 bereits wieder durchtimeout()ersetzt hat.
Fazit
Structured Concurrency vereinfacht – aufbauend auf virtuellen Threads – die Verwaltung von Tasks, die in nebenläufige Subtasks aufgeteilt werden, deutlich. Policies erlauben uns, das Verhalten von StructuredTaskScope zu beeinflussen, z. B. um alle Tasks abzubrechen, sollte einer fehlgeschlagen sein.
Die API wurde in Java 25 grundlegend überarbeitet: StructuredTaskScope und Join-Strategie wurden entkoppelt, was zu klarer strukturiertem, verständlicherem und robusterem Code führt – Stichwort „Composition over inheritance“. In Java 26 (JEP 525) folgten kleinere Anpassungen, die ich in der Historie zusammengefasst habe.
Bitte beachte, dass sich Structured Concurrency nach wie vor im Preview-Stadium befindet – in Java 27 als siebter Preview (JEP 533). Mit JEP 543 soll sie in Java 28 finalisiert werden – ohne weitere Änderungen an der API. Der Code in diesem Artikel gilt damit voraussichtlich unverändert für Java 28, nur das Flag --enable-preview entfällt dann. Java 27 hat vor allem das Exception-Handling geschärft: Die vordefinierten Joiner werfen eine ExecutionException statt einer FailedException, ein dritter Typparameter macht den von join() geworfenen Exception-Typ explizit, timeout() ersetzt onTimeout(), awaitAll() ist entfallen, und open() nimmt die Konfiguration auch ohne Joiner entgegen. Die Details findest du in den Infoboxen „Java 26 → Java 27“ oben.
Hat dir dieser Artikel Zeit gespart? Dann freue ich mich, wenn du eine Minute davon in eine Bewertung auf meinem ProvenExpert-Profil investierst. Dein Feedback zeigt mir, dass sich die Arbeit an diesen Artikeln lohnt.