In diesem Artikel zeige ich dir anhand eines Beispiels, wie der Java ByteBuffer funktioniert und was die Methoden flip() und compact() genau machen.
Folgende Fragen wird der Artikel beantworten:
- Was ist ein
ByteBuffer, und wofür benötigt man ihn? - Wie erzeugt man einen
ByteBuffer? - Was bedeuten die Werte
position,limitundcapacity? - Wie schreibt man in den
ByteBuffer, wie liest man daraus? - Was genau machen die Methoden
flip()undcompact()? - Wann verwendet man
clear()stattcompact(), und was machtrewind()?
Los geht’s!
Was ist ein ByteBuffer, und wofür benötigt man ihn?
Einen ByteBuffer benötigst du, um mit einem sogenannten „Channel“ Daten in eine Datei, einen Socket oder eine andere I/O-Komponente zu schreiben bzw. daraus zu lesen.
In diesem Artikel geht es vorrangig um den ByteBuffer selbst. Wie du mit dem ByteBuffer und einem FileChannel Dateien schreibst und liest, erfährst du im FileChannel-Artikel des Dateien-Tutorials.
Ein ByteBuffer ist ein Wrapper um ein Byte-Array oder um einen Speicherbereich außerhalb des Heaps und bietet Methoden zum komfortablen Schreiben und Lesen. Der ByteBuffer speichert intern die Schreib-/Leseposition und ein sogenanntes „Limit“.
Was das genau bedeutet, erfährst du im folgenden Beispiel – Schritt für Schritt.
Den im Zuge dieses Artikels geschriebenen Programmcode findest du in diesem GitHub-Repository.
Einen ByteBuffer erzeugen
Als Erstes muss ein ByteBuffer mit einer vorgegebenen Größe (englisch: „capacity“) angelegt werden. Hierfür gibt es zwei Methoden:
ByteBuffer.allocate(int capacity)ByteBuffer.allocateDirect(int capacity)
Mit dem Parameter capacity wird die Größe des Buffers in Byte angegeben.
Die Methode allocate() legt den Buffer im Java Heap Memory an, wo er nach der Verwendung durch den Garbage Collector wieder entfernt wird.
allocateDirect() hingegen legt den Buffer im nativen Speicher an, also außerhalb des Heaps. Das hat den Vorteil, dass Schreib- und Leseoperationen schneller ausgeführt werden, da die entsprechenden Betriebssystem-Operationen direkt auf diesen Speicherbereich zugreifen können und die Daten nicht zunächst zwischen dem Java-Heap und dem Betriebssystem ausgetauscht werden müssen. Der Nachteil dieser Methode sind höhere Allokations- und Deallokationskosten.
Wir legen wie folgt einen ByteBuffer mit einer Größe von 1.000 Bytes an:
var buffer = ByteBuffer.allocate(1000);Danach schauen wir uns die Kennzahlen des Buffers an – nämlich position, limit und capacity.
Da wir diese Kennzahlen im Verlauf des Beispiels wiederholt ausgeben werden, legen wir dafür eine printMetrics()-Methode an:
private static void printMetrics(ByteBuffer buffer) {
  System.out.printf("position = %4d, limit = %4d, capacity = %4d%n",
      buffer.position(), buffer.limit(), buffer.capacity());
}
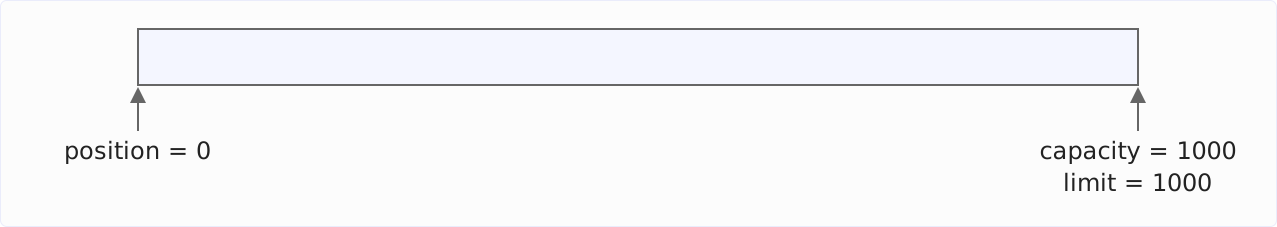
Nach dem Anlegen des ByteBuffers sehen wir folgende Ausgabe:
position = 0, limit = 1000, capacity = 1000Hier eine grafische Darstellung, damit du dir den Buffer besser vorstellen kannst. Der grau umrandete Bereich ist leer und kann im Folgenden gefüllt werden.
ByteBuffer-Position, -Limit und -Capacity
Die ausgegebenen Werte bedeuten im Einzelnen:
positionist die Schreib-/Leseposition. Diese ist bei einem neuen Buffer immer 0.limithat zwei Bedeutungen: Wenn wir in den Buffer schreiben, kennzeichnetlimitdie Position, bis zu der wir schreiben können. Wenn wir aus dem Buffer lesen, zeigtlimit, bis zu welcher Position der Buffer Daten enthält. Bei einem neuenByteBuffergleichtlimitdercapacity– den leeren Buffer können wir bis zum Ende beschreiben.capacitybezeichnet die Größe des Buffers. Diese entspricht den 1.000 Bytes, die wir bei derallocate()-Methode angegeben haben. Sie wird sich während der Lebenszeit des Buffers nicht mehr ändern.
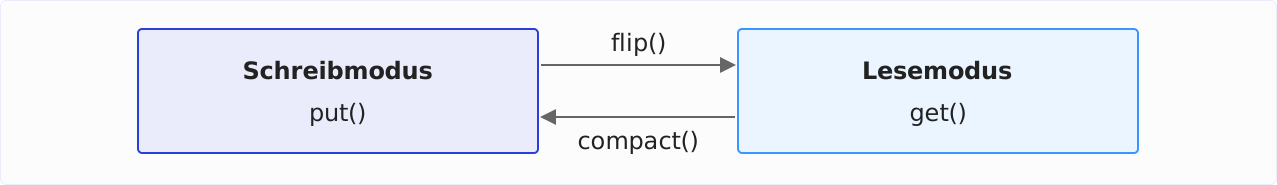
Das Schreiben in den Buffer und das Lesen aus dem Buffer nenne ich im Folgenden „Schreibmodus“ und „Lesemodus“. Der ByteBuffer selbst hat keinen Modus – ob wir gerade schreiben oder lesen, speichert er nicht. Umschalten müssen wir deshalb selbst: mit flip() und compact().
Der ByteBuffer-Schreib-Lese-Zyklus
Ein vollständiger Schreib-Lese-Zyklus besteht aus den Schritten put(), flip(), get() und compact(): Mit put() schreiben wir in den Buffer, flip() schaltet in den Lesemodus, mit get() lesen wir, und compact() schaltet zurück in den Schreibmodus.
Diese Schritte werden wir uns in den folgenden Abschnitten anschauen.
Schreiben in den ByteBuffer mit put()
Zum Schreiben in den ByteBuffer gibt es diverse put()-Methoden, um einzelne Bytes, ein Byte-Array oder auch andere primitive Datentypen (wie char, double, float, int, long, short) in den Buffer zu schreiben.
Werte aus mehreren Bytes – z. B. int und long – schreibt der ByteBuffer in der Byte-Reihenfolge Big Endian, also mit dem höchstwertigen Byte zuerst. Mit buffer.order(ByteOrder.LITTLE_ENDIAN) stellst du die Reihenfolge um.
Die genannten put()-Methoden schreiben an der aktuellen Position und schieben position weiter. Daneben gibt es Varianten, die den Index als Parameter bekommen und position nicht verändern – seit Java 13 auch für Byte-Arrays.
In unserem Beispiel schreiben wir 100-mal den Wert 1 in den Buffer und schauen uns danach erneut die Buffer-Kennzahlen an:
for (int i = 0; i < 100; i++) {
  buffer.put((byte) 1);
}

printMetrics(buffer);
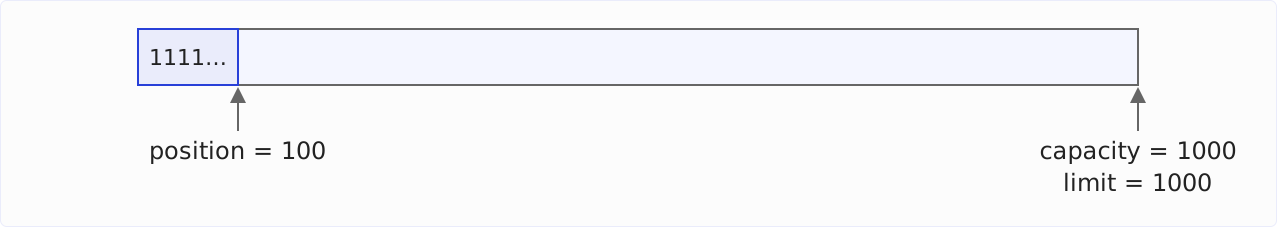
Wenn wir das Programm laufen lassen, sehen wir folgende Ausgabe:
position = 100, limit = 1000, capacity = 1000Die Position hat sich also um 100 Bytes nach rechts verschoben; der Buffer sieht nun wie folgt aus:
Als Nächstes schreiben wir 200-mal eine Zwei in den Buffer. Dieses Mal verwenden wir dazu eine andere Methode: Wir füllen zunächst ein Byte-Array, kopieren dieses in den Buffer und geben wieder die Kennzahlen aus:
byte[] twos = new byte[200];
Arrays.fill(twos, (byte) 2);
buffer.put(twos);

printMetrics(buffer);
Wir sehen nun:
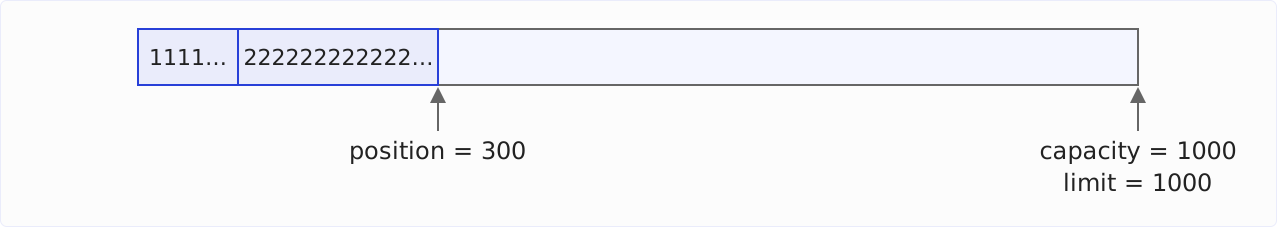
position = 300, limit = 1000, capacity = 1000Die Position hat sich um weitere 200 Bytes nach rechts verschoben; der Buffer sieht wie folgt aus:
Umschalten in den Lesemodus mit ByteBuffer.flip()
Zum Lesen aus dem Buffer gibt es entsprechende get()-Methoden.
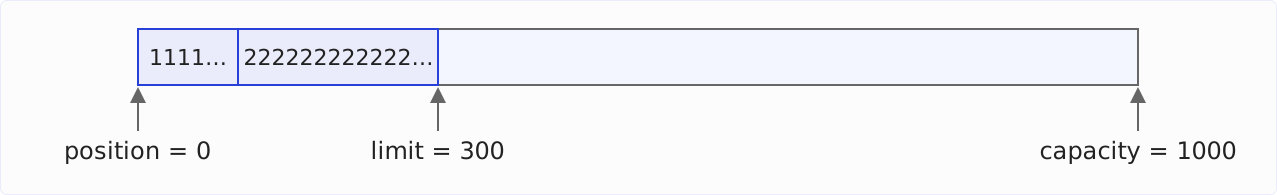
Wir wollen den Buffer von Anfang an lesen. Da position nicht nur die Schreib-, sondern auch die Leseposition anzeigt, müssen wir position dazu zurück auf 0 setzen.
Gleichzeitig setzen wir limit auf 300, um zu signalisieren, dass aus dem Buffer maximal 300 Bytes gelesen werden können.
Im Programmcode machen wir das wie folgt:
buffer.limit(buffer.position());
buffer.position(0);
Da diese zwei Zeilen bei jedem Umschalten vom Schreib- in den Lesemodus benötigt werden, gibt es eine ByteBuffer-Methode, die dasselbe für uns tut:
buffer.flip();Ein Aufruf von printMetrics() zeigt uns nun folgende Werte:
position = 0, limit = 300, capacity = 1000position ist also an den Anfang des Buffers zurückgesprungen, und limit zeigt auf das Ende des gefüllten Bereichs:
Damit ist der Buffer bereit, um gelesen zu werden.
Lesen aus dem ByteBuffer mit get()
Nehmen wir an, wir wollen den Inhalt des Buffers in einen Channel schreiben, und dieser kann momentan nur 200 der 300 Bytes aufnehmen. Das können wir simulieren, indem wir der ByteBuffer.get()-Methode ein 200 Byte großes Byte-Array übergeben, in das der Buffer seine Daten schreiben soll:
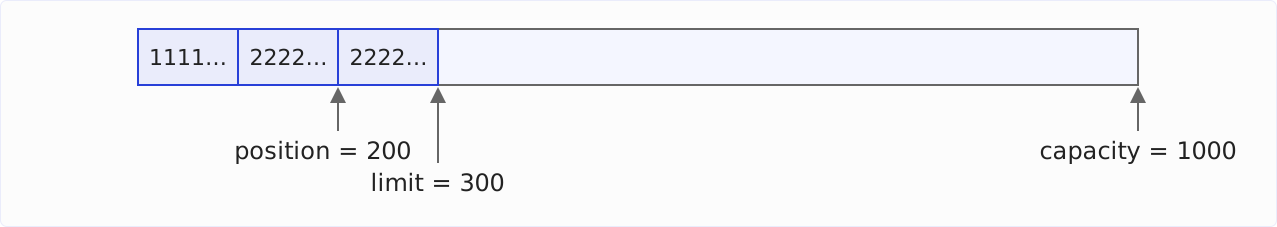
buffer.get(new byte[200]);printMetrics() zeigt uns nun Folgendes an:
position = 200, limit = 300, capacity = 1000Die Leseposition ist um 200 Bytes nach rechts gerückt – also ans Ende der gelesenen Daten bzw. an den Anfang der noch nicht gelesenen Daten:
Umschalten in den Schreibmodus – wie man es nicht macht
Um jetzt wieder in den Buffer zu schreiben, könnte man folgenden Fehler begehen: Man setzt position auf das Ende der Daten, also 300, und limit wieder auf 1.000. Damit sind wir bei exakt dem Zustand, in dem wir nach dem Schreiben der Einsen und Zweien waren:
Nehmen wir an, wir würden jetzt 300 weitere Bytes in den Buffer schreiben. Der Buffer sähe danach wie folgt aus:
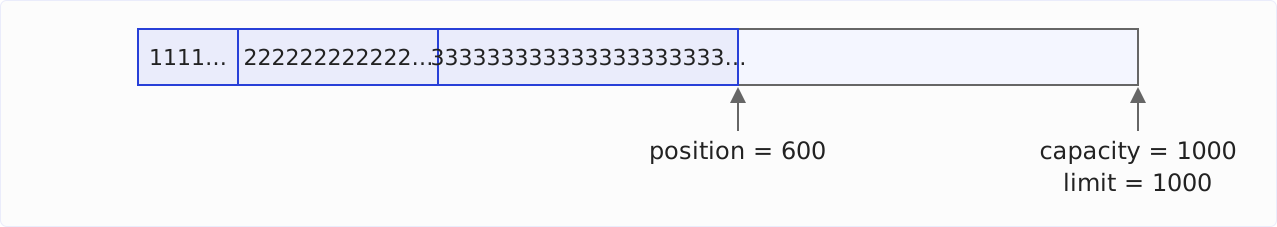
Wenn wir nun mit flip() zurück in den Lesemodus schalten würden, dann wäre position wieder auf 0:
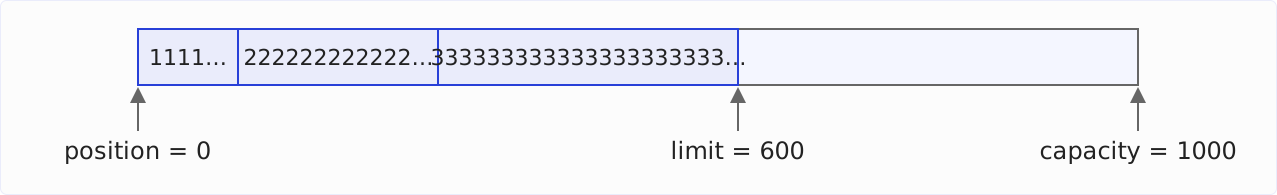
Jetzt würden wir allerdings die ersten 200 Bytes, die wir bereits gelesen haben, noch einmal lesen.
Diese Vorgehensweise ist also falsch. Wie man es richtig macht, erklärt der folgende Abschnitt.
Umschalten in den Schreibmodus mit ByteBuffer.compact()
Zur Erinnerung: So sieht der Buffer aus, nachdem wir 200 der 300 Bytes gelesen haben:
Richtig gehen wir beim Umschalten in den Schreibmodus wie folgt vor:
- Wir berechnen die Anzahl der noch nicht gelesenen Bytes:
remaining = limit - position, im Beispiel ergibt das 100. - Wir schieben die noch nicht gelesenen Bytes an den Anfang des Buffers.
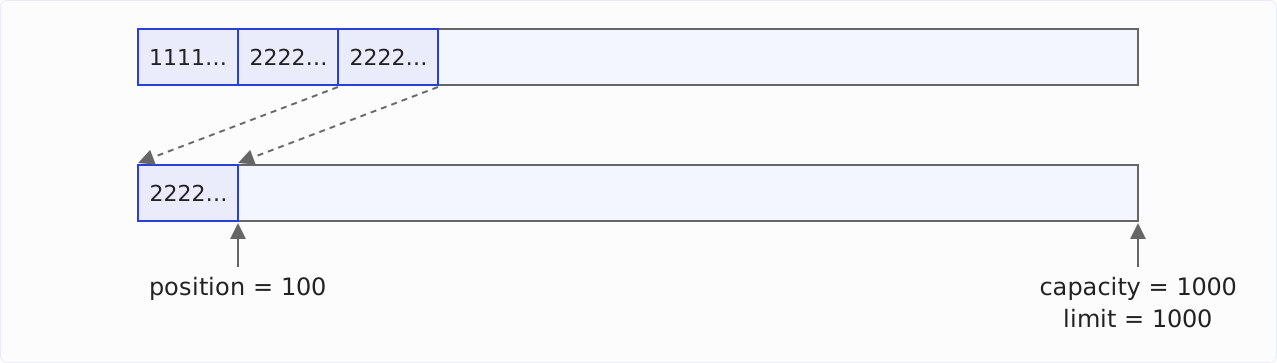
- Wir setzen die Schreibposition ans Ende der nach links verschobenen Bytes, im Beispiel also auf 100.
- Wir setzen
limitauf das Ende des Buffers.
Auch hierfür stellt ByteBuffer eine Methode zur Verfügung:
buffer.compact();Nach dem Aufruf von compact() zeigt uns printMetrics() Folgendes an:
position = 100, limit = 1000, capacity = 1000In der Grafik sieht der compact()-Vorgang wie folgt aus:
Der nächste Zyklus
Jetzt können wir die nächsten 300 Bytes in den Buffer schreiben:
byte[] threes = new byte[300];
Arrays.fill(threes, (byte) 3);
buffer.put(threes);
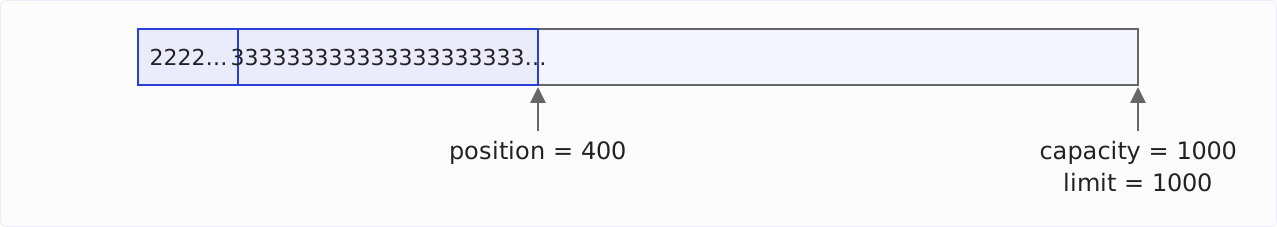
printMetrics() zeigt uns nun folgende Werte an:
position = 400, limit = 1000, capacity = 1000Nach dem Schreiben der Dreien ist position um 300 Bytes nach rechts gerückt:
Jetzt schalten wir mit flip() wieder in den Lesemodus um:
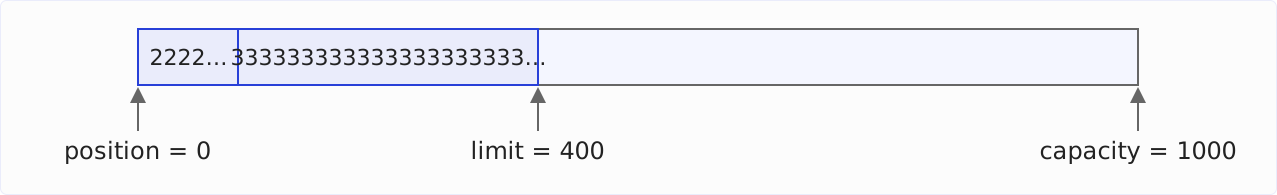
buffer.flip();Ein letzter Aufruf von printMetrics() gibt folgende Werte aus:
position = 0, limit = 400, capacity = 1000Die Leseposition steht am Anfang des Buffers, dort, wo die verschobenen 100 Zweien liegen. Wir können nun also an genau der Position weiterlesen, an der wir vorhin aufgehört haben.
Weitere ByteBuffer-Methoden: clear(), remaining(), rewind()
Neben flip() und compact() wirst du im Schreib-Lese-Zyklus häufig auf clear(), remaining(), hasRemaining() und rewind() treffen.
ByteBuffer.clear() oder compact()?
compact() kopiert die noch nicht gelesenen Bytes an den Anfang des Buffers. Hast du den Buffer vollständig gelesen, gibt es nichts zu kopieren. Dann kannst du statt compact() auch clear() aufrufen:
buffer.clear();clear() setzt position auf 0 und limit auf capacity. Die Daten im Buffer löscht die Methode nicht – der nächste Schreibvorgang überschreibt sie.
Liegen beim Aufruf von clear() noch ungelesene Bytes im Buffer, überschreibt der nächste Schreibvorgang auch diese. In unserem Beispiel wären das die 100 Zweien gewesen, die nach dem get()-Aufruf noch im Buffer lagen.
Ich empfehle compact(), sobald beim Lesen Bytes übrig bleiben können, z. B. nach channel.write(buffer). clear() passt, wenn du sicher weißt, dass der Buffer vollständig gelesen ist.
ByteBuffer.remaining() und hasRemaining()
remaining() liefert die Anzahl der Bytes zwischen position und limit – im Lesemodus sind das die noch nicht gelesenen Bytes. hasRemaining() liefert true, solange diese Anzahl größer als 0 ist.
Mit hasRemaining() stellst du sicher, dass ein Channel den Buffer vollständig schreibt, denn channel.write(buffer) schreibt nicht in jedem Fall alle Bytes:
while (buffer.hasRemaining()) {
  channel.write(buffer);
}
Ein vollständiges Beispiel findest du im FileChannel-Artikel im Abschnitt Schreiben in eine Datei mit ByteBuffer.flip() und compact().
ByteBuffer.rewind()
rewind() setzt position zurück auf 0 und lässt limit unverändert. Danach kannst du dieselben Daten erneut lesen.
Von flip() unterscheidet sich rewind() nur im limit: flip() setzt es auf die bisherige Position, rewind() lässt es stehen. Rufst du nach dem Schreiben rewind() statt flip() auf, bleibt limit auf capacity – und beim Lesen bekommst du auch die Bytes hinter den geschriebenen Daten.
Zusammenfassung
Ein ByteBuffer hat eine feste Größe (capacity), eine Schreib-/Leseposition (position) und ein limit, bis zu dem du schreiben bzw. lesen kannst.
Die folgende Tabelle zeigt, worauf flip(), compact(), clear() und rewind() die Werte position und limit setzen und wofür du die Methode verwendest:
| Methode | position | limit | Verwendung |
|---|---|---|---|
flip() | 0 | bisherige position | nach dem Schreiben, um zu lesen |
compact() | Anzahl der ungelesenen Bytes | capacity | nach dem Lesen, um weiterzuschreiben – ungelesene Bytes bleiben erhalten |
clear() | 0 | capacity | nach vollständigem Lesen, um erneut zu schreiben |
rewind() | 0 | unverändert | um dieselben Daten erneut zu lesen |
compact() kopiert als einzige der vier Methoden Daten. Die anderen drei ändern nur position und limit.
Für den Wechsel zurück in den Schreibmodus empfehle ich compact(): Es gehen keine ungelesenen Bytes verloren. Und ist der Buffer leer gelesen, gibt es nichts zu kopieren – compact() tut dann dasselbe wie clear().
Hat dieser Artikel deine Fragen beantwortet? Dann freue ich mich über eine Bewertung auf meinem ProvenExpert-Profil – sie hilft anderen Entwickler:innen, diese Inhalte zu finden.