Jedes Java-Objekt hat im Speicher einen den eigentlichen Daten vorangestellten Objekt-Header. Dieser enthält vor allem den Hash-Code des Objekts und die Information, von welcher Klasse das Objekt eine Instanz ist.
Bis Java 26 war der Objekt-Header standardmäßig 96 Bit (12 Byte) groß – oder 128 Bit (16 Byte), wenn Compressed Class Pointers ausgeschaltet wurden (wozu es praktisch keinen Grund gibt). Seit Java 27 sind es standardmäßig 64 Bit (8 Byte) – wie das geht, erklärt dieser Artikel.
Im Rahmen von Project Lilliput tüfteln die JDK-Entwickler:innen seit vielen Jahren an Möglichkeiten, um den Header auf insgesamt 64 Bit oder sogar auf 32 Bit zu komprimieren.
Im Jahr 2025 war es dann so weit: In Java 24 wurden Compact Object Headers durch JDK Enhancement Proposal 450 als experimentelles Feature eingeführt – und in Java 25 durch JDK Enhancement Proposal 519 finalisiert. Compact Object Headers ermöglichen es, den Objekt-Header von 96 Bit auf 64 Bit zu komprimieren und damit die Heap-Größe bestehender Anwendungen deutlich zu reduzieren.
In diesem Artikel erfährst du:
- Wie funktioniert die Header-Komprimierung?
- Warum wird dadurch nicht nur der Speicherbedarf reduziert, sondern auch die Anwendungsperformance erhöht?
- Was es mit dem neuen „Self Forwarded Tag“ auf sich hat
- Wie du Compact Object Headers aktivierst – und ab welcher Java-Version sie standardmäßig aktiv sind
- Wie die geplanten 4-Byte-Header funktionieren sollen
Status Quo vor Compact Object Headers
Eine detaillierte Beschreibung des Aufbaus von Objekt-Headern findest du im Hauptartikel über Java Objekt-Header. Hier das Wichtigste zusammengefasst:
Bis Java 26 bestand der Objekt-Header standardmäßig aus einem 64-Bit-„Mark Word“ und einem 32-Bit-„Class Word“. Mark Word und Class Word sind wie folgt aufgebaut:
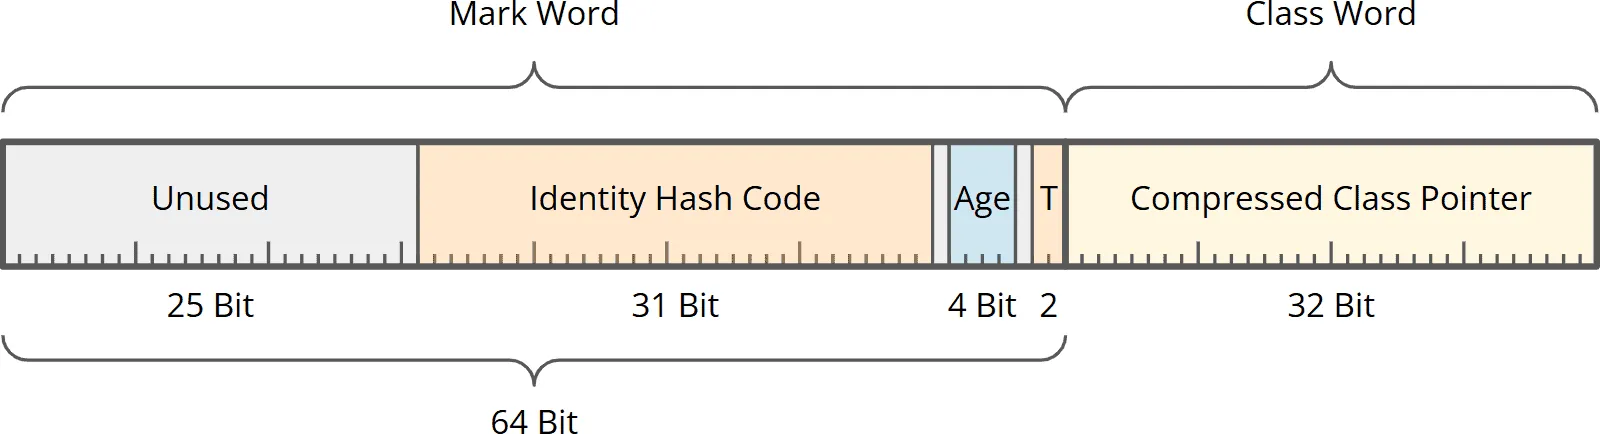
Das Mark Word enthält:
- einen 31-Bit Identity Hash Code (der beim Aufruf von
System.identityHashCode(Object)zurückgegeben wird), - 4 Bits, in denen der Garbage Collector das Alter eines Objekts speichert (anhand dessen er entscheidet, wann ein Objekt von der jungen in die alte Generation verschoben wird),
- 2 „Tag Bits“, die anzeigen, ob das Objekt nicht, uncontended (ohne wartende Threads) oder contended (mit wartenden Threads) gelockt ist.
Das Class Word enthält einen 32-Bit-Offset in den maximal 4 GB großen Compressed Class Space, der auf die sogenannte Klass-Datenstruktur zeigt, welche alle relevanten Daten über die Klasse enthält.
Vom Compressed Class Pointer zum Compact Object Header
Wie können wir den Objekt-Header weiter komprimieren?
Zunächst einmal enthielt das Mark Word bis Java 23 (wie man oben sieht) 27 ungenutzte Bits (25 am Anfang und jeweils eines vor und nach den „Age Bits“). Von den 96 Bits des gesamten Objekt-Headers wurden also nur 96 − 27 = 69 Bits benötigt. Um auf 64 Bit zu kommen, müssen wir also irgendwie fünf Bits einsparen.
Wo können wir die hernehmen?
Die JDK-Entwickler:innen haben lange experimentiert, bis sie zu folgender Lösung kamen (ich habe für eine bessere Darstellung den Maßstab geändert – die 64 Bit ziehen sich jetzt über die gesamte Breite):
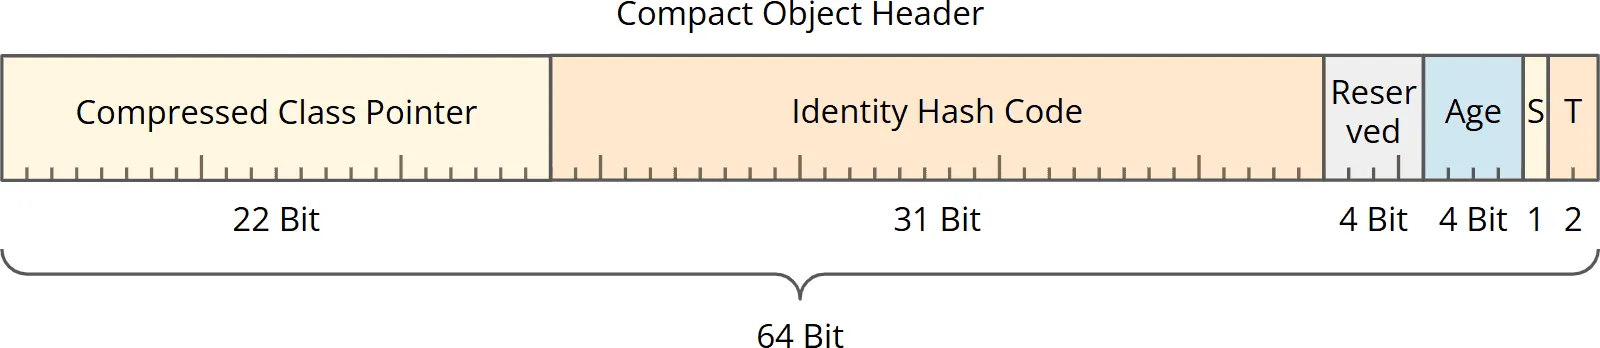
Der neue 64-Bit-Header wird nicht mehr in Mark Word und Class Word aufgeteilt, sondern enthält direkt die folgenden Informationen:
- einen von 32 Bit auf 22 Bit weiter komprimierten Class Pointer (wird unten erklärt),
- den 31-Bit Identity Hash Code (unverändert),
- 4 für Project Valhalla reservierte Bits (neu),
- 4 Bits für das Alter des Objekts (unverändert),
- 1 Bit für das sogenannte „Self Forwarded Tag“ (wird unten erklärt),
- 2 Tag Bits (unverändert).
Der Class Pointer wurde also um 10 Bits verkleinert. Da wir nur fünf Bits einsparen mussten, stehen nun fünf zusätzliche Bits zur Verfügung. Vier davon wurden für Project Valhalla reserviert, und in einem Bit wird das neue „Self Forwarded Tag“ gespeichert.
Wie konnte der Class Pointer auf 22 Bit komprimiert werden?
Mit den bisherigen 32 Bit konnte jede Position innerhalb des 4 GB großen Compressed Class Space einzeln adressiert werden.
Der Einfachheit halber stelle ich das in der folgenden Grafik mit einem 256 Byte großen Speicherbereich dar:
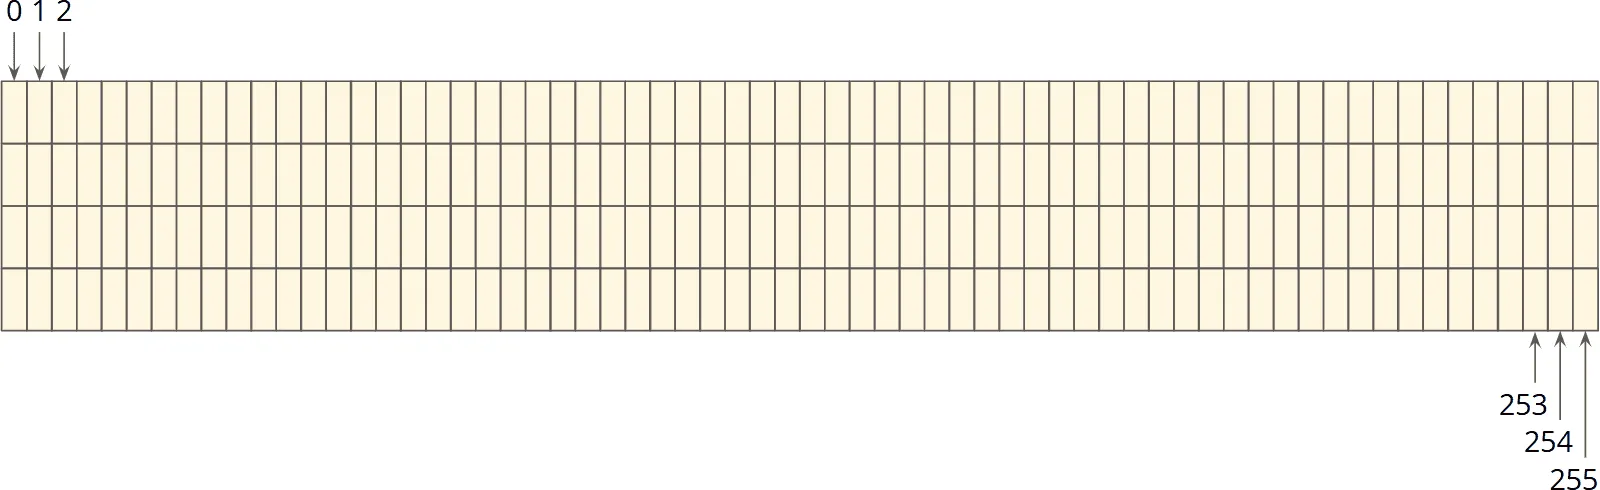
Wie du siehst, brauchen wir die Zahlen 0 bis 255, um jede einzelne Position des Speicherbereichs zu adressieren. Dafür brauchen wir einen 8-Bit-Pointer (28 = 256).
Doch müssen wir wirklich jede einzelne Position adressieren können? Nein, das müssen wir nicht!
Genau wie eine Festplatte (egal ob eine herkömmliche oder eine SSD) in sogenannte (in der Regel 4 KB große) Blöcke aufgeteilt ist, können wir auch den Speicherbereich für die Klassendaten in Blöcke aufteilen. So muss nicht mehr jedes einzelne Byte adressiert werden, sondern nur noch jeder Block. Und so können wir mit deutlich weniger Bits den gleichen Speicherbereich adressieren.
Hier wieder das vereinfachte Beispiel, in dem ich den 256 Byte großen Speicherbereich in 32 Blöcke zu je 8 Byte aufteile:
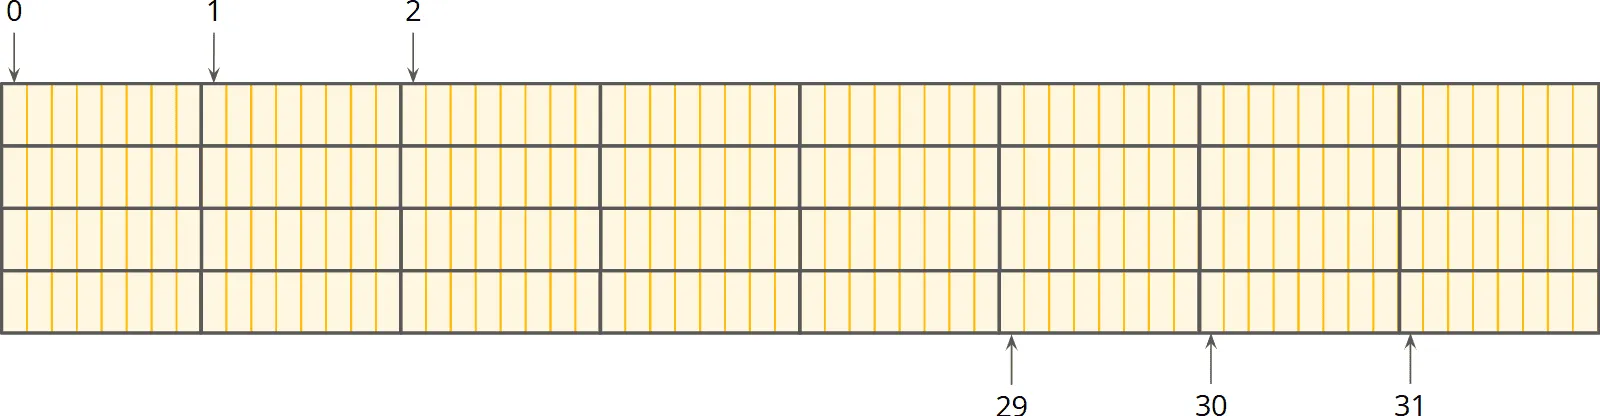
Jetzt brauchen wir nur noch die Zahlen 0 bis 31, um den gleichen Speicherbereich zu adressieren. Dafür brauchen wir nur noch 5 Bit große Pointer (25 = 32). Durch Aufteilung in Blöcke konnten wir den Speicherbedarf pro Pointer von 8 Bit auf 5 Bit reduzieren.
Und das funktioniert auch mit dem Speicherbereich, in dem die Klassen-Informationen liegen.
Bei der Verwendung von Compact Object Headers wird dieser Speicherbereich in 1.024 (= 210) Byte große Blöcke aufgeteilt. Diese Blockgröße ist ein Kompromiss: Größere Blöcke würden noch mehr Bits im Pointer sparen, kleinere Blöcke weniger Platz zwischen den Klassenstrukturen verschwenden.
Zur Erinnerung: Der Bereich ist 4 GB groß. Entsprechend ergeben sich 4 × 1.024 × 1.024 × 1.024 / 1.024 Blöcke, also 4 × 1.024 × 1.024, das sind 4.194.304, oder 222 Blöcke. Und diese können wir mit 22 Bit adressieren!
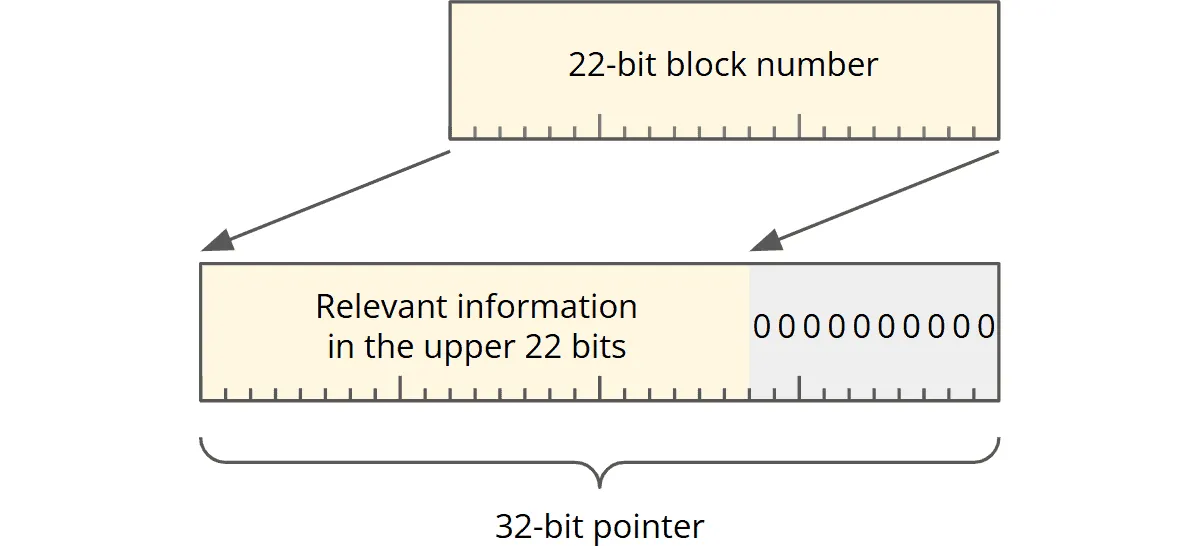
Um aus einer 22-Bit-Blocknummer einen Pointer zu machen, müssen wir die 22 Bit lediglich um 10 Bit nach links schieben und die hinteren 10 Bit mit Nullen auffüllen, und damit haben wir wieder einen 32-Bit-Pointer in den 4 GB großen Speicherbereich:
Die Aufteilung in Blöcke führt nun zu einer Fragmentierung bei den Klassendaten. Doch auch das haben die JDK-Entwickler:innen bedacht: Der zwischen den Klassen liegende Speicher kann auch von anderen Datenstrukturen des Metaspace genutzt werden.
Was ist das „Self Forwarded Tag“?
Wenn ein Garbage Collector ein Objekt an eine neue Speicheradresse kopiert, ersetzt er im ursprünglichen Objekt die oberen 62 Bit des Mark Words durch einen Pointer auf die neue Speicheradresse und setzt die Tag-Bits auf 0b11. Das ursprüngliche Mark Word findet er dann an der neuen Adresse.
Schlägt der Kopiervorgang fehl (z. B. weil der Zielbereich voll ist), bleibt das Objekt, wo es ist. Bis Java 23 schrieb der Garbage Collector auch in diesem Fall einen Pointer ins Mark Word – auf das Objekt selbst. Identity Hash Code und Objekt-Alter gingen dabei nicht verloren: Der Garbage Collector sicherte das ursprüngliche Mark Word vorher auf einem separaten Stack und stellte es nach der Garbage Collection wieder her.
Mit einem Compact Object Header würde eine solche Selbst-Referenz aber auch den Class Pointer überschreiben – und den braucht der Garbage Collector weiterhin, z. B. um die Größe des Objekts zu bestimmen. Ein Compact Object Header darf deshalb nicht durch eine Selbst-Referenz ersetzt werden.
Stattdessen wird nur das neue „Self Forwarded Tag“-Bit gesetzt; alle anderen Bits bleiben stehen. Das gilt seit Java 24 übrigens für beide Header-Layouts – auch das klassische 96-Bit-Layout hat seither ein Self-Forwarded-Bit.
Fazit zu Compact Object Headers
Compact Object Headers reduzieren den Speicherbedarf eines Java-Programms signifikant, indem die Objekt-Header von 96 Bit (12 Byte) auf 64 Bit (8 Byte) reduziert werden. Der JEP selbst spricht von einer Reduktion des Heap-Verbrauchs um 10–20 %, Amazon spricht sogar von 22 % (dieselbe Messung mit SPECjbb2015 zitiert auch JEP 534: 22 % weniger Heap, 8 % weniger CPU-Zeit), Alibaba nennt Werte zwischen 5 und 10 %.
Und nicht nur das – dadurch, dass die Objekte kleiner sind, passen auch mehr Objekte in den CPU-Cache. So kommt es zu weniger Cache-Misses – und das wirkt sich zusätzlich positiv auf die Performance aus. Amazon hat 8 bis 11 % mehr Durchsatz gemessen, Reddit-Nutzer „plokhotnyuk“ hat in einem JSON-Benchmark 10 % mehr Durchsatz gemessen, und Alibaba berichtet von 6–9 % mehr Durchsatz.
Compact Object Headers aktivieren: -XX:+UseCompactObjectHeaders
Seit Java 27 sind Compact Object Headers per JEP 534 standardmäßig aktiv; bei Bedarf lassen sie sich mit -XX:-UseCompactObjectHeaders abschalten. In Java 25 und 26 musst du sie einschalten, in Java 24 zusätzlich als experimentelles Feature freischalten:
| Java-Version | Status | VM-Option |
|---|---|---|
| 24 | experimentell (JEP 450) | -XX:+UnlockExperimentalVMOptions -XX:+UseCompactObjectHeaders |
| 25, 26 | Produktfeature, standardmäßig aus (JEP 519) | -XX:+UseCompactObjectHeaders |
| ab 27 | standardmäßig an (JEP 534) | abschalten mit -XX:-UseCompactObjectHeaders |
Ausblick
Das alte 96-Bit-Layout soll laut JEP 534 in einer künftigen Java-Version als deprecated markiert werden.
Als Nächstes arbeiten die Project-Lilliput-Entwickler:innen an 4-Byte-Headern – also einer weiteren Halbierung der Header-Größe! Für diese weitere Reduzierung müssen wir wahrscheinlich Leistungseinbußen in Kauf nehmen. Der JEP-Entwurf „4-byte Object Headers“ veranschlagt dafür höchstens 5 % weniger Durchsatz oder 5 % mehr Latenz – und das nur in seltenen Fällen. Wie die Komprimierung auf vier Byte erreicht werden soll, steht noch nicht im JEP-Entwurf – wohl aber im Lilliput-Wiki.
Wie sollen 4-Byte-Header funktionieren?
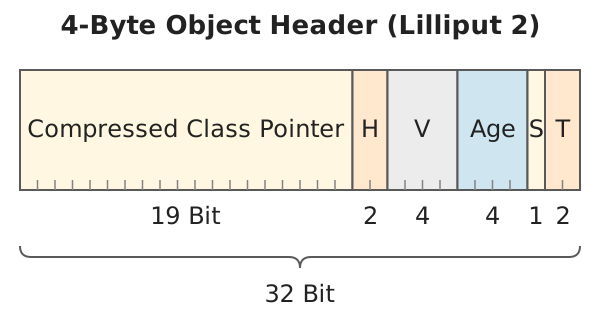
Auf der Wiki-Seite „Lilliput 2 – 4-byte headers“ hat Roman Kennke, der Autor des JEP-Entwurfs, den Plan 2024 skizziert. Der 32-Bit-Header soll so aussehen (H steht für die zwei Hash-Bits, V für die vier für Project Valhalla reservierten Bits, S wieder für das Self Forwarded Tag und T für die zwei Tag-Bits; was es mit den Hash-Bits auf sich hat, erkläre ich gleich):
Die folgenden drei Ideen machen die Halbierung möglich:
Class Pointer auf 19 Bit. Damit lassen sich rund 500.000 Klassen adressieren – für die allermeisten Anwendungen mehr als genug. Für den Rest ist ein Fallback vorgesehen: Ist der Adressraum beim Laden einer Klasse erschöpft, bekommen deren Objekte ein zusätzliches, verstecktes Feld mit dem vollständigen Class Pointer. Im Header steht dann statt des komprimierten Class Pointers ein reserviertes Bitmuster, gefolgt vom Offset dieses Feldes im Objekt.
Identity Hash Code raus aus dem Header. Für die 31 Bit ist kein Platz mehr; im Header bleiben nur zwei Bits, die den Zustand des Hash-Codes festhalten:
00– noch nie angefordert (der Normalfall für die meisten Objekte),01–System.identityHashCode()wurde aufgerufen; der Hash-Code wird aus der Speicheradresse des Objekts berechnet und bleibt gleich, solange das Objekt nicht verschoben wird,10– in einem versteckten Feld am Ende des Objekts gespeichert.
Muss der Garbage Collector ein Objekt im Zustand 01 verschieben, berechnet er den Hash-Code ein letztes Mal aus der alten Adresse, hängt den berechneten Hash-Code ans Ende der Objekt-Kopie an und setzt deren Zustand auf 10. Hat das Objekt ohnehin eine Lücke von mindestens vier Byte in seinem Feld-Layout, überspringt es den Zustand 01: Schon der erste Aufruf von System.identityHashCode() speichert den Hash-Code in dieser Lücke und setzt den Zustand auf 10 – das Objekt muss dann gar nicht wachsen. Objekte, deren Hash-Code nie angefordert wird, behalten also ihre Größe; nur die anderen wachsen um ein Feld, und auch das nur, wenn sie keine Lücke haben.
GC-Forwarding mit Side-Table. Das Problem: Verschiebt eine Full GC ein Objekt, hinterlegt sie die neue Adresse – wie oben beschrieben – vorübergehend im alten Header. Im 4-Byte-Header ist dafür kaum Platz: Class Pointer und Hash-Bits müssen stehen bleiben, weil der Garbage Collector aus ihnen die Objektgröße ableitet. Übrig bleiben elf Bits – und in elf Bits passt keine Adresse.
Der Trick: Eine Full GC verschiebt Objekte nicht kreuz und quer, sondern schiebt die lebenden Objekte in ihrer Reihenfolge lückenlos an den Anfang des Heaps, also zu niedrigeren Adressen. Teilt man den Heap in 4-KB-Blöcke, ist deshalb vorhersagbar, wo die Objekte eines Blocks landen: Sie bleiben beieinander und belegen zusammen höchstens 4 KB; ihre Anfänge – und nur die muss ein Forwarding-Pointer adressieren – liegen damit in höchstens zwei Zielblöcken. Zwei und nicht einer, weil die Reihe meist mitten in einem Zielblock beginnt – dort, wo die Objekte des vorigen Blocks enden – und ein späteres Objekt dann schon im nächsten Zielblock anfängt:
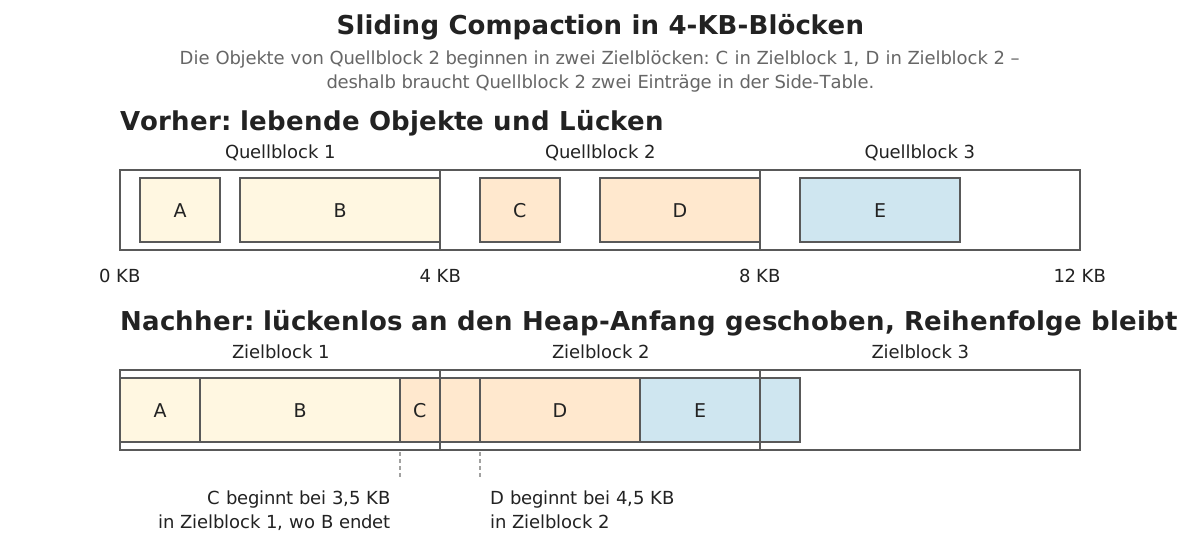
Also merkt sich der Garbage Collector, bevor er verschiebt, für jeden Quellblock diese zwei Zielblöcke in einer Tabelle neben dem Heap – der Side-Table, die höchstens 1/256 der Heap-Größe belegt. Die neue Adresse eines Objekts passt dann in elf Bits: Ein Bit sagt, welcher der beiden Zielblöcke gemeint ist, neun Bits nennen die Position innerhalb dieses Blocks in 8-Byte-Schritten (29 × 8 Byte = 4 KB), und ein Bit markiert das Objekt als verschoben. Beginnt ein Objekt ausnahmsweise in keinem der beiden Blöcke, landet seine neue Adresse in einer Fallback-Hashtabelle.
Offen ist noch der Parallel GC: Seine Full GC geht von einer festen Objektgröße aus und muss für den Compact Identity Hash Code neu geschrieben werden. Ob und wann das alles in ein Java-Release kommt, ist offen – der JEP-Entwurf ist seit Januar 2025 unverändert.
Zusammenfassung
Compact Object Headers schrumpfen den Objekt-Header von 96 auf 64 Bit (12 → 8 Byte), ohne dass Informationen verloren gehen: Der Class Pointer wird von 32 auf 22 Bit komprimiert, indem der Class Space nicht mehr byteweise, sondern in 1-KB-Blöcken adressiert wird. Die freigewordenen Bits gehen an Project Valhalla und an das Self Forwarded Tag, mit dem der Garbage Collector ein nicht kopierbares Objekt markiert, ohne den Class Pointer zu überschreiben.
Das spart 10–20 % Heap (Amazon misst 22 %) und bringt durch weniger Cache-Misses einige Prozent mehr Durchsatz. In Java 24 waren Compact Object Headers experimentell (JEP 450), in Java 25 und 26 musst du sie mit -XX:+UseCompactObjectHeaders einschalten (JEP 519), seit Java 27 sind sie Standard (JEP 534).
Der nächste Schritt sind 4-Byte-Header: Class Pointer auf 19 Bit, der Identity Hash Code verlässt den Header, und das GC-Forwarding läuft über eine Side-Table. Das ist bisher ein Plan im Lilliput-Wiki und ein JEP-Entwurf ohne Zielversion.
Wenn dir der Artikel weitergeholfen hat, würde ich mich sehr über eine positive Bewertung auf meinem ProvenExpert-Profil freuen. Dein Feedback hilft mir, meine Inhalte weiter zu verbessern und motiviert mich, neue informative Artikel zu schreiben.