Mit Java 11 wurde am 25. September 2018 das erste Long-Term-Support (LTS)-Release des JDK seit der Umstellung auf den sechsmonatigen Release-Zyklus veröffentlicht. „Long-Term-Support“ bedeutet, dass die JDK-Anbieter diese Version über Jahre mit Sicherheitspatches versorgen.
Bei Oracle endete der Premier Support für Java 11 am 30. September 2023, der kostenpflichtige Extended Support läuft bis zum 31. Januar 2032. Kostenlose Updates liefert Eclipse Temurin bis Oktober 2027.
Die letzte LTS-Version war Java 8. Java 9 und 10 waren keine LTS-Releases, was bedeutet, dass der Support dieser Versionen mit der jeweils folgenden Version eingestellt wurde.
Ich habe die Änderungen in Java 11 nach Relevanz für die tägliche Entwicklerarbeit sortiert. Zuerst kommen Änderungen an der Sprache selbst. Es folgen Erweiterungen an der JDK-Klassenbibliothek, Tools und experimentelle Features. Und zuletzt Deprecations, Löschungen und sonstige kleine Änderungen.
Wichtig ist noch zu wissen, dass das Oracle JDK 11 – wie alle Versionen bis Java 16 – nur für Entwickler:innen frei nutzbar ist. Für den Produktiveinsatz brauchen Firmen eine kostenpflichtige Subscription von Oracle. OpenJDK 11 hingegen ist für alle frei einsetzbar.
Seit Java 17 steht das Oracle JDK unter einer kostenlosen Lizenz (NFTC) – allerdings nur für die Updates, die bis ein Jahr nach dem nächsten LTS-Release erscheinen.
Local-Variable Syntax for Lambda Parameters
Mit dem JDK Enhancement Proposal 323 wird die Verwendung von „var“ in Parametern von implizit typisierten Lambda-Ausdrücken erlaubt.
Was ist ein implizit typisierter Lambda-Ausdruck?
Fangen wir mit einem explizit typisierten Lambda-Ausdruck an. Explizit bedeutet in folgendem Beispiel, dass die Datentypen der Lambda-Parameter l und s – also List<String> und String – mit angegeben sind:
(List<String> l, String s) -> l.add(s);Der Compiler kann die Typen allerdings auch aus dem Kontext herleiten, so dass auch folgende – implizit typisierte – Schreibweise erlaubt ist:
(l, s) -> l.add(s);Seit Java 11 kann anstelle der expliziten Typen auch das in Java 10 eingeführte „var“ verwendet werden:
(var l, var s) -> l.add(s);Doch warum sollte man „var“ schreiben, wenn man die Typen, wie im Beispiel davor, komplett weglassen kann?
Der Grund dafür sind Annotationen. Soll eine Variable annotiert werden, muss die Annotation am Typ stehen – das kann ein expliziter Typ sein oder auch „var“. Eine Annotation direkt am Variablennamen ist nicht erlaubt.
Möchte man die Variablen im obigen Beispiel-Lambda annotieren, war vor Java 11 nur folgende Schreibweise möglich:
(@Nonnull List<String> l, @Nullable String s) -> l.add(s);Java 11 erlaubt mit „var“ nun auch folgende, kürzere Variante:
(@Nonnull var l, @Nullable var s) -> l.add(s);Die verschiedenen Schreibweisen dürfen nicht gemischt werden. D. h. du musst entweder für alle Variablen den Typ angeben, alle Typen weglassen oder bei allen Variablen „var“ verwenden.
Welche Form du letztendlich wählst, hängt von der Lesbarkeit im konkreten Fall und den Stil-Vorgaben deines Teams ab.
HTTP Client (Standard)
Um vor Java 11 mit JDK-Hausmitteln Daten z. B. per HTTP-POST zu versenden, war eine ganze Menge Code erforderlich.
public String post(String url, String data) throws IOException {
  URL urlObj = new URL(url);
  HttpURLConnection con = (HttpURLConnection) urlObj.openConnection();
  con.setRequestMethod("POST");
  con.setRequestProperty("Content-Type", "application/json");

  // Send data
  con.setDoOutput(true);
  try (OutputStream os = con.getOutputStream()) {
    byte[] input = data.getBytes(StandardCharsets.UTF_8);
    os.write(input, 0, input.length);
  }

  // Handle HTTP errors
  if (con.getResponseCode() != 200) {
    con.disconnect();
    throw new IOException("HTTP response status: " + con.getResponseCode());
  }

  // Read response
  String body;
  try (InputStreamReader isr = new InputStreamReader(con.getInputStream());
      BufferedReader br = new BufferedReader(isr)) {
    body = br.lines().collect(Collectors.joining("\n"));
  }
  con.disconnect();

  return body;
}Das JDK 11 enthält die neue Klasse HttpClient, die die Arbeit mit HTTP wesentlich vereinfacht.
Den Code oben kann man mit HttpClient deutlich kürzer und aussagekräftiger schreiben:
public String post(String url, String data) throws IOException, InterruptedException {
  HttpClient client = HttpClient.newHttpClient();

  HttpRequest request =
      HttpRequest.newBuilder()
          .uri(URI.create(url))
          .header("Content-Type", "application/json")
          .POST(BodyPublishers.ofString(data))
          .build();

  HttpResponse<String> response = client.send(request, BodyHandlers.ofString());

  if (response.statusCode() != 200) {
    throw new IOException("HTTP response status: " + response.statusCode());
  }

  return response.body();
}
Die neue HttpClient-Klasse ist vielseitig einsetzbar:
- Über
BodyPublishers.ofString()senden wir im Beispiel oben einen String. Über die MethodenofByteArray(),ofByteArrays(),ofFile()undofInputStream()derselben Klasse können wir die zu sendenden Daten auch aus anderen Quellen lesen. - Analog kann die Klasse
BodyHandlers, mit derenofString()-Methode wir die Antwort als String geliefert bekommen, auch Byte-Arrays und Streams liefern oder die empfangene Antwort in einer Datei speichern. HttpClientunterstützt im Gegensatz zuHttpURLConnectionauch HTTP/2 und WebSocket.- Außerdem bietet
HttpClientneben dem oben gezeigten synchronen Programmiermodell auch ein asynchrones Modell. Die MethodeHttpClient.sendAsync()gibt dabei einCompletableFuturezurück, mit dem wir dann asynchron weiterarbeiten können.
Eine asynchrone Variante der post()-Methode kann z. B. wie folgt aussehen:
public void postAsync(
    String url, String data, Consumer<String> consumer, IntConsumer errorHandler) {
  HttpClient client = HttpClient.newHttpClient();

  HttpRequest request =
      HttpRequest.newBuilder()
          .uri(URI.create(url))
          .header("Content-Type", "application/json")
          .POST(BodyPublishers.ofString(data))
          .build();

  client
      .sendAsync(request, BodyHandlers.ofString())
      .thenAccept(
          response -> {
            if (response.statusCode() == 200) {
              consumer.accept(response.body());
            } else {
              errorHandler.accept(response.statusCode());
            }
          });
}
(HttpClient ist definiert im JDK Enhancement Proposal 321.)
Neue Collection.toArray()-Methode
Vor Java 11 bot das Collection-Interface zwei toArray()-Methoden, um Collections in Arrays zu konvertieren. Das folgende Beispiel zeigt diese zwei Methoden (und zwei unterschiedliche Anwendungen der zweiten Methode) am Beispiel einer Liste von Strings:
List<String> list = List.of("foo", "bar", "baz");

Object[] strings1 = list.toArray();

String[] strings2a = list.toArray(new String[list.size()]);
String[] strings2b = list.toArray(new String[0]);
Die erste toArray()-Methode ohne Parameter liefert ein Objekt-Array zurück, da aufgrund von Type Erasure zur Laufzeit die Typ-Information von list nicht mehr bekannt ist.
Der zweiten toArray()-Methode übergeben wir ein Array des gewünschten Typs. Wenn dieses Array mindestens so groß ist wie die Collection, werden die Elemente in diesem Array hinterlegt (strings2a). Andernfalls wird ein neues Array in der erforderlichen Größe erstellt (strings2b).
Seit Java 11 können wir auch Folgendes schreiben:
String[] strings = list.toArray(String[]::new);Diese Methode erlaubt es den Collection-Klassen, anhand der übergebenen Referenz auf den Array-Konstruktor selbst ein Array der benötigten Größe zu erstellen.
Genutzt wird diese Möglichkeit allerdings nicht. Die Default-Methode im Collection-Interface erstellt ein leeres Array und ruft damit die toArray()-Methode mit Array-Parameter auf:
default <T> T[] toArray(IntFunction<T[]> generator) {
  return toArray(generator.apply(0));
}
Überschrieben wird diese Default-Methode in Java 11 nur von den Wrappern aus Collections, z. B. unmodifiableCollection() und synchronizedCollection() – und die reichen den Aufruf an die eingepackte Collection weiter. ArrayList, HashSet und alle anderen Collection-Klassen aus java.util und java.util.concurrent überschreiben sie nicht.
Für diese Änderung gibt es keinen JEP; sie wird im Bug-Tracker unter JDK-8060192 aufgeführt.
Neue String-Methoden
In Java 11 wurde die Klasse String um einige hilfreiche Methoden erweitert:
String.strip(), stripLeading(), stripTrailing()
Die Methode String.strip() entfernt aus einem String alle führenden und abschließenden Leerzeichen.
Haben wir dafür nicht schon die Methode String.trim()?
Ja, mit dem folgenden Unterschied:
trim()entfernt alle Zeichen, deren Codepoint U+0020 oder kleiner ist. Das schließt z. B. „Space“, „Tab“, „Newline“ und „Carriage Return“ ein.strip()entfernt diejenigen Zeichen, dieCharacter.isWhitespace()als Leerzeichen einstuft. Das sind zum einen einige (aber nicht alle) Zeichen mit Codepoint U+0020 oder kleiner. Und zum anderen Zeichen, die im Unicode-Standard als Leerzeichen, Zeilenumbrüche und Absatztrennzeichen definiert sind (z. B. U+2002 – ein Leerzeichen, das so breit ist wie der Buchstabe „n“).
Es gibt noch zwei Varianten der Methode: stripLeading() entfernt nur führende Leerzeichen, stripTrailing() nur abschließende.
String.isBlank()
Die Methode String.isBlank() liefert genau dann true zurück, wenn der String leer ist oder nur solche Zeichen enthält, die das im vorangegangenen Punkt genannte Character.isWhitespace() als Leerzeichen einstuft.
String.repeat()
Mit String.repeat() wird ein String wiederholt aneinandergereiht:
System.out.println(":-) ".repeat(10));:-) :-) :-) :-) :-) :-) :-) :-) :-) :-) String.lines()
Die Methode String.lines() trennt einen String an Zeilenumbrüchen auf und liefert einen Stream aller Zeilen zurück.
Hier ist ein kleines Beispiel:
Stream<String> lines = "foo\nbar\nbaz".lines();
lines.forEachOrdered(System.out::println);
foo
bar
bazFür diese Erweiterungen der String-Klasse gibt es keinen JEP; sie werden im Bug-Tracker unter JDK-8200377 (strip(), stripLeading(), stripTrailing()), JDK-8200436 (isBlank()), JDK-8197594 (repeat()) und JDK-8200380 (lines()) aufgeführt.
Files.readString() und writeString()
Das Lesen und Schreiben von Textdateien wurde seit Java 6 kontinuierlich vereinfacht. In Java 6 mussten wir noch einen FileInputStream öffnen, diesen mit einem InputStreamReader und einem BufferedReader wrappen, dann die Textdatei Zeile für Zeile in einen StringBuilder laden (oder, alternativ, den BufferedReader weglassen und die Daten in char[]-Blöcken auslesen) und im finally-Block die Reader und den InputStream wieder schließen.
Zum Glück gab es Libraries wie Apache Commons IO, die uns mit den Methoden FileUtils.readFileToString() und writeStringToFile() diese Arbeit abnahmen.
In Java 7 konnten wir die ineinander geschachtelte Stream/Reader- bzw. Stream/Writer-Kombination mit Files.newBufferedWriter() und Files.newBufferedReader() deutlich einfacher erzeugen. Und dank try-with-resources brauchten wir auch keinen finally-Block mehr.
Dennoch waren noch immer mehrere Zeilen Code notwendig:
public static void writeStringJava7(Path path, String text) throws IOException {
  try (BufferedWriter writer =
      Files.newBufferedWriter(path, StandardCharsets.UTF_8)) {
    writer.write(text);
  }
}

private static String readFileJava7(Path path) throws IOException {
  StringBuilder sb = new StringBuilder();
  try (BufferedReader reader =
      Files.newBufferedReader(path, StandardCharsets.UTF_8)) {
    String line;
    while ((line = reader.readLine()) != null) {
      sb.append(line).append('\n');
    }
  }
  return sb.toString();
}
Mit Java 11 bekommen wir endlich Methoden, die es mit denen von Drittanbieter-Bibliotheken aufnehmen können:
Files.writeString(path, text, StandardCharsets.UTF_8);

text = Files.readString(path, StandardCharsets.UTF_8);
Den Zeichensatz-Parameter kannst du auch weglassen. Beide Methoden verwenden dann UTF-8 – unabhängig vom Standardzeichensatz des Betriebssystems.
Für diese Änderung gibt es keinen JEP; sie wird im Bug-Tracker unter JDK-8201276 aufgeführt.
Path.of()
Path-Objekte mussten wir vor Java 11 über Paths.get() erstellen – oder File.toPath(). Seit Java 8 dürfen Interfaces statische Methoden enthalten. Das erlaubte es den JDK-Entwickler:innen, entsprechende Factory-Methoden direkt in das Path-Interface zu integrieren.
Seit Java 11 kannst du Path-Objekte beispielsweise wie folgt erstellen:
// Relative path foo/bar/baz
Path.of("foo/bar/baz");
Path.of("foo", "bar/baz");
Path.of("foo", "bar", "baz");

// Absolute path /foo/bar/baz
Path.of("/foo/bar/baz");
Path.of("/foo", "bar", "baz");
Path.of("/", "foo", "bar", "baz");
Als Parameter kannst du den gesamten Pfad oder Teile des Pfades angeben – in beliebigen Kombinationen, wie im Beispiel zu sehen.
Um einen absoluten Pfad zu definieren, muss der erste Teil unter Linux und macOS mit „/“ beginnen und unter Windows mit einem Laufwerksbuchstaben, wie z. B. „C:\“.
Für diese Änderung gibt es keinen JEP; sie wird im Bug-Tracker unter JDK-8194746 aufgeführt.
Optional.isEmpty() und Predicate.not()
Zwei kleine Ergänzungen machen Bedingungen lesbarer, die vorher eine Negation brauchten.
Die Methode Optional.isEmpty() ist das Gegenstück zu isPresent(): Sie liefert true, wenn ein Optional keinen Wert enthält.
Das folgende Beispiel prüft ein leeres Optional:
Optional<String> name = Optional.empty();
System.out.println(name.isEmpty());trueDie statische Methode Predicate.not() negiert ein Prädikat. Damit lässt sich auch eine Methodenreferenz negieren, die sich sonst nur als Lambda-Ausdruck mit ! umkehren ließe.
Das folgende Beispiel filtert mit Predicate.not(String::isBlank) alle Strings aus einem Stream, die leer sind oder nur aus Leerzeichen bestehen:
List<String> words = Stream.of("foo", " ", "bar", "")
    .filter(Predicate.not(String::isBlank))
    .collect(Collectors.toList());
System.out.println(words);
[foo, bar]Für diese beiden Änderungen gibt es keinen JEP; sie werden im Bug-Tracker unter JDK-8184693 und JDK-8050818 aufgeführt.
Epsilon: A No-Op Garbage Collector
Mit dem JDK 11 erhalten wir einen neuen Garbage Collector: den Epsilon GC.
Der Epsilon GC macht ... nichts. Nun, nicht ganz. Er verwaltet die Allokation von Objekten auf dem Heap – er hat aber keinen Garbage-Collection-Prozess, mit dem er die Objekte wieder freigibt.
Welchen Zweck hat ein Garbage Collector, der keinen Garbage collected?
Folgende Einsatzszenarien sind denkbar:
- Performance-Tests: Bei Micro-Benchmarks z. B., bei denen man verschiedene Implementierungen von Algorithmen miteinander vergleicht, ist ein regulärer Garbage Collector hinderlich, da er die Ausführungszeiten beeinflussen und damit die Messergebnisse verfälschen kann. Durch die Verwendung des Epsilon GC können solche Beeinflussungen ausgeschlossen werden.
- Extrem kurzlebige Applikationen, wie z. B. für AWS Lambda entwickelte, sollen so schnell wie möglich beendet werden. Ein Garbage-Collection-Zyklus wäre hier Zeitverschwendung, wenn die Applikation ohnehin wenige Millisekunden später wieder beendet wird.
- Eliminierung von Latenzen: Wenn Entwickler:innen den Speicherbedarf ihrer Anwendung gut kennen und komplett oder nahezu komplett auf Objekt-Allokationen verzichten, ermöglicht ihnen der Epsilon GC, eine latenzfreie Anwendung zu implementieren.
Epsilon GC ist ein experimentelles Feature. Aktiviert wird er deshalb über zwei Optionen in der java-Befehlszeile:
-XX:+UnlockExperimentalVMOptions -XX:+UseEpsilonGC
(Epsilon GC ist definiert im JDK Enhancement Proposal 318.)
Launch Single-File Source-Code Programs
Für kleine Java-Programme, die aus nur einer Klasse bestehen, wird der JDK Enhancement Proposal 330 interessant.
Damit ist es zum einen möglich, eine .java-Datei mit dem java-Kommando zu compilieren und auszuführen. Zum anderen kann eine .java-Datei durch ein sogenanntes „Shebang“ direkt ausführbar gemacht werden.
Was genau das bedeutet, zeige ich dir an einem einfachen Beispiel.
Erstelle dazu eine Datei mit dem Namen Hello.java und folgendem Inhalt:
public class Hello {
  public static void main(String[] args) {
    if (args.length > 0) {
      System.out.printf("Hello %s!%n", args[0]);
    } else {
      System.out.println("Hello!");
    }
  }
}
Vor Java 11 musstest du dieses Programm zuerst mit javac compilieren, um es dann mit java ausführen zu können:
$ javac Hello.java
$ java Hello Anna

Hello Anna!
Ab Java 11 kannst du den ersten Schritt weglassen:
$ java Hello.java Anna

Hello Anna!
Der Quellcode wird dabei in den Arbeitsspeicher compiliert und von dort ausgeführt.
Auf Linux und macOS kannst du noch einen Schritt weiter gehen und direkt ein ausführbares Java-Skript schreiben. Dazu musst du in der ersten Zeile ein sogenanntes „Shebang“ und die Java-Version eintragen:
#!/usr/bin/java --source 11

public class Hello {
  public static void main(String[] args) {
    if (args.length > 0) {
      System.out.printf("Hello %s!%n", args[0]);
    } else {
      System.out.println("Hello!");
    }
  }
}
Die Datei darf keine .java-Endung haben. Benenne sie um in Hello und mache sie ausführbar:
mv Hello.java Hello
chmod +x Hello
Jetzt kannst du sie direkt ausführen:
$ ./Hello Anna

Hello Anna!
Ziemlich cool, oder? Für kleinere Tools kann das sehr nützlich sein.
Nest-Based Access Control
Bei der Verwendung von inneren Klassen bekommen wir Java-Entwickler:innen immer wieder die folgende Warnung zu sehen:
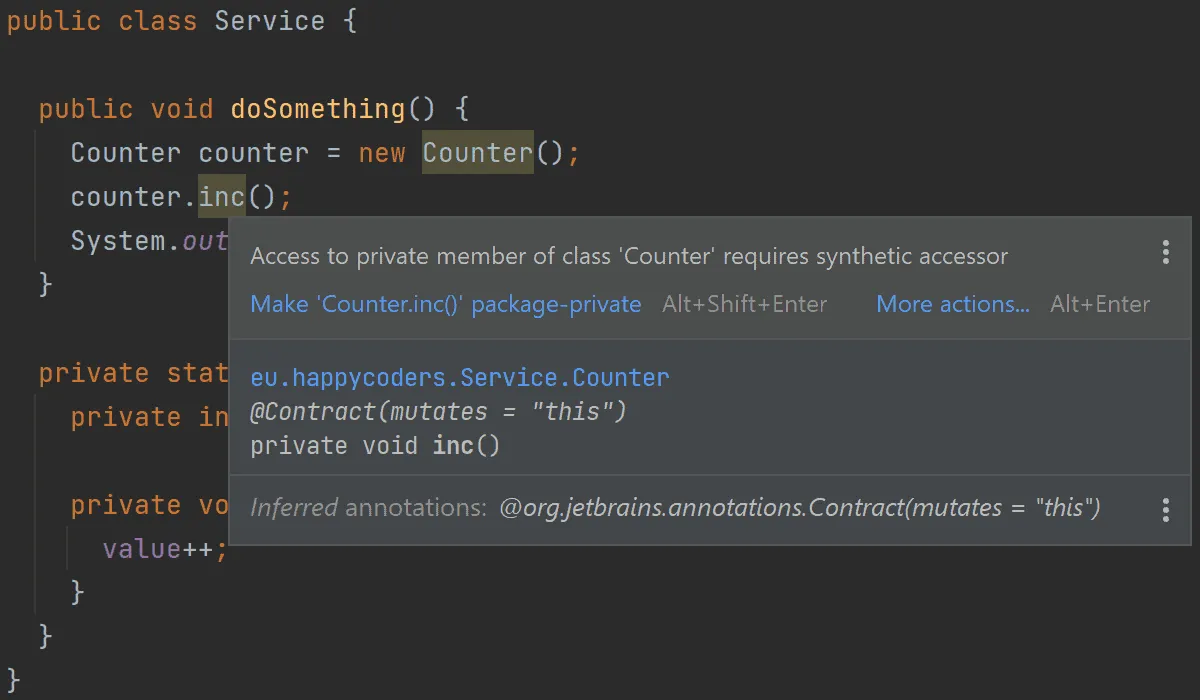
Was hat es damit auf sich?
Die Java Language Specification (JLS) erlaubt den Zugriff auf private Felder und Methoden von inneren Klassen. Die Java Virtual Machine (JVM) hingegen erlaubte das bis Java 10 nicht.
Um diesen Widerspruch aufzulösen, fügt der Java-Compiler (bis Java 10) beim Zugriff auf diese privaten Felder und Methoden sogenannte „synthetische Accessor-Methoden“ ein – mit der Standard-Sichtbarkeit „package-private“.
Diese zusätzlichen Methoden führen dazu, dass scheinbar private Felder und Methoden vom gesamten Paket aus zugänglich sind. Dementsprechend erfolgt die Warnung.
Auflösen ließ sich das bis Java 10, indem man die entsprechenden Members entweder selbst package-private machte oder – dies ging nur in Eclipse – den Code mit der Annotation @SuppressWarnings("synthetic-access") versah.
Mit dem JDK Enhancement Proposal 181 wird die Zugriffskontrolle der JVM so erweitert, dass der Zugriff auf private Members von inneren Klassen ohne synthetische Accessoren auskommt.
Solltest du Methoden und Felder innerer Klassen aus o. g. Grund package-private gemacht haben oder @SuppressWarnings eingesetzt haben, dann kannst du das mit Java 11 wieder rückgängig machen.
Analyse-Tools
Java Flight Recorder
Zahlreiche Tools helfen uns bei der Fehleranalyse und -behebung während des Entwicklungsprozesses. Bestimmte Probleme treten aber erst im Betrieb einer Anwendung auf. Deren Analyse ist oft schwer bis unmöglich, da wir solche Fehler oft nicht reproduzieren können.
Java Flight Recorder (JFR) kann uns hier zur Seite stehen, indem er während des Betriebs einer Anwendung zahlreiche JVM-Daten aufzeichnet und in einer Datei zur nachträglichen Analyse bereitstellt.
Flight Recorder gab es vorher schon seit mehreren Jahren als kommerzielles Feature im Oracle JDK. Mit dem JDK Enhancement Proposal 328 wird er Teil des OpenJDK und kann damit frei eingesetzt werden.
Wie startet man Flight Recorder?
Du kannst Flight Recorder auf zwei Arten starten. Zum einen kannst du ihn beim Start einer Anwendung über folgende Option in der java-Befehlszeile aktivieren:
-XX:StartFlightRecording=filename=<file name>
Zum anderen kannst du jcmd nutzen, um Flight Recorder in einer laufenden Java-Anwendung zu aktivieren:
jcmd <pid> JFR.start filename=<file name>
Bei beiden Varianten kannst du zahlreiche weitere Optionen angeben; z. B. kannst du mit „duration“ festlegen, wie lange der Recorder laufen soll. Alle Optionen im Detail vorzustellen würde den Rahmen dieses Artikels sprengen. Du findest sie in Oracles Dokumentation der Befehle java (Option -XX:StartFlightRecording) und jcmd (Befehl JFR.start).
Java Flight Recorder Beispiel
In folgendem Beispiel sei 31100 die Prozess-ID der zu analysierenden Java-Anwendung. Die Aufzeichnung wird wie folgt gestartet (über den optionalen Parameter „name“ geben wir dabei einen Namen für die Aufzeichnung an):
$ jcmd 31100 JFR.start filename=myrecording.jfr name=myrecording
31100:
Started recording 1. No limit specified, using maxsize=250MB as default.

Use jcmd 31100 JFR.dump name=myrecording to copy recording data to file.
Flight Recorder schreibt die angegebene Datei erst, wenn die Aufzeichnung endet – spätestens beim Beenden der Anwendung. Du kannst die Aufzeichnung aber auch zwischendurch speichern, indem du das Dump-Kommando ausführst, das dir beim Start angezeigt wurde:
$ jcmd 31100 JFR.dump name=myrecording
31100:
Dumped recording "myrecording", 344.8 kB written to:

<path>/myrecording.jfr
Falls du beim Start keinen „name“-Parameter angegeben hast, kannst du als Namen die Nummer der Aufzeichnung (im Beispiel oben „1“) angeben.
Stoppen kannst du Flight Recorder wie folgt:
$ jcmd 31100 JFR.stop name=myrecording
31100:
Stopped recording "myrecording".
Wie analysiert man nun die von Flight Recorder gespeicherte Datei?
JDK Mission Control
Zur Betrachtung der Analysedaten benötigst du ein weiteres Tool: JDK Mission Control. Auf der GitHub-Seite des Projekts findest du Links zu mehreren Distributoren, bei denen du Mission Control für Windows, Mac und Linux herunterladen kannst.
Über „File / Open File...“ lädst du die Analysedatei. Mission Control zeigt dir zunächst eine Übersicht der gesammelten Daten:
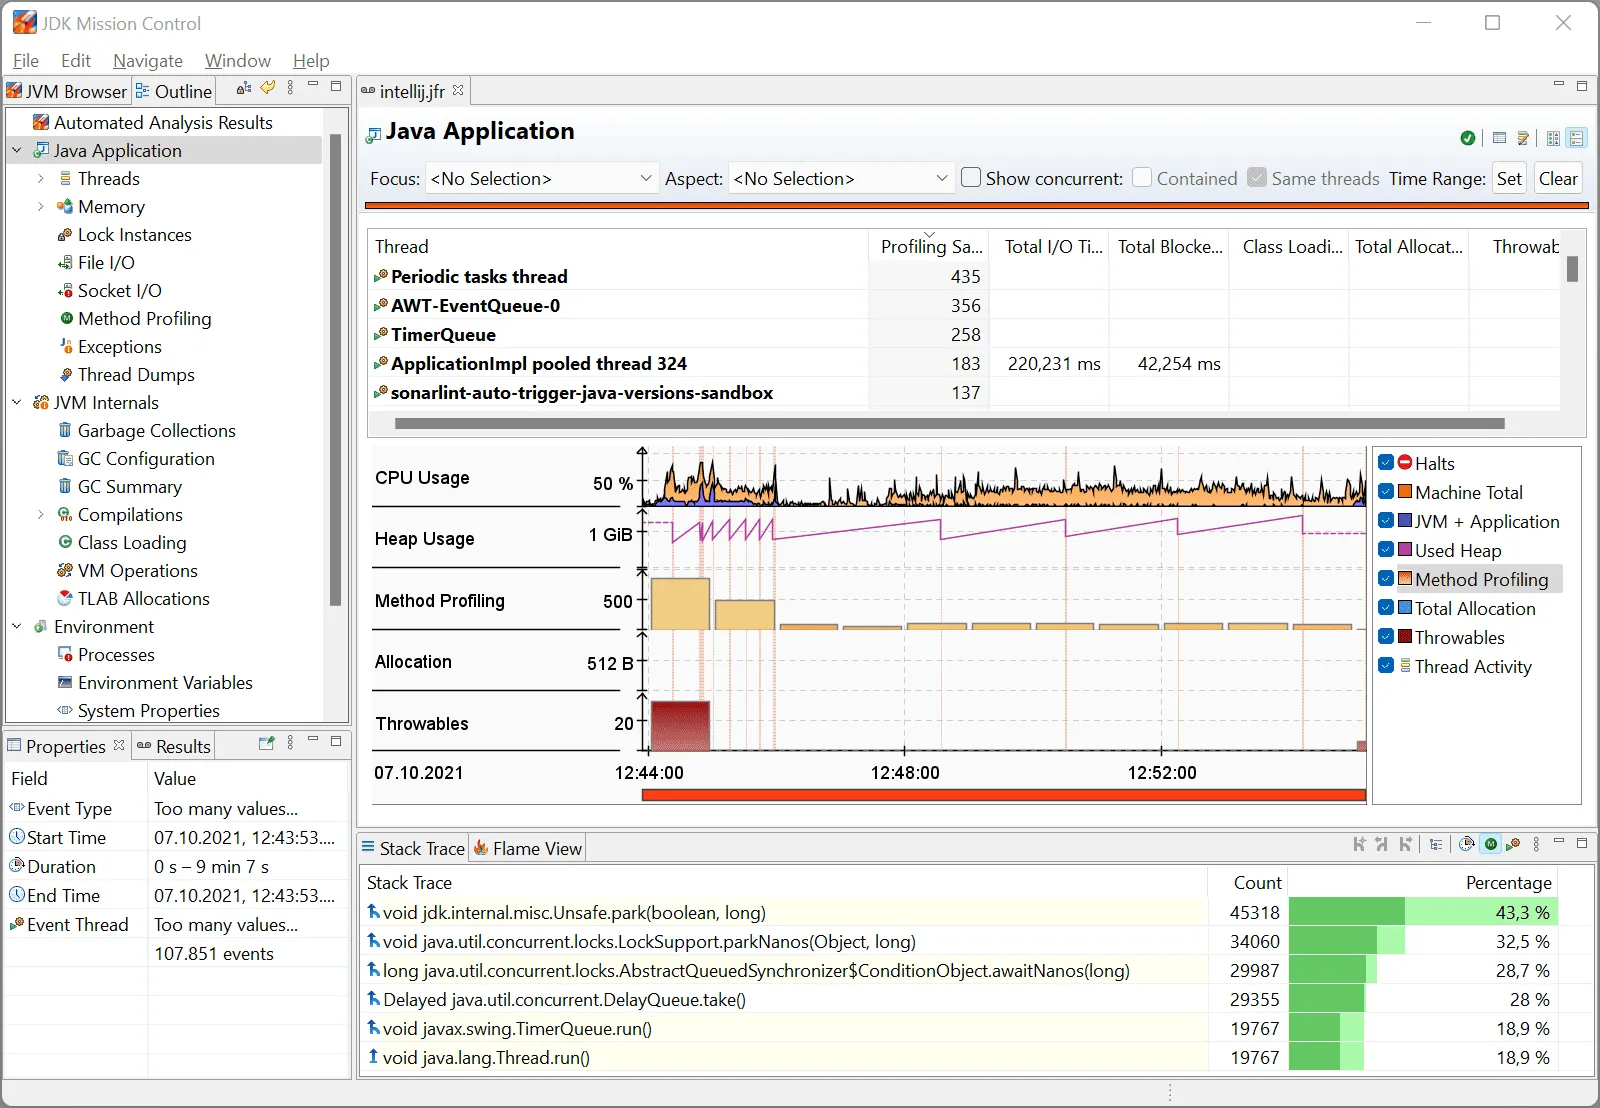
Über die Navigation links kannst du dir dann einzelne Bereiche wie Threads, Speicherbelegung und Locks genauer ansehen. Unter „Threads“ z. B. siehst du, welche Threads von wann bis wann liefen:
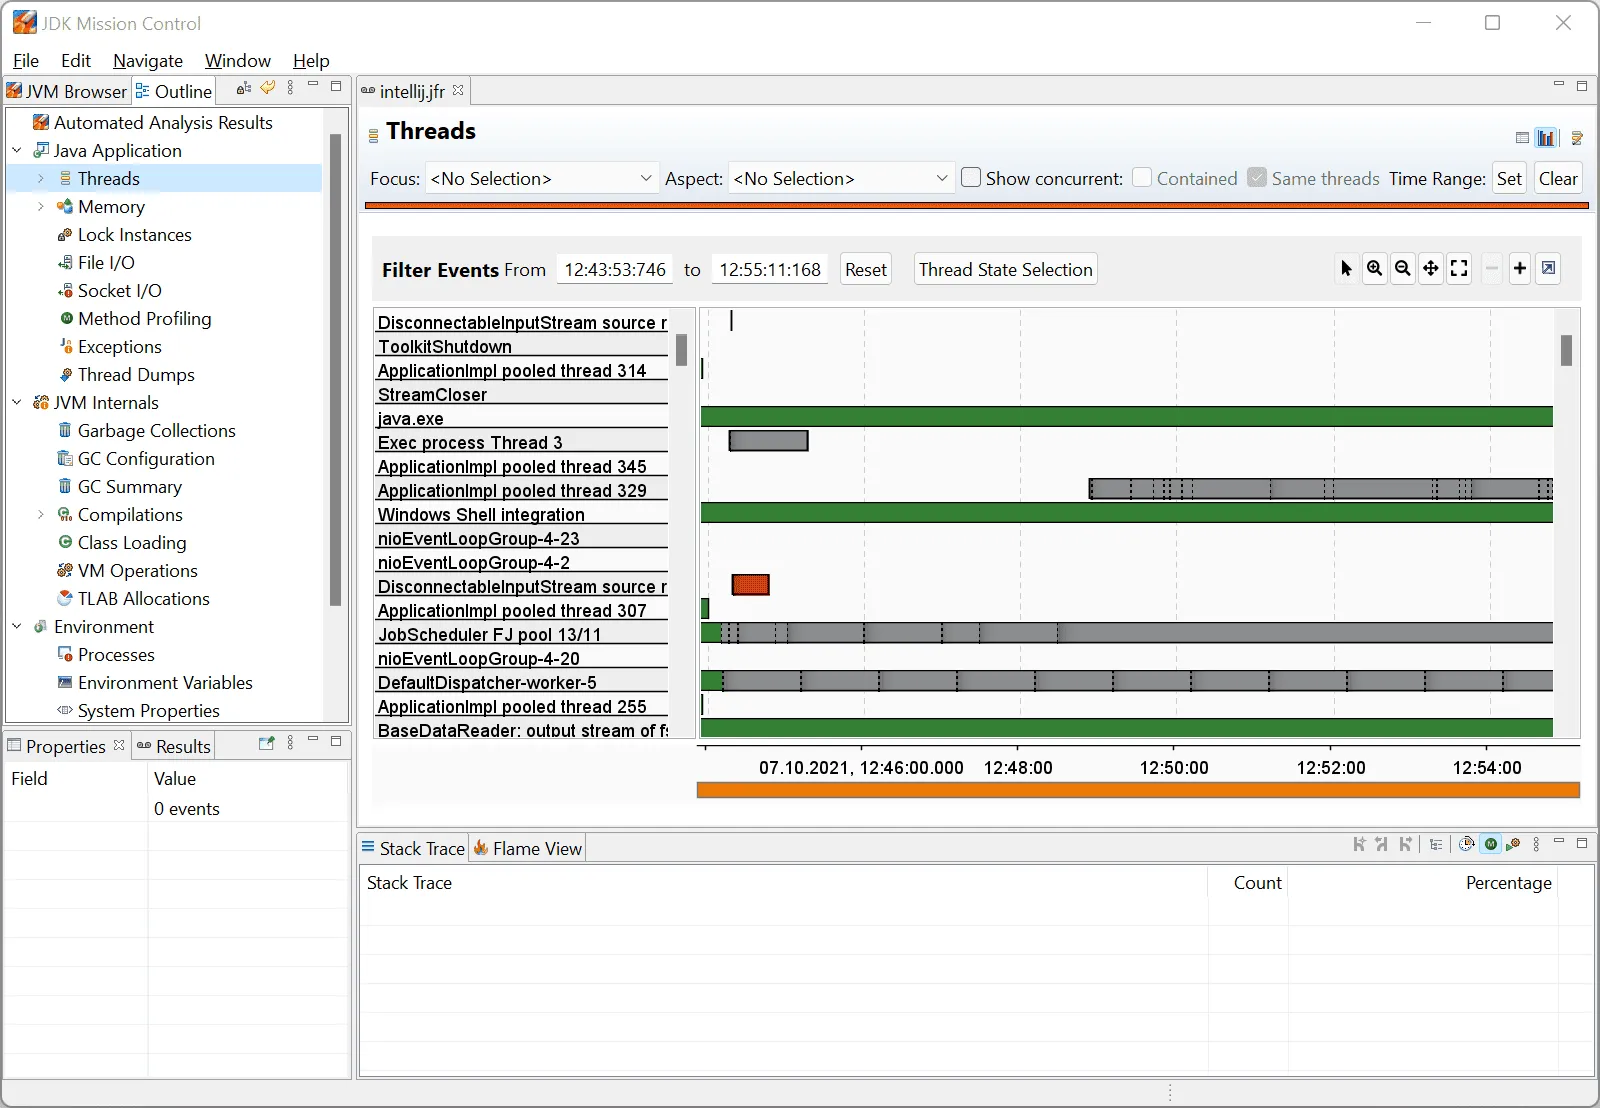
Auch unter den anderen Navigationspunkten findest du spannende Aufbereitungen der gesammelten Daten. Probier es am besten gleich selbst einmal aus!
Low-Overhead Heap Profiling
Ein wichtiges Werkzeug bei der Analyse von Speicherproblemen (z. B. hohe Garbage-Collector-Zeiten oder OutOfMemoryErrors) sind Heap-Dumps zur Analyse der auf dem Heap liegenden Objekte. Der Markt bietet hierfür zahlreiche Tools an. Was diese Werkzeuge vor Java 11 nicht verrieten, war, an welcher Stelle des Programmcodes die auf dem Heap liegenden Objekte erzeugt wurden.
Mit JEP 331 wird das Java Virtual Machine Tool Interface (JVMTI) – also das Interface, über das diese Tools die Daten über die laufende Anwendung beziehen – um die Möglichkeit erweitert, Stichproben von Objekt-Allokationen samt Stack Trace zu sammeln. Das Abtastintervall legst du dabei selbst fest. Die Heap-Analyse-Tools können diese Zusatzinformationen mit anzeigen und uns Entwickler:innen die Problemanalyse so wesentlich erleichtern.
Experimentelle Features
Auf experimentelle Features gehe ich nur kurz ein und verweise stattdessen auf die Java-Versionen, in denen sie als „production-ready“ released wurden.
ZGC: A Scalable Low-Latency Garbage Collector (Experimental)
Der „Z Garbage Collector“ – kurz ZGC – ist ein von Oracle entwickelter alternativer Garbage Collector mit dem Ziel, GC-Pausen auf maximal 10 ms zu begrenzen – ohne dabei den Gesamtdurchsatz gegenüber dem G1GC um mehr als 15 % zu reduzieren.
In Java 11 ist ZGC nur für Linux/x64 verfügbar; macOS und Windows kamen in Java 14 dazu. Aktivieren kannst du ihn mit den folgenden JVM-Flags:
-XX:+UnlockExperimentalVMOptions -XX:+UseZGC
In Java 15 wurde ZGC produktionsreif; im Artikel dazu beschreibe ich ihn ausführlicher.
(Dieses experimentelle Release ist im JDK Enhancement Proposal 333 definiert.)
Deprecations und Löschungen
Dieser Abschnitt listet alle als „deprecated“ markierten und aus dem JDK entfernten Features auf.
Remove the Java EE and CORBA Modules
Mit dem JDK Enhancement Proposal 320 werden folgende Module aus dem JDK entfernt:
- java.xml.ws (JAX-WS)
- java.xml.bind (JAXB)
- java.activation (JAF)
- java.xml.ws.annotation (Common Annotations)
- java.corba (CORBA)
- java.transaction (JTA)
- java.se.ee (Aggregatormodul für die sechs zuvor genannten Module)
- jdk.xml.ws (Tools für JAX-WS)
- jdk.xml.bind (Tools für JAXB)
Der Web-Services-Stack – JAX-WS, JAXB, JAF und Common Annotations – wurde ursprünglich für die Java-EE-Plattform entwickelt und mit Java 6 in die Standard Edition „Java SE“ übernommen. CORBA gehört schon seit 1998 zu Java SE, Teile von JTA seit Java 1.3. In Java 9 wurden all diese Module als „deprecated“ markiert und mit Java 11 endgültig entfernt.
Sollten dir diese Libraries beim Upgrade auf Java 11 fehlen, dann kannst du sie z. B. per Maven-Dependencies wieder in dein Projekt ziehen.
Deprecate the Nashorn JavaScript Engine
Die im JDK 8 eingeführte JavaScript-Engine „Nashorn“ wurde in Java 11 mit dem JEP 335 als „deprecated for removal“ markiert und in Java 15 mit JEP 372 entfernt.
Grund dafür ist das Tempo, mit dem sich ECMAScript (der Standard hinter JavaScript) weiterentwickelt – das hat die Pflege von Nashorn zu aufwändig gemacht.
Deprecate the Pack200 Tools and API
Pack200 ist ein in Java 5 eingeführtes, spezielles Kompressionsverfahren, das insbesondere für .class- und .jar-Dateien höhere Kompressionsraten erreicht als Standardverfahren. Entwickelt wurde Pack200, um in den frühen 2000ern möglichst viel Bandbreite einzusparen.
Der Algorithmus ist jedoch komplex, und die Weiterentwicklungskosten stehen in Zeiten von 100-MBit-Internetleitungen in keinem Verhältnis zum Nutzen mehr.
Daher wurde das Tool mit dem JDK Enhancement Proposal 336 als „deprecated“ markiert und in Java 14 mit JEP 367 entfernt.
JavaFX geht eigene Wege
Beginnend mit Java 11 wird JavaFX (und das dazugehörende Tool javapackager) nicht mehr mit dem Oracle JDK ausgeliefert – in den OpenJDK-Builds war es nie enthalten. Du kannst es stattdessen als separates SDK von der JavaFX-Homepage herunterladen.
Ebenfalls aus dem Oracle JDK entfernt wurde der Deployment-Stack für Applets und Java-Web-Start-Anwendungen.
Für diese Änderungen gibt es keinen JEP; Oracle führt sie in den Release Notes von Java 11 auf.
Sonstige Änderungen in Java 11 (die man als Java-Entwickler:in nicht unbedingt kennen muss)
Dieser Abschnitt listet weitere Änderungen unter der Haube von Java 11 auf, von denen du wahrscheinlich nicht direkt etwas mitbekommen wirst. Es kann trotzdem sinnvoll sein, die folgenden Abschnitte einmal zu überfliegen.
Unicode 10
Mit dem JDK Enhancement Proposal 327 wurde Java 11 um Support für Unicode 10.0 erweitert. Da Java 10 noch Unicode 8.0 unterstützte, kommen dabei auch die Neuerungen von Unicode 9.0 hinzu.
Was bedeutet das?
Insbesondere die Klassen String und Character mussten um die neuen Codeblöcke und Zeichen erweitert werden. Relevant ist das z. B. für String.toUpperCase() und toLowerCase() sowie für Character.getName() und Character.UnicodeBlock.of().
Hier ist ein kurzes Code-Beispiel (der Unicode-Codepoint 0x1F929 steht für das Emoji 🤩):
System.out.println("name  = " + Character.getName(0x1F929));
System.out.println("block = " + Character.UnicodeBlock.of(0x1F929));
Java 10 kennt zwar den Unicode-Block, in dem das Emoji liegt, aber noch nicht das Emoji selbst:
name  = null
block = SUPPLEMENTAL_SYMBOLS_AND_PICTOGRAPHS
Java 11 hingegen kennt auch das neue Emoji – was für ein Glück ;-)
name  = GRINNING FACE WITH STAR EYES
block = SUPPLEMENTAL_SYMBOLS_AND_PICTOGRAPHS
Für String.toUpperCase() und toLowerCase() sind die Schriften Osage und Adlam relevant, die mit Unicode 9.0 hinzukamen und Groß- und Kleinbuchstaben haben.
Das folgende Beispiel wandelt den Osage-Großbuchstaben A (U+104B0) mit toLowerCase() um und gibt den Codepoint des Ergebnisses aus:
String osageA = new String(Character.toChars(0x104B0));
System.out.printf("%X%n", osageA.toLowerCase().codePointAt(0));
Java 10 kennt den Buchstaben nicht und lässt ihn unverändert:
104B0Java 11 liefert den Osage-Kleinbuchstaben A (U+104D8):
104D8Improve Aarch64 Intrinsics
Mit dem JDK Enhancement Proposal 315 werden sogenannte „Intrinsics“ für die AArch64-Plattform (also 64-Bit ARM-CPUs) verbessert und neue Intrinsics hinzugefügt.
Intrinsics werden eingesetzt, um anstelle von Java-Code Architektur-spezifischen Assembler-Code auszuführen, was die Performance bestimmter Methoden der JDK-Klassenbibliothek wesentlich verbessert.
Mit diesem JEP werden Intrinsics für trigonometrische Funktionen und die Logarithmus-Funktion hinzugefügt und bestehende Intrinsics für Methoden wie z. B. String.compareTo() und String.indexOf() optimiert.
Transport Layer Security (TLS) 1.3
Vor Java 11 unterstützte das JDK die folgenden Sicherheitsprotokolle:
- Secure Socket Layer (SSL) in der Version 3.0
- Transport Layer Security (TLS) in den Versionen 1.0, 1.1 und 1.2
- Datagram Transport Layer Security (DTLS) in den Versionen 1.0 und 1.2
Mit JEP 332 wurde diese Liste um den modernen Sicherheitsstandard TLS 1.3 erweitert.
TLS 1.0 und 1.1 sind seit Java 16 standardmäßig deaktiviert (JDK-8202343) – per Backport auch in Java 11, seit dem Update 11.0.11.
ChaCha20 and Poly1305 Cryptographic Algorithms
Mit JEP 329 wird das JDK um zwei Kryptografiealgorithmen – ChaCha20 und Poly1305 – erweitert. Diese werden z. B. von den im vorangegangenen Abschnitt genannten Sicherheitsprotokollen eingesetzt.
Key Agreement with Curve25519 and Curve448
Mit JEP 324 werden die Schlüsselaustauschprotokolle des JDK um die sogenannten elliptischen Kurven „Curve25519“ und „Curve448“ erweitert. Der Schlüsselaustausch nach RFC 7748 ist effizienter und sicherer als das zuvor verfügbare ECDH-Verfahren (Elliptic Curve Diffie-Hellman).
Dynamic Class-File Constants
Das .class-Dateiformat wird um die Konstante CONSTANT_Dynamic erweitert, „die Sprachentwicklern und Compiler-Implementierern breitere Optionen für Ausdrucksfähigkeit und Leistung bietet.“ Solltest du eine Sprache oder einen Compiler entwickeln wollen, findest du weitere Details im JDK Enhancement Proposal 309.
Vollständige Liste aller Änderungen in Java 11
Dieser Artikel hat alle Features von Java 11 vorgestellt, die in JDK Enhancement Proposals definiert sind, sowie die wichtigsten Erweiterungen an der JDK-Klassenbibliothek, die keinem JEP zugeordnet sind.
Eine vollständige Liste aller Änderungen findest du in den offiziellen Java 11 Release Notes.
Fazit
Mit Java 11 können wir „var“ nun auch in Lambda-Parametern verwenden.
Auf HTTP-Schnittstellen können wir komfortabel mit dem HttpClient zugreifen.
String wurde um einige hilfreiche Methoden erweitert. Mit Files.readString() und writeString() können wir endlich ohne Drittbibliothek mit nur einer Zeile Code Textdateien lesen und schreiben, und mit Path.of() können wir Path-Objekte prägnanter erstellen als mit Paths.get().
Mit dem Epsilon Garbage Collector können wir Microbenchmarks ohne störende GC-Zyklen durchführen.
Kleine Programme, die aus nur einer Klasse bestehen, können wir mit einem Aufruf von java compilieren und ausführen – oder sie mit einem „Shebang“, wie wir es beispielsweise von Perl kennen, direkt ausführbar machen.
Dank Nest-Based Access Control muss der Compiler keine synthetischen Zugriffsmethoden mehr einfügen.
Und mit dem Flight Recorder wurde ein sehr nützliches Analyse-Tool, das vorher nur mit Supportvertrag von Oracle genutzt werden durfte, für alle frei verfügbar gemacht. Ich kann nur empfehlen, es einmal auszuprobieren!
War dieser Artikel hilfreich für dich? Dann freue ich mich, wenn du dir kurz Zeit für eine Bewertung auf meinem ProvenExpert-Profil nimmst.