reduce() ist eine terminale Operation der Java-Stream-API, die alle Elemente eines Streams zu einem einzigen Wert zusammenfasst – zu einer Summe, einem Produkt, einem Minimum oder einem beliebigen anderen Ergebnis. Dazu verbindet sie mit einer Funktion, die du übergibst, immer zwei Werte zu einem – solange, bis nur noch einer übrig ist.
So addiert reduce() die Zahlen von 1 bis 5:
int sum = IntStream.rangeClosed(1, 5)
.reduce(0, (a, b) -> a + b);15reduce() gibt es seit Java 8, und zwar in drei Varianten. Welche du wann brauchst, warum das erste Argument kein beliebiger Startwert sein darf und wann collect() das bessere Werkzeug ist, zeige ich dir in diesem Artikel.
In diesem Artikel erfährst du,
- wie
reduce()Schritt für Schritt arbeitet, - welche drei Varianten von
reduce()es gibt und was sie für einen leeren Stream liefern, - wofür du
reduce()einsetzt – und für welche Aufgaben es fertige Operationen gibt, - welche drei Regeln
reduce()in einem parallelen Stream verlangt, - wann
collect()das bessere Werkzeug ist, - wie sich
reduce()vom Gathererfold()unterscheidet, - welche Fehler du vermeiden solltest.
Die Beispiele in diesem Artikel
Die Beispiele verwenden das Datenmodell des Artikels über Java Streams – ein Enum Genre, einen Record Book und eine kleine Bibliothek mit elf Klassikern:
public enum Genre {
  NOVEL,
  GOTHIC,
  ADVENTURE,
  FANTASY,
  SCIENCE_FICTION
}

public record Book(String title, String author, int year, Genre genre) {}
public class Library {
public static final List<Book> BOOKS = List.of(
new Book("Pride and Prejudice", "Jane Austen", 1813, NOVEL),
new Book("Frankenstein", "Mary Shelley", 1818, GOTHIC),
new Book("Moby-Dick", "Herman Melville", 1851, ADVENTURE),
new Book("From the Earth to the Moon", "Jules Verne", 1865, SCIENCE_FICTION),
new Book("Alice's Adventures in Wonderland", "Lewis Carroll", 1865, FANTASY),
new Book("Around the World in Eighty Days", "Jules Verne", 1873, ADVENTURE),
new Book("Treasure Island", "Robert Louis Stevenson", 1883, ADVENTURE),
new Book("Kidnapped", "Robert Louis Stevenson", 1886, ADVENTURE),
new Book("The Time Machine", "H. G. Wells", 1895, SCIENCE_FICTION),
new Book("Dracula", "Bram Stoker", 1897, GOTHIC),
new Book("The War of the Worlds", "H. G. Wells", 1898, SCIENCE_FICTION));
}Den vollständigen Code aller Beispiele findest du im GitHub-Repository java-streams-examples, im Package eu.happycoders.reduce.
Wie funktioniert reduce()?
reduce() bekommt in der einfachsten Form zwei Argumente: einen Wert, mit dem die Berechnung beginnt, und eine Funktion, die zwei Werte zu einem verbindet. Im Beispiel aus der Einleitung sind das die 0 und die Funktion (a, b) -> a + b.
reduce() ruft die Funktion zuerst mit der 0 und dem ersten Element auf, dann mit diesem Zwischenergebnis und dem zweiten Element und so weiter bis zum letzten Element. Das Ergebnis des letzten Aufrufs ist das Ergebnis von reduce(). Für die Zahlen von 1 bis 5 entspricht das der folgenden Schleife:
int result = 0;
for (int element = 1; element <= 5; element++) {
  result = result + element;
}
Im Stream kannst du die einzelnen Aufrufe der reduce()-Funktion sehen, wenn du die Funktion jeden Aufruf ausgeben lässt:
int sum = IntStream.rangeClosed(1, 5)
    .reduce(0, (a, b) -> {
      System.out.println(a + " + " + b + " = " + (a + b));
      return a + b;
    });
0 + 1 = 1
1 + 2 = 3
3 + 3 = 6
6 + 4 = 10
10 + 5 = 15Der erste Parameter a ist bei jedem Aufruf das bisherige Zwischenergebnis, der zweite Parameter b das nächste Element.
Die Ausgabe in der Funktion dient nur der Anschauung. In einem parallelen Stream kämen die Zeilen in anderer Reihenfolge, wie der Abschnitt über parallele Streams zeigt.
Die beiden Argumente von reduce() haben Namen, die dir im Javadoc und im Rest dieses Artikels wieder begegnen:
- Das erste Argument,
identity, ist der Identitätswert – hier die0. Ein Identitätswert ist ein Wert, der das Ergebnis der Funktion nicht verändert:0 + xergibt für jedesxwiederx. Für eine Multiplikation ist es die1, für das Verbinden von Strings der leere String. Warumreduce()einen solchen Wert verlangt und nicht einen beliebigen Startwert, zeigt der Abschnitt über parallele Streams. - Das zweite Argument,
accumulator, ist der Akkumulator – die Funktion, die ein Zwischenergebnis und das nächste Element zum neuen Zwischenergebnis verbindet, hier(a, b) -> a + b.
Die folgende Grafik zeigt den Ablauf: oben die Elemente, unten die Zwischenergebnisse, beginnend mit dem Identitätswert. Jedes weitere Zwischenergebnis entsteht aus dem vorigen und dem Element darüber.
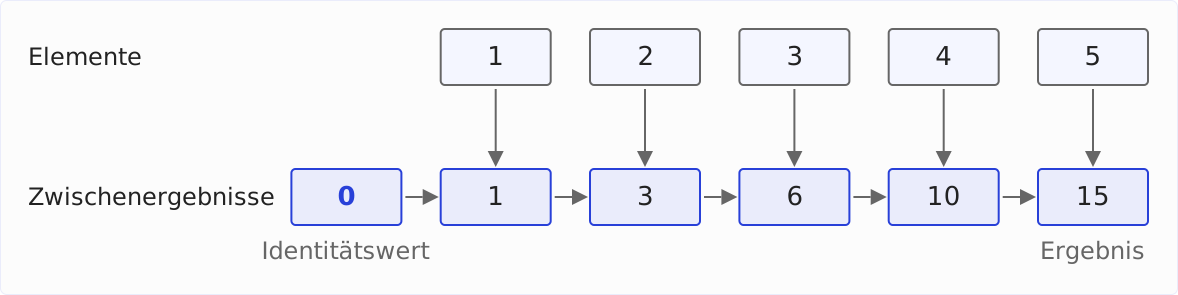
Das Javadoc nennt dieses Zusammenfassen aller Elemente zu einem Wert Reduktion (englisch „reduction“), auch Fold genannt.
Die drei Varianten von reduce()
Das Interface Stream deklariert reduce() in drei Varianten:
T reduce(T identity, BinaryOperator<T> accumulator)

Optional<T> reduce(BinaryOperator<T> accumulator)

<U> U reduce(
    U identity, BiFunction<U, ? super T, U> accumulator, BinaryOperator<U> combiner)
Die folgenden Abschnitte zeigen jede Variante mit einem Beispiel und mit dem, was sie für einen leeren Stream liefert.
reduce(identity, accumulator) – mit Identitätswert
Die erste Variante kennst du aus dem vorigen Abschnitt. Ihr Akkumulator ist ein BinaryOperator<T>: Er verbindet zwei Werte vom Typ der Elemente zu einem dritten desselben Typs. Das Ergebnis hat deshalb ebenfalls den Typ der Elemente.
Das folgende Beispiel bildet jedes Buch auf die Länge seines Titels ab und addiert die Längen:
int totalLength = BOOKS.stream()
    .map(book -> book.title().length())
.reduce(0, Integer::sum);197Integer::sum ist eine Methodenreferenz auf die statische Methode Integer.sum(int a, int b), die dasselbe tut wie (a, b) -> a + b.
Für einen leeren Stream liefert diese Variante den Identitätswert.
Kein Buch der Bibliothek ist vor 1800 erschienen, deshalb liefert das folgende Beispiel die 0:
int noLength = BOOKS.stream()
    .filter(book -> book.year() < 1800)
    .map(book -> book.title().length())
.reduce(0, Integer::sum);0reduce(accumulator) – ohne Identitätswert
Nicht für jede Verknüpfung gibt es einen sinnvollen Identitätswert. Deshalb gibt es reduce() auch ohne Identitätswert.
Das folgende Beispiel sucht das Buch mit dem längsten Titel. Der Akkumulator vergleicht zwei Bücher und gibt das mit dem längeren Titel zurück, bei gleicher Länge das erste:
Optional<Book> longest = BOOKS.stream()
    .reduce((a, b) -> a.title().length() >= b.title().length() ? a : b);
System.out.println(longest.map(Book::title));
Optional[Alice's Adventures in Wonderland]Einen sinnvollen Identitätswert gibt es hier nicht. Du müsstest einen erfinden: z. B. ein Buch mit leerem Titel, das gegen jedes andere verliert – und das für einen leeren Stream am Ende im Ergebnis stünde.
Ohne Identitätswert beginnt reduce() mit dem ersten Element als Zwischenergebnis und verbindet es mit dem zweiten. Für einen leeren Stream gibt es kein erstes Element, deshalb liefert diese Variante ein Optional – und das ist leer, wenn der Stream leer ist.
Mit dem Filter aus dem vorigen Abschnitt bleibt kein Buch übrig, und reduce() liefert ein leeres Optional:
Optional<Book> none = BOOKS.stream()
    .filter(book -> book.year() < 1800)
    .reduce((a, b) -> a.title().length() >= b.title().length() ? a : b);
System.out.println(none.map(Book::title));Optional.emptyreduce(identity, accumulator, combiner) – mit anderem Ergebnistyp
Bei den ersten beiden Varianten haben die Elemente und das Ergebnis denselben Typ. Deshalb musste das Beispiel mit den Titellängen die Bücher zuerst mit map() in Zahlen umwandeln.
Die dritte Variante erlaubt ein Ergebnis vom Typ U, der sich vom Typ T der Elemente unterscheidet. Ihr Akkumulator ist deshalb kein BinaryOperator<T>, sondern eine BiFunction<U, ? super T, U>: Er verbindet ein Zwischenergebnis vom Typ U mit einem Element vom Typ T.
Das folgende Beispiel addiert die Titellängen direkt aus den Büchern, ohne map():
int totalLength = BOOKS.stream()
.reduce(0, (sum, book) -> sum + book.title().length(), Integer::sum);197Das dritte Argument ist der Combiner – hier Integer::sum. Er verbindet zwei Zwischenergebnisse vom Typ U miteinander. Der Akkumulator kann das nicht, denn er erwartet als zweites Argument ein Buch und keine Zahl.
In einem sequenziellen Stream ruft reduce() den Combiner nie auf. Gebraucht wird er erst in einem parallelen Stream, der mehrere Zwischenergebnisse erzeugt – was dort passiert, zeigt der Abschnitt über parallele Streams.
Das Javadoc des Packages java.util.stream empfiehlt statt dieser Variante in der Regel die Kombination aus map() und reduce() mit zwei Argumenten, weil sie lesbarer ist. Die Variante mit drei Argumenten ist laut Javadoc für Fälle gedacht, in denen es spürbar Arbeit spart, das Abbilden und das Verbinden in einer Funktion zusammenzulegen.
Ich empfehle dir deshalb map() und reduce() – und für ein Ergebnis, das ein Container wie eine Liste oder ein StringBuilder ist, collect(), wie der Abschnitt reduce() vs. collect() zeigt.
reduce() auf IntStream, LongStream und DoubleStream
Die primitiven Streams haben nur die ersten beiden Varianten, mit primitiven Typen: Auf einem IntStream sind das int reduce(int identity, IntBinaryOperator op) und OptionalInt reduce(IntBinaryOperator op). Eine Variante mit Combiner gibt es dort nicht.
Das folgende Beispiel addiert die Titellängen ohne den Umweg über Integer-Objekte und sucht die größte Titellänge:
int totalLength = BOOKS.stream()
    .mapToInt(book -> book.title().length())
    .reduce(0, Integer::sum);

OptionalInt maxLength = BOOKS.stream()
    .mapToInt(book -> book.title().length())
    .reduce(Math::max);
197
OptionalInt[32]Beide Aufrufe haben fertige Gegenstücke, sum() und max() – und die bestehen intern aus genau diesen Aufrufen: IntStream.sum() ist im JDK als reduce(0, Integer::sum) implementiert, IntStream.max() als reduce(Math::max).
Die folgende Tabelle fasst die Varianten zusammen. LongStream und DoubleStream entsprechen dem IntStream, mit long bzw. double und OptionalLong bzw. OptionalDouble:
| Variante | Rückgabetyp | für einen leeren Stream |
|---|---|---|
reduce(identity, accumulator) | T | identity |
reduce(accumulator) | Optional<T> | Optional.empty() |
reduce(identity, accumulator, combiner) | U | identity |
IntStream.reduce(identity, op) | int | identity |
IntStream.reduce(op) | OptionalInt | OptionalInt.empty() |
Anwendungsbeispiele
Summe und Produkt
Für Summen haben die primitiven Streams sum(). Für ein Produkt gibt es dagegen keine fertige Operation – hier ist reduce() das Werkzeug, mit der 1 als Identitätswert.
Das folgende Beispiel berechnet die Fakultät 5! = 1 · 2 · 3 · 4 · 5:
int factorial = IntStream.rangeClosed(1, 5)
.reduce(1, (a, b) -> a * b);120Bei größeren Zahlen läuft ein Produkt schnell über den Wertebereich von int hinaus. Wie du das bemerkst, zeigt der Abschnitt über den Überlauf.
Minimum und Maximum
Die statischen Methoden BinaryOperator.minBy() und maxBy() liefern einen Akkumulator, der von zwei Elementen das kleinere bzw. größere nach einem Comparator zurückgibt – bei Gleichstand das erste.
Das folgende Beispiel sucht das älteste Buch:
Optional<Book> oldest = BOOKS.stream()
    .reduce(BinaryOperator.minBy(Comparator.comparingInt(Book::year)));
System.out.println(oldest.map(Book::title).orElse("-"));
Pride and PrejudiceDasselbe liefert min(), denn Stream.min() ist im JDK als reduce(BinaryOperator.minBy(comparator)) implementiert, max() entsprechend mit maxBy().
Ich empfehle dir min() und max(), denn sie sagen mit ihrem Namen, was sie tun:
Optional<Book> oldest = BOOKS.stream()
    .min(Comparator.comparingInt(Book::year));
BigDecimal und eigene Klassen summieren
Geldbeträge rechnest du in Java mit BigDecimal, denn double kann Dezimalbrüche wie 0,1 nicht exakt darstellen. Für BigDecimal gibt es keinen primitiven Stream und damit kein sum() – hier ist reduce() der direkte Weg.
Das folgende Beispiel summiert die drei Beträge einer Bestellung. BigDecimal.ZERO ist der Identitätswert und BigDecimal::add der Akkumulator:
List<BigDecimal> prices = List.of(
    new BigDecimal("12.99"), new BigDecimal("8.50"), new BigDecimal("14.95"));

BigDecimal total = prices.stream()
.reduce(BigDecimal.ZERO, BigDecimal::add);36.44Das geht genauso mit selbst geschriebenen Klassen. Der folgende Record Money speichert einen Betrag als long in Cent; ZERO ist der Identitätswert für seine Methode add(), und add() liefert ein neues Money-Objekt, statt das vorhandene zu verändern:
public record Money(long cents) {

  public static final Money ZERO = new Money(0);

  public Money add(Money other) {
    return new Money(cents + other.cents);
  }
}
Mit Money.ZERO als Identitätswert und Money::add als Akkumulator summiert reduce() dieselbe Bestellung, diesmal als Money-Objekte:
List<Money> prices = List.of(new Money(1299), new Money(850), new Money(1495));

Money total = prices.stream()
.reduce(Money.ZERO, Money::add);Money[cents=3644]Dass add() ein neues Objekt liefert, ist kein Detail: Warum ein Akkumulator, der sein erstes Argument verändert, in einem parallelen Stream falsche Ergebnisse liefert, zeigt der Abschnitt Eine Liste mit reduce() aufbauen. Eine Money-Klasse für echte Anwendungen hätte zusätzlich eine Währung und würde beim Addieren prüfen, dass beide Beträge dieselbe haben – an reduce() ändert das nichts.
Bedingungen und Funktionen verketten
Dieser Abschnitt zeigt eine exotische Form, Bedingungen und Funktionen zu verketten – im Alltag wirst du sie selten sehen. Sie macht aber sichtbar, dass reduce() nicht nur mit Zahlen funktioniert, sondern mit jedem Typ, dessen Werte sich paarweise verbinden lassen – auch mit funktionalen Interfaces – und was ein Identitätswert jenseits von Zahlen ist.
Das folgende Beispiel verknüpft eine Liste von Bedingungen mit Predicate::and zu einer einzigen Bedingung, die erfüllt ist, wenn alle erfüllt sind:
List<Predicate<Book>> conditions = List.of(
    book -> book.genre() == ADVENTURE,
    book -> book.year() > 1860,
    book -> book.author().startsWith("Robert"));

Predicate<Book> all = conditions.stream()
    .reduce(book -> true, Predicate::and);

List<String> titles = BOOKS.stream()
    .filter(all)
    .map(Book::title)
    .toList();
[Treasure Island, Kidnapped]Der Identitätswert ist hier das Predicate book -> true: Mit and() verknüpft, ändert es keine Bedingung. Für Predicate::or wäre es book -> false.
Der Identitätswert bestimmt auch, was eine leere Liste von Bedingungen ergibt. book -> true lässt dann alle elf Bücher durch – und das ist für „alle Bedingungen erfüllt“ die richtige Antwort, denn es gibt keine Bedingung, die ein Buch verletzen könnte.
Auf dieselbe Weise verkettest du eine Liste von Funktionen mit Function::andThen, mit Function.identity() als Identitätswert:
List<Function<String, String>> steps = List.of(
    String::strip,
    String::toUpperCase,
    title -> title.replace(' ', '_'));

Function<String, String> pipeline = steps.stream()
    .reduce(Function.identity(), Function::andThen);

System.out.println(pipeline.apply(" The Time Machine "));THE_TIME_MACHINEIch empfehle dir diese Form trotzdem nicht, denn sie ist schwer zu lesen: Bei reduce(book -> true, Predicate::and) musst du erst überlegen, was herauskommt.
Kennst du die Bedingungen schon beim Schreiben, verknüpfst du sie direkt mit and():
Predicate<Book> isAdventure = book -> book.genre() == ADVENTURE;
Predicate<Book> after1860 = book -> book.year() > 1860;
Predicate<Book> byRobert = book -> book.author().startsWith("Robert");

List<String> titles = BOOKS.stream()
    .filter(isAdventure.and(after1860).and(byRobert))
    .map(Book::title)
    .toList();
[Treasure Island, Kidnapped]Die Funktionen verkettest du entsprechend mit andThen():
Function<String, String> strip = String::strip;

Function<String, String> pipeline = strip
    .andThen(String::toUpperCase)
    .andThen(title -> title.replace(' ', '_'));

System.out.println(pipeline.apply(" The Time Machine "));THE_TIME_MACHINEKommen die Bedingungen als Liste, sagt allMatch() lesbarer, was gemeint ist – dass jede Bedingung erfüllt sein muss:
List<String> titles = BOOKS.stream()
    .filter(book -> conditions.stream().allMatch(condition -> condition.test(book)))
    .map(Book::title)
    .toList();
[Treasure Island, Kidnapped]Wofür es fertige Operationen gibt
Für die häufigsten Reduktionen hat die Stream-API eigene Methoden. Sie sind kürzer und sagen mit ihrem Namen, was sie tun. Die folgende Tabelle stellt sie der Lösung mit reduce() gegenüber:
| Aufgabe | mit reduce() | besser |
|---|---|---|
| Summe | map(…).reduce(0, Integer::sum) | mapToInt(…).sum() |
| Anzahl | map(e -> 1).reduce(0, Integer::sum) | count() |
| Minimum, Maximum | reduce(BinaryOperator.minBy(c)) | min(c), max(c) |
| Strings verbinden | reduce("", String::concat) | collect(joining()) |
Für den Durchschnitt brauchst du Summe und Anzahl zugleich; das liefern average() und summaryStatistics() der primitiven Streams. Warum joining() beim Verbinden von Strings mehr ist als eine Frage des Stils, zeigt der Abschnitt Strings mit reduce() verbinden.
Bei double rechnet sum() zudem genauer als reduce(). DoubleStream.sum() addiert mit einer kompensierten Summation: Sie hält den Rundungsfehler jeder Addition fest und rechnet ihn in die nächste Addition ein. reduce(0, Double::sum) addiert dagegen einfach nacheinander.
Das folgende Beispiel addiert 0,1, 0,2 und 0,3 auf beide Arten:
double reduced = DoubleStream.of(0.1, 0.2, 0.3)
    .reduce(0, Double::sum);

double summed = DoubleStream.of(0.1, 0.2, 0.3)
    .sum();
0.6000000000000001
0.6reduce() in parallelen Streams
Ein paralleler Stream teilt seine Elemente in Teilstücke auf und verarbeitet sie auf mehreren Threads. reduce() reduziert dabei jedes Teilstück für sich und verbindet die Teilergebnisse danach mit dem Combiner.
Das folgende Beispiel addiert die Zahlen von 1 bis 5 in einem parallelen Stream und gibt jeden Aufruf von Akkumulator und Combiner aus. boxed() macht aus dem IntStream einen Stream<Integer>, denn nur dort gibt es die Variante mit Combiner:
int sum = IntStream.rangeClosed(1, 5)
    .boxed()
    .parallel()
    .reduce(
        0,
        (a, b) -> {
          System.out.println("accumulate " + a + " + " + b + " = " + (a + b));
          return a + b;
        },
        (a, b) -> {
          System.out.println("combine    " + a + " + " + b + " = " + (a + b));
          return a + b;
        });
accumulate 0 + 5 = 5
accumulate 0 + 4 = 4
accumulate 0 + 3 = 3
combine 4 + 5 = 9
accumulate 0 + 1 = 1
combine 3 + 9 = 12
accumulate 0 + 2 = 2
combine 1 + 2 = 3
combine 3 + 12 = 15Die Reihenfolge der Zeilen ändert sich von Lauf zu Lauf, denn die Threads arbeiten gleichzeitig. Gleich bleibt, welche Werte verbunden werden: Der Stream hat jedes der fünf Elemente zu einem eigenen Teilstück gemacht, und jedes Teilstück beginnt mit dem Identitätswert 0. Der Combiner verbindet die Teilergebnisse dann paarweise, bis eines übrig ist.
Die folgende Grafik zeigt dieselben Aufrufe als Baum: oben die fünf Aufrufe des Akkumulators, darunter die vier Aufrufe des Combiners.

Damit ein paralleler Stream dasselbe Ergebnis liefert wie ein sequenzieller, müssen Identitätswert, Akkumulator und Combiner drei Regeln erfüllen. Geprüft wird keine davon – ein Verstoß fällt erst auf, wenn derselbe Code parallel läuft.
Regel 1: Der Identitätswert darf das Ergebnis nicht verändern
Der Identitätswert ist kein Startwert, der einmal ins Ergebnis eingeht, denn jedes Teilstück beginnt mit ihm. Wer mit reduce(10, Integer::sum) zur Summe der Zahlen von 1 bis 5 noch 10 addieren will, bekommt sequenziell das erwartete Ergebnis – und parallel ein anderes:
int sequential = IntStream.rangeClosed(1, 5)
    .reduce(10, Integer::sum);

int parallel = IntStream.rangeClosed(1, 5)
    .parallel()
    .reduce(10, Integer::sum);
25
65Im parallelen Stream beginnt jedes der fünf Teilstücke mit der 10 – so gehen 5 · 10 = 50 statt 10 in die Summe ein, und aus 25 werden 65.
Der Identitätswert muss deshalb ein Wert sein, der das Ergebnis nicht verändert, wie oft er auch eingeht: 0 für eine Summe, 1 für ein Produkt, der leere String für das Verbinden von Strings. Das Javadoc formuliert es so: accumulator.apply(identity, t) muss für jedes t gleich t sein.
Einen echten Startwert addierst du außerhalb von reduce():
int sum = 10 + IntStream.rangeClosed(1, 5)
    .parallel()
.reduce(0, Integer::sum);25Regel 2: Der Akkumulator muss assoziativ sein
Ein Akkumulator ist assoziativ, wenn es gleichgültig ist, wie du Klammern setzt: (a op b) op c muss dasselbe ergeben wie a op (b op c). Für die Addition und Multiplikation ganzer Zahlen, für Minimum, Maximum und das Verbinden von Strings gilt das. Der parallele Stream nutzt diese Freiheit – im Baum oben hat er 4 und 5 verbunden, bevor die 3 an der Reihe war.
Das folgende Beispiel versucht, die Ziffern 1 bis 5 zur Zahl 12345 zusammenzusetzen. Der Akkumulator schiebt dazu das Zwischenergebnis um eine Dezimalstelle nach links und hängt die nächste Ziffer an:
int sequential = IntStream.rangeClosed(1, 5)
    .reduce(0, (a, b) -> 10 * a + b);

int parallel = IntStream.rangeClosed(1, 5)
    .parallel()
    .reduce(0, (a, b) -> 10 * a + b);
12345
195Der Identitätswert 0 erfüllt Regel 1: 10 * 0 + b ergibt b. Der Akkumulator ist aber nicht assoziativ. Der parallele Stream verbindet zuerst 4 und 5 zu 45 und dann die 3 mit der 45 – zu 10 · 3 + 45 = 75 statt zu 345. Der Akkumulator hängt eine einzelne Ziffer an; ein mehrstelliges Teilergebnis als zweites Argument sieht er nicht vor.
Eine Reduktion, deren Akkumulator nicht assoziativ ist, kannst du nicht mit reduce() parallelisieren. Für sie gibt es den Gatherer fold(), den der Abschnitt reduce() vs. Gatherers.fold() zeigt.
Regel 3: Der Combiner muss zum Akkumulator passen
Der Combiner verbindet Teilergebnisse, die der Akkumulator erzeugt hat. Er muss dabei zum selben Ergebnis kommen, als hätte der Akkumulator die Elemente nacheinander verarbeitet. Das Javadoc formuliert es so: combiner.apply(u, accumulator.apply(identity, t)) muss gleich accumulator.apply(u, t) sein.
Die Summe der Quadrate zeigt, was passiert, wenn das nicht gilt. Der Akkumulator (sum, x) -> sum + x * x behandelt seine beiden Argumente verschieden: Das erste ist eine Summe, das zweite ein Element, das er quadriert. Als Combiner taugt er deshalb nicht, denn zwei Teilsummen müssen addiert werden, ohne dass eine davon quadriert wird.
In der Variante mit zwei Argumenten gibt es aber keinen eigenen Combiner – reduce() verwendet den Akkumulator auch als Combiner. Sequenziell stimmt das Ergebnis, parallel nicht:
List<Integer> numbers = List.of(1, 2, 3, 4, 5);

int sequential = numbers.stream()
    .reduce(0, (sum, x) -> sum + x * x);

int parallel = numbers.parallelStream()
    .reduce(0, (sum, x) -> sum + x * x);
55
1326867573Für die Teilstücke 4 und 5 rechnet der Akkumulator als Combiner 16 + 25 · 25 = 641 statt 16 + 25 = 41. Eine Ebene darunter quadriert er die 641 erneut, und am Ende läuft das Quadrat des Teilergebnisses 410.890 über den Wertebereich von int hinaus.
Die Variante mit drei Argumenten trennt die beiden Rollen: Der Akkumulator quadriert und addiert, der Combiner Integer::sum addiert nur. Noch lesbarer ist es, das Quadrieren mit map() vor reduce() zu ziehen – dann ist der Akkumulator wieder ein gewöhnlicher, assoziativer BinaryOperator:
int withCombiner = numbers.parallelStream()
    .reduce(0, (sum, x) -> sum + x * x, Integer::sum);

int withMap = numbers.parallelStream()
    .map(x -> x * x)
    .reduce(0, Integer::sum);
55
55Ob sich ein paralleler Stream überhaupt lohnt, ist eine andere Frage – sie wird Thema eines eigenen Artikels sein.
reduce() vs. collect()
reduce() ist eine unveränderliche Reduktion: Jeder Aufruf des Akkumulators erzeugt einen neuen Wert und lässt die alten unverändert – Integer.sum() eine neue Zahl, BigDecimal.add() ein neues BigDecimal.
collect() ist dagegen eine veränderliche Reduktion (englisch „mutable reduction“): Es sammelt die Elemente in einem Container wie einer ArrayList, einer HashMap oder einem StringBuilder, den es dabei verändert.
Wer beides verwechselt, schreibt Code, der sequenziell funktioniert und parallel falsche Ergebnisse liefert – oder Code, dessen Aufwand quadratisch wächst. Die folgenden zwei Abschnitte zeigen je ein Beispiel.
Eine Liste mit reduce() aufbauen
Das folgende Beispiel sammelt Buchtitel mit der reduce()-Variante mit drei Argumenten in einer ArrayList. Der Identitätswert ist eine leere Liste, der Akkumulator fügt einen Titel hinzu, und der Combiner hängt eine Liste an die andere an:
List<String> titles = BOOKS.stream()
    .reduce(
        new ArrayList<>(),
        (list, book) -> {
          list.add(book.title());
          return list;
        },
        (a, b) -> {
          a.addAll(b);
          return a;
        });
Sequenziell liefert das die elf Titel. Mit BOOKS.parallelStream() statt BOOKS.stream() liefert dasselbe reduce() in fünf Läufen fünf verschiedene Listen – hier die Zahl ihrer Einträge:
3344 titles
912 titles
4776 titles
1344 titles
992 titles
Die Ursache ist der Identitätswert. reduce() erzeugt ihn nicht für jedes Teilstück neu, sondern gibt jedem Teilstück dasselbe Objekt – die eine ArrayList, die du übergeben hast. Alle Threads fügen gleichzeitig in diese eine Liste ein, die dafür nicht threadsicher ist. Der Combiner hängt die Liste zudem an sich selbst an, denn a und b sind dasselbe Objekt; so verdoppelt jeder Aufruf des Combiners die Liste.
Für veränderliche Container ist collect() gemacht. Seine Variante mit drei Argumenten entspricht dem reduce()-Versuch Argument für Argument – mit einem Unterschied: Statt eines Identitätswerts bekommt es einen Supplier, den es für jedes Teilstück aufruft. So hat jedes Teilstück seine eigene Liste:
ArrayList<String> titles = BOOKS.parallelStream()
    .collect(
        () -> new ArrayList<>(),
        (list, book) -> {
          list.add(book.title());
        },
        (a, b) -> {
          a.addAll(b);
        });
Das liefert die elf Titel, sequenziell wie parallel. Akkumulator und Combiner sind dabei BiConsumer: Sie haben keinen Rückgabewert, denn sie verändern die Liste, statt einen neuen Wert zu erzeugen. Deshalb fehlen die return-Anweisungen aus dem reduce()-Versuch.
Den Supplier und den Combiner kannst du durch die Methodenreferenzen ArrayList::new und ArrayList::addAll ersetzen. Der Akkumulator bleibt ein Lambda, denn er muss den Titel erst aus dem Buch holen; er passt aber in eine Zeile ohne geschweifte Klammern:
ArrayList<String> titles = BOOKS.parallelStream()
    .collect(
        ArrayList::new,
        (list, book) -> list.add(book.title()),
        ArrayList::addAll);
Ziehst du die Titel vorher mit map() heraus, wird auch der Akkumulator zur Methodenreferenz ArrayList::add:
ArrayList<String> titles = BOOKS.parallelStream()
    .map(Book::title)
    .collect(ArrayList::new, ArrayList::add, ArrayList::addAll);
Für eine Liste genügt allerdings toList(); die Variante mit drei Argumenten brauchst du nur für einen Container, für den es keinen fertigen Collector gibt.
Strings mit reduce() verbinden
Strings sind unveränderlich, deshalb liefert reduce() hier ein richtiges Ergebnis, auch parallel. Das Problem ist der Aufwand.
Das folgende Beispiel verbindet die elf Titel:
String concatenated = BOOKS.stream()
    .map(Book::title)
    .reduce("", String::concat);
Jeder Aufruf von concat() erzeugt einen neuen String und kopiert dafür alle bisherigen Zeichen und die des nächsten Titels. Die elf Titel haben zusammen 197 Zeichen, kopiert werden dabei 1.222 Zeichen. Bei 11.000 Titeln – der Bibliothek tausendmal hintereinander – sind es 197.000 Zeichen und 1.083.638.500 kopierte. Der Aufwand wächst quadratisch mit der Zahl der Zeichen, wovor das Javadoc des Packages java.util.stream am selben Beispiel warnt.
Collectors.joining() sammelt die Titel stattdessen in einem veränderlichen Container – ohne Trennzeichen in einem StringBuilder, mit Trennzeichen in einem StringJoiner –, und sein Aufwand wächst linear mit der Zahl der Zeichen.
Das folgende Beispiel verbindet die Titel mit Komma und Leerzeichen als Trennzeichen:
String joined = BOOKS.stream()
    .map(Book::title)
    .collect(joining(", "));
Pride and Prejudice, Frankenstein, Moby-Dick, From the Earth to the Moon, Alice's Adventures in Wonderland, Around the World in Eighty Days, Treasure Island, Kidnapped, The Time Machine, Dracula, The War of the WorldsWann reduce(), wann collect()?
Die folgende Tabelle fasst die Unterschiede zusammen:
reduce() | collect() | |
|---|---|---|
| Ergebnis | ein unveränderlicher Wert: Zahl, String, BigDecimal, Record | ein veränderlicher Container: List, Map, StringBuilder |
| ein Schritt | erzeugt einen neuen Wert | verändert den Container |
| parallel | jedes Teilstück beginnt mit demselben Identitätswert | jedes Teilstück bekommt vom Supplier einen eigenen Container |
Ich empfehle dir reduce() für Ergebnisse, die sich als einzelner Wert ausdrücken lassen, und collect() für alles, was Elemente sammelt.
Collectors.reducing()
Eine Reduktion gibt es auch als Collector: Collectors.reducing(). Für sich allein brauchst du ihn nicht, denn collect(reducing(…)) liefert dasselbe wie reduce(…). Er ist für die Stellen gedacht, an denen ein anderer Collector einen Collector erwartet – vor allem als Downstream-Collector von groupingBy(), der die Elemente jeder Gruppe zusammenfasst.
Das folgende Beispiel sucht das älteste Buch pro Genre:
Map<Genre, Optional<Book>> oldestPerGenre = BOOKS.stream()
    .collect(groupingBy(
        Book::genre,
        TreeMap::new,
        reducing(BinaryOperator.minBy(Comparator.comparingInt(Book::year)))));

oldestPerGenre.forEach((genre, book) ->
    System.out.println(genre + ": " + book.map(Book::title).orElse("-")));
NOVEL: Pride and Prejudice
GOTHIC: Frankenstein
ADVENTURE: Moby-Dick
FANTASY: Alice's Adventures in Wonderland
SCIENCE_FICTION: From the Earth to the Moonreducing() gibt es wie reduce() in drei Varianten. Die ersten beiden, reducing(identity, op) und reducing(op), entsprechen denen von reduce(). Die dritte, reducing(identity, mapper, op), hat statt eines Combiners eine Funktion, die jedes Element vor dem Verbinden abbildet – sie vereint also map() und reduce() in einem Collector.
Für das Minimum gibt es auch hier einen fertigen Collector: Collectors.minBy(), im JDK implementiert als reducing(BinaryOperator.minBy(comparator)). groupingBy() und seine Downstream-Collectors werden Thema eines eigenen Artikels sein.
reduce() vs. Gatherers.fold()
Seit Java 24 gibt es mit dem Gatherer Gatherers.fold() eine zweite Form der Reduktion. Sie unterscheidet sich von reduce() in drei Punkten:
fold()ist eine intermediäre Operation und liefert einen Stream mit genau einem Element; die Pipeline kann danach weitergehen.fold()braucht keinen Combiner, auch wenn das Ergebnis einen anderen Typ hat als die Elemente.fold()verarbeitet die Elemente immer nacheinander, auch in einem parallelen Stream. Der Akkumulator muss deshalb nicht assoziativ sein.
Mit fold() setzt deshalb auch ein paralleler Stream die Ziffern aus Regel 2 richtig zur Zahl zusammen:
int number = IntStream.rangeClosed(1, 5)
    .boxed()
    .parallel()
    .gather(Gatherers.fold(() -> 0, (a, b) -> 10 * a + b))
    .findFirst()
.orElseThrow();12345Dass fold() auch mit einem nicht assoziativen Akkumulator richtig rechnet, hat einen Preis: Den fold()-Schritt verarbeitet auch ein paralleler Stream nicht parallel. Eine Gegenüberstellung von reduce(), fold() und scan() findest du im Artikel über Stream Gatherers.
Häufige Fehler
get() auf einem leeren Optional
reduce() ohne Identitätswert liefert ein Optional, und auf einem leeren Optional wirft get() eine NoSuchElementException:
Book oldest = BOOKS.stream()
    .filter(book -> book.year() < 1800)
    .reduce((a, b) -> a.year() <= b.year() ? a : b)
    .get();
java.util.NoSuchElementException: No value presentKann der Stream leer sein, empfehle ich dir orElse() mit einem Ersatzwert. Ist ein leerer Stream ein Fehler, nimm orElseThrow(): Es wirft dieselbe Exception, sagt aber mit seinem Namen, dass das Absicht ist. Weitere Wege zeigt der Artikel über Java Optional.
Stream<Integer> statt IntStream
reduce(0, Integer::sum) auf einem Stream<Integer> verpackt jedes Zwischenergebnis in ein Integer, denn Integer::sum liefert ein int, der Akkumulator aber muss ein Integer zurückgeben. Das Verpacken übernimmt Integer.valueOf(), und das hält standardmäßig nur für die Werte von −128 bis 127 fertige Objekte vorrätig; für jeden größeren Wert erzeugt es ein neues.
Für die Summe der elf Titellängen sind das sechs neue Integer-Objekte, denn die Zwischensumme überschreitet nach dem sechsten Buch die 127. Bei einer Million Titeln wären es fast eine Million neue Objekte.
mapToInt() und sum() rechnen dagegen durchgehend mit int:
int totalLength = BOOKS.stream()
    .mapToInt(book -> book.title().length())
    .sum();
Überlauf bei Summen und Produkten
int und long laufen bei Summen und Produkten stillschweigend über. Die Fakultät von 13 ist 6.227.020.800 und passt nicht mehr in ein int, dessen größter Wert 2.147.483.647 ist. reduce() liefert trotzdem ein Ergebnis, nur ein falsches:
int factorial = IntStream.rangeClosed(1, 13)
.reduce(1, (a, b) -> a * b);1932053504Mit Math::multiplyExact als Akkumulator bekommst du stattdessen bei einem Überlauf eine Exception; für Summen gibt es entsprechend Math::addExact:
int factorial = IntStream.rangeClosed(1, 13)
    .reduce(1, Math::multiplyExact);
java.lang.ArithmeticException: integer overflowDasselbe gilt für sum(), das intern reduce(0, Integer::sum) aufruft: Es läuft ebenso stillschweigend über. Ein LongStream reicht bis zur Fakultät von 20; für größere Werte brauchst du BigInteger und reduce(BigInteger.ONE, BigInteger::multiply).
Zusammenfassung
reduce() fasst die Elemente eines Streams zu einem Wert zusammen, indem es einen Akkumulator immer wieder auf ein Zwischenergebnis und das nächste Element anwendet. Mit Identitätswert liefert es für einen leeren Stream eben diesen Identitätswert, ohne Identitätswert ein Optional. Die Variante mit Combiner erlaubt ein Ergebnis von anderem Typ als die Elemente.
In einem parallelen Stream beginnt jedes Teilstück mit dem Identitätswert, und der Combiner verbindet die Teilergebnisse. Damit das stimmt, darf der Identitätswert das Ergebnis nicht verändern, muss der Akkumulator assoziativ sein und der Combiner Teilergebnisse so verbinden, wie der Akkumulator Elemente verbindet.
Vier Empfehlungen für den Alltag:
- Nimm die fertigen Operationen, wo es sie gibt:
sum(),count(),min(),max(),average(). - Nimm
reduce()für Reduktionen ohne fertige Operation: ein Produkt, eine Summe vonBigDecimal-Beträgen oder von Objekten einer eigenen Klasse wieMoney. - Schreib
map()undreduce()statt der Variante mit drei Argumenten, wo es geht. - Nimm
collect(), sobald das Ergebnis ein Container ist – eine Liste, eine Map, einStringBuilder.
Wie reduce() in eine Stream-Pipeline passt und welche Operationen es außerdem gibt, zeigt der Artikel über Java Streams.
War dieser Artikel hilfreich für dich? Dann freue ich mich, wenn du dir kurz Zeit für eine Bewertung auf meinem ProvenExpert-Profil nimmst.