Ein Java Stream ist eine Folge von Elementen, die durch eine Pipeline von Operationen läuft, die Elemente u. a. filtert, umwandelt und sortiert – und das Ergebnis z. B. in einer Liste einsammelt. Die Stream-API gehört seit Java 8 (also seit März 2014) zum JDK – und sie ersetzt imperative for- oder for-each-Schleifen, die beschreiben, wie etwas gefiltert, transformiert und wieder eingesammelt werden soll, durch eine deklarative Beschreibung dessen, was passieren soll.
In diesem Artikel erfährst du,
- was ein Java Stream ist und wie eine Stream-Pipeline aufgebaut ist,
- was du über Lambda-Ausdrücke und Methodenreferenzen wissen musst, um Streams zu schreiben,
- wie du Streams aus Collections, Arrays, Zahlenbereichen und Dateien erzeugst,
- wie die intermediären Operationen
filter(),map(),flatMap(),distinct(),sorted()und die übrigen funktionieren, - wie die terminalen Operationen
forEach(),collect(),reduce(),findFirst(),anyMatch()und die übrigen funktionieren, - warum Streams „lazy“ sind und was das für deinen Code bedeutet,
- welche Fehler du bei der Arbeit mit Streams vermeiden solltest.
Die Beispiele in diesem Artikel
Alle Beispiele arbeiten auf dem folgenden Datenmodell – einem Record Book und einer kleinen Bibliothek mit elf Klassikern:
public enum Genre {
  NOVEL,
  GOTHIC,
  ADVENTURE,
  FANTASY,
  SCIENCE_FICTION
}

public record Book(String title, String author, int year, Genre genre) {}
public class Library {
public static final List<Book> BOOKS = List.of(
new Book("Pride and Prejudice", "Jane Austen", 1813, NOVEL),
new Book("Frankenstein", "Mary Shelley", 1818, GOTHIC),
new Book("Moby-Dick", "Herman Melville", 1851, ADVENTURE),
new Book("From the Earth to the Moon", "Jules Verne", 1865, SCIENCE_FICTION),
new Book("Alice's Adventures in Wonderland", "Lewis Carroll", 1865, FANTASY),
new Book("Around the World in Eighty Days", "Jules Verne", 1873, ADVENTURE),
new Book("Treasure Island", "Robert Louis Stevenson", 1883, ADVENTURE),
new Book("Kidnapped", "Robert Louis Stevenson", 1886, ADVENTURE),
new Book("The Time Machine", "H. G. Wells", 1895, SCIENCE_FICTION),
new Book("Dracula", "Bram Stoker", 1897, GOTHIC),
new Book("The War of the Worlds", "H. G. Wells", 1898, SCIENCE_FICTION));
}Den vollständigen Code aller Beispiele findest du im GitHub-Repository java-streams-examples.
Bevor wir in die Theorie einsteigen, hier ein Beispiel, das die imperative Schleife und den deklarativen Stream gegenüberstellt.
So sammelst du die Titel aller Science-Fiction-Bücher alphabetisch sortiert ein – zuerst mit einer Schleife:
static List<String> scienceFictionTitles(List<Book> books) {
  List<String> titles = new ArrayList<>();
  for (Book book : books) {
    if (book.genre() == SCIENCE_FICTION) {
      titles.add(book.title());
    }
  }
  Collections.sort(titles);
  return titles;
}
Und hier mit einem Stream:
static List<String> scienceFictionTitles(List<Book> books) {
  return books.stream()
      .filter(book -> book.genre() == SCIENCE_FICTION)
      .map(Book::title)
      .sorted()
      .toList();
}
Beide Methoden liefern dieselbe Liste:
[From the Earth to the Moon, The Time Machine, The War of the Worlds]Die Schleife sagt, wie du zu diesem Ergebnis kommst: Liste anlegen, iterieren, prüfen, hinzufügen, sortieren, zurückgeben. Der Stream sagt, was du willst: die Titel der Science-Fiction-Bücher, sortiert – vier Operationen, von oben nach unten auf den ersten Blick im Code erkennbar.
Was ist ein Java Stream?
Ein Stream ist keine Datenstruktur. Er speichert keine Elemente; er holt sie aus einer Quelle – z. B. aus einer Liste, einem Array oder einer Datei – und reicht sie durch eine Kette von Operationen. Hat ein Stream sein Ergebnis geliefert, ist er verbraucht. Ein zweites Mal kannst du einen Stream nicht benutzen – dafür brauchst du einen neuen Stream aus derselben Quelle.
Das ist der Unterschied zu einer Collection: Eine List hält ihre Elemente, und du kannst so oft über sie iterieren, wie du willst. Ein Stream beschreibt eine Berechnung über Elemente und führt sie genau einmal aus.
Aufbau einer Stream-Pipeline
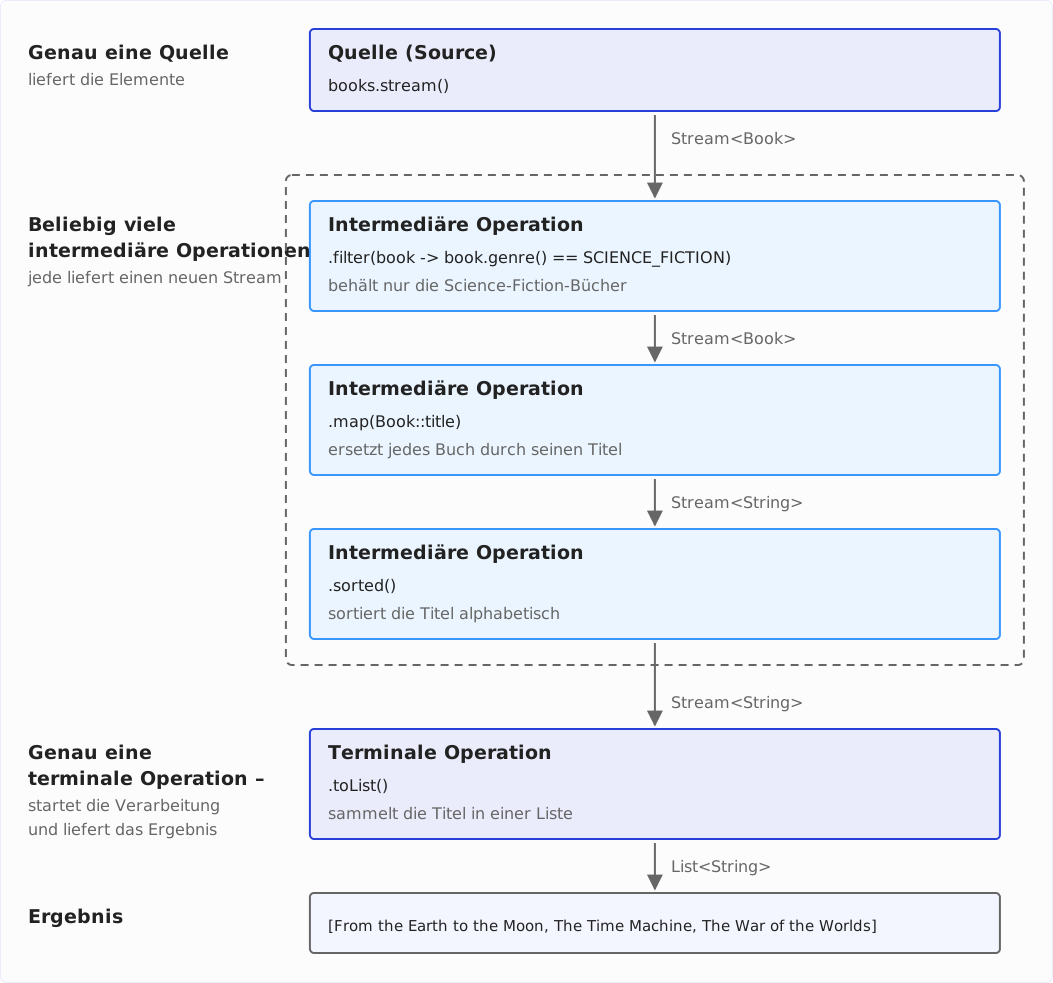
Jede Stream-Pipeline besteht aus drei Teilen:
- Genau eine Quelle (Source), die die Elemente liefert – z. B.
books.stream(). - Beliebig viele intermediäre Operationen, die jeweils einen neuen Stream zurückgeben – z. B.
filter()undmap(). - Genau eine terminale Operation, deren Aufruf die Stream-Verarbeitung startet und die das Ergebnis erzeugt – z. B. mit
count()odertoList().
Das folgende Diagramm zeigt die Pipeline aus dem ersten Beispiel von oben nach unten, mit dem Stream-Typ an jedem Pfeil – bei map() wechselt er von Stream<Book> zu Stream<String>:
Sehen wir uns die drei Teile an einem zweiten Beispiel an.
Die folgende Methode zählt die Bücher, die nach einem bestimmten Jahr erschienen sind:
static long countBooksAfter(List<Book> books, int year) {
  return books.stream()                    // ⟵ Quelle
      .filter(book -> book.year() > year)  // ⟵ Intermediäre Operation
      .count();                            // ⟵ Terminale Operation
}
Für die Beispiel-Bibliothek Library.BOOKS liefert countBooksAfter(BOOKS, 1880) den Wert 5.
Die intermediären Operationen laufen nicht, sobald du sie aufrufst. Sie beschreiben nur, was passieren soll. Erst die terminale Operation count() startet die Verarbeitung – warum das wichtig ist, siehst du im Kapitel über Lazy Evaluation.
Übersicht über alle Stream-Operationen
Die folgende Tabelle listet alle Operationen auf, die dieser Artikel behandelt, mit ihrem Typ (intermediär oder terminal) und der Java-Version, in der sie dazukamen. Jede Zeile verlinkt auf den Abschnitt, der die Operation erklärt. Was „zustandsbehaftet“ und „Short-circuiting“ bedeuten, erkläre ich im Kapitel über Lazy Evaluation – für den Moment reicht: Eine zustandsbehaftete Operation merkt sich etwas über die Elemente, die sie schon gesehen hat, und eine Short-circuiting-Operation kann die Verarbeitung vorzeitig beenden.
| Operation | Typ | Zustandsbehaftet | Short-circuiting | Seit |
|---|---|---|---|---|
filter() | intermediär | nein | nein | Java 8 |
map() | intermediär | nein | nein | Java 8 |
flatMap() | intermediär | nein | nein | Java 8 |
mapMulti() | intermediär | nein | nein | Java 16 |
mapToInt(), mapToObj(), boxed() | intermediär | nein | nein | Java 8 |
distinct() | intermediär | ja | nein | Java 8 |
sorted() | intermediär | ja | nein | Java 8 |
limit() | intermediär | ja | ja | Java 8 |
skip() | intermediär | ja | nein | Java 8 |
takeWhile() | intermediär | ja | ja | Java 9 |
dropWhile() | intermediär | ja | nein | Java 9 |
peek() | intermediär | nein | nein | Java 8 |
gather() | intermediär | je nach Gatherer | je nach Gatherer | Java 24 |
forEach(), forEachOrdered() | terminal | – | nein | Java 8 |
collect() | terminal | – | nein | Java 8 |
toList() | terminal | – | nein | Java 16 |
toArray() | terminal | – | nein | Java 8 |
reduce() | terminal | – | nein | Java 8 |
count(), min(), max(), sum(), average() | terminal | – | nein | Java 8 |
findFirst(), findAny() | terminal | – | ja | Java 8 |
anyMatch(), allMatch(), noneMatch() | terminal | – | ja | Java 8 |
Lambda-Ausdrücke und Methodenreferenzen – was du für Streams brauchst
Jede Operation in den Beispielen oben bekommt ein kleines Stück Code als Argument: book -> book.genre() == SCIENCE_FICTION für filter(), Book::title für map(). Dieses Kapitel erklärt gerade so viel über diese beiden Schreibweisen, wie du brauchst, um jede Pipeline in diesem Artikel zu lesen und zu schreiben. Lambda-Ausdrücke und funktionale Interfaces haben weit mehr zu bieten – dafür werden sie eigene Artikel bekommen.
Lambda-Ausdrücke
Ein Lambda-Ausdruck ist eine Funktion ohne Namen, die du als Argument übergibst. Vor Java 8 brauchtest du dafür eine anonyme Klasse:
Predicate<Book> publishedBefore1850 = new Predicate<Book>() {
  @Override
  public boolean test(Book book) {
    return book.year() < 1850;
  }
};
Sechs Zeilen für einen Vergleich. Ein Lambda-Ausdruck reduziert das auf den Parameter und den Ausdruck:
Predicate<Book> publishedBefore1850 = book -> book.year() < 1850;Alles Weitere leitet der Compiler aus dem Zieltyp Predicate<Book> ab: Der Parameter book ist ein Book, und der Ausdruck rechts vom Pfeil ist der Rückgabewert der Methode test().
Ein Lambda gibt es in drei Formen: 1. mit abgeleitetem Parametertyp, 2. mit explizitem Typ und 3. mit einem Block als Rumpf, der ein eigenes return braucht:
// 1. Abgeleiteter Parametertyp: Der Compiler erkennt den Typ `Book` aus dem Kontext
Function<Book, String> title = book -> book.title();

// 2. Expliziter Parametertyp – nötig nur, wo der Compiler ihn nicht ableiten kann
Function<Book, String> titleTyped = (Book book) -> book.title();

// 3. Block als Rumpf: mehr als eine Anweisung, und deshalb ein eigenes `return`
Function<Book, String> titleBlock = book -> {
  String t = book.title();
  return t.toUpperCase();
};
Ich empfehle die erste Form überall dort, wo sie funktioniert. Der explizite Typ ist nur dann nötig, wenn der Compiler ihn nicht ableiten kann, und der Block nur dann, wenn das Lambda mehr als eine Anweisung braucht.
Methodenreferenzen
Ein Lambda, das nichts tut, als eine Methode aufzurufen – book -> book.title() z. B. –, lässt sich auch als Methodenreferenz schreiben: Book::title. Die vier Formen von Methodenreferenzen, die dir in Stream-Pipelines begegnen, sind die Referenz 1. auf eine Instanzmethode eines Typs, 2. auf eine statische Methode, 3. auf eine Methode eines bestimmten Objekts und 4. auf einen Konstruktor:
// 1. Instanzmethode eines Typs: `title()` wird auf jedem `Book`-Element aufgerufen
List<String> titles = BOOKS.stream().map(Book::title).toList();

// 2. Statische Methode: Jedes Element wird `String.valueOf()` als Argument übergeben
List<String> years = BOOKS.stream().map(Book::year).map(String::valueOf).toList();

// 3. Methode eines bestimmten Objekts: `println()` auf `System.out` mit dem Element
titles.forEach(System.out::println);

// 4. Konstruktor: erzeugt das Array, in das `toArray()` die Titel schreibt
String[] titleArray = titles.toArray(String[]::new);
Welche Form vorliegt, ergibt sich aus der referenzierten Methode. Book::title ist eine Instanzmethode ohne Argumente und wird auf jedem Book-Element aufgerufen. String.valueOf() ist statisch und bekommt das Element als Argument übergeben. System.out::println ruft println() auf dem Objekt System.out auf und bekommt das Element ebenfalls als Argument übergeben. Und String[]::new erzeugt das Array, in das toArray() die Titel schreibt – eine Konstruktorreferenz, die dir später bei toArray() und Collectors.toCollection() wiederbegegnet.
Funktionale Interfaces in der Stream-API
Jedes Lambda hat einen Typ, und dieser Typ ist ein funktionales Interface – ein Interface mit genau einer abstrakten Methode. filter() erwartet das funktionale Interface Predicate als Argument, map() eine Function, forEach() einen Consumer. Du musst die Namen der funktionalen Interfaces selten ausschreiben, weil der Compiler sie aus der Methodensignatur ableiten kann. Begegnen werden sie dir eher im Javadoc und in Compilerfehlern, deshalb hier die, die die Stream-API am häufigsten verwendet:
| Interface | Methode | Verwendet von |
|---|---|---|
Predicate<T> | boolean test(T t) | filter(), anyMatch(), allMatch(), noneMatch(), takeWhile(), dropWhile() |
Function<T, R> | R apply(T t) | map(), flatMap(), Collectors.toMap(), Collectors.groupingBy() |
Consumer<T> | void accept(T t) | forEach(), peek() |
Supplier<T> | T get() | Stream.generate(), Collectors.toCollection() |
Comparator<T> | int compare(T a, T b) | sorted(), min(), max() |
BinaryOperator<T> | T apply(T a, T b) | reduce(), die Merge-Funktion von Collectors.toMap() |
Die Methodensignatur (zweite Spalte der Tabelle) sagt dir, wie dein Lambda aussehen muss: Ein Predicate liefert ein boolean, eine Function liefert einen neuen Wert, ein Consumer liefert nichts.
Wie erzeugt man einen Stream?
Ein Stream braucht eine Quelle, und das JDK bietet eine für fast jede Art von Daten.
Aus einer Collection: Collection.stream()
Jede Collection hat eine stream()-Methode, also z. B. List, Set, Queue und Deque.
Im folgenden Beispiel sind eine List und ein Set die Quelle:
Stream<Book> books = BOOKS.stream();

Set<String> authors = Set.of("Jane Austen", "Bram Stoker");
List<String> sorted = authors.stream().sorted().toList();
[Bram Stoker, Jane Austen]Map hingegen ist keine Collection und hat keine stream()-Methode. Bei einer Map wählst du eine ihrer Views als Stream-Quelle: map.entrySet().stream(), map.keySet().stream() oder map.values().stream().
Stream.of() und Arrays.stream()
Stream.of() erzeugt einen Stream aus den Werten, die du übergibst:
Stream<String> genres = Stream.of("Novel", "Gothic", "Adventure");Arrays.stream() tut dasselbe für ein vorhandenes Array:
String[] words = {"streams", "are", "lazy"};
List<String> upper = Arrays.stream(words).map(String::toUpperCase).toList();

int[] years = {1813, 1818, 1851};
int sum = Arrays.stream(years).sum();
[STREAMS, ARE, LAZY]
5482Beachte im zweiten Beispiel: Arrays.stream(years) auf einem int[] liefert keinen Stream<Integer>, sondern einen IntStream – und auf dem steht die Methode sum() zur Verfügung. Das bringt uns zu den primitiven Streams.
Primitive Streams: IntStream, LongStream, DoubleStream
Ein Stream<Integer> enthält geboxte Integer-Objekte. Für Zahlen bietet das JDK drei spezialisierte Streams, die stattdessen auf primitiven Typen arbeiten: IntStream, LongStream und DoubleStream. Sie vermeiden das Boxing, und sie haben Methoden, die für nicht-numerische Objekte keinen Sinn ergeben – sum(), average(), range(), rangeClosed() und summaryStatistics():
int sum = IntStream.rangeClosed(1, 5).sum();
int sumExclusive = IntStream.range(1, 5).sum();
double average = DoubleStream.of(1.5, 2.5).average().getAsDouble();
long max = LongStream.of(1L, 2L, 3L).max().getAsLong();
IntSummaryStatistics stats = IntStream.rangeClosed(1, 5).summaryStatistics();
15
10
2.0
3
IntSummaryStatistics{count=5, sum=15, min=1, average=3.000000, max=5}rangeClosed(1, 5) schließt die obere Grenze ein und summiert deshalb die fünf Zahlen 1 bis 5, range(1, 5) schließt sie aus und summiert die vier Zahlen 1 bis 4. average() und max() liefern ein OptionalDouble und ein OptionalLong, weil der Stream leer sein kann; getAsDouble() und getAsLong() packen den Wert aus. Und summaryStatistics() liefert Anzahl, Summe, Minimum, Durchschnitt und Maximum in einem Durchlauf.
In die andere Richtung, zurück zum Objekt-Stream, führt boxed(): Es verpackt jedes int in ein Integer, sodass wieder ein Stream<Integer> entsteht.
List<Integer> numbers = IntStream.range(0, 3).boxed().toList();[0, 1, 2]Weitere Stream-Quellen
Files.lines() liest eine Textdatei zeilenweise als Stream<String>. Der Stream hält die Datei offen, deshalb gehört er in ein Try-with-resources:
try (Stream<String> lines = Files.lines(file)) {
  List<String> startingWithD = lines.filter(line -> line.startsWith("D")).toList();
}
String.chars() liefert die Zeichen eines Strings als IntStream:
long vowels = "Moby-Dick".chars().filter(c -> "aeiou".indexOf(c) >= 0).count();Stream.iterate() und Stream.generate() erzeugen unendliche Streams: iterate() wendet eine Funktion auf das vorige Element an, generate() ruft für jedes Element einen Supplier auf. Da beide kein Ende haben, brauchst du limit() – oder seit Java 9 die Form von iterate() mit drei Argumenten und einer Abbruchbedingung:
List<Integer> powersOfTwo = Stream.iterate(1, n -> n * 2).limit(6).toList();
List<Integer> powersBelow100 = Stream.iterate(1, n -> n < 100, n -> n * 2).toList();
List<String> xs = Stream.generate(() -> "x").limit(3).toList();
[1, 2, 4, 8, 16, 32]
[1, 2, 4, 8, 16, 32, 64]
[x, x, x]Stream.empty() erzeugt einen Stream ohne Elemente, und Stream.ofNullable(), ebenfalls seit Java 9, einen Stream mit einem Element – oder einen leeren, wenn das Argument null ist:
long none = Stream.empty().count();          // 0
long zero = Stream.ofNullable(null).count(); // 0
long one = Stream.ofNullable("Dracula").count(); // 1
Intermediäre Operationen
Eine intermediäre Operation nimmt einen Stream und gibt einen neuen Stream zurück. Der Aufruf einer intermediären Operation verarbeitet die Elemente noch nicht; das passiert erst, wenn eine terminale Operation läuft. Dieses Kapitel zeigt jede intermediäre Operation des Stream-Interfaces mit einem Beispiel.
filter()
filter() behält diejenigen Elemente, für die das Predicate true liefert, und verwirft alle anderen:
List<Book> adventures = BOOKS.stream()
    .filter(book -> book.genre() == ADVENTURE)
    .toList();

adventures.forEach(System.out::println);
Book[title=Moby-Dick, author=Herman Melville, year=1851, genre=ADVENTURE]
Book[title=Around the World in Eighty Days, author=Jules Verne, year=1873, genre=ADVENTURE]
Book[title=Treasure Island, author=Robert Louis Stevenson, year=1883, genre=ADVENTURE]
Book[title=Kidnapped, author=Robert Louis Stevenson, year=1886, genre=ADVENTURE]Die Elemente kommen unverändert durch. Nur ihre Anzahl ändert sich.
map()
map() wandelt jedes Element in genau ein neues Element um. Der Typ darf sich dabei ändern – hier von Book zu String:
List<String> titles = BOOKS.stream()
    .map(Book::title)
    .toList();

List<String> labels = BOOKS.stream()
    .map(book -> book.title() + " (" + book.year() + ")")
    .toList();
[Pride and Prejudice, Frankenstein, Moby-Dick, From the Earth to the Moon, ...]
[Pride and Prejudice (1813), Frankenstein (1818), Moby-Dick (1851), ...]Die Anzahl der Elemente bleibt gleich. Nur ihr Inhalt ändert sich.
flatMap()
Was, wenn aus einem Element mehrere werden sollen? Autor:innen haben jeweils eine Liste von Büchern, und du willst einen Stream aller Bücher. map() würde dir einen Stream<List<Book>> liefern – einen Stream von Listen von Büchern. flatMap() nimmt eine Funktion, die pro Element einen Stream zurückgibt, und fasst alle diese Streams zu einem zusammen.
Für dieses Beispiel bündelt der Record Author die Bücher einer Autorin oder eines Autors:
public record Author(String name, List<Book> books) {}Die Liste Library.AUTHORS enthält die Bibliothek nach Autor:innen gruppiert. Über sie kommst du mit flatMap() wieder an alle Bücher:
List<Book> allBooks = AUTHORS.stream()
    .flatMap(author -> author.books().stream())
    .toList();
allBooks enthält dann alle Bücher aller Autor:innen.
Auf dieselbe Art kannst du eine Liste von Titeln in eine Liste all ihrer Wörter zerlegen:
List<String> words = Stream.of("The Time Machine", "Moby-Dick")
    .flatMap(title -> Stream.of(title.split(" ")))
    .toList();
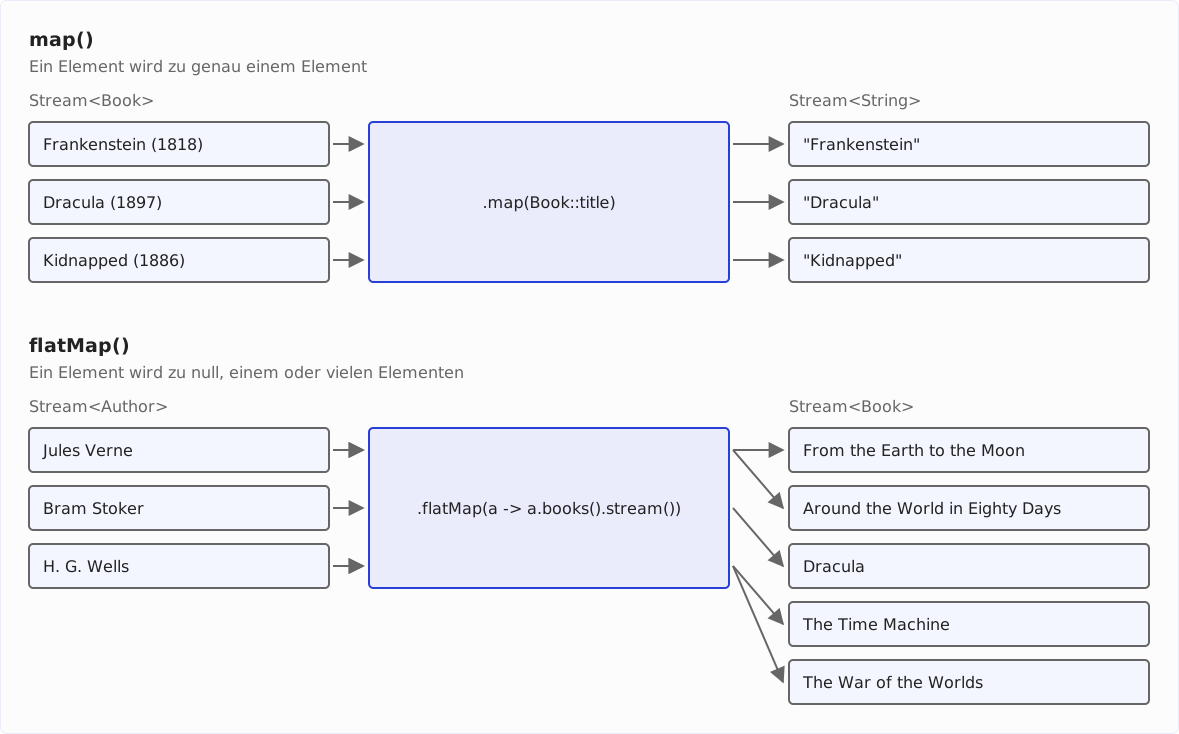
[The, Time, Machine, Moby-Dick]Du kannst dir merken: map() bildet eins auf eins ab, flatMap() eins auf null, eins oder viele.
Das folgende Diagramm zeigt beide Operationen nebeneinander – map() auf drei Büchern, flatMap() auf drei Autoren mit einem, einem und zwei Büchern:
Seit Java 16 gibt es mapMulti() als imperative Alternative zu flatMap(). Statt einen Stream zurückzugeben, bekommt das Lambda einen Consumer und übergibt diesem jedes Element, das es ausgeben will:
List<String> earlyTitles = BOOKS.stream()
    .<String>mapMulti((book, downstream) -> {
      if (book.year() < 1850) {
        downstream.accept(book.title());
      }
    })
    .toList();
[Pride and Prejudice, Frankenstein]mapMulti() spart es, pro Element einen Stream zu erzeugen. Das explizite Typargument <String> ist in diesem Beispiel nötig, weil der Compiler den Elementtyp des Ergebnisses nicht aus dem Lambda ableiten kann.
Wechsel zwischen Objekt-Streams und primitiven Streams
mapToInt(), mapToLong() und mapToDouble() machen aus einem Stream<T> einen primitiven Stream, damit du sum(), max() und die anderen numerischen Operationen verwenden kannst. mapToObj() und boxed() gehen den umgekehrten Weg:
int newestYear = BOOKS.stream().mapToInt(Book::year).max().getAsInt();

List<Integer> years = BOOKS.stream().mapToInt(Book::year).boxed().toList();

List<String> squares = IntStream.rangeClosed(1, 3)
    .mapToObj(n -> n + "² = " + n * n)
    .toList();
1898
[1813, 1818, 1851, 1865, 1865, 1873, 1883, 1886, 1895, 1897, 1898]
[1² = 1, 2² = 4, 3² = 9]distinct()
distinct() entfernt Duplikate. Zwei Elemente gelten als Duplikate, wenn equals() für sie true liefert; das erste Vorkommen bleibt:
List<String> authors = BOOKS.stream()
    .map(Book::author)
    .distinct()
    .toList();
[Jane Austen, Mary Shelley, Herman Melville, Jules Verne, Lewis Carroll, Robert Louis Stevenson, H. G. Wells, Bram Stoker]Elf Bücher, acht Autor:innen. distinct() muss sich jedes Element merken, das es gesehen hat – das macht es zu einer zustandsbehafteten Operation; mehr dazu im Abschnitt über zustandsbehaftete Operationen.
sorted()
sorted() ohne Argument sortiert den Stream nach der natürlichen Ordnung, die Elemente müssen also Comparable implementieren:
List<String> titles = BOOKS.stream().map(Book::title).sorted().toList();[Alice's Adventures in Wonderland, Around the World in Eighty Days, Dracula, Frankenstein, From the Earth to the Moon, Kidnapped, Moby-Dick, Pride and Prejudice, The Time Machine, The War of the Worlds, Treasure Island]Für alles andere übergibst du einen Comparator. Comparator.comparingInt() extrahiert im folgenden Beispiel das Erscheinungsjahr als Sortierschlüssel, reversed() dreht die Reihenfolge um:
List<Book> byYearDescending = BOOKS.stream()
    .sorted(Comparator.comparingInt(Book::year).reversed())
    .toList();

byYearDescending.forEach(
    book -> System.out.println(book.year() + " " + book.title()));
1898 The War of the Worlds
1897 Dracula
1895 The Time Machine
1886 Kidnapped
1883 Treasure Island
...Mit thenComparing() kannst du einen zweiten Sortierschlüssel ergänzen für diejenigen Elemente, die der erste Sortierschlüssel als gleich einstuft. Das folgende Beispiel sortiert also zuerst nach Autor:in und dann nach Jahr:
List<Book> byAuthorThenYear = BOOKS.stream()
    .sorted(Comparator.comparing(Book::author).thenComparing(Book::year))
    .toList();

byAuthorThenYear.forEach(
    book -> System.out.println(book.author() + " " + book.year()));
Bram Stoker 1897
H. G. Wells 1895
H. G. Wells 1898
Herman Melville 1851
Jane Austen 1813
Jules Verne 1865
Jules Verne 1873
...Alles, was ein Comparator kann – nullsFirst(), reverseOrder(), Vergleichen nach mehreren Schlüsseln –, steht im Artikel über das Sortieren von Streams mit Comparator.comparing().
limit() und skip()
limit(n) behält die ersten n Elemente, skip(n) verwirft die ersten n. Zusammen liefern sie einen beliebigen Abschnitt des Streams – im dritten Beispiel die Elemente vier bis sechs:
List<String> firstThree = BOOKS.stream().map(Book::title).limit(3).toList();
List<String> lastThree = BOOKS.stream().map(Book::title).skip(8).toList();
List<String> fourToSix = BOOKS.stream().map(Book::title).skip(3).limit(3).toList();
[Pride and Prejudice, Frankenstein, Moby-Dick]
[The Time Machine, Dracula, The War of the Worlds]
[From the Earth to the Moon, Alice's Adventures in Wonderland, Around the World in Eighty Days]takeWhile() und dropWhile()
Seit Java 9 liefert takeWhile() die Elemente vom Anfang des Streams, bis das übergebene Predicate zum ersten Mal false ergibt. dropWhile() überspringt genau diese Elemente und liefert den Rest:
List<String> before1860 = BOOKS.stream()
    .takeWhile(book -> book.year() < 1860)
    .map(Book::title)
    .toList();

List<String> from1890 = BOOKS.stream()
    .dropWhile(book -> book.year() < 1890)
    .map(Book::title)
    .toList();
[Pride and Prejudice, Frankenstein, Moby-Dick]
[The Time Machine, Dracula, The War of the Worlds]Das funktioniert in diesem Fall, weil die Bibliothek nach Jahr sortiert ist. Auf einem unsortierten Stream wird der Unterschied zu filter() sichtbar:
List<Integer> taken = Stream.of(1, 2, 8, 3, 4).takeWhile(n -> n < 5).toList();
List<Integer> filtered = Stream.of(1, 2, 8, 3, 4).filter(n -> n < 5).toList();
[1, 2]
[1, 2, 3, 4]takeWhile() hört bei der 8 – dem ersten Element, das nicht kleiner als 5 ist – auf und bekommt die 3 und die 4 nie zu sehen. filter() prüft jedes Element.
peek()
peek() führt für jedes Element, das die Operation durchläuft, eine Aktion aus und reicht das Element unverändert weiter. Es ist dafür gedacht, beim Debuggen in eine laufende Pipeline hineinzusehen:
List<String> result = BOOKS.stream()
    .filter(book -> book.year() > 1890)
    .peek(book -> System.out.println("after filter: " + book.title()))
    .map(Book::title)
    .peek(title -> System.out.println("after map:    " + title))
    .toList();
after filter: The Time Machine
after map: The Time Machine
after filter: Dracula
after map: Dracula
after filter: The War of the Worlds
after map: The War of the WorldsBeachte die Reihenfolge der Ausgabe: „after filter“ und „after map“ wechseln sich ab. Das erste Buch läuft durch filter() und map(), bevor das zweite Buch die Pipeline betritt. Das ist die elementweise Verarbeitung, die das Kapitel über Lazy Evaluation erklärt.
Verwende peek() nicht, um Elemente zu verändern oder eine externe Liste zu füllen. Die JDK-Entwickler:innen garantieren nicht, dass die Aktion für jedes Element läuft – eine Pipeline, die nur zählt, darf die intermediären Operationen z. B. ganz überspringen. Für Seiteneffekte gibt es forEach(), für Ergebnisse collect().
gather()
Seit Java 24 kannst du mit gather() eigene intermediäre Operationen schreiben. Das JDK bringt einige fertige Gatherer mit; Gatherers.windowFixed() gruppiert die Elemente in Listen fester Größe:
List<List<String>> pairs = BOOKS.stream()
    .map(Book::title)
    .gather(Gatherers.windowFixed(2))
    .toList();
[Pride and Prejudice, Frankenstein]
[Moby-Dick, From the Earth to the Moon]
[Alice's Adventures in Wonderland, Around the World in Eighty Days]
[Treasure Island, Kidnapped]
[The Time Machine, Dracula]
[The War of the Worlds]Wie die anderen eingebauten Gatherer funktionieren und wie du eigene implementierst, ist Thema des Artikels über Java Stream Gatherers.
Terminale Operationen
Eine terminale Operation startet die Verarbeitung und erzeugt das Ergebnis: einen Wert, eine Collection oder einen Seiteneffekt. Danach ist der Stream verbraucht.
forEach() und forEachOrdered()
forEach() führt für jedes Element eine Aktion aus:
BOOKS.stream()
    .filter(book -> book.year() > 1890)
    .forEach(book -> System.out.println(book.title()));
The Time Machine
Dracula
The War of the WorldsforEachOrdered() tut dasselbe, garantiert aber die Reihenfolge der Elemente. Bei einem sequenziellen Stream macht das keinen Unterschied; bei einem parallelen Stream schon.
collect() und Collectors
collect() baut aus den Elementen ein Ergebnis – z. B. eine Liste, ein Set, eine Map, einen String. Wie es das tut, legt ein Collector fest, und die Klasse Collectors stellt die gängigen bereit. Hier je ein Beispiel.
toSet() sammelt die Elemente in einem Set und verwirft dabei Duplikate – hier bleiben die fünf Genres übrig, die in der Bibliothek vorkommen:
Set<Genre> genres = BOOKS.stream().map(Book::genre).collect(toSet());toMap() baut aus einer Schlüsselfunktion und einer Wertfunktion eine Map, z. B. eine Map von Buchtitel auf Erscheinungsjahr:
Map<String, Integer> yearByTitle = BOOKS.stream()
    .collect(toMap(Book::title, Book::year));
Zwei Elemente mit demselben Schlüssel lassen toMap() eine IllegalStateException werfen. Mit dem Autor als Schlüssel passiert das bei Jules Verne, der zwei Bücher in der Bibliothek hat:
Map<String, Integer> yearByAuthor = BOOKS.stream()
    .collect(toMap(Book::author, Book::year));
java.lang.IllegalStateException: Duplicate key Jules Verne (attempted merging values 1865 and 1873)toMap() mit drei Argumenten nimmt eine Merge-Funktion, die entscheidet, welcher Wert gewinnt – im folgenden Beispiel überschreibt der neuere den existierenden:
Map<String, String> latestTitleByAuthor = BOOKS.stream()
    .collect(toMap(Book::author, Book::title, (first, second) -> second));

System.out.println(latestTitleByAuthor.get("Jules Verne"));
Around the World in Eighty Daysjoining() verkettet Strings mit einem Trennzeichen:
String authors = BOOKS.stream()
    .map(Book::author)
    .distinct()
    .collect(joining(", "));
Jane Austen, Mary Shelley, Herman Melville, Jules Verne, Lewis Carroll, Robert Louis Stevenson, H. G. Wells, Bram StokergroupingBy() gruppiert die Elemente nach einem Schlüssel in eine Map von Listen. Damit löst du auch die Aufgabe, an der toMap() eben gescheitert ist: Jede Autorin und jeder Autor bekommt eine Liste von Erscheinungsjahren statt eines einzelnen Werts. Was in diesen Listen landet, bestimmt ein zweites Argument, ein sogenannter Downstream-Collector – hier mapping():
Map<String, List<Integer>> yearsByAuthor = BOOKS.stream()
    .collect(groupingBy(Book::author, mapping(Book::year, toList())));
{Bram Stoker=[1897], Robert Louis Stevenson=[1883, 1886], Mary Shelley=[1818], Jane Austen=[1813], Lewis Carroll=[1865], Herman Melville=[1851], Jules Verne=[1865, 1873], H. G. Wells=[1895, 1898]}Genauso gruppierst du die Titel nach Genre, und mit counting() als Downstream-Collector zählst du die Bücher je Genre:
Map<Genre, List<String>> titlesByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, mapping(Book::title, toList())));

Map<Genre, Long> countByGenre = BOOKS.stream()
    .collect(groupingBy(Book::genre, counting()));
{FANTASY=[Alice's Adventures in Wonderland], ADVENTURE=[Moby-Dick, Around the World in Eighty Days, Treasure Island, Kidnapped], GOTHIC=[Frankenstein, Dracula], SCIENCE_FICTION=[From the Earth to the Moon, The Time Machine, The War of the Worlds], NOVEL=[Pride and Prejudice]}
{FANTASY=1, ADVENTURE=4, GOTHIC=2, SCIENCE_FICTION=3, NOVEL=1}groupingBy() liefert eine HashMap. Deren Reihenfolge ist nicht festgelegt, bei den Genre-Schlüsseln wechselt sie sogar von Programmlauf zu Programmlauf – bei dir sieht die Ausgabe also anders aus.
Zwei weitere Collectors solltest du kennen: Seit Java 10 liefern toUnmodifiableList(), toUnmodifiableSet() und toUnmodifiableMap() Collections, die sich nachträglich nicht mehr ändern lassen. Und seit Java 12 leitet teeing() die Elemente in zwei Collectors gleichzeitig und kombiniert deren Ergebnisse.
Stream.toList() vs. Collectors.toList()
Seit Java 16 hat Stream eine eigene toList()-Methode, und du hast sie in vielen Beispielen oben gesehen. Sie liefert eine unveränderbare Liste:
List<String> titles = BOOKS.stream().map(Book::title).toList();
titles.add("Emma"); // UnsupportedOperationException
collect(Collectors.toList()) ist die ältere Form. Ihr Javadoc verspricht nichts über den Typ oder die Veränderbarkeit der Liste – heute liefert sie eine ArrayList, die du ändern kannst, aber die API garantiert das nicht:
List<String> mutable = BOOKS.stream()
    .map(Book::title)
    .collect(Collectors.toList());
mutable.add("Emma"); // funktioniert heute, aber die API garantiert es nicht
Ich empfehle Stream.toList() überall dort, wo das Ergebnis nicht verändert werden muss. Wenn doch, sag es ausdrücklich mit collect(Collectors.toCollection(ArrayList::new)) – siehe das Kapitel über häufige Fehler.
toArray()
toArray() liefert die Elemente als Array. Bei einem Objekt-Stream übergibst du den Array-Konstruktor, damit das Ergebnis den richtigen Typ hat; ein primitiver Stream kennt seinen Typ:
String[] titles = BOOKS.stream().map(Book::title).toArray(String[]::new);
int[] years = BOOKS.stream().mapToInt(Book::year).toArray();
reduce()
reduce() fasst alle Elemente zu einem Wert zusammen. Du übergibst eine Funktion, die zwei Elemente nimmt – das bisher aufgelaufene Ergebnis und das nächste Element – und eines zurückgibt:
int sum = IntStream.rangeClosed(1, 5).reduce(0, (a, b) -> a + b);

Optional<Book> oldest = BOOKS.stream()
    .reduce((a, b) -> a.year() <= b.year() ? a : b);
15
Optional[Book[title=Pride and Prejudice, author=Jane Austen, year=1813, genre=NOVEL]]Die erste Form nimmt einen Anfangswert, den sogenannten Identitätswert – die 0 für eine Summe – und liefert ein int. Die zweite Form hat keinen Identitätswert und liefert ein Optional, denn ein leerer Stream hat nichts, was sich zusammenfassen ließe. Was reduce() sonst noch kann und wann collect() das bessere Werkzeug ist, wird Thema eines eigenen Artikels sein.
count(), min(), max(), sum() und average()
Für die gängigen Aggregationen brauchst du kein reduce(). count(), min() und max() gibt es auf jedem Stream; sum(), average() und summaryStatistics() auf den primitiven Streams:
long before1850 = BOOKS.stream().filter(book -> book.year() < 1850).count();

Optional<Book> newest = BOOKS.stream().max(Comparator.comparingInt(Book::year));

double averageYear = BOOKS.stream().mapToInt(Book::year).average().getAsDouble();

IntSummaryStatistics stats = BOOKS.stream()
    .mapToInt(Book::year)
    .summaryStatistics();
2
Optional[Book[title=The War of the Worlds, author=H. G. Wells, year=1898, genre=SCIENCE_FICTION]]
1867.6363636363637
IntSummaryStatistics{count=11, sum=20544, min=1813, average=1867.636364, max=1898}findFirst() und findAny()
findFirst() liefert das erste Element des Streams, findAny() irgendein Element. Beide liefern ein Optional, weil der Stream leer sein kann:
Optional<Book> firstGothic = BOOKS.stream()
    .filter(book -> book.genre() == GOTHIC)
    .findFirst();

String title = firstGothic.map(Book::title).orElse("none");
System.out.println(title);
firstGothic.ifPresent(book -> System.out.println("found: " + book.title()));
Frankenstein
found: FrankensteinOptional.map() wandelt den Wert um, falls es einen gibt, orElse() liefert den Ersatzwert, und ifPresent() führt eine Aktion nur dann aus, wenn ein Wert vorhanden ist. Mehr brauchst du von Optional nicht, um mit diesen Methoden zu arbeiten; für alles Weitere wird es einen eigenen Artikel geben. So sieht ein leeres Ergebnis aus:
Optional<Book> after1900 = BOOKS.stream()
    .filter(book -> book.year() > 1900)
    .findFirst();

after1900.isPresent();                         // false
after1900.map(Book::title).orElse("none");     // "none"
In einem sequenziellen Stream liefert findAny() dasselbe Element wie findFirst(). Sein Zweck ist der parallele Stream: Dort darf es das Element liefern, das irgendein Thread zuerst findet – und spart die Koordination, die findFirst() braucht, um das erste Element in der Reihenfolge der Quelle zu bestimmen.
anyMatch(), allMatch() und noneMatch()
Die drei Match-Operationen beantworten eine Ja/Nein-Frage über die Elemente, z. B. ob es irgendein Buch des Autors Bram Stoker gibt, ob alle Bücher von vor 1900 sind oder ob kein Buch ein Roman ist:
boolean hasStoker = BOOKS.stream()
    .anyMatch(book -> book.author().equals("Bram Stoker"));

boolean allBefore1900 = BOOKS.stream().allMatch(book -> book.year() < 1900);

boolean noNovels = BOOKS.stream().noneMatch(book -> book.genre() == NOVEL);
true
true
falseAlle drei beenden den Stream, sobald die Antwort feststeht: anyMatch() beim ersten Treffer, allMatch() und noneMatch() beim ersten Element, das die Frage entscheidet.
Wie Streams arbeiten: Lazy Evaluation
Die vorigen Kapitel haben eine Eigenschaft von Streams benutzt, ohne sie zu erklären: Intermediäre Operationen laufen nicht, sobald du sie aufrufst (sondern erst, wenn du die terminale Operation aufrufst). Dieses Kapitel zeigt, was stattdessen passiert – und warum das für deinen Code wichtig ist.
Intermediäre Operationen tun von sich aus nichts
Was gibt die folgende Pipeline aus?
BOOKS.stream()
    .filter(book -> book.year() > 1890)
    .peek(book -> System.out.println("filtered: " + book.title()));
Nichts. Es gibt keine terminale Operation, also schiebt die Quelle kein einziges Element in die Pipeline, und die peek()-Aktion läuft nie. Die intermediären Operationen bauen nur eine Beschreibung der Verarbeitung auf. Das bedeutet Lazy Evaluation: Die Arbeit passiert erst, wenn das Ergebnis angefordert wird, nicht, wenn die Pipeline zusammengesetzt wird.
Element für Element, nicht Stufe für Stufe
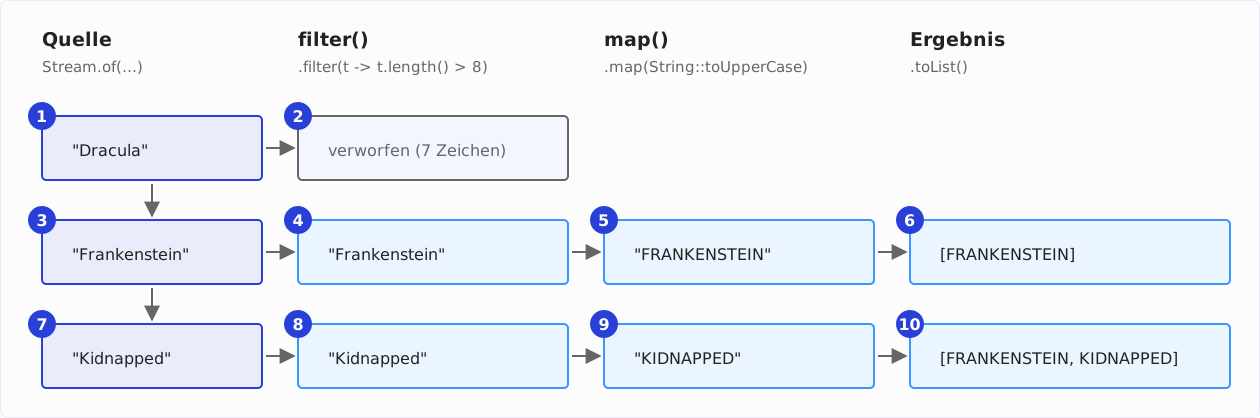
Du könntest erwarten, dass eine Pipeline in Stufen läuft: im folgenden Beispiel erst filter() auf allen Elementen, dann map() auf allen verbliebenen. So ist es nicht. Die terminale Operation stößt den Durchlauf an, und die Quelle schiebt ihre Elemente einzeln in die Pipeline: Jedes Element läuft durch die ganze Pipeline, bevor das nächste folgt.
List<String> result = Stream.of("Dracula", "Frankenstein", "Kidnapped")
    .peek(title -> System.out.println("filter sees " + title))
    .filter(title -> title.length() > 8)
    .peek(title -> System.out.println("map sees    " + title))
    .map(String::toUpperCase)
    .toList();
filter sees Dracula
filter sees Frankenstein
map sees Frankenstein
filter sees Kidnapped
map sees Kidnapped„Dracula“ hat sieben Buchstaben und fällt durch den Filter, also sieht map() es nie. „Frankenstein“ besteht den Filter und erreicht map(), bevor „Kidnapped“ überhaupt aus der Quelle gelesen wird.
Das folgende Diagramm zeigt denselben Durchlauf als Raster – eine Zeile pro Element, eine Spalte pro Stufe, und die Reihenfolge der Schritte als Nummern:
Das hat zwei Folgen. Ein Stream muss nie die Zwischenergebnisse aller Elemente im Speicher halten – es ist immer nur ein Element in der Pipeline unterwegs. Und eine Operation, die früh entscheidet, kann die ganze Pipeline früh beenden, und darum geht es im nächsten Abschnitt.
Short-Circuiting-Operationen
findFirst(), anyMatch(), limit() und die anderen Operationen, die in der Übersicht als Short-circuiting markiert sind, melden der Quelle, sobald ihr Ergebnis feststeht, dass keine weiteren Elemente mehr nötig sind. Zusammen mit der elementweisen Verarbeitung führt das dazu, dass die folgende Pipeline terminiert, obwohl ihre Quelle unendlich ist:
String first = Stream.iterate(1, n -> n + 1)
    .peek(n -> System.out.println("checking " + n))
    .filter(n -> n % 7 == 0)
    .map(n -> "first multiple of 7: " + n)
    .findFirst()
    .orElseThrow();
checking 1
checking 2
checking 3
checking 4
checking 5
checking 6
checking 7
first multiple of 7: 7iterate() würde endlos Zahlen erzeugen. findFirst() braucht genau ein Element, das den Filter besteht; mit der 7 ist das erreicht, und findFirst() beendet den Stream. Die 8 wird nie erzeugt.
Zustandsbehaftete Operationen: sorted() und distinct()
Die elementweise Verarbeitung hat eine Grenze. sorted() kann sein erstes Element nicht ausgeben, bevor es das letzte gesehen hat – das kleinste Element könnte ganz am Ende kommen. Es sammelt alle Elemente, sortiert sie und gibt sie erst dann weiter:
List<String> sorted = Stream.of("Dracula", "Frankenstein", "Kidnapped")
    .peek(title -> System.out.println("before sorted: " + title))
    .sorted()
    .peek(title -> System.out.println("after sorted:  " + title))
    .toList();
before sorted: Dracula
before sorted: Frankenstein
before sorted: Kidnapped
after sorted: Dracula
after sorted: Frankenstein
after sorted: KidnappedErst kommen die drei „before“-Zeilen, dann die drei „after“-Zeilen. Bis sorted() lief die Pipeline Element für Element; bei sorted() musste sie puffern.
Solche Operationen heißen zustandsbehaftet (stateful): sorted() puffert alles, distinct() merkt sich jedes gesehene Element, limit() und skip() zählen mit. Die anderen – filter(), map(), flatMap(), peek() – sind zustandslos (stateless): Sie sehen sich ein Element nach dem anderen an und merken sich nichts.
Zustandsbehaftete Operationen haben ihren Preis. sorted() hält alle Elemente im Speicher, und auf einem unendlichen Stream kehrt es nie zurück – Stream.iterate(1, n -> n + 1).sorted().findFirst() läuft, bis der JVM der Speicher ausgeht. Ein limit() vor sorted() behebt das; ein limit() dahinter nicht.
Ein Stream kann nur einmal verwendet werden
Ein Stream führt seine Pipeline genau einmal aus. Die zweite terminale Operation auf demselben Stream wirft eine Exception:
Stream<Book> books = BOOKS.stream();
books.count();
books.count(); // IllegalStateException
java.lang.IllegalStateException: stream has already been operated upon or closedBrauchst du die Elemente zweimal, musst du ihn zweimal erzeugen. Das kostet nichts: BOOKS.stream() kopiert die Liste nicht, es erzeugt nur das Pipeline-Objekt.
Parallele Streams
parallelStream() auf einer Collection – oder parallel() auf einem beliebigen Stream – verteilt die Elemente auf die Threads des gemeinsamen ForkJoinPool und verarbeitet sie nebenläufig. Die Pipeline bleibt dieselbe; nur die Ausführung ändert sich. Bei forEach() siehst du das sofort, denn die Reihenfolge, in der die Threads fertig werden, ist nicht mehr die Reihenfolge der Quelle:
BOOKS.parallelStream()
    .map(Book::title)
    .forEach(System.out::println);
Treasure Island
Kidnapped
Around the World in Eighty Days
Dracula
...forEachOrdered() stellt die Reihenfolge der Quelle wieder her – um den Preis der Koordination, die das erfordert:
BOOKS.parallelStream()
    .map(Book::title)
    .forEachOrdered(System.out::println);
Pride and Prejudice
Frankenstein
Moby-Dick
...Die Ergebnisse von reduce(), collect() und den Aggregationen bleiben in einem parallelen Stream korrekt – das JDK teilt die Arbeit auf und fügt die Teilergebnisse zusammen:
long sum = IntStream.rangeClosed(1, 1_000_000).parallel().asLongStream().sum();500000500000Ob ein paralleler Stream schneller ist als ein sequenzieller, hängt von der Arbeit pro Element ab, von der Größe der Quelle und davon, wie leicht sie sich aufteilen lässt. Bei elf Büchern gibt es nichts zu verteilen – das Aufteilen und Zusammenfügen ist der ganze Aufwand, und die Arbeit pro Element ist ein Methodenaufruf. Wann sich parallele Streams lohnen und wann nicht, wird Thema eines eigenen Artikels sein; die Messungen zum parallelen Sortieren geben einen ersten Eindruck davon, wo die Grenze liegt.
Häufige Fehler
Die folgenden fünf Fehler sehe ich häufig beim Einsatz von Streams – jeder hat eine einfache Lösung.
Seiteneffekte in Lambdas
Eine externe Liste aus forEach() heraus zu füllen, funktioniert – in einem sequenziellen Stream:
List<String> titles = new ArrayList<>();
BOOKS.stream()
    .filter(book -> book.year() > 1890)
    .forEach(book -> titles.add(book.title()));
Wenn du daraus einen parallelen Stream machst, schreiben mehrere Threads gleichzeitig in eine ArrayList, die nicht threadsicher ist. Das Ergebnis ist eine Liste mit fehlenden Elementen oder eine ArrayIndexOutOfBoundsException.
Die Lösung ist, den Stream die Liste erzeugen zu lassen:
List<String> titles = BOOKS.stream()
    .filter(book -> book.year() > 1890)
    .map(Book::title)
    .toList();
Diese Fassung hat keinen gemeinsamen Zustand und funktioniert sequenziell wie parallel. Die Regel dahinter: Lambdas in einer Pipeline berechnen Werte, sie ändern nichts außerhalb der Pipeline.
Einen Stream wiederverwenden
Die IllegalStateException hast du im Abschnitt Ein Stream kann nur einmal verwendet werden gesehen. Sie taucht meist dann auf, wenn ein Stream in einer Variablen gespeichert und an zwei Stellen verwendet wird:
Stream<Book> stream = BOOKS.stream();
stream.forEach(book -> {});
stream.count(); // IllegalStateException
Speichere Streams nicht in Variablen; erzeuge sie dort, wo du sie brauchst.
Checked Exceptions in Lambdas
Function, Predicate und die anderen funktionalen Interfaces deklarieren keine Checked Exceptions. Ein Lambda, das eine Methode mit einer Checked Exception aufruft, kompiliert deshalb nicht:
// kompiliert nicht: Files.readAllLines() wirft eine IOException
List<String> lines = files.stream()
    .flatMap(file -> Files.readAllLines(file).stream())
    .toList();
Die Lösung ist eine kleine Hilfsmethode, die die Checked Exception in eine Unchecked Exception verpackt – genau dafür gibt es UncheckedIOException. Lässt du sie gleich einen Stream zurückgeben, genügt im flatMap() eine Methodenreferenz:
List<String> lines = files.stream()
    .flatMap(FileUtil::readLines)
    .toList();
public class FileUtil {
public static Stream<String> readLines(Path file) {
try {
return Files.readAllLines(file).stream();
} catch (IOException e) {
throw new UncheckedIOException(e);
}
}
}Streams für alles
Nicht jede Schleife ist als Stream besser. Diese Schleife summiert die Längen der Titel:
int total = 0;
for (Book book : BOOKS) {
  total += book.title().length();
}
Und dieser Stream tut dasselbe:
int total = BOOKS.stream().mapToInt(book -> book.title().length()).sum();Beide sind in Ordnung. Der Stream gewinnt, wenn die Pipeline mehrere Schritte hat, die in der Schleife jeweils zu einem verschachtelten if oder einer Zwischenliste würden. Er verliert, wenn die Schleife über Indizes läuft oder mehrere Variablen gleichzeitig ändert. Am deutlichsten wird das bei verschachtelten Schleifen.
Die folgende Methode sucht in einer Matrix alle Zellen mit einem bestimmten Wert und gibt deren Koordinaten zurück:
static List<String> findAll(int[][] matrix, int value) {
  List<String> hits = new ArrayList<>();
  for (int row = 0; row < matrix.length; row++) {
    for (int col = 0; col < matrix[row].length; col++) {
      if (matrix[row][col] == value) {
        hits.add(row + "/" + col);
      }
    }
  }
  return hits;
}
Dieselbe Aufgabe als Pipeline:
static List<String> findAll(int[][] matrix, int value) {
  return IntStream.range(0, matrix.length)
      .boxed()
      .flatMap(row -> IntStream.range(0, matrix[row].length)
          .filter(col -> matrix[row][col] == value)
          .mapToObj(col -> row + "/" + col))
      .toList();
}
Für die Matrix {{1, 0, 2}, {0, 2, 0}, {2, 1, 0}} und den Wert 2 liefern beide dasselbe Ergebnis:
[0/2, 1/1, 2/0]Die Stream-Fassung ist drei Zeilen kürzer und trotzdem schwerer zu lesen: Die äußere range() muss mit boxed() in einen Objekt-Stream wechseln, damit flatMap() einen Stream<String> zurückgeben darf, und die innere Pipeline steckt als Ausdruck im Lambda der äußeren. Die verschachtelte Schleife kommt ohne beides aus.
Und wo eine Schleife mittendrin mit break abbricht und dabei einen Zwischenstand mitführt, brauchst du für eine Stream-Pipeline sogar einen eigenen Gatherer, denn takeWhile() bekommt immer nur ein Element und kennt den Zwischenstand nicht.
Ich empfehle die Form, die am klarsten sagt, was der Code tut, und das ist nicht immer der Stream.
Annehmen, dass Collectors.toList() eine veränderbare Liste liefert
Der Vergleich oben hat es gezeigt: Collectors.toList() liefert heute eine veränderbare ArrayList, aber sein Vertrag verspricht das nicht. Code, der etwas an das Ergebnis anhängt, verlässt sich auf ein Implementierungsdetail. Brauchst du eine veränderbare Liste, dann fordere explizit eine an:
List<String> titles = BOOKS.stream()
    .map(Book::title)
    .collect(Collectors.toCollection(ArrayList::new));
Zusammenfassung
Eine Stream-Pipeline hat eine Quelle, beliebig viele intermediäre Operationen und eine terminale Operation. Die intermediären Operationen beschreiben die Verarbeitung; erst der Aufruf der terminalen Operation führt sie aus – lazy, Element für Element und nur so weit, wie das Ergebnis es erfordert. Deshalb terminiert findFirst() auf einem unendlichen Stream, und deshalb tut sorted() es nicht.
Drei Empfehlungen für den Alltag: Verwende Stream.toList(), es sei denn, du brauchst eine veränderbare Liste. Halte Lambdas frei von Seiteneffekten, dann funktioniert die Pipeline sequenziell wie parallel. Und erzeuge einen Stream dort, wo du ihn verwendest, statt ihn zu speichern.
Dieser Artikel hat jede Operation des Stream-Interfaces behandelt. Zu einigen davon gibt es mehr zu sagen, als ein Beispiel zeigen kann: reduce(), die Collectors groupingBy() und toMap() sowie parallele Streams werden deshalb jeweils einen eigenen Artikel bekommen, ebenso Lambda-Ausdrücke, funktionale Interfaces und Optional – die drei Dinge, aus denen eine Pipeline neben dem Stream selbst besteht. Über die Stream Gatherers, mit denen du eigene intermediäre Operationen schreibst, gibt es ihn schon.
War dieser Artikel hilfreich für dich? Dann freue ich mich, wenn du dir kurz Zeit für eine Bewertung auf meinem ProvenExpert-Profil nimmst.
Wenn du erfahren möchtest, was sich in Java als Nächstes ändert, klicke hier und melde dich für den HappyCoders-Newsletter an.