Für das Lesen und Schreiben von Dateien in Java gibt es in den Packages java.io und java.nio.file zahlreiche Klassen. Seit der Einführung der Java NIO.2 (New I/O) File API verliert man – nicht nur als Einsteiger:in – leicht den Überblick. Viele Datei-Operationen lassen sich seither auf mehrere Arten durchführen.
Diese Artikelserie stellt zuerst einfache Utility-Methoden vor, um Dateien zu lesen und zu schreiben. In späteren Teilen werden komplexere und fortgeschrittene Methoden behandelt: über Channels und Buffers bis hin zu Memory-Mapped I/O (es macht nichts, wenn dir das an dieser Stelle noch nichts sagt).
Der erste Artikel behandelt das Lesen von Dateien. Du lernst zunächst, wie man Dateien einliest, die komplett in den Arbeitsspeicher passen:
- Wie liest man am einfachsten eine Textdatei in einen String (oder eine String-Liste)?
- Wie liest man eine Binärdatei in ein Byte-Array?
Danach geht es weiter zu größeren Dateien und den dafür zuständigen Klassen:
- Wie liest man größere Dateien und verarbeitet sie gleichzeitig weiter (um nicht die komplette Datei im Speicher halten zu müssen)?
- Wann verwendet man
FileReader,FileInputStream,InputStreamReader,BufferedInputStreamundBufferedReader? - Wann verwendet man
Files.newInputStream()undFiles.newBufferedReader()?
Außerdem (und das gilt sowohl für kleine als auch für große Dateien):
- Was muss man beachten, damit der Dateizugriff auf jedem Betriebssystem funktioniert?
Wie liest man in Java am einfachsten eine Datei?
Bis einschließlich Java 6 musste man für das Lesen einer Datei mehrere Zeilen Programmcode um einen FileInputStream herum schreiben. Dabei musste man darauf achten, dass man diesen nach dem Lesen – und auch im Fehlerfall – wieder korrekt schließt. „Try-with-resources“ (also das automatische Schließen aller im try-Block geöffneten Ressourcen) gab es damals noch nicht.
Nur über Drittanbieter-Libraries (z. B. Apache Commons oder Guava) konnte man auf komfortablere Möglichkeiten zurückgreifen.
Mit Java 7 kam dann über das JSR 203 die langersehnte „NIO.2 File API“ (NIO steht für New I/O). Mit der neuen API kam unter anderem die Utility-Klasse java.nio.file.Files, über die du mit einem einzigen Methoden-Aufruf Text- sowie Binärdateien komplett einlesen kannst.
Welche Methoden das im Detail sind, erfährst du in den folgenden Abschnitten.
Laden einer Binärdatei in ein Byte-Array
Du kannst den kompletten Inhalt einer Datei über die Methode Files.readAllBytes() in ein Byte-Array einlesen:
String fileName = ...;
byte[] bytes = Files.readAllBytes(Path.of(fileName));
Die Klasse Path ist dabei eine Abstraktion von Datei- und Verzeichnisnamen, deren Details hier erstmal nicht relevant sind. Auf diese gehe ich im Artikel Dateinamen und Verzeichnisnamen mit File, Path und Paths näher ein. Zunächst genügt es zu wissen, dass du ein Path-Objekt über Paths.get() oder – seit Java 11 etwas eleganter – über Path.of() erstellen kannst.
Laden einer Textdatei in einen String
Möchtest du den Inhalt einer Textdatei in einen String laden, geht das – seit Java 11 – über die Methode Files.readString() wie folgt:
String fileName = ...;
String text = Files.readString(Path.of(fileName));
Die Methode readString() ruft dabei intern wiederum readAllBytes() auf und wandelt danach die Binärdaten in die gewünschte Zeichenkette um.
Zeilenweises Laden einer Textdatei in eine String-Liste
Der Inhalt von Textdateien ist in den allermeisten Fällen auf mehrere Zeilen verteilt. Möchtest du den Text zeilenweise verarbeiten, brauchst du dir nicht selbst die Mühe zu machen, den eingelesenen Text aufzusplitten. Dies kann direkt beim Laden erfolgen, indem du die seit Java 8 verfügbare Methode readAllLines() verwendest:
String fileName = ...;
List<String> lines = Files.readAllLines(Path.of(fileName));
Danach kannst du leicht über die erhaltene String-Liste iterieren und diese weiterverarbeiten.
Zeilenweises Laden einer Textdatei in einen String-Stream
In Java 8 wurden Streams eingeführt. Entsprechend wurde in derselben Java-Version die Klasse Files um die Methode lines() erweitert, die die Zeilen einer Textdatei nicht als String-Liste zurückzuliefert, sondern als Stream von Strings:
String fileName = ...;
Stream<String> lines = Files.lines(Path.of(fileName));
So könntest du beispielsweise mit nur einem Code-Statement alle Zeilen einer Textdatei ausgeben, die die Zeichenkette „foo“ enthalten:
try (Stream<String> lines = Files.lines(Path.of(fileName))) {
  lines.filter(line -> line.contains("foo"))
       .forEach(System.out::println);
}
Der Stream hält die Datei so lange offen, bis du ihn schließt – anders als bei readAllLines() ist die Datei nach dem letzten Element also noch nicht zu. Deshalb gehört er immer in ein Try-with-resources.
java.nio.file.Files – Zusammenfassung
Mit den vier gezeigten Methoden lassen sich viele Anwendungsfälle abdecken. Allerdings sollten die gelesenen Dateien nicht zu groß sein, da diese komplett in den Arbeitsspeicher geladen werden. Mit einem HD-Film solltest du das also nicht versuchen.
Eine harte Grenze gibt es obendrein: readAllBytes() legt den Inhalt in einem einzigen Byte-Array ab und vergleicht die Dateigröße vorher mit Integer.MAX_VALUE. Ist die Datei größer als 2.147.483.647 Bytes (knapp 2 GB), wirft die Methode einen OutOfMemoryError mit der Meldung „Required array size too large“. Für readString() gilt dasselbe, denn sie ruft intern readAllBytes() auf.
Auch für kleinere Dateien gibt es gute Gründe, diese nicht komplett in den RAM zu laden:
- Eventuell möchte man die gelesenen Daten so schnell wie möglich weiterverarbeiten, und zwar bevor die Datei komplett geladen wurde.
- Läuft deine Software in Containern oder als „Function-as-a-Service“, könnte Arbeitsspeicher u. U. relativ teuer sein.
Wie du Dateien Stück für Stück einlesen und dabei direkt verarbeiten kannst, wird im folgenden Kapitel beschrieben.
Wie verarbeitet man große Dateien, ohne sie komplett im Arbeitsspeicher halten zu müssen?
Und damit kommen wir zu den Funktionen, die schon vor Java 7 verfügbar waren – also diejenigen, die das „mal eben einlesen“ einer kleinen Datei zu einer komplizierten Angelegenheit gemacht haben.
Lesen großer Binärdateien mit FileInputStream
Im einfachsten Fall lesen wir eine Binärdatei Byte für Byte und verarbeiten diese Bytes weiter. Diese Aufgabe erledigt die Klasse FileInputStream. Im folgenden Beispiel wird sie verwendet, um den Inhalt einer Datei Byte für Byte auf der Konsole auszugeben.
String fileName = ... ;
try (FileInputStream is = new FileInputStream(fileName)) {
  int b;
  while ((b = is.read()) != -1) {
    System.out.println("Byte: " + b);
  }
}
Die Methode FileInputStream.read() liest dabei jeweils ein Byte aus der Datei. Ist das Ende der Datei erreicht, wird -1 zurückgegeben. Die Funktionalität dieser Klasse ist zum größten Teil nativ (also nicht in Java) implementiert, da sie direkt auf die I/O-Funktionalität des Betriebssystems zugreift.
Dieser Zugriff ist teuer: Das Laden einer 100 Millionen Byte großen Testdatei über einen FileInputStream dauert auf meinem System 30 Sekunden. Das sind nur 3,3 MB pro Sekunde.
Alle Zeiten in diesem Kapitel habe ich auf einem Apple M5 Pro unter Java 27 gemessen, als Median aus fünf Läufen und ohne die Konsolenausgabe aus den Beispielen – die würde jede Messung dominieren. Als Testdatei dient enwik8: die ersten 100 Millionen Bytes eines englischen Wikipedia-Dumps von 2006, ein Standard-Testkorpus für Kompressionsverfahren.
Lesen großer Binärdateien mit dem NIO.2 InputStream
Mit der NIO.2 File API in Java 7 kam mit Files.newInputStream() eine zweite Methode hinzu, um einen InputStream zu erzeugen:
String fileName = ...;
try (InputStream is = Files.newInputStream(Path.of(fileName))) {
  int b;
  while ((b = is.read()) != -1) {
    System.out.println("Byte: " + b);
  }
}
Diese Methode liefert einen ChannelInputStream anstatt eines FileInputStreams, da NIO.2 unter der Haube mit sogenannten Channels arbeitet. Schneller wird das Lesen dadurch nicht: In meinen Messungen braucht diese Variante mit 31,5 Sekunden rund 5 % länger als der FileInputStream.
Schneller lesen mit dem BufferedInputStream
Beschleunigt werden kann der Zugriff mit dem BufferedInputStream. Dieser wird sozusagen um den FileInputStream gelegt und lädt die Daten vom Betriebssystem nicht Byte für Byte, sondern in Blöcken von standardmäßig 8 KB und speichert diese zwischen. Die Bytes können dann wiederum nach und nach ausgelesen werden. Dieses Mal aber aus dem Arbeitsspeicher, was um ein Vielfaches schneller geht.
String fileName = ...;
try (FileInputStream is = new FileInputStream(fileName);
     BufferedInputStream bis = new BufferedInputStream(is)) {
  int b;
  while ((b = bis.read()) != -1) {
    System.out.println("Byte: " + b);
  }
}
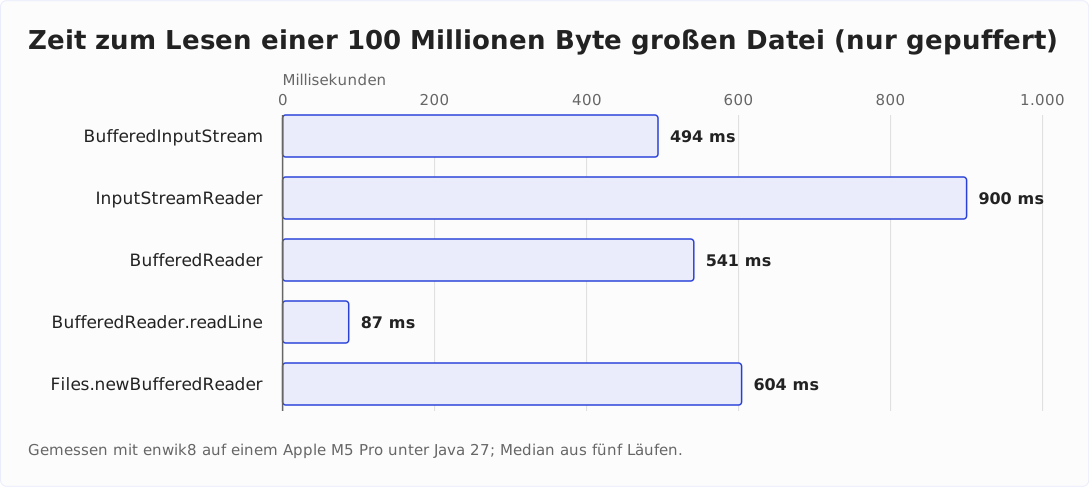
Dieselbe Datei wird durch diesen Code in 494 ms eingelesen – 61-mal schneller als ohne Puffer. Das sind gut 200 MB pro Sekunde.
Man sollte also fast immer einen BufferedInputStream verwenden. Die einzige Ausnahme ist, wenn man die Daten über den FileInputStream nicht Byte für Byte liest, sondern in größeren Blöcken, deren Größe möglichst an die Blockgröße des Dateisystems angepasst ist. Wenn du dir unsicher bist, ob sich der BufferedInputStream für deinen speziellen Einsatzbereich lohnt, dann probier es einfach aus.
Lesen großer Textdateien mit dem FileReader
Textdateien sind letztendlich auch Binärdateien. Beim Laden werden Bytes in Zeichen umgewandelt. Diese Aufgabe übernimmt die Klasse InputStreamReader. Wenn du diese um einen FileInputStream legst, kannst du anstelle von Bytes Zeichen lesen und ausgeben:
String fileName = ...;
try (FileInputStream is = new FileInputStream(fileName);
     InputStreamReader reader = new InputStreamReader(is)) {
  int c;
  while ((c = reader.read()) != -1) {
    System.out.println("Char: " + (char) c);
  }
}
Etwas komfortabler geht es mit dem FileReader: Dieser kombiniert FileInputStream und InputStreamReader, so dass folgender Code entsteht, der äquivalent ist zu dem oben:
String fileName = ...;
try (FileReader reader = new FileReader(fileName)) {
  int c;
  while ((c = reader.read()) != -1) {
    System.out.println("Char: " + (char) c);
  }
}
Der InputStreamReader verwendet intern ebenfalls einen 8-KB-Puffer. Das Einlesen der 100 Millionen Byte großen Textdatei dauert Zeichen für Zeichen 900 ms.
Textdateien schneller lesen mit dem BufferedReader
Der InputStreamReader puffert zwar schon, doch das Einlesen von Texten geht noch schneller – mit dem BufferedReader:
String fileName = ...;
try (FileReader reader = new FileReader(fileName);
     BufferedReader bufferedReader = new BufferedReader(reader)) {
  int c;
  while ((c = bufferedReader.read()) != -1) {
    System.out.println("Char: " + (char) c);
  }
}
Dadurch sinkt die Zeit für das Einlesen der Testdatei von 900 ms auf 541 ms. Dies erreicht der BufferedReader, indem er dem 8-KB-Puffer des InputStreamReaders noch einen Puffer für 8.192 dekodierte Zeichen zur Seite stellt.
Ein weiterer Vorteil des BufferedReader ist, dass dieser die zusätzliche Methode readLine() anbietet, mit der du die Textdatei nicht nur Zeichen für Zeichen, sondern auch Zeile für Zeile einlesen und verarbeiten kannst:
String fileName = ...;
try (FileReader reader = new FileReader(fileName);
     BufferedReader bufferedReader = new BufferedReader(reader)) {
  String line;
  while ((line = bufferedReader.readLine()) != null) {
    System.out.println("Line: " + line);
  }
}
Das Einlesen kompletter Zeilen reduziert die Gesamtzeit für das Einlesen der Testdatei weiter auf 87 ms – noch einmal gut sechsmal schneller als zeichenweise. Der Grund: Es fällt nur noch pro Zeile ein Methodenaufruf an – statt pro Zeichen.
Textdateien schneller lesen mit dem NIO.2 BufferedReader
Die NIO.2 File API bietet mit Files.newBufferedReader() eine Methode, um direkt einen BufferedReader zu erzeugen:
String fileName = ...;
try (BufferedReader reader = Files.newBufferedReader(Path.of(fileName))) {
  int c;
  while ((c = reader.read()) != -1) {
    System.out.println("Char: " + (char) c);
  }
}
Der so erzeugte BufferedReader liegt mit 604 ms in derselben Größenordnung wie der „klassisch“ erstellte mit 541 ms.
Übersicht Performance
Das folgende Diagramm zeigt noch einmal alle vorgestellten Methoden und die Zeit, die diese jeweils für das Einlesen einer 100 Millionen Byte großen Datei benötigen:
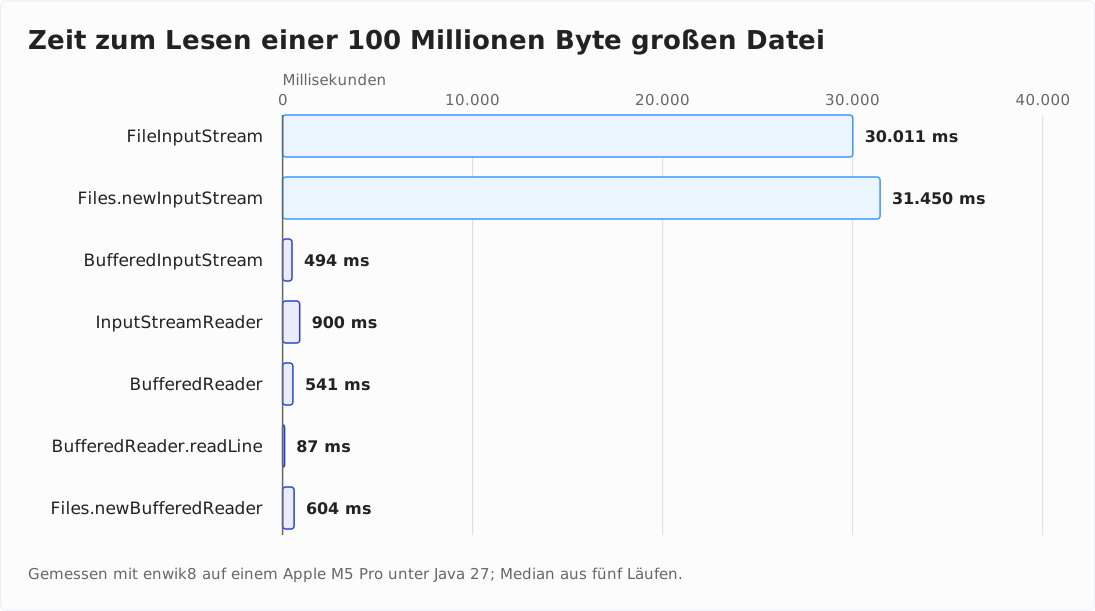
Der Abstand zu den ungepufferten Methoden ist so groß, dass die Balken der fünf gepufferten Methoden oben kaum zu erkennen sind. Daher hier ein zweites Diagramm, das nur die gepufferten Methoden zeigt:
Übersicht FileInputStream, FileReader, InputStreamReader, BufferedInputStream, BufferedReader
In den letzten Abschnitten wurden zahlreiche Klassen zum Lesen von Dateien aus dem java.io-Paket vorgestellt. Die folgende Grafik zeigt dir noch einmal den Zusammenhang all dieser Klassen. Falls dieses Thema neu für dich ist, hilft es hier immer wieder einmal draufzuschauen.
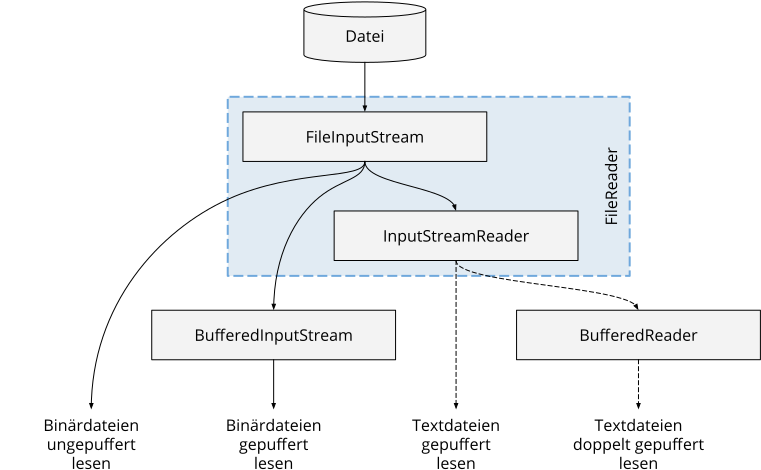
Die durchgezogenen Linien stellen den Fluss von Binärdaten dar, die gestrichelten Linien zeigen den Fluss von Zeichen-Daten, also Characters oder Strings. Der FileReader ist die Kombination aus FileInputStream und InputStreamReader.
Betriebssystem-Unabhängigkeit
Im letzten Kapitel haben wir sorglos Textdateien eingelesen. Leider ist es nicht immer ganz so einfach: Zeichenkodierungen, Zeilenumbrüche und Pfad-Trennzeichen machen auch erfahrenen Programmierer:innen immer wieder das Leben schwer.
Zeichenkodierung
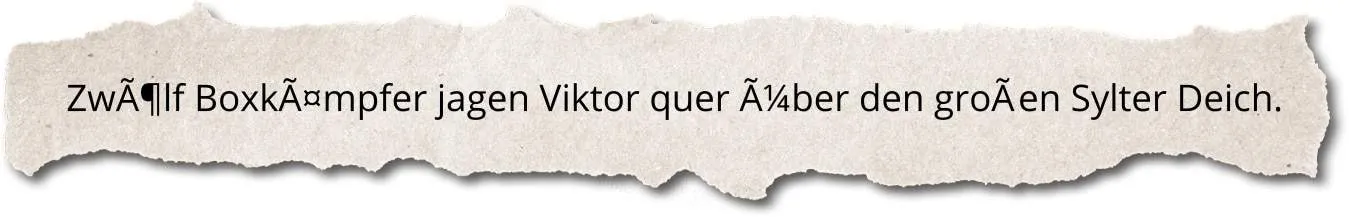
Hast du schon einmal Folgendes gesehen?
Oder so etwas?
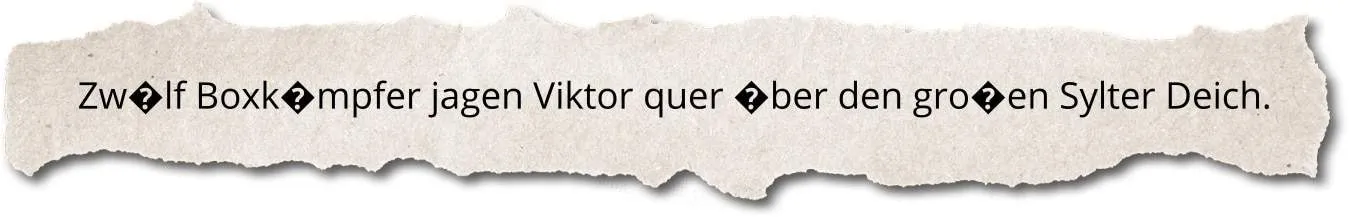
Das nennt sich Mojibake und passiert, wenn beim Lesen und Schreiben einer Datei unterschiedliche Zeichenkodierungen verwendet werden.
Bei der Vorstellung der Klasse InputStreamReader habe ich kurz erwähnt, dass diese die eingelesenen Bytes (Zahlen) in Zeichen (Buchstaben, Sonderzeichen, etc.) umwandelt. Die sogenannte Zeichenkodierung bestimmt, welches Zeichen durch welche Zahl kodiert wird.
Bei UTF-8 werden die ersten 128 Zeichen (also z. B. „A“ bis „Z“, „a“ bis „z“ und „0“ bis „9“) durch die gleichen Bytes dargestellt wie in ASCII. Das ist der Grund, warum diese Zeichen – auch bei falsch eingestellter Kodierung – immer lesbar sind. Deutsche Umlaute hingegen werden durch jeweils zwei Bytes repräsentiert.
Genau daran scheitern die beiden Beispiele oben. Die folgende Grafik zeigt dir für das „ö“, welche Bytes in der Datei stehen und was ein Reader daraus macht, der die falsche Kodierung annimmt – einmal in jede Richtung:
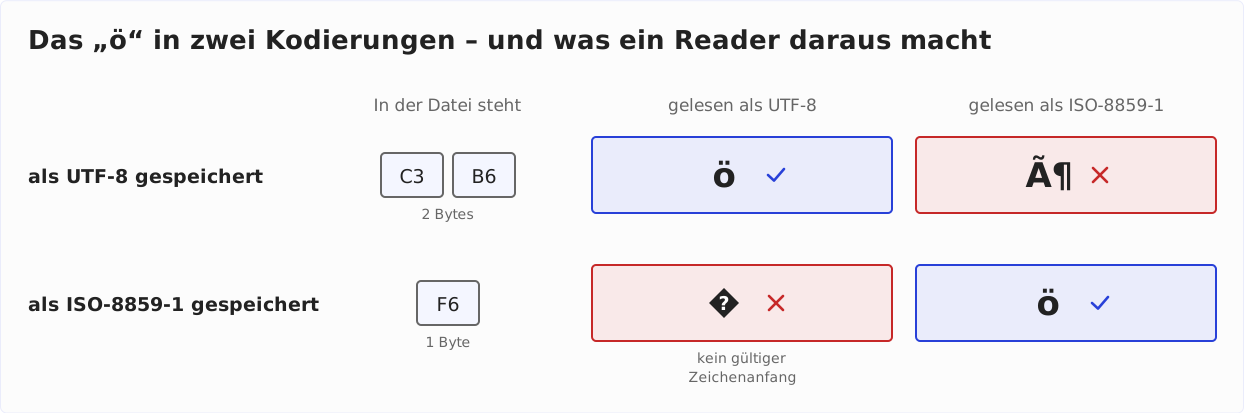
Im ersten Beispiel habe ich den Text als UTF-8 gespeichert und als ISO-8859-1 geladen: Aus den zwei Bytes des „ö“ werden zwei einzelne Zeichen. Im zweiten Beispiel war es umgekehrt – und dort ergibt das eine Byte des „ö“ in UTF-8 keinen gültigen Zeichenanfang. Der InputStreamReader setzt dafür das Unicode-Ersatzzeichen U+FFFD ein, das die meisten Schriftarten als Raute mit Fragezeichen zeichnen.
Es muss also sichergestellt werden, dass beim Einlesen einer Datei dieselbe Zeichenkodierung verwendet wird wie beim Speichern.
Welche Zeichenkodierung verwendet Java standardmäßig zum Lesen von Textdateien?
Gibt man (wie in den vorangegangenen Beispielen) keine Zeichenkodierung an, wird eine Standard-Kodierung verwendet. Welche das ist, hat sich mit Java 18 geändert.
Seit Java 18 ist die Antwort einfach: Es ist immer UTF-8. JEP 400 hat UTF-8 zur Standard-Kodierung aller Standard-APIs gemacht – unabhängig von Betriebssystem, Locale und Konfiguration.
Bis einschließlich Java 17 hing die Antwort dagegen davon ab, welche Methode du verwendet hast:
FileReaderundInputStreamReaderverwendeten ohne AngabeCharset.defaultCharset(). Diese Kodierung leitete die JVM aus Betriebssystem und Locale ab: auf einem deutschen Windows in der Regel Windows-1252, auf Linux und macOS meist UTF-8. Derselbe Code lieferte also je nach Rechner ein anderes Ergebnis.Files.readString(),Files.readAllLines(),Files.lines()undFiles.newBufferedReader()verwendeten dagegen von Anfang an UTF-8.
Genau diese Uneinheitlichkeit war der Grund für JEP 400. Sie ist auch der Grund, warum du beim Umstieg auf Java 18 oder neuer hinsehen solltest: Liest dein Programm über einen FileReader Dateien, die in Windows-1252 geschrieben wurden, lief das auf einem deutschen Windows bis Java 17 – und geht seit Java 18 schief. Für solche Fälle holt die System-Property -Dfile.encoding=COMPAT das alte Verhalten zurück.
Was heißt das für deinen Code? Läuft er auf Java 18 oder neuer und liest er UTF-8-Dateien, brauchst du die Kodierung nicht mehr anzugeben. Ein StandardCharsets.UTF_8 hinter jedem Aufruf ist dann nur noch Rauschen und sagt nichts, was nicht ohnehin gilt.
Explizit wird es in zwei Fällen: Dein Code muss auch auf Java 17 oder älter laufen – oder die Datei ist nicht UTF-8. Dann gehört die Kodierung in den Aufruf, und zwar in jeden.
Wie gebe ich die Zeichenkodierung beim Lesen einer Textdatei an?
Alle bisher vorgestellten Methoden bieten eine Variante an, bei der die Zeichenkodierung mit übergeben werden kann. Die Kodierung wird als Objekt der Klasse Charset übergeben. Konstanten für Standard-Kodierungen findet man in der Klasse StandardCharsets. Im Folgenden findest du alle Methoden mit explizit angegebener Kodierung – hier am Beispiel von UTF-8:
Files.readString(path, StandardCharsets.UTF_8)Files.readAllLines(path, StandardCharsets.UTF_8)Files.lines(path, StandardCharsets.UTF_8)new FileReader(file, StandardCharsets.UTF_8)– diesen Konstruktor gibt es erst seit Java 11new InputStreamReader(is, StandardCharsets.UTF_8)Files.newBufferedReader(path, StandardCharsets.UTF_8)
Zeilenumbrüche
Eine weitere Hürde beim Laden von Textdateien ist die Tatsache, dass unter Windows Zeilenumbrüche anders kodiert werden als unter Linux und macOS.
- Unter Linux und macOS wird ein Zeilenumbruch durch das „Line Feed“-Zeichen (Escape-Sequenz „\n“, ASCII-Code 10, hexadezimal
0A) dargestellt. - Windows benutzt die Kombination „Carriage Return“+„Line Feed“ (Escape-Sequenz „\r\n“, ASCII-Codes 13 und 10, bzw. hexadezimal
0D0A).
Glücklicherweise können heutzutage die meisten Programme mit beiden Kodierungen umgehen. Das war nicht immer so. Früher passierte es beim Austausch von Textdateien zwischen verschiedenen Betriebssystemen regelmäßig, dass entweder alle Zeilenumbrüche verschwanden und der komplette Text in einer Zeile stand, oder aber dass am Ende jeder Zeile ein Sonderzeichen erschien.
Wenn du mit Files.readAllLines() oder Files.lines() eine Textdatei zeilenweise einliest, erkennt Java die Zeilenumbrüche automatisch richtig. Möchtest du einen Text mit eigenem Programmcode in Zeilen aufsplitten, kannst du das wie folgt mit String.split() machen:
String[] lines = text.split("\r?\n");Beim Schreiben von Dateien (s. Artikel „Dateien schnell und einfach schreiben“) empfehle ich grundsätzlich die Linux-Variante zu verwenden, da heutzutage so gut wie jedes Windows-Programm (seit 2018 sogar Notepad!) damit umgehen kann.
Beim Erstellen eines formatierten Strings mit String.format() musst du darauf achten, wie du den Zeilenumbruch angibst:
String.format("Hallo%n")fügt einen Betriebssystem-spezifischen Zeilenumbruch ein. Das Ergebnis unterscheidet sich also je nach Betriebssystem, auf dem dein Programm ausgeführt wird.String.format("Hallo\n")fügt unabhängig vom Betriebssystem immer einen Linux-Zeilenumbruch ein.
Du kannst das mit folgendem Programm ausprobieren:
public class LineBreaks {
  public static void main(String[] args) {
    System.out.println(String.format("Hallo%n").length());
    System.out.println(String.format("Hallo\n").length());
  }
}
Unter Linux und macOS gibt es 6 und 6 aus. Unter Windows hingegen 7 und 6, da der mit „%n“ für Windows generierte Zeilenumbruch aus einem Zeichen mehr besteht.
Falls du den Zeilentrenner des aktuellen Systems benötigst, erhältst du diesen über System.lineSeparator().
Pfadnamen
Auch bei Pfadnamen müssen wir Unterschiede zwischen den Betriebssystemen berücksichtigen. Während unter Windows absolute Pfade mit einem Laufwerksbuchstaben und einem Doppelpunkt (z. B. „C:“) beginnen und Verzeichnisse durch einen Backslash („\“) getrennt werden, werden diese unter Linux und macOS durch einen regulären Schrägstrich („/“) getrennt, welcher auch am Anfang von absoluten Pfaden steht.
Beispielsweise lautet der Pfad meiner Maven-Konfigurationsdatei:
- ... unter Windows:
C:\Users\sven\.m2\settings.xml - ... unter Linux:
/home/sven/.m2/settings.xml
Das im aktuellen Betriebssystem verwendete Trennzeichen bekommst du über die Konstante File.separator oder die Methode FileSystems.getDefault().getSeparator().
Im Normalfall solltest du das Trennzeichen nicht direkt benötigen. Java stellt dir die Klassen java.io.File und, ab Java 7, java.nio.file.Path zur Verfügung, um Verzeichnis- und Dateipfade zu konstruieren, ohne das Trennzeichen angeben zu müssen.
An dieser Stelle gehe ich nicht weiter ins Detail. Datei- und Verzeichnisnamen, relative und absolute Pfadangaben, alte API und NIO.2 machen die Thematik komplex. Ich behandle sie deshalb in einem eigenen Artikel: Dateinamen und Verzeichnisnamen mit File, Path und Paths.
Zusammenfassung und Ausblick
In diesem Artikel hast du verschiedene Methoden kennengelernt, um in Java Text- und Binärdateien zu lesen. Außerdem haben wir uns angesehen, was zu beachten ist, wenn deine Software auch auf anderen Betriebssystemen als deinem lauffähig sein soll.
Wenn du dir aus dem Artikel drei Regeln mitnimmst, dann diese:
- Kleine Dateien liest du mit einem Einzeiler:
Files.readString()für Text,Files.readAllBytes()für Binärdaten,Files.readAllLines()für Text in Zeilen. - Große Dateien liest du gepuffert und verarbeitest sie dabei:
BufferedReader.readLine()für Text,BufferedInputStreamfür Binärdaten. Ungepuffert Byte für Byte zu lesen, kostet dich den Faktor 61. - Die Zeichenkodierung gibst du seit Java 18 nur noch an, wenn die Datei nicht UTF-8 ist oder dein Code auch auf Java 17 und älter laufen muss. Sonst ist UTF-8 der Standard, und die Angabe wäre Rauschen.
Im zweiten Teil wirst du die entsprechenden Methoden zum Schreiben von Dateien in Java kennenlernen.
Im Anschluss daran werden folgende Themen behandelt:
- Konstruieren von Datei- und Verzeichnispfaden mit den Klassen
File,PathundPaths - Verzeichnis-Operationen, wie z. B. das Einlesen der Dateiliste eines Verzeichnisses
- Kopieren, Verschieben und Löschen von Dateien
- Erstellen von temporären Dateien
- Laden und Schreiben strukturierter Daten mit
DataOutputStreamundDataInputStream
Und zum Abschluss der Serie kommen wir zu fortgeschrittenen Themen:
- Die in Java 1.4 eingeführten NIO-Channels und Buffer, um insbesondere das Arbeiten mit großen Dateien zu beschleunigen
- Memory-mapped I/O für rasend schnellen Dateizugriff ohne Streams
- File Locking, um parallel – also aus mehreren Threads oder Prozessen – konfliktfrei auf dieselben Dateien zuzugreifen
Wenn dir dieser Artikel gefallen hat, freue ich mich über eine Bewertung auf meinem ProvenExpert-Profil.