In diesem Artikel lernst du den Sortieralgorithmus „Radix Sort“ kennen. Du erfährst:
- Wie funktioniert Radix Sort? (Schritt für Schritt)
- Wie implementiert man Radix Sort in Java?
- Welche Zeit- und Platzkomplexität hat Radix Sort?
- Welche Varianten gibt es von Radix Sort?
- … und was bedeutet überhaupt der Begriff „Radix“?
Fangen wir mit der letzten Frage an:
Was ist Radix Sort?
„Radix“ ist zwar das lateinische Wort für „Wurzel“ – dennoch hat Radix Sort nichts mit Wurzelziehen zu tun.
Die „Radix“ eines Zahlensystems (auch „Basis“ genannt) bezeichnet vielmehr die Anzahl der verschiedenen Ziffern (Ziffernsymbole), mit denen Zahlen in diesem Zahlensystem dargestellt werden. Die Radix im Dezimalsystem ist 10, die Radix des Binärsystems ist 2, und die Radix des Hexadezimalsystems ist 16.
Bei Radix Sort sortieren wir die Zahlen Ziffer für Ziffer – und nicht, wie bei den meisten anderen Sortierverfahren, indem wir zwei Zahlen miteinander vergleichen. Wie genau das funktioniert, liest du im folgenden Kapitel.
Radix Sort Algorithmus
Den Algorithmus für Radix Sort erkläre ich am besten Schritt für Schritt an einem Beispiel. Folgende Zahlen sollen sortiert werden:

Wir betrachten zu Beginn ausschließlich die letzte Ziffer (es gibt auch Radix-Sort-Varianten, bei denen man bei der ersten Ziffer beginnt, aber dazu kommen wir später):

Wir sortieren die Zahlen in zwei Phasen: einer Partitionierungsphase und einer Sammelphase.
Partitionierungsphase
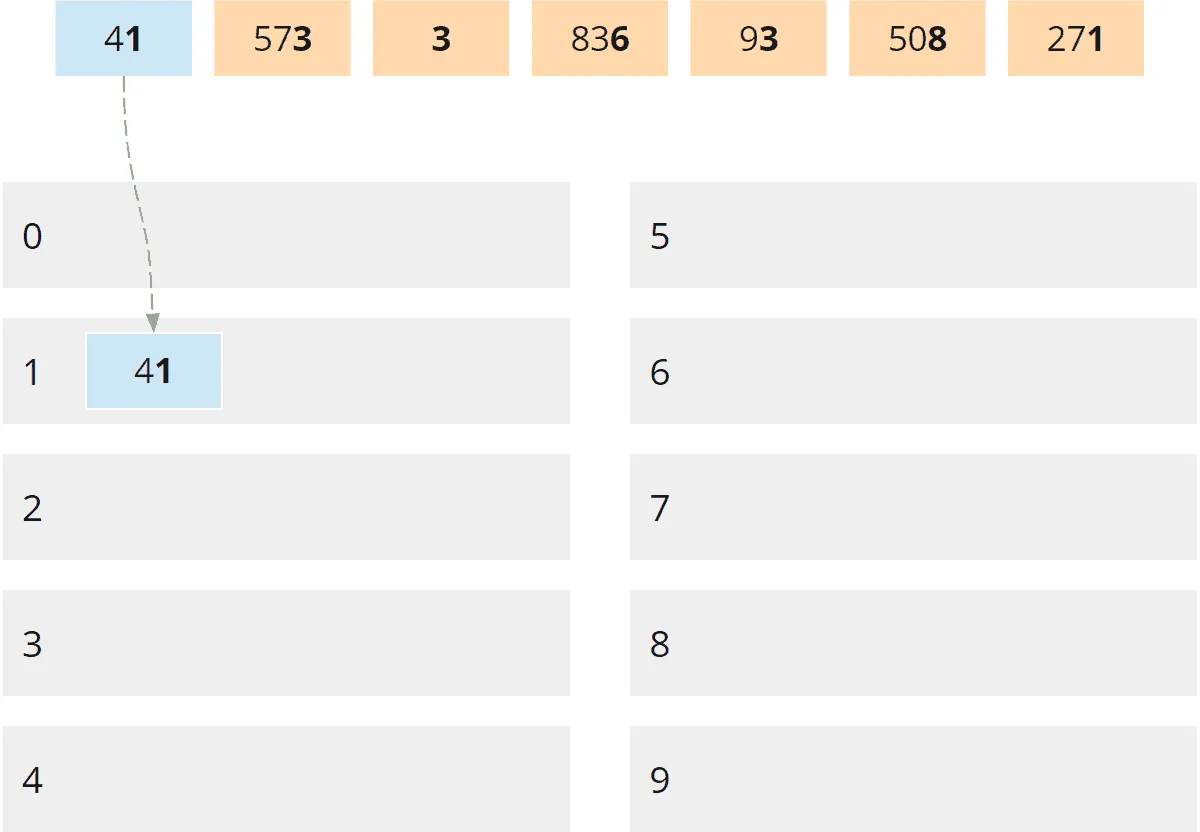
Für die Partitionierung legen wir zehn sogenannte „Buckets“ an, bezeichnet mit „0“ bis „9“. Auf diese verteilen wir die Zahlen entsprechend ihrer jeweils letzten Ziffer. Die folgende Grafik demonstriert, wie wir die erste Zahl, die 41, in den Bucket „1“ legen:
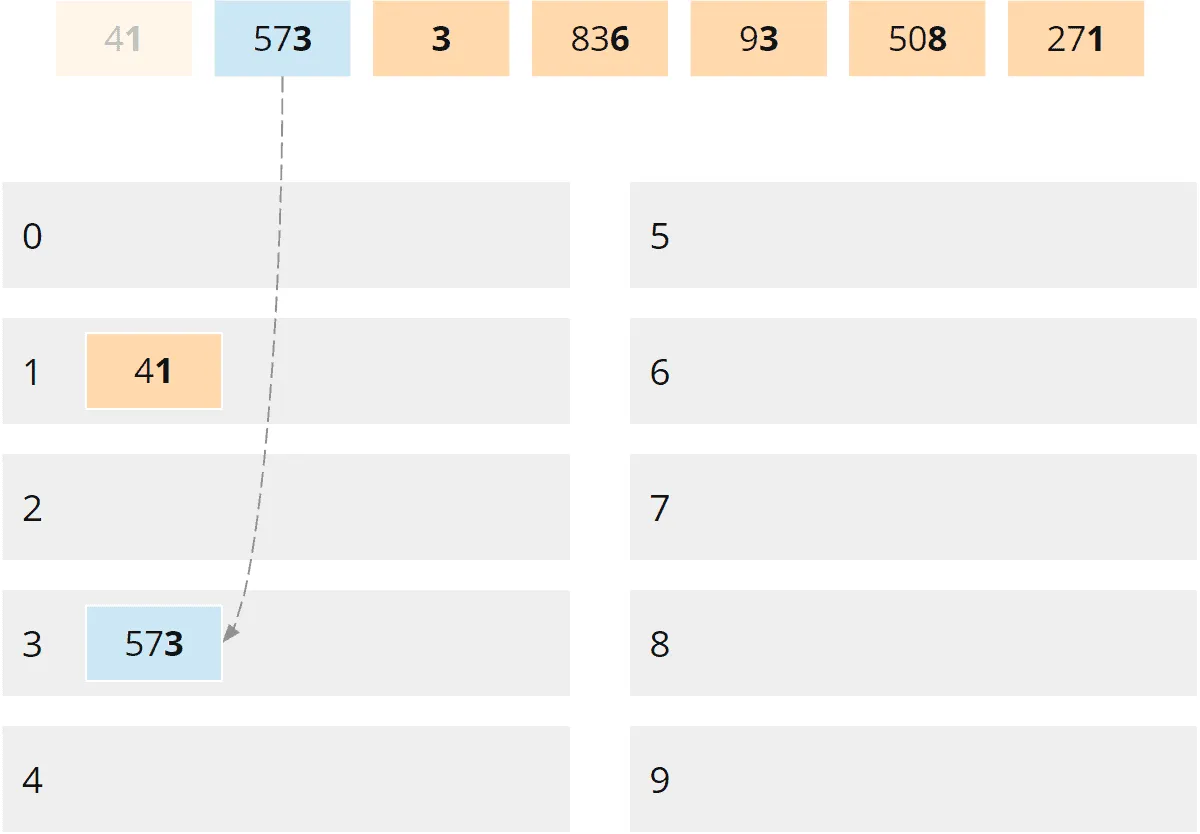
Die zweite Zahl, die 573, legen wir, entsprechend ihrer letzten Ziffer, in den Bucket „3“:
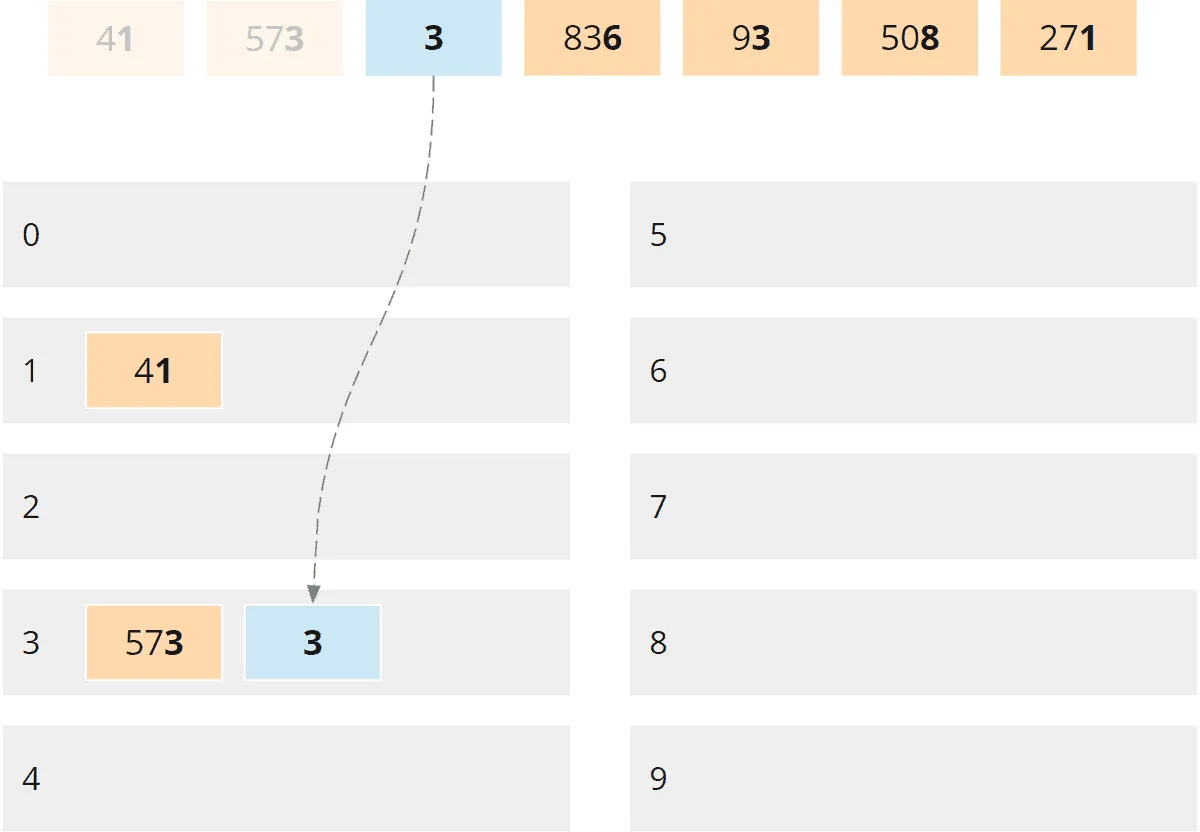
Die dritte Zahl, die 3, legen wir ebenfalls in den Bucket „3“:
Auf die gleiche Art verteilen wir auch die restlichen Zahlen auf die Buckets:
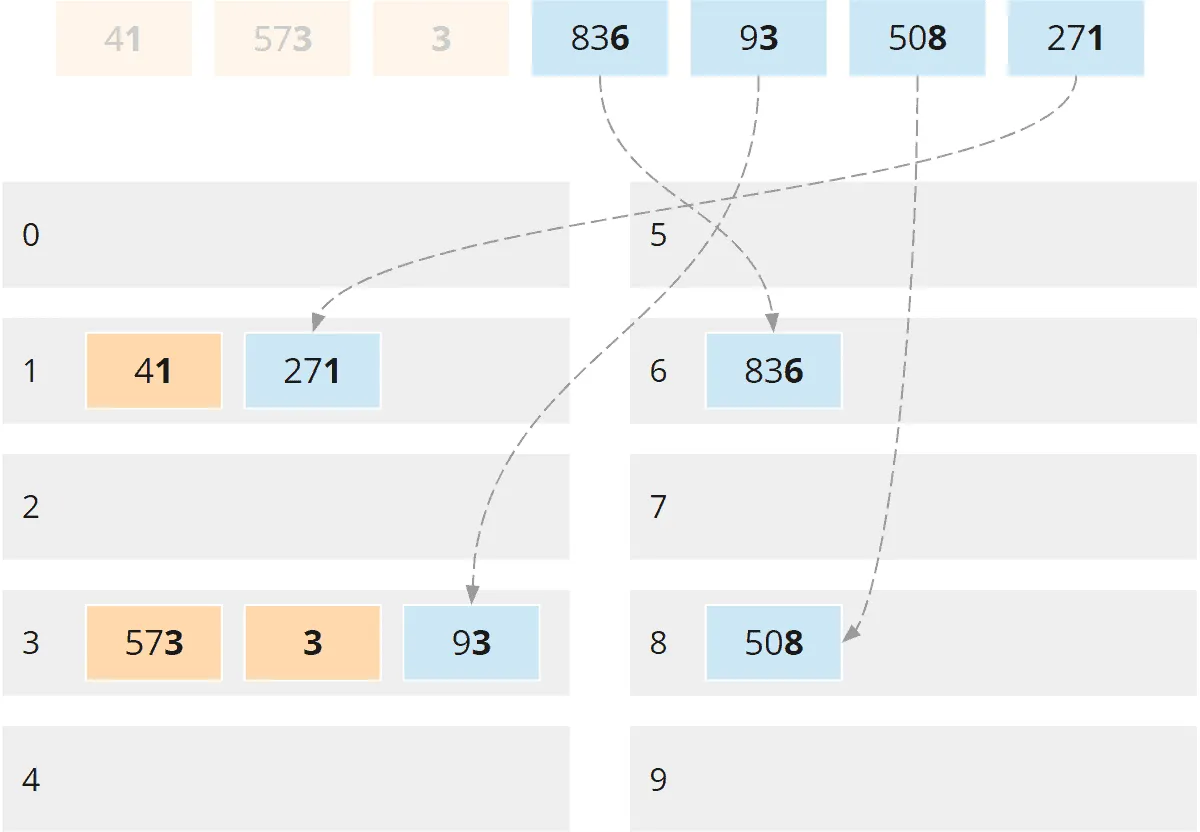
Die Partitionierungsphase für die letzte Ziffer ist damit abgeschlossen.
Sammelphase
An die Partitionierungsphase schließt sich die Sammelphase an. Wir sammeln die Zahlen, Bucket für Bucket, in aufsteigender Reihenfolge – und innerhalb der Buckets von links nach rechts (also in der Reihenfolge, in der die Zahlen in den jeweiligen Bucket eingetragen wurden) – in eine neue Liste.
Wir beginnen mit dem Bucket mit der kleinsten Ziffer, also Bucket 1:
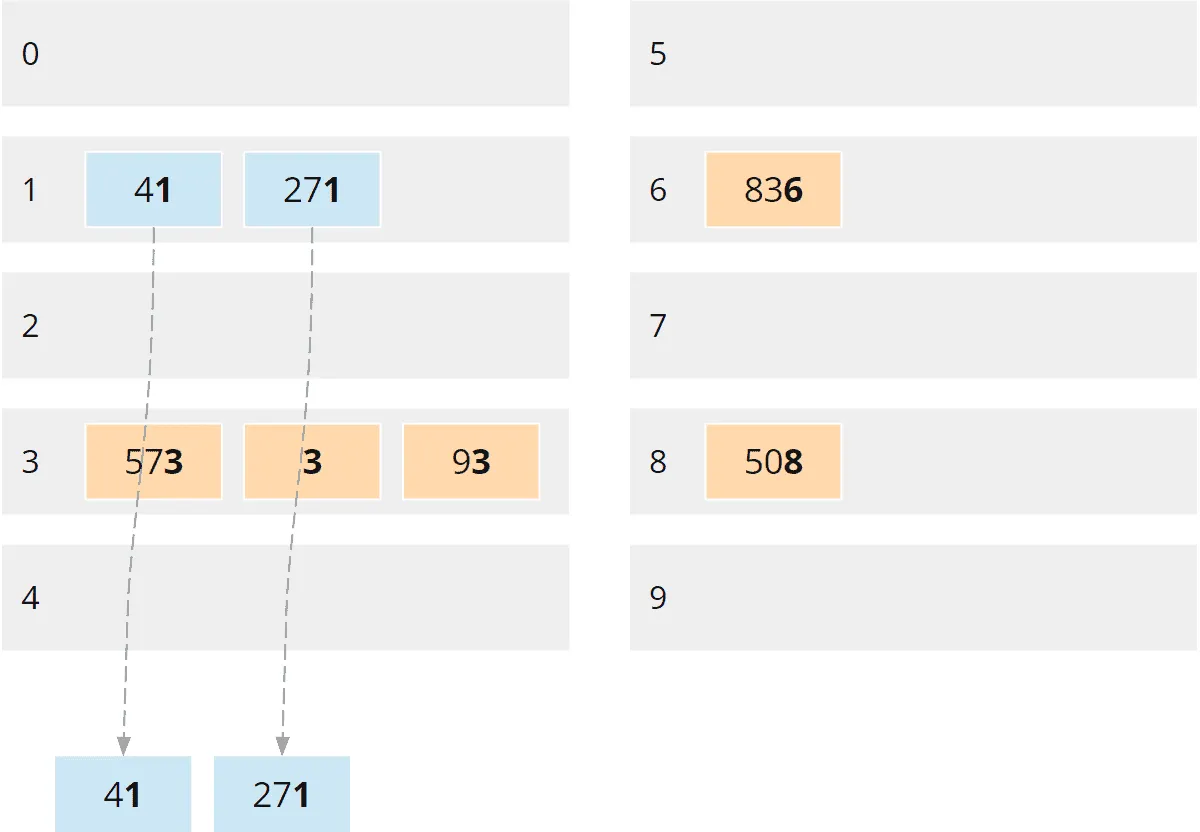
Danach sammeln wir die Zahlen des nächsthöheren Buckets, also Bucket 3:
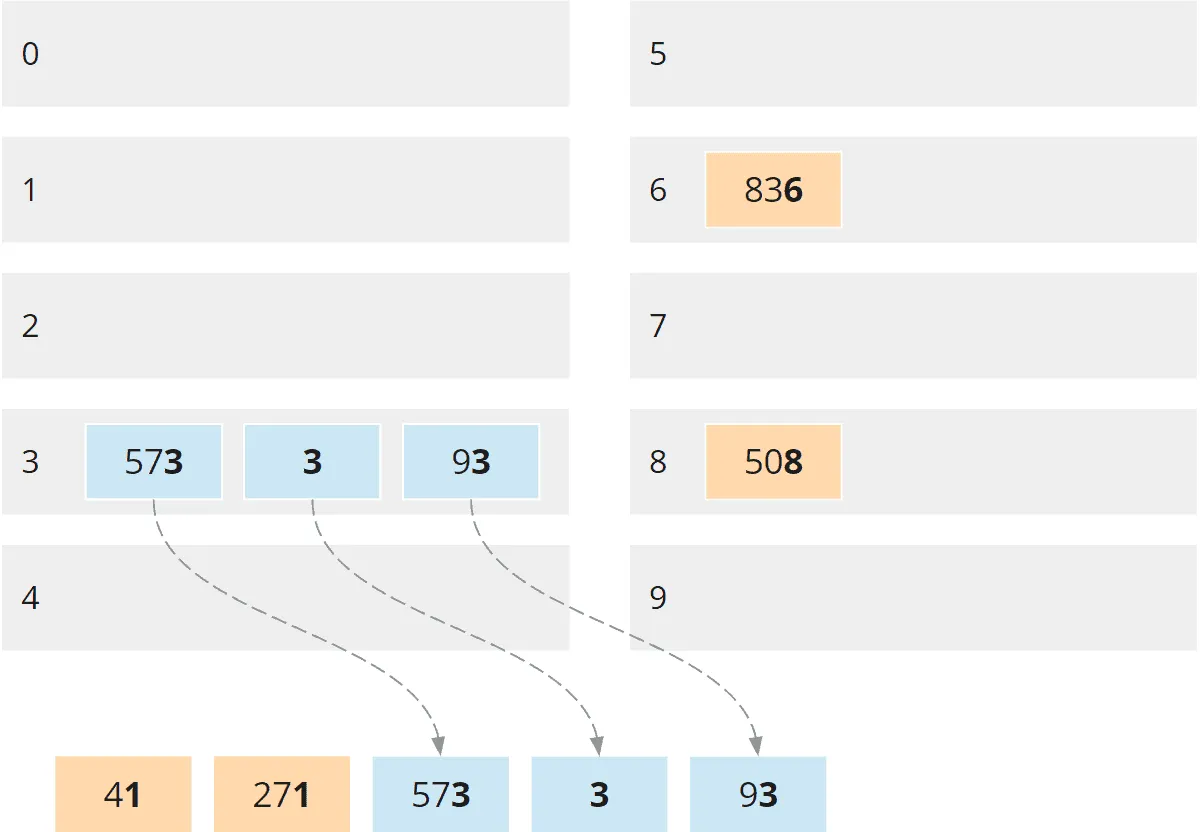
Und schließlich die Zahlen aus Bucket 6 und dann Bucket 8:
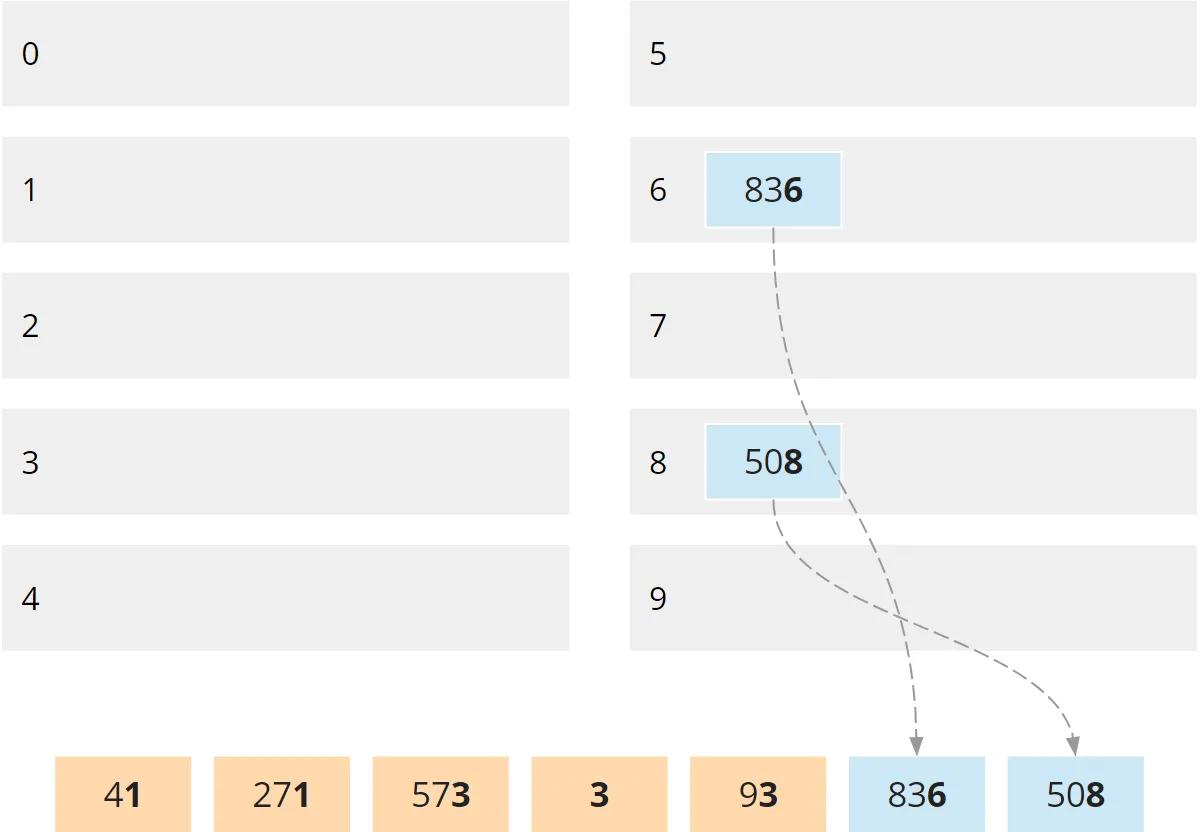
Alle Buckets sind nun geleert:
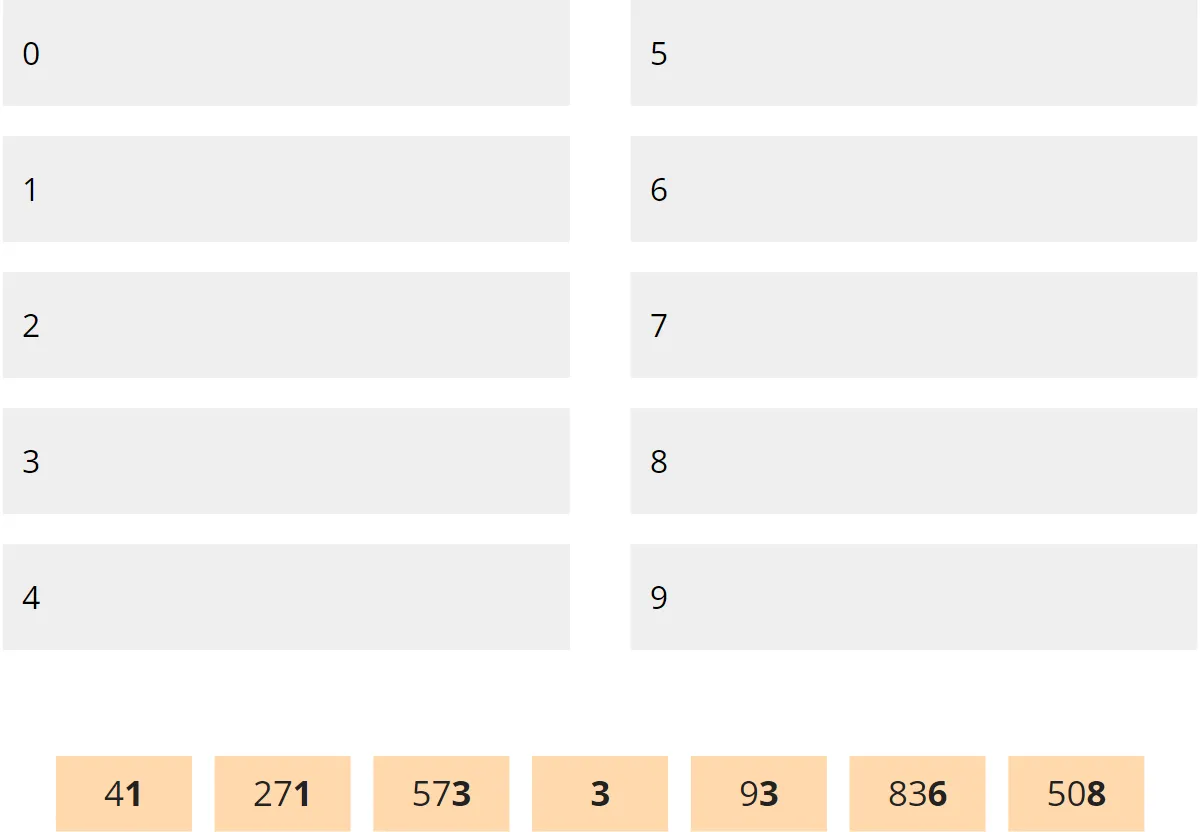
In dieser neuen Liste sind die Zahlen nach ihrer letzten Ziffer aufsteigend sortiert: 1, 1, 3, 3, 3, 6, 8.
Nach Zehnerstelle sortieren
Wir wiederholen die Partitionierungs- und Sammelphase für die Zehnerstelle. Die zwei Phasen stelle ich dieses Mal mit nur jeweils einer Grafik dar.
In der Partitionierungsphase verteilen wir die Zahlen nach ihrer Zehnerstelle auf die Buckets:
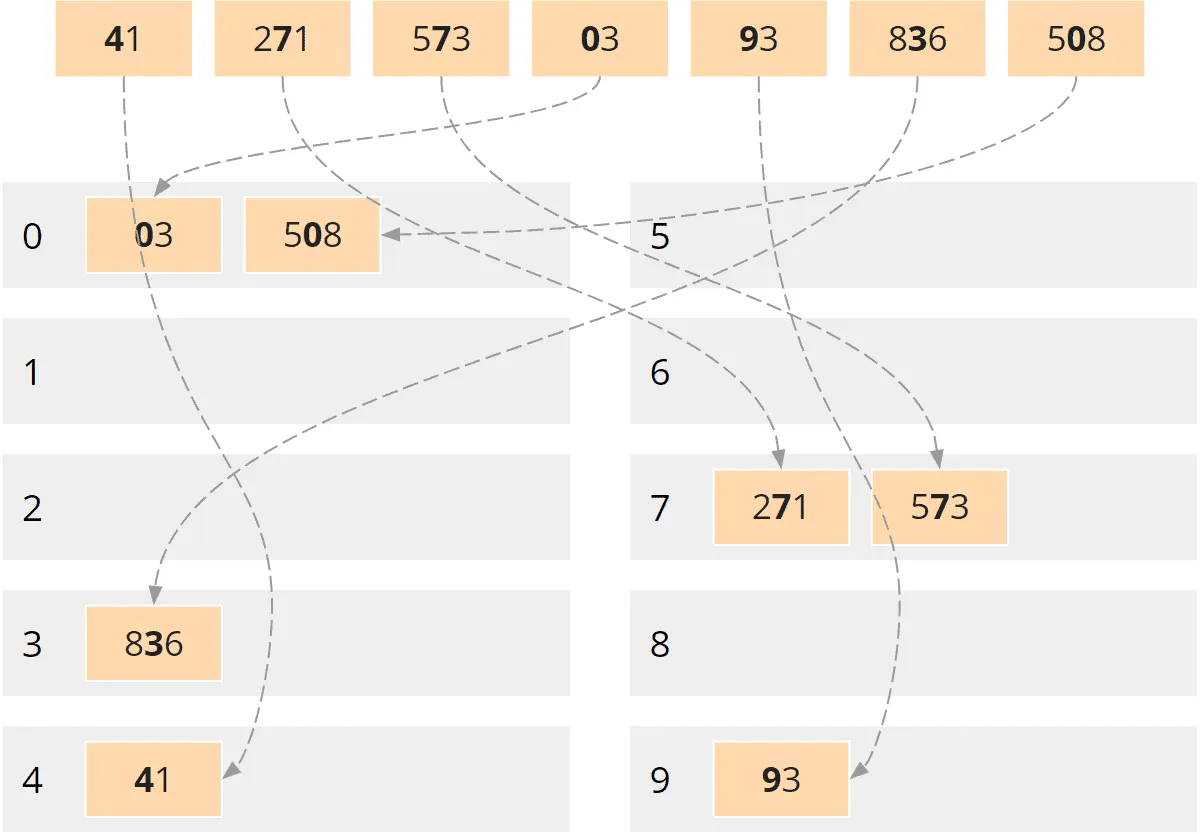
Die Zehnerstelle von einstelligen Zahlen ist die Null. Dementsprechend habe ich die Drei als „03“ dargestellt.
In der Sammelphase entnehmen wir die Zahlen wieder Bucket für Bucket:
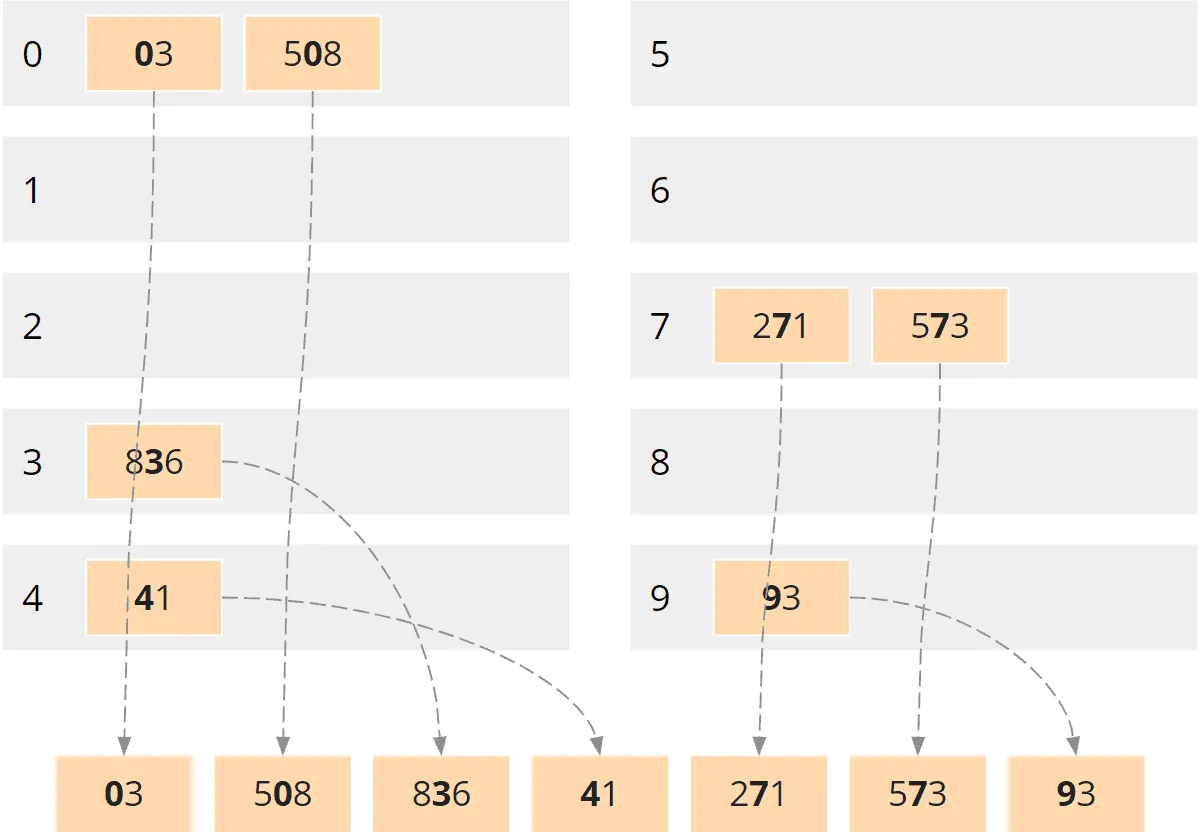
Die Zahlen sind nun nach ihren jeweils zwei letzten Ziffern sortiert: 3, 8, 36, 41, 71, 73, 93.
Nach Hunderterstelle sortieren
Die gleiche Prozedur wiederholen wir für die Hunderterstelle. Zunächst die Partitionierungsphase:
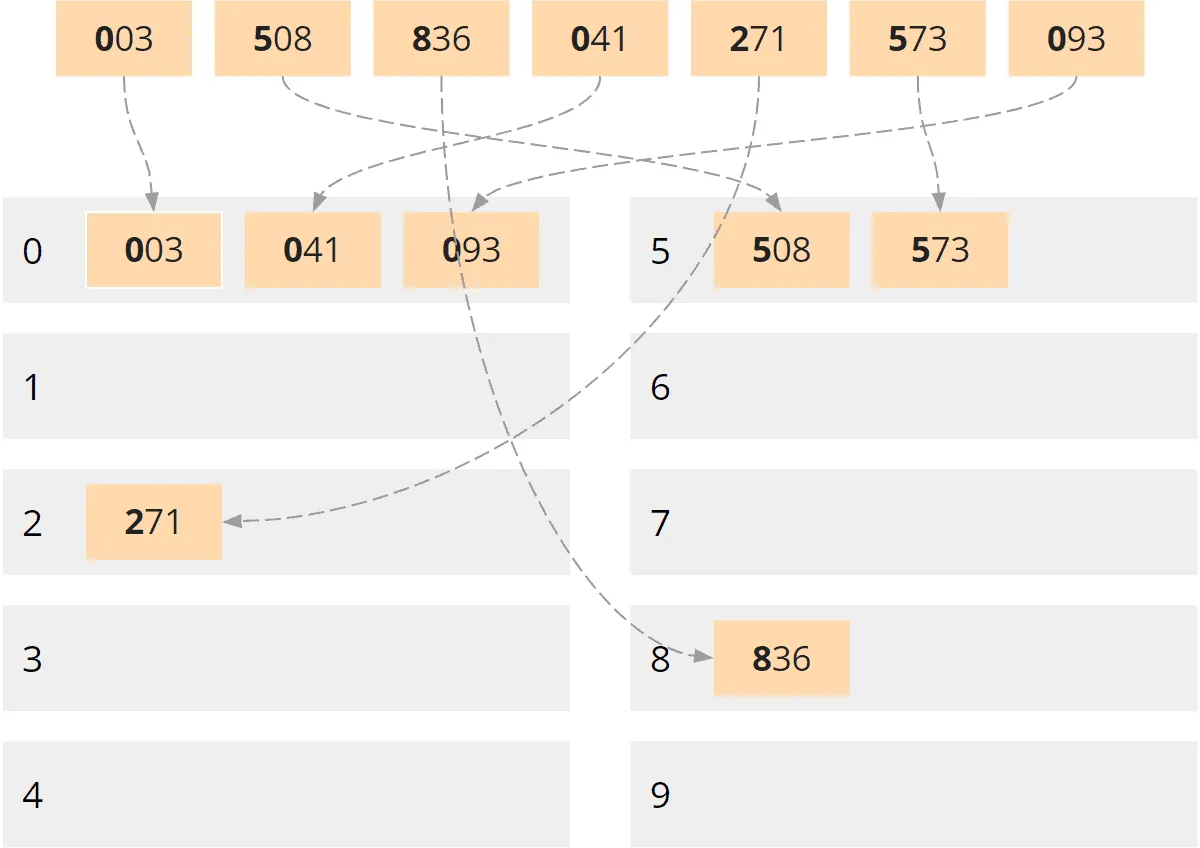
Und im Anschluss die Sammelphase:
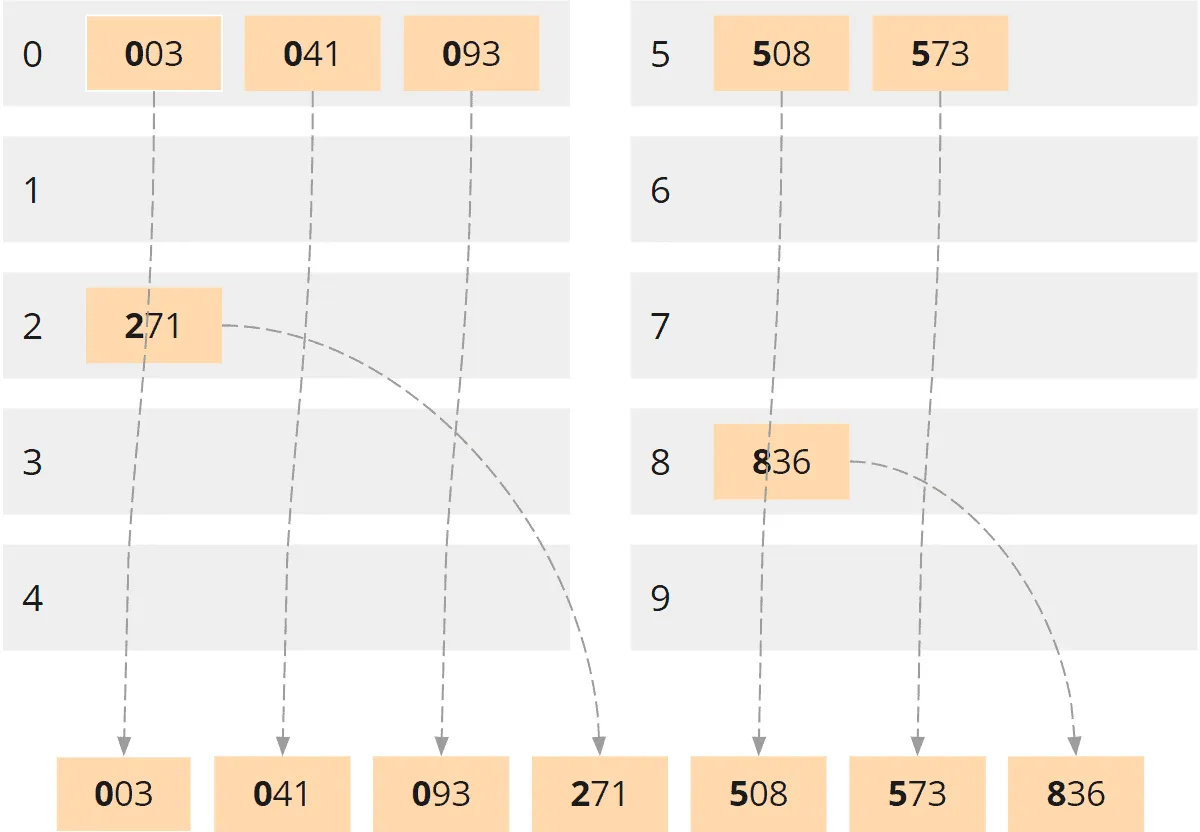
Nach der dritten und letzten Sammelphase sind die Zahlen nun vollständig sortiert.
Hier noch einmal das Endergebnis ohne führende Nullen:

Im nächsten Kapitel kommen wir zur Implementierung von Radix Sort.
Radix Sort in Java
Radix Sort kann auf verschiedene Weisen implementiert werden. Wir beginnen mit einer einfachen Variante, die sich sehr nah am beschriebenen Algorithmus orientiert. Danach zeige ich dir zwei alternative Implementierungen.
Variante 1: Radix Sort mit dynamischen Listen
Wir fangen mit einer leeren sort()-Methode an und füllen diese Schritt für Schritt.
public class RadixSortWithDynamicLists {

  public void sort(int[] elements) {
    // We will implement this method step by step...
  }

}
Da wir die zwei Phasen (Partitionierungsphase und Sammelphase) für jede Ziffer wiederholen müssen, müssen wir zunächst einmal feststellen, wie viele Ziffern unsere Zahlen überhaupt haben.
Das tun wir, indem wir die größte Zahl aus dem zu sortierenden Array ermitteln und danach zählen, wie oft wir sie durch 10 teilen können, bis sie einstellig ist – plus eins:
public class RadixSortWithDynamicLists {

  public void sort(int[] elements) {
    int max = getMaximum(elements);
    int numberOfDigits = getNumberOfDigits(max);

    // TODO: Implement the partitioning and collection phases
  }

  private int getMaximum(int[] elements) {
    int max = 0;
    for (int element : elements) {
      if (element > max) {
        max = element;
      }
    }
    return max;
  }

  private int getNumberOfDigits(int number) {
    int numberOfDigits = 1;
    while (number >= 10) {
      number /= 10;
      numberOfDigits++;
    }
    return numberOfDigits;
  }

}Danach sortieren wir Ziffer für Ziffer. Dazu schreiben wir eine for-Schleife mit der Schleifenvariable digitIndex, wobei 0 für die Einerstelle steht, 1 für die Zehnerstelle, 2 für die Hunderterstelle usw.
public void sort(int[] elements) {
  int max = getMaximum(elements);
  int numberOfDigits = getNumberOfDigits(max);

  for (int digitIndex = 0; digitIndex < numberOfDigits; digitIndex++) {
    // TODO: Sort elements by digit at 'digitIndex'
  }
}
Für den nächsten Schritt benötigen wir die Buckets, auf die wir die Zahlen verteilen können. Wir könnten hierfür zehn ArrayLists verwenden.
Eleganter ist es jedoch, diese in eine Bucket-Klasse zu wrappen. Das macht zum einen den Code lesbarer; zum anderen ermöglicht es uns später, die Implementierung der Buckets zu ändern, ohne den restlichen Code anpassen zu müssen.
Die Bucket-Klasse können wir als statische verschachtelte Klasse (static nested class) innerhalb der Klasse RadixSortWithDynamicLists anlegen:
private static class Bucket {
  private final List<Integer> elements = new ArrayList<>();

  private void add(int element) {
    elements.add(element);
  }

  private List<Integer> getElements() {
    return elements;
  }
}
Das war die Vorbereitung.
Kommen wir zur Partitionierungsphase. Wir benötigen zehn Buckets, auf die wir die Zahlen verteilen können; diese generieren wir mit einer createBuckets()-Methode:
private Bucket[] createBuckets() {
  Bucket[] buckets = new Bucket[10];
  for (int i = 0; i < 10; i++) {
    buckets[i] = new Bucket();
  }
  return buckets;
}
Danach verteilen wir unsere Zahlen anhand der aktuell betrachteten Stelle digitIndex auf die Buckets:
private void distributeToBuckets(int[] elements, int digitIndex, Bucket[] buckets) {
  int divisor = calculateDivisor(digitIndex);

  for (int element : elements) {
    int digit = element / divisor % 10;
    buckets[digit].add(element);
  }
}

private int calculateDivisor(int digitIndex) {
  int divisor = 1;
  for (int i = 0; i < digitIndex; i++) {
    divisor *= 10;
  }
  return divisor;
}
Der divisor ist dabei diejenige Zahl, durch die wir ein Element teilen müssen, so dass an der hintersten Stelle die aktuell zu betrachtende Ziffer steht – also 1 für die Einerstelle, 10 für die Zehnerstelle, 100 für die Hunderterstelle usw.
Die Methoden der Partitionierungsphase fassen wir in einer partition()-Methode zusammen:
private Bucket[] partition(int[] elements, int digitIndex) {
  Bucket[] buckets = createBuckets();
  distributeToBuckets(elements, digitIndex, buckets);
  return buckets;
}
In der Sammelphase müssen wir nun lediglich die Zahlen der einzelnen Buckets aneinanderreihen:
private void collect(Bucket[] buckets, int[] elements) {
  int targetIndex = 0;
  for (Bucket bucket : buckets) {
    for (int element : bucket.getElements()) {
      elements[targetIndex] = element;
      targetIndex++;
    }
  }
}
Die partition()- und collect()-Methoden fassen wir in einer sortByDigit()-Methode zusammen:
private void sortByDigit(int[] elements, int digitIndex) {
  Bucket[] buckets = partition(elements, digitIndex);
  collect(buckets, elements);
}
Und jetzt schließen wir den Kreis, indem wir die sortByDigit()-Methode aus der digitIndex-Schleife der zu Beginn gezeigten sort()-Methode heraus aufrufen:
public void sort(int[] elements) {
  int max = getMaximum(elements);
  int numberOfDigits = getNumberOfDigits(max);

  for (int digitIndex = 0; digitIndex < numberOfDigits; digitIndex++) {
    sortByDigit(elements, digitIndex);
  }
}
Damit ist unsere Radix-Sort-Implementierung abgeschlossen.
Hier siehst du noch einmal den vollständigen Quellcode:
public class RadixSortWithDynamicLists {

  public void sort(int[] elements) {
    int max = getMaximum(elements);
    int numberOfDigits = getNumberOfDigits(max);

    for (int digitIndex = 0; digitIndex < numberOfDigits; digitIndex++) {
      sortByDigit(elements, digitIndex);
    }
  }

  private int getMaximum(int[] elements) {
    int max = 0;
    for (int element : elements) {
      if (element > max) {
        max = element;
      }
    }
    return max;
  }

  private int getNumberOfDigits(int number) {
    int numberOfDigits = 1;
    while (number >= 10) {
      number /= 10;
      numberOfDigits++;
    }
    return numberOfDigits;
  }

  private void sortByDigit(int[] elements, int digitIndex) {
    Bucket[] buckets = partition(elements, digitIndex);
    collect(buckets, elements);
  }

  private Bucket[] partition(int[] elements, int digitIndex) {
    Bucket[] buckets = createBuckets();
    distributeToBuckets(elements, digitIndex, buckets);
    return buckets;
  }

  private Bucket[] createBuckets() {
    Bucket[] buckets = new Bucket[10];
    for (int i = 0; i < 10; i++) {
      buckets[i] = new Bucket();
    }
    return buckets;
  }

  private void distributeToBuckets(int[] elements, int digitIndex, Bucket[] buckets) {
    int divisor = calculateDivisor(digitIndex);

    for (int element : elements) {
      int digit = element / divisor % 10;
      buckets[digit].add(element);
    }
  }

  private int calculateDivisor(int digitIndex) {
    int divisor = 1;
    for (int i = 0; i < digitIndex; i++) {
      divisor *= 10;
    }
    return divisor;
  }

  private void collect(Bucket[] buckets, int[] elements) {
    int targetIndex = 0;
    for (Bucket bucket : buckets) {
      for (int element : bucket.getElements()) {
        elements[targetIndex] = element;
        targetIndex++;
      }
    }
  }

  private static class Bucket {
    private final List<Integer> elements = new ArrayList<>();

    private void add(int element) {
      elements.add(element);
    }

    private List<Integer> getElements() {
      return elements;
    }
  }
}
Die RadixSortWithDynamicLists-Klasse im GitHub-Repository unterscheidet sich übrigens leicht von dem hier abgedruckten Quellcode:
- Sie implementiert das Interface
SortAlgorithm, das es ermöglicht, verschiedene Radix-Sort-Implementierungen miteinander und mit den anderen Algorithmen der Sortieralgorithmen-Serie zu vergleichen. - Die
getMaximum()-Methode ist in die KlasseArrayUtilsausgelagert. - Die Methoden
getNumberOfDigits()undcalculateDivisor()liegen in der KlasseRadixSortHelperund können so auch in anderen Radix-Sort-Implementierungen verwendet werden.
Die gezeigte Implementierung hat ein Manko:
Dynamische Listen (also Listen, deren Größe sich zur Laufzeit ändern kann) sind für leistungskritische Einsatzzwecke wie Sortieralgorithmen nicht optimal, da das Hinzufügen von Elementen mit einem gewissen Performance-Overhead verbunden ist: Bei einer verketteten Liste beispielsweise müssen neue Knoten angelegt werden; bei einer ArrayList muss das Array in bestimmten Abständen in ein größeres umkopiert werden.
Dazu kommt das Autoboxing: List<Integer> speichert jede Zahl als eigenes Integer-Objekt – außerhalb des Integer-Caches (−128 bis 127) jedes Mal ein neues, das der Garbage Collector später wieder einsammeln muss.
Im nächsten Abschnitt zeige ich dir daher eine alternative Variante.
Variante 2: Radix Sort mit Arrays
Wir können die Implementierung deutlich beschleunigen (wir werden die Performance der Implementierungen im Anschluss vergleichen), indem wir für die Buckets statt einer ArrayList ein Array verwenden.
Da Arrays eine feste Größe haben, müssen wir vor der Erstellung eines Buckets wissen, wie viele Elemente der Bucket enthalten soll. Wir ändern unsere Bucket-Klasse wie folgt ab und übergeben die Größe an ihren Konstruktor:
private static class Bucket {
  private final int[] elements;
  private int addIndex;

  private Bucket(int size) {
    elements = new int[size];
  }

  private void add(int element) {
    elements[addIndex] = element;
    addIndex++;
  }

  private int[] getElements() {
    return elements;
  }
}
Um zu bestimmen, wie viele Elemente ein Bucket enthalten soll, zählen wir vorab die Ziffern an der aktuell betrachteten Stelle digitIndex. Die partition()-Methode sieht dann so aus:
private Bucket[] partition(int[] elements, int digitIndex) {
  int[] counts = countDigits(elements, digitIndex);
  Bucket[] buckets = createBuckets(counts);
  distributeToBuckets(elements, digitIndex, buckets);
  return buckets;
}

private int[] countDigits(int[] elements, int digitIndex) {
  int[] counts = new int[10];
  int divisor = calculateDivisor(digitIndex);
  for (int element : elements) {
    int digit = element / divisor % 10;
    counts[digit]++;
  }
  return counts;
}

private Bucket[] createBuckets(int[] counts) {
  Bucket[] buckets = new Bucket[10];
  for (int i = 0; i < 10; i++) {
    buckets[i] = new Bucket(counts[i]);
  }
  return buckets;
}
Die distributeToBuckets()-Methode brauchen wir nicht zu ändern, ebenso wenig alle anderen in Variante 1 gezeigten Methoden. Gut, dass wir in Variante 1 eine Bucket-Klasse verwendet haben und nicht direkt eine ArrayList.
Den vollständigen Code von Variante 2 findest du im GitHub-Repository in der Klasse RadixSortWithArrays.
Kommen wir zu einer dritten Variante.
Variante 3: Radix Sort mit Counting Sort
In Variante 2 haben wir vorab gezählt, wie viele Elemente in jeden Bucket sortiert werden müssen. Mit dieser Information können wir die Buckets auch überspringen und die Elemente direkt an ihre Zielpositionen verschieben – mit der allgemeinen Form von Counting Sort.
Wie Counting Sort funktioniert, werde ich an dieser Stelle nicht wiederholen. Ich zeige dir direkt die Implementierung:
public class RadixSortWithCountingSort {

  public void sort(int[] elements) {
    int max = getMaximum(elements);
    int numberOfDigits = getNumberOfDigits(max);

    // Remember input array
    int[] inputArray = elements;

    for (int digitIndex = 0; digitIndex < numberOfDigits; digitIndex++) {
      elements = sortByDigit(elements, digitIndex);
    }

    // Copy sorted elements back to input array
    System.arraycopy(elements, 0, inputArray, 0, elements.length);
  }

  // Same as in the other variants:
  // getMaximum(), getNumberOfDigits(), calculateDivisor()

  private int[] sortByDigit(int[] elements, int digitIndex) {
    int[] counts = countDigits(elements, digitIndex);
    int[] prefixSums = calculatePrefixSums(counts);
    return collectElements(elements, digitIndex, prefixSums);
  }

  private int[] countDigits(int[] elements, int digitIndex) {
    int[] counts = new int[10];
    int divisor = calculateDivisor(digitIndex);
    for (int element : elements) {
      int digit = element / divisor % 10;
      counts[digit]++;
    }
    return counts;
  }

  private int[] calculatePrefixSums(int[] counts) {
    int[] prefixSums = new int[10];
    prefixSums[0] = counts[0];
    for (int i = 1; i < 10; i++) {
      prefixSums[i] = prefixSums[i - 1] + counts[i];
    }
    return prefixSums;
  }

  private int[] collectElements(int[] elements, int digitIndex, int[] prefixSums) {
    int divisor = calculateDivisor(digitIndex);
    int[] target = new int[elements.length];
    for (int i = elements.length - 1; i >= 0; i--) {
      int element = elements[i];
      int digit = element / divisor % 10;
      target[--prefixSums[digit]] = element;
    }
    return target;
  }

}
Diesen Code findest du ebenfalls im GitHub-Repository, in der Klasse RadixSortWithCountingSort.
Radix Sort Varianten
Es gibt zwei grundlegende Varianten von Radix Sort, die sich durch die Reihenfolge unterscheiden, in der wir die Ziffern der Elemente betrachten.
LSD Radix Sort
Der oben Schritt für Schritt gezeigte Radix-Sort-Algorithmus nennt sich „LSD Radix Sort“. LSD steht dabei für „least significant digit“, also „niedrigstwertige Stelle“. Wir haben mit dem Sortieren bei der niedrigstwertigen Stelle (den Einern) begonnen und uns Ziffer für Ziffer bis zur höchstwertigen Stelle vorgearbeitet.
MSD Radix Sort
Alternativ können wir auch bei der höchstwertigen Stelle („most significant digit“) beginnen. Entsprechend heißt die zweite Variante „MSD Radix Sort“.
Dabei müssen wir allerdings anders vorgehen als bei der LSD-Variante. Denn wenn wir in unserem Ausgangsbeispiel die gesamte Eingabeliste zunächst nach Hundertern, dann nach Zehnern und zuletzt nach der Einerstelle sortieren würden, würde Folgendes passieren (die Buckets habe ich in der Grafik weggelassen, da es nur um die Ergebnisse nach den drei Sammelphasen geht):
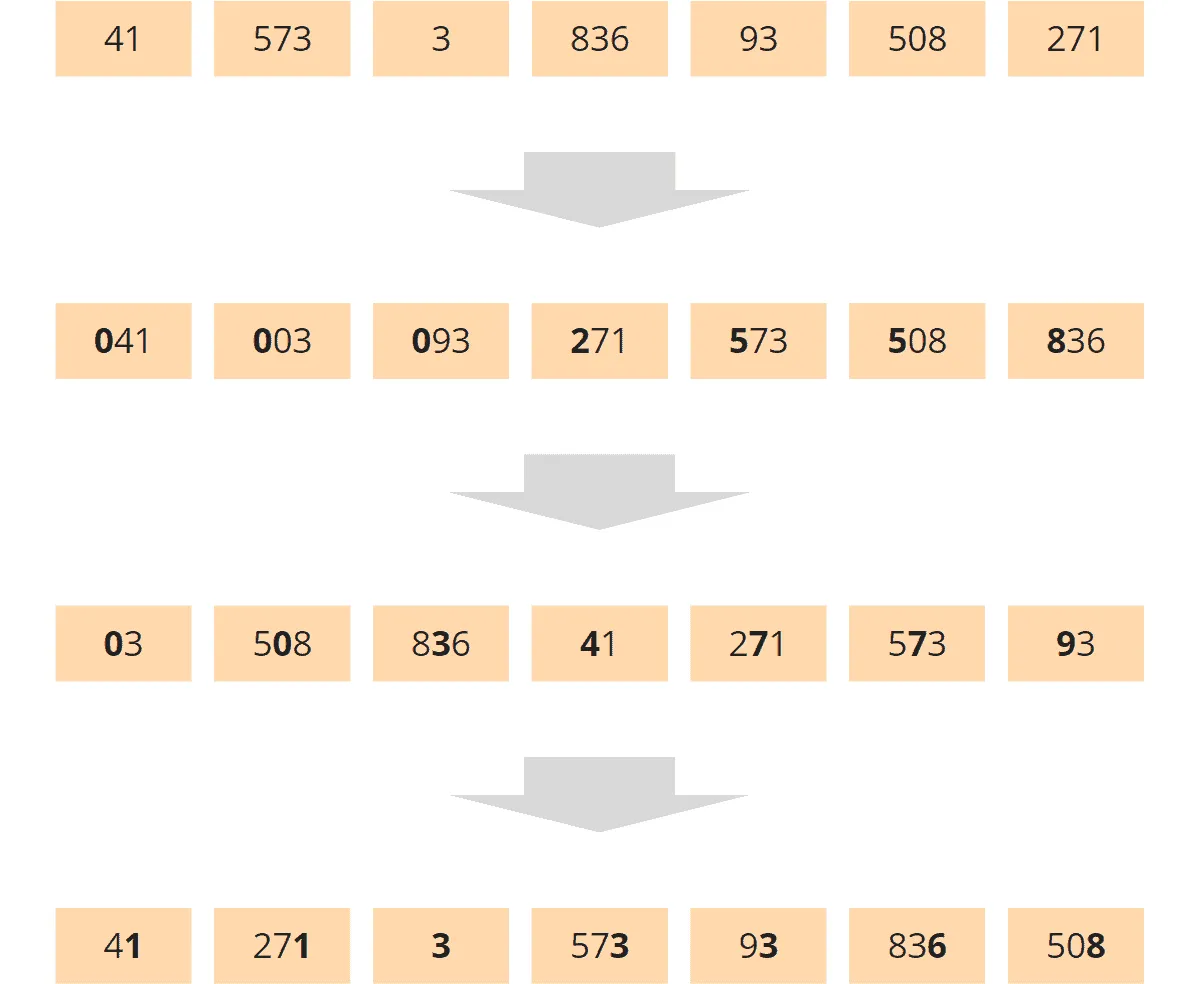
Die Sortierung nach der Zehner- und Einerstelle hat die jeweiligen vorherigen Sortierungen wieder durcheinandergebracht.
Das Problem ist schnell gelöst:
Nach der Hunderterstelle dürfen wir die Eingabeliste nicht erneut als Ganzes sortieren, sondern die Hunderterstellen-Buckets in sich. Die daraus wiederum resultierenden Zehnerstellen-Buckets sortieren wir dann jeweils nach der Einerstelle. Wir sortieren die Buckets also rekursiv.
MSD Radix Sort – Schritt für Schritt
Die folgenden Grafiken zeigen das rekursive MSD-Radix-Sort-Verfahren Schritt für Schritt am Eingangsbeispiel. Buckets werden durch schwarze Klammern unter den Elementen dargestellt. Leere Buckets werden nicht angezeigt.
Wir beginnen mit der Partitionierung nach Hunderterstellen:
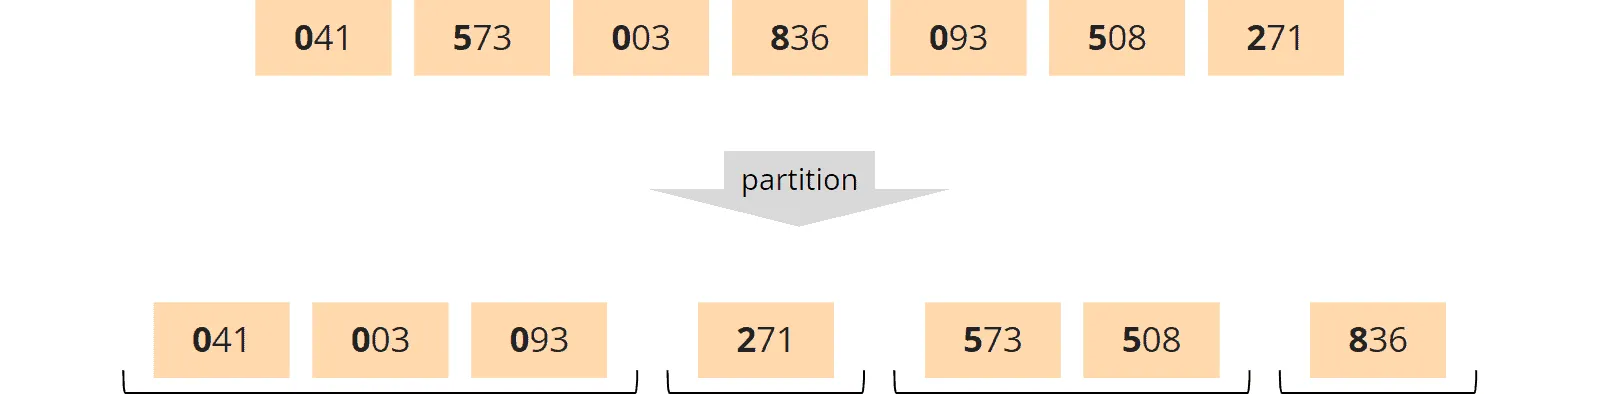
Anstatt nun von der Partitionierungs- in die Sammelphase überzugehen, führen wir auf jedem Bucket eine weitere Partitionierungsphase aus – und zwar auf der nächstniedrigeren Stelle, also den Zehnern.
Leere Buckets und solche, die nur ein Element enthalten (wie die 271 und die 836), brauchen wir nicht weiter zu partitionieren.
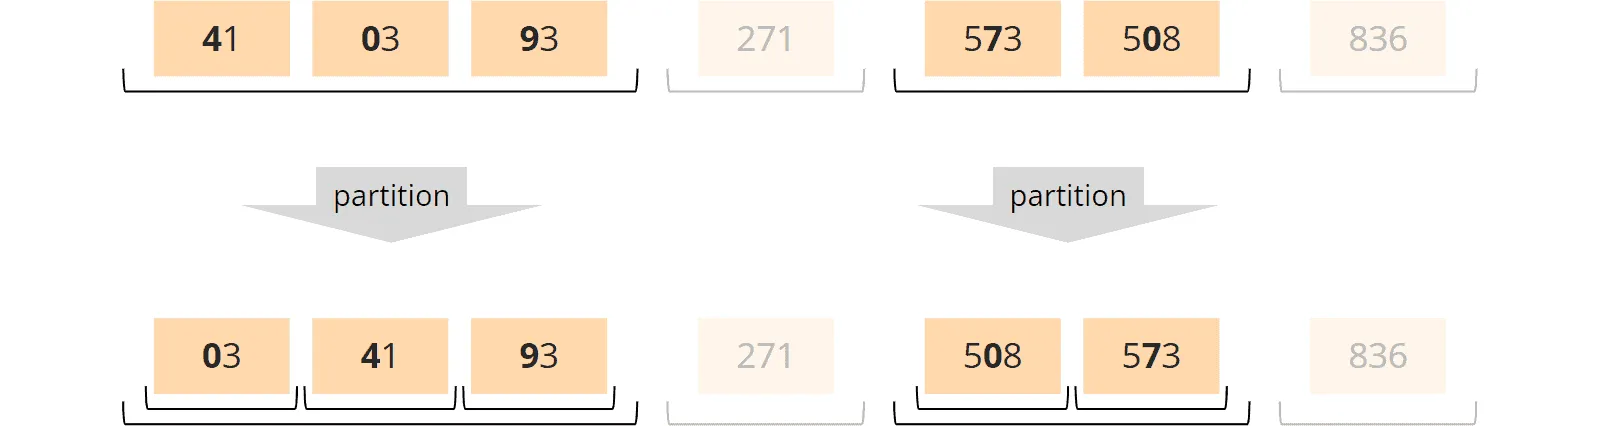
Eigentlich müssten wir die Buckets nun noch nach Einerstellen partitionieren. Da aber keiner der Zehnerstellen-Buckets mehr als ein Element enthält, ist das nicht notwendig.
Wir steigen daher aus der Rekursion wieder aus. Zunächst führen wir eine Sammelphase auf den Zehnerstellen-Buckets aus:
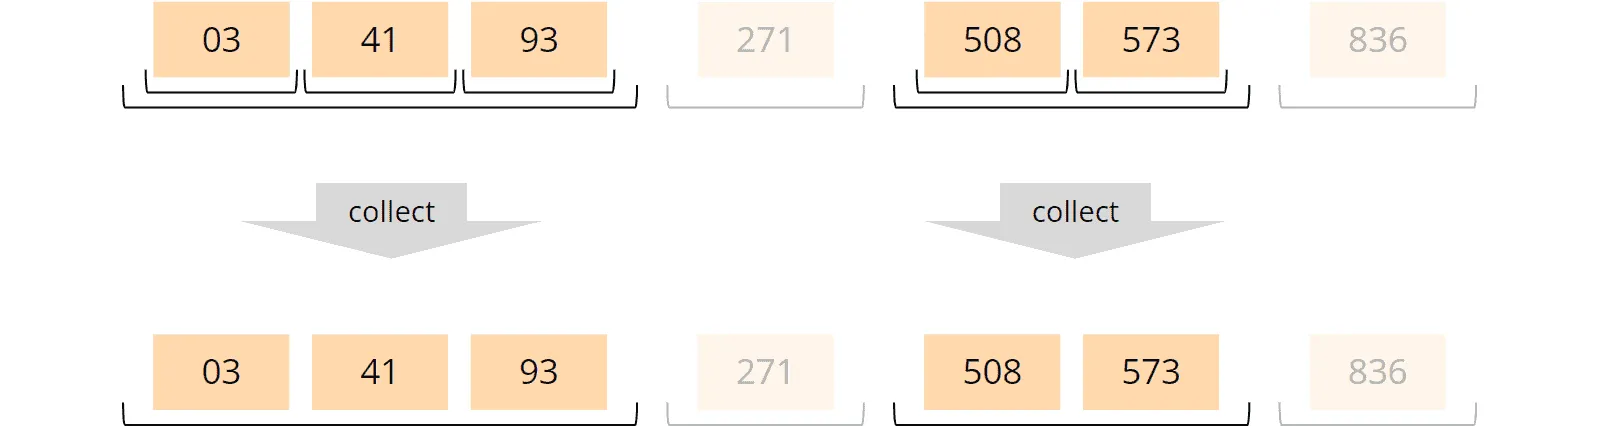
Und zuletzt führen wir die Sammelphase auf den Hunderterstellen-Buckets aus:
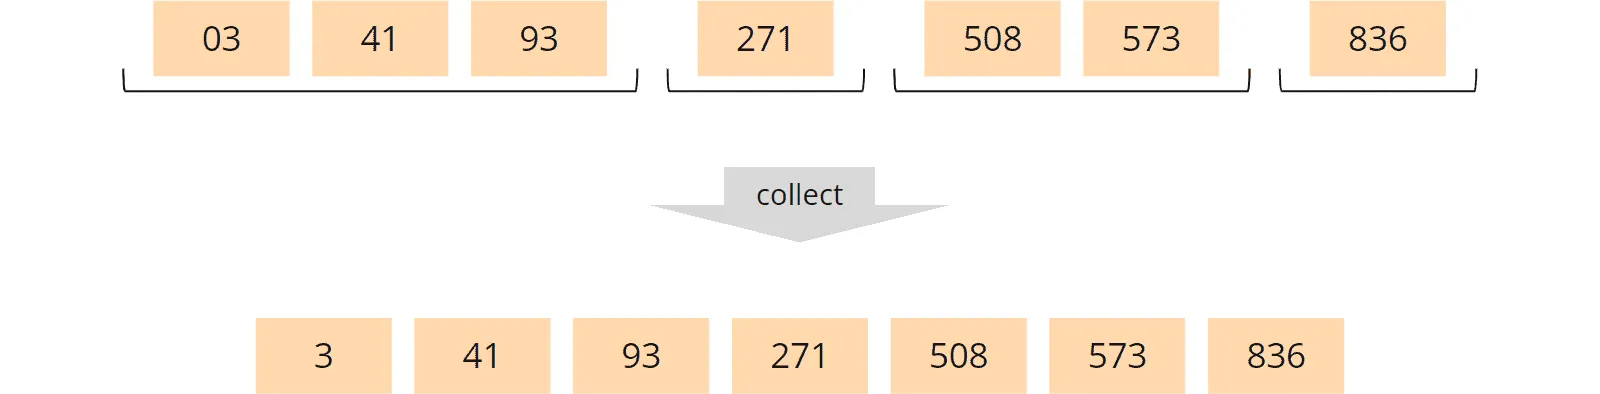
Die Sortierung ist damit abgeschlossen.
MSD Radix Sort – Implementierung
Genau wie die LSD-Variante kann auch MSD Radix Sort mit dynamischen Listen, Arrays und mit Counting Sort implementiert werden.
Ich zeige dir, wie du die oben gezeigte LSD-Array-Implementierung mit wenigen Änderungen in eine MSD-Implementierung umbauen kannst.
Hier sind noch einmal die Methoden sort() und sortByDigit() der Klasse RadixSortWithArrays:
public void sort(int[] elements) {
  int max = getMaximum(elements);
  int numberOfDigits = getNumberOfDigits(max);

  for (int digitIndex = 0; digitIndex < numberOfDigits; digitIndex++) {
    sortByDigit(elements, digitIndex);
  }
}

private void sortByDigit(int[] elements, int digitIndex) {
  Bucket[] buckets = partition(elements, digitIndex);
  collect(buckets, elements);
}
Alles, was wir nun tun müssen, ist die sortByDigit()-Methode für die höchstwertige Stelle aufzurufen und zwischen Partitionierungs- und Sammelphase den rekursiven Aufruf für die nächstniedrigere Stelle einzufügen:
public void sort(int[] elements) {
  int max = getMaximum(elements);
  int numberOfDigits = getNumberOfDigits(max);

  sortByDigit(elements, numberOfDigits - 1);
}

private void sortByDigit(int[] elements, int digitIndex) {
  Bucket[] buckets = partition(elements, digitIndex);

  // If we haven't reached the last digit,
  // sort the buckets by the next digit, recursively
  if (digitIndex > 0) {
    for (Bucket bucket : buckets) {
      if (bucket.needsToBeSorted()) {
        sortByDigit(bucket.getElements(), digitIndex - 1);
      }
    }
  }

  collect(buckets, elements);
}
Die Methode Bucket.needsToBeSorted() gibt true zurück, wenn der Bucket mehr als ein Element enthält.
Den vollständigen Code findest du im GitHub-Repository in der Klasse RecursiveMsdRadixSortWithArrays.
Ich überlasse es dir als Übungsaufgabe, auch für die zwei anderen LSD-Implementierungen (dynamische Listen und Counting Sort) je eine MSD-Variante zu schreiben.
Verwendung anderer Basen
Bisher haben wir die Partitionierung nach dem Dezimalsystem, also mit 10 Buckets, durchgeführt. Wir können aber auch mit jeder anderen Basis arbeiten, also beispielsweise mit dem Binärsystem (2 Buckets), dem Hexadezimalsystem (16 Buckets) oder auch mit hundert, tausend oder mehr Buckets.
Je höher die Basis, desto mehr Buckets, desto aufwändiger die Partitionierungsphase. Andererseits haben die zu sortierenden Zahlen dann weniger Stellen (1.000.000 dezimal = F4240 hexadezimal), so dass insgesamt weniger Partitionierungs- und Sammelphasen stattfinden müssen. Was das für die Performance bedeutet, werden wir im Kapitel „Radix Sort Laufzeit“ ermitteln.
Wie implementiert man Radix Sort mit einer anderen Basis?
Im Grunde genommen müssen wir jedes Vorkommen der Zahl 10 im Quellcode durch die neue Basis ersetzen. In der Klasse RadixSortWithDynamicLists kommt die 10 in den folgenden Methoden vor:
private int getNumberOfDigits(int number) {
  int numberOfDigits = 1;
  while (number >= 10) {
    number /= 10;
    numberOfDigits++;
  }
  return numberOfDigits;
}

private Bucket[] createBuckets() {
  Bucket[] buckets = new Bucket[10];
  for (int i = 0; i < 10; i++) {
    buckets[i] = new Bucket();
  }
  return buckets;
}

private void distributeToBuckets(int[] elements, int digitIndex, Bucket[] buckets) {
  int divisor = calculateDivisor(digitIndex);

  for (int element : elements) {
    int digit = element / divisor % 10;
    buckets[digit].add(element);
  }
}

private int calculateDivisor(int digitIndex) {
  int divisor = 1;
  for (int i = 0; i < digitIndex; i++) {
    divisor *= 10;
  }
  return divisor;
}
Wir können die 10 an all diesen Stellen durch eine andere Basis ersetzen. Besser noch: Wir ersetzen sie durch eine Variable, so dass wir den Sortieralgorithmus mit jeder beliebigen Basis aufrufen können.
In der Klasse RadixSortWithDynamicListsAndCustomBase findest du die entsprechende Anpassung:
public class RadixSortWithDynamicListsAndCustomBase implements SortAlgorithm {

  private final int base;

  public RadixSortWithDynamicListsAndCustomBase(int base) {
    this.base = base;
  }

  // All methods not printed here are the same as in RadixSortWithDynamicLists

  private int getNumberOfDigits(int number) {
    int numberOfDigits = 1;
    while (number >= base) {
      number /= base;
      numberOfDigits++;
    }
    return numberOfDigits;
  }

  private Bucket[] createBuckets() {
    Bucket[] buckets = new Bucket[base];
    for (int i = 0; i < base; i++) {
      buckets[i] = new Bucket();
    }
    return buckets;
  }

  private void distributeToBuckets(int[] elements, int digitIndex, Bucket[] buckets) {
    int divisor = calculateDivisor(digitIndex);

    for (int element : elements) {
      int digit = element / divisor % base;
      buckets[digit].add(element);
    }
  }

  private int calculateDivisor(int digitIndex) {
    int divisor = 1;
    for (int i = 0; i < digitIndex; i++) {
      divisor *= base;
    }
    return divisor;
  }

}
Beachte bitte, dass im GitHub-Repository die Methoden getNumberOfDigits() und calculateDivisor() in die Klasse RadixSortHelper ausgelagert sind, da sie auch von anderen Radix-Sort-Implementierungen benötigt werden.
Im GitHub-Repository findest du außerdem die angepassten Algorithmen für Arrays, Counting Sort und rekursives MSD Radix Sort:
- Dynamische Listen + variable Basis:
RadixSortWithDynamicListsAndCustomBase - Arrays + variable Basis:
RadixSortWithArraysAndCustomBase - Counting Sort + variable Basis:
RadixSortWithCountingSortAndCustomBase - Rekursives MSD Radix Sort + variable Basis:
RecursiveMsdRadixSortWithArraysAndCustomBase
Radix Sort Zeitkomplexität
In diesem Kapitel zeige ich dir, wie du die Zeitkomplexität von Radix Sort bestimmst. Eine Einführung in das Thema Zeitkomplexität findest du im Artikel „O-Notation und Zeitkomplexität“.
Im Folgenden verwenden wir diese Variablen:
- n = die Anzahl der zu sortierenden Elemente
- k = die maximale Schlüssellänge („key length“, Anzahl der Stellen) der zu sortierenden Elemente
- b = die Basis (= die Anzahl der Buckets)
Der Algorithmus iteriert über k Stellen; für jede Stelle betreibt er den folgenden Aufwand:
- Er legt b Buckets an. Der Aufwand dafür ist jeweils konstant.
- Er iteriert über alle n Elemente, um diese in die Buckets einzusortieren. Der Aufwand für die Berechnung der Bucket-Nummer und für das Einfügen in den Bucket ist konstant.
- Er iteriert über b Buckets und entnimmt diesen wieder insgesamt n Elemente. Der Aufwand für jeden dieser Schritte ist wiederum konstant.
Konstante Aufwände vernachlässigen wir bei der Bestimmung der Zeitkomplexität. Somit ergibt sich:
Die Zeitkomplexität für Radix Sort ist: O(k · (b + n)).
Der Aufwand ist unabhängig davon, wie die Eingabezahlen angeordnet sind. Ob diese zufällig verteilt oder bereits vorsortiert sind, macht keinen Unterschied für den Algorithmus. Best case, average case und worst case sind also identisch.
Die Formel sieht erst einmal kompliziert aus. Doch zwei der drei Variablen sind in den meisten Fällen gar nicht variabel. Wenn wir z. B. Longs mit der Basis 10 sortieren, können wir k durch 19 ersetzen (der maximal mögliche Wert für ein Long ist 9.223.372.036.854.775.807) und b durch 10.
Die Formel wird dann zu O(19 · (10 + n)). Konstanten können wir weglassen, somit ergibt sich:
Die Zeitkomplexität für Radix Sort
bei bekannter maximaler Länge der zu sortierenden Elemente
und mit festgelegter Basis ist: O(n).
Radix Sort hat also für primitive Datentypen wie Integer und Long (bei diesen kennen wir die maximale Länge) eine bessere Zeitkomplexität als Quicksort!
Ob Radix Sort tatsächlich schneller ist, erfährst du im nächsten Kapitel. Dort werden wir die Laufzeit der verschiedenen Radix-Sort-Implementierungen messen und untereinander (und auch mit Quicksort) vergleichen.
Radix Sort Laufzeit
In diesem Kapitel zeige ich dir die Ergebnisse einiger Performance-Tests, die ich mit den Tools UltimateTest und CompareRadixSorts durchgeführt habe, um die Performance der verschiedenen Algorithmen, Implementierungen und Basen zu vergleichen.
Laufzeit verschiedener Radix-Sort-Implementierungen
Das erste Diagramm zeigt den Vergleich der verschiedenen Implementierungen, jeweils mit Basis 10, für zufällige Zahlen:
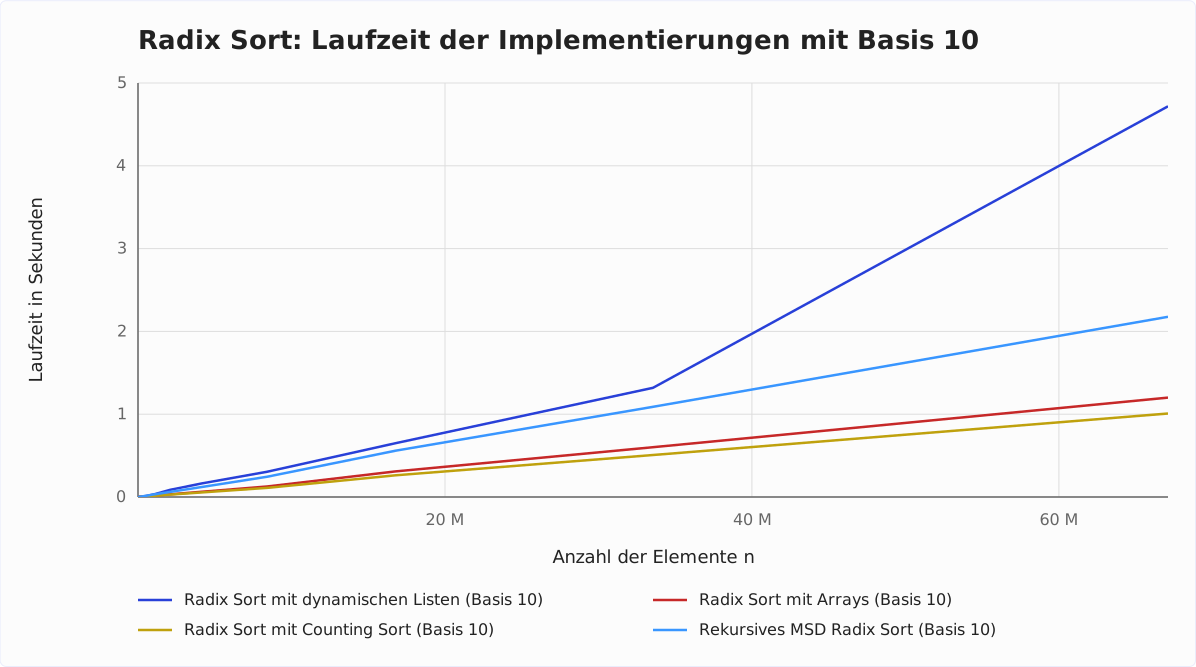
Die Implementierung mit dynamischen Listen schneidet, wie vermutet, am schlechtesten ab. Die Implementierung mit Counting Sort gewinnt, gefolgt von der Implementierung mit Arrays, die 19 % länger braucht. Das rekursive MSD Radix Sort braucht 2,2-mal so lange wie die Counting-Sort-Variante, die dynamischen Listen 4,7-mal so lange.
Sehr schön zu sehen ist auch die jeweils lineare Laufzeit O(n), die wir im vorangegangenen Kapitel vorhergesagt hatten: Ab 65.536 Elementen wächst die Laufzeit der Array-, Counting-Sort- und MSD-Variante pro Verdopplung um den Faktor 1,9 bis 2,1.
Ausnahmen sind die Verdopplungen, bei denen die größte Zahl eine Dezimalstelle dazubekommt – von 65.536 auf 131.072, von 524.288 auf 1.048.576 und von 8.388.608 auf 16.777.216 Elemente. Dort ist es der Faktor 2,2 bis 2,6 (im Diagramm kaum zu sehen). Der Test füllt das Array mit Zufallszahlen von 0 bis n – 1, und mit jeder zusätzlichen Stelle braucht der Algorithmus eine Iteration mehr – beim Sprung von k auf k + 1 Stellen ist also etwa der Faktor 2 · (k + 1) / k zu erwarten, von sieben auf acht Stellen z. B. 2,29.
Sichtbar knickt nur die Linie der dynamischen Listen: Bei der letzten Verdopplung, von 33.554.432 auf 67.108.864 Elemente, wächst ihre Laufzeit um den Faktor 3,6.
Ursache ist der Garbage Collector: In dieser Variante ist jedes Element ein eigenes Integer-Objekt in einer ArrayList. In einem Kontrolllauf mit GC-Log entfielen bei 67.108.864 zufälligen Zahlen 1,9 der 4,4 Sekunden auf GC-Pausen; ohne sie wächst die Laufzeit pro Verdopplung um den Faktor 2,0 bis 2,2. Bei welcher Größe die Pausen einsetzen, schwankt von Lauf zu Lauf.
Auswirkung der Basis auf die Laufzeit
Das zweite Diagramm zeigt dieselben vier Implementierungen mit einer größeren Basis – 100 für die drei LSD-Varianten, 1.000 für das rekursive MSD Radix Sort:
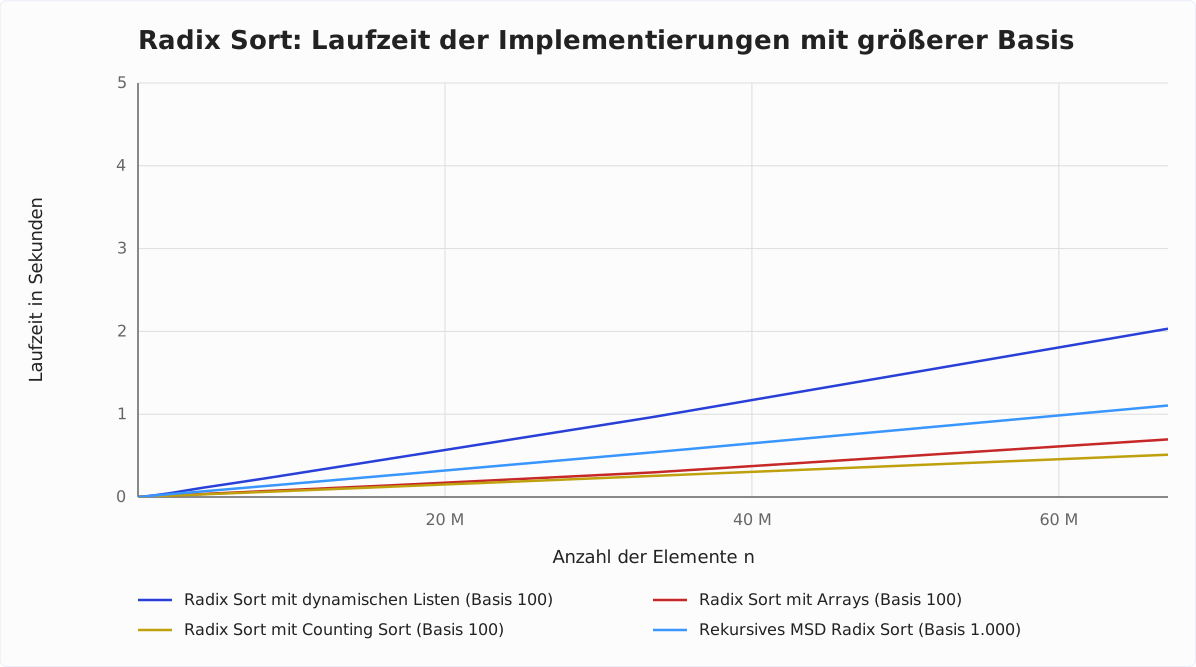
Alle vier Implementierungen sind mit der größeren Basis deutlich schneller: die Array-Variante um den Faktor 1,7, die Counting-Sort- und die MSD-Variante um den Faktor 2,0 und die Variante mit dynamischen Listen um den Faktor 2,3.
Alle bisherigen Messungen verwendeten zufällige Zahlen. Die folgende Tabelle zeigt alle acht Varianten (vier Implementierungen mit je zwei Basen) für 67.108.864 Elemente – zufällig, aufsteigend sortiert und absteigend sortiert:
| Implementierung | Basis | zufällig | aufsteigend | absteigend |
|---|---|---|---|---|
| Dynamische Listen | 10 | 4.718,4 ms | 5.599,2 ms | 5.613,5 ms |
| Dynamische Listen | 100 | 2.032,5 ms | 2.308,6 ms | 2.276,6 ms |
| Arrays | 10 | 1.200,3 ms | 1.199,9 ms | 1.189,5 ms |
| Arrays | 100 | 695,9 ms | 997,5 ms | 989,0 ms |
| Counting Sort | 10 | 1.008,5 ms | 1.009,5 ms | 1.001,3 ms |
| Counting Sort | 100 | 510,4 ms | 530,9 ms | 522,9 ms |
| Rekursives MSD Radix Sort | 10 | 2.176,1 ms | 1.759,7 ms | 1.862,9 ms |
| Rekursives MSD Radix Sort | 1.000 | 1.105,5 ms | 652,0 ms | 638,5 ms |
Laut Zeitkomplexität sollte die Reihenfolge der Eingabe keine Rolle spielen. Für die Array- und die Counting-Sort-Variante mit Basis 10 stimmt das auch (weniger als 1 % Unterschied). Ansonsten spielt die Reihenfolge auf dieser Maschine durchaus eine Rolle: Vorsortierte Zahlen brauchen mit Counting Sort (Basis 100) 2 bis 4 % länger und mit Arrays (Basis 100) 42 bis 43 % länger – das rekursive MSD Radix Sort dagegen braucht für sie 14 bis 19 % weniger Zeit (Basis 10) bzw. 41 bis 42 % weniger (Basis 1.000).
Die dynamischen Listen nehme ich dabei aus: Bei ihnen hängt der Unterschied davon ab, wann die oben beschriebenen GC-Pausen einsetzen. In der Tabelle brauchen vorsortierte Zahlen 12 bis 19 % länger, im Kontrolllauf mit GC-Log (Basis 10) 30 bis 31 %.
Untersuchen wir die Auswirkung der Basis etwas detaillierter … Das dritte Diagramm zeigt feinere Abstufungen der Basen bei gleicher Anzahl Elemente (n = 5.555.555) für die Array-Implementierung:
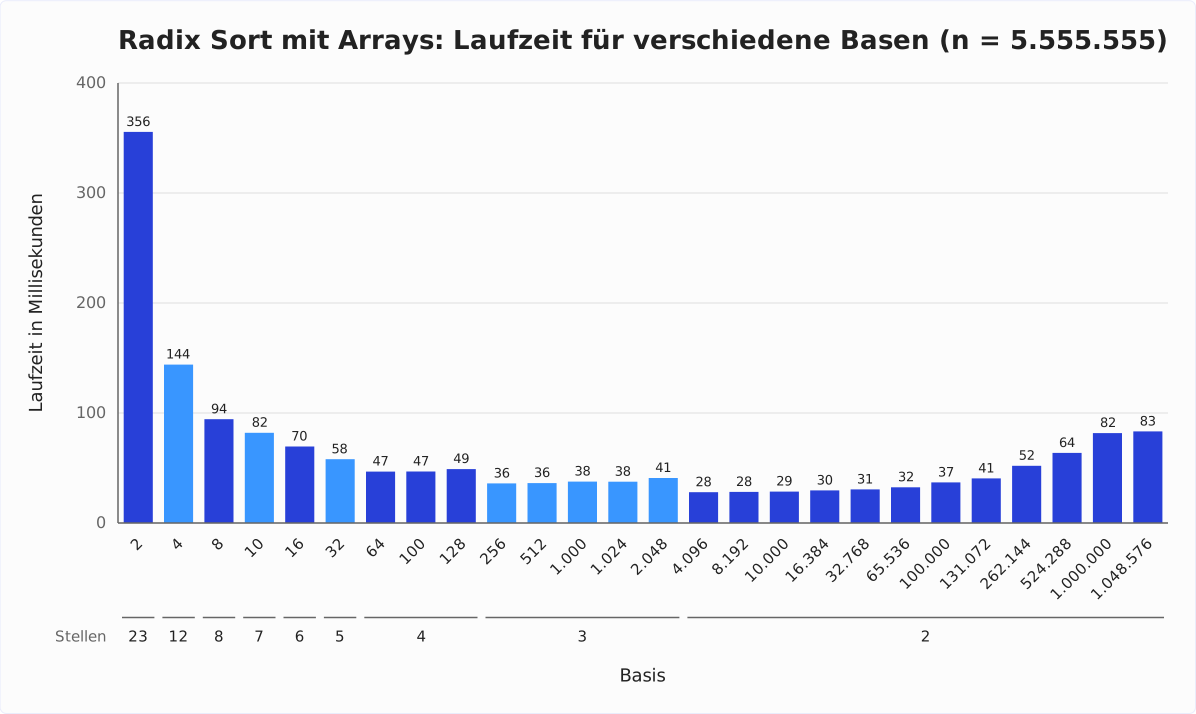
Sowohl eine zu kleine als auch eine zu große Basis sind schlecht für die Performance.
Eine sehr kleine Basis führt dazu, dass viele Iterationen durchgeführt werden müssen. Eine zu große Basis führt zwar zu weniger Iterationen, aber deutlich mehr Buckets innerhalb der Iterationen.
Die Anzahl der Iterationen steht in der Zeile unter den Basen: Die zu sortierenden Zahlen liegen zwischen 0 und 5.555.554, und die Zeile zeigt, wie viele Stellen die größte davon in der jeweiligen Basis hat – so viele Partitionierungs- und Sammelphasen durchläuft der Algorithmus. Die Laufzeit fällt in Stufen mit der Anzahl der Stellen und steigt innerhalb einer Stufe mit der Anzahl der Buckets.
Ein Sweet Spot zeigt sich bei einer Basis von 4.096 (28,0 ms) – der kleinsten Basis, mit der zwei Stellen ausreichen. Mit Basis 256 dauert das Sortieren 29 % länger. Auch die anderen drei Implementierungen sind mit Basis 4.096 am schnellsten; die Counting-Sort-Variante ist dort mit 21,8 ms die schnellste aller 108 Kombinationen.
Bei der Messung von 2022 lag der Sweet Spot bei Basis 256; Basis 4.096 brauchte dort 1,6-mal so lange.
Radix Sort vs. Quicksort
Im folgenden Diagramm siehst du die Laufzeiten …
- der Radix-Sort-Array-Implementierung mit einer Basis von 4.096 (dem Sweet Spot von oben) und zum Vergleich mit 256,
- von Dual-Pivot Quicksort kombiniert mit Insertion Sort (Schwellwert 64; die Variante aus dem Quicksort-Tutorial),
- und der JDK-Sortiermethode
Arrays.sort(), welche ebenfalls ein optimiertes Dual-Pivot Quicksort implementiert.
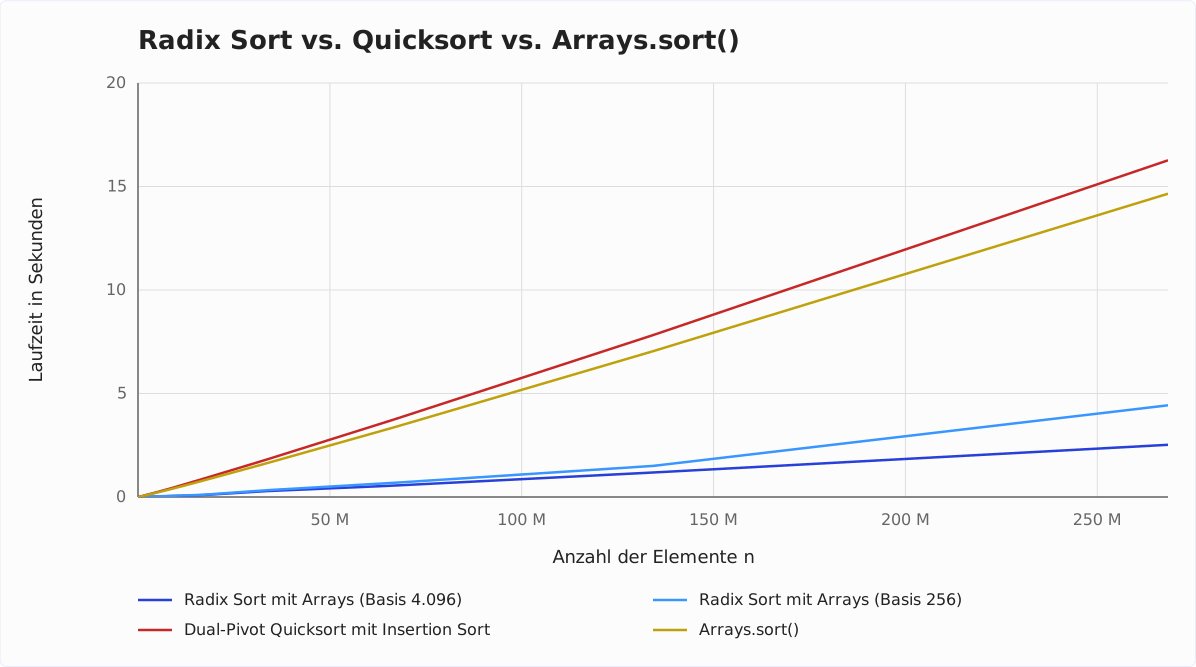
Und tatsächlich ist Radix Sort nicht nur in der Theorie schneller (O(n) vs. O(n log n)), sondern auch in der Praxis – sowohl im Vergleich mit dem selbst implementierten Quicksort als auch mit der noch schnelleren JDK-Implementierung Arrays.sort(). Mit Basis 4.096 liegt Radix Sort ab 2.048 Elementen vorn. Bei 1.024 Elementen – im Diagramm nicht zu erkennen – sind beide Quicksort-Varianten schneller; mit Basis 256 liegt Radix Sort auch dort vorn. Für 134.217.728 Elemente braucht es 1,2 Sekunden, Arrays.sort() 7,0 Sekunden – 5,9-mal so lange – und Dual-Pivot Quicksort 7,8 Sekunden. 2022 brauchte Arrays.sort() nur 1,7-mal so lange wie Radix Sort mit Basis 256.
Zwischen 134.217.728 und 268.435.456 Elementen knickt die Linie für Basis 256 nach oben: Ihre Laufzeit wächst um den Faktor 2,9, die von Arrays.sort() um 2,1. Das liegt nicht an der Zeitkomplexität des Algorithmus, sondern am Garbage Collector G1: Ab dieser Größe ist etwa die Hälfte der Buckets größer als eine halbe Heap-Region, und G1 legt jeden davon als „Humongous Object“ in eine eigene Region. In einem Kontrolllauf mit größeren Regionen (-XX:G1HeapRegionSize=32m) sinkt der Faktor auf 2,2. Mit Basis 4.096 bleiben die Buckets der unteren Stellen weit unter dieser Grenze (256 KB bei 268.435.456 Elementen), und die Laufzeit wächst um den Faktor 2,1.
Wenn du also nicht-negative int-Primitive sortieren musst und die Performance kritisch ist, solltest du erwägen, statt des Java-Hausmittels Arrays.sort() Radix Sort einzusetzen. Du kannst gerne die Implementierung aus diesem Artikel verwenden.
Übrigens: Vladimir Yaroslavskiy, der Autor von Dual-Pivot Quicksort, hat 2021 vorgeschlagen, Radix Sort für große zufällige primitive Arrays in Arrays.sort() zu integrieren (JDK-8266431). Im September 2025 hat er Radix Sort auf Wunsch der Reviewer aus dem Pull Request herausgenommen; die aktuelle Fassung (#27411) enthält es nur abgeschaltet, vorgesehen für ein späteres Release. Stand Java 27 sortiert Arrays.sort() ohne Radix Sort.
Weitere Eigenschaften von Radix Sort
In diesem abschließenden Kapitel betrachten wir die Platzkomplexität, Stabilität und Parallelisierbarkeit von Radix Sort sowie die Unterschiede zu Counting Sort und Bucket Sort.
Radix Sort Platzkomplexität
Alle hier gezeigten Varianten benötigen zusätzlichen Speicherplatz:
- O(b) für das Zählen der Ziffern (nicht benötigt in der Variante mit dynamischen Listen)
- O(b) für die Referenzen auf die Buckets (nicht benötigt bei der Counting-Sort-Variante)
- O(n) für die Buckets (nicht benötigt bei der Counting-Sort-Variante)
- O(n) für ein zusätzliches Ziel-Array (nur bei der Counting-Sort-Variante)
Jede Variante enthält also mindestens einen O(b)-Anteil und mindestens einen O(n)-Anteil.
Somit gilt:
Die Platzkomplexität von Radix Sort ist: O(b + n).
Beim rekursiven MSD Radix Sort kommen die Buckets jeder Rekursionsebene hinzu – im ungünstigsten Fall, wenn alle Zahlen dieselben führenden Ziffern haben, also O(k · (b + n)).
Ist Radix Sort stabil?
Die Bedeutung von Stabilität bei Sortierverfahren kannst du im verlinkten Einführungsartikel nachlesen. Kurz gesagt: Elemente mit dem gleichen Schlüssel behalten bei der Sortierung ihre ursprüngliche Reihenfolge zueinander bei.
Alle in diesem Artikel gezeigten Implementierungen von Radix Sort sind stabil.
Die im vorherigen Abschnitt angesprochenen In-Place-Varianten sind hingegen nicht stabil (analog zu Quicksort).
Paralleles Radix Sort
Beide Radix-Sort-Varianten (LSD und MSD) lassen sich parallelisieren.
MSD Radix Sort parallel
Bei MSD Radix Sort können wir nach der ersten Partitionierungsphase alle entstandenen Buckets unabhängig voneinander parallel sortieren. Dank paralleler Streams lässt sich das in Java sehr einfach implementieren.
Hier noch einmal der entsprechende sequenzielle Code aus der Klasse RecursiveMsdRadixSortWithArrays:
for (Bucket bucket : buckets) {
  if (bucket.needsToBeSorted()) {
    sortByDigit(bucket.getElements(), digitIndex - 1);
  }
}
Und hier die parallelisierte Variante (Klasse ParallelRecursiveMsdRadixSortWithArrays im GitHub-Repository):
Arrays.stream(buckets)
    .parallel()
    .forEach(
        bucket -> {
          if (bucket.needsToBeSorted()) {
            sortByDigit(bucket.getElements(), digitIndex - 1);
          }
        });
LSD Radix Sort parallel
Um LSD Radix Sort zu parallelisieren, müssen wir etwas mehr Aufwand betreiben:
- Wir teilen das Eingabe-Array in parallel zu bearbeitende Segmente auf (z. B. entsprechend der Anzahl der CPU-Kerne).
- Wir berechnen parallel pro Segment, wie viele Elemente in welche Buckets sortiert werden müssen.
- Wenn Schritt 2 für alle Segmente abgeschlossen ist, berechnen wir a) pro Bucket die Gesamtanzahl der Elemente und b) pro Segment die Start-Schreibpositionen für jeden Bucket.
- Wir verteilen die Elemente der Segmente parallel auf die Buckets. Durch die in Schritt 3 berechneten Start-Schreibpositionen wissen wir, an welchen Positionen innerhalb der Buckets wir aus welchen Segmenten schreiben dürfen.
- Wenn Schritt 4 für alle Segmente abgeschlossen ist, berechnen wir pro Bucket den Offset im Zielarray (als Präfixsummen über die Anzahl der Elemente der Buckets).
- Wir sammeln die Elemente der Buckets parallel ein. Durch die in Schritt 5 berechneten Offsets wissen wir, an welcher Position im Zielarray die Elemente eines Buckets starten müssen.
Die folgende Grafik zeigt die Schritte 2 bis 6 an einem Beispiel mit drei Segmenten und der Basis 4:
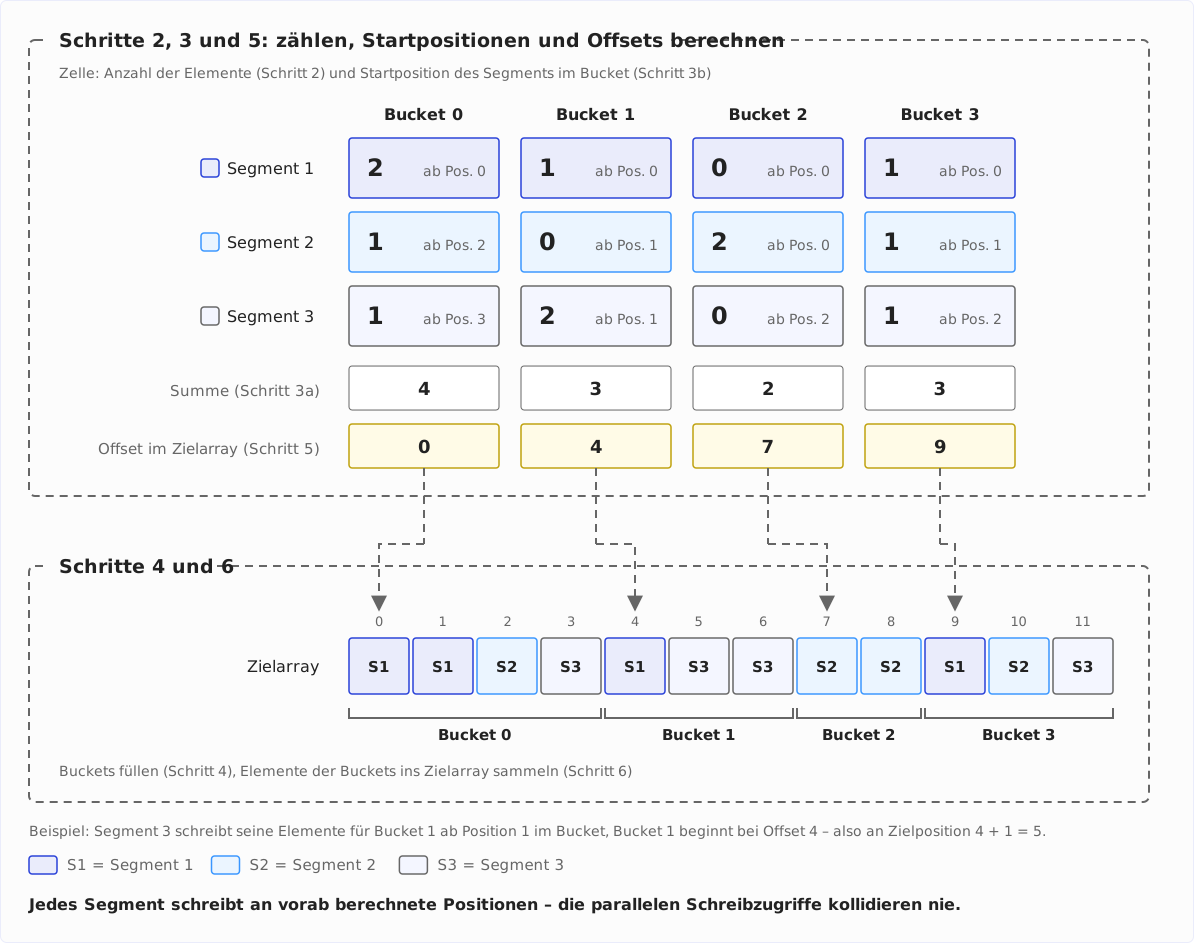
Den Quellcode findest du in der Klasse ParallelRadixSortWithArrays im GitHub-Repo. Die sechs oben aufgezählten Schritte sind im Code mit entsprechend nummerierten Kommentaren markiert.
Radix Sort parallel vs. sequenziell
Das folgende Diagramm zeigt die Laufzeit der parallelen Varianten verglichen mit den sequenziellen Varianten (beide mit Basis 10) auf dem Apple M5 Pro mit 18 Kernen:
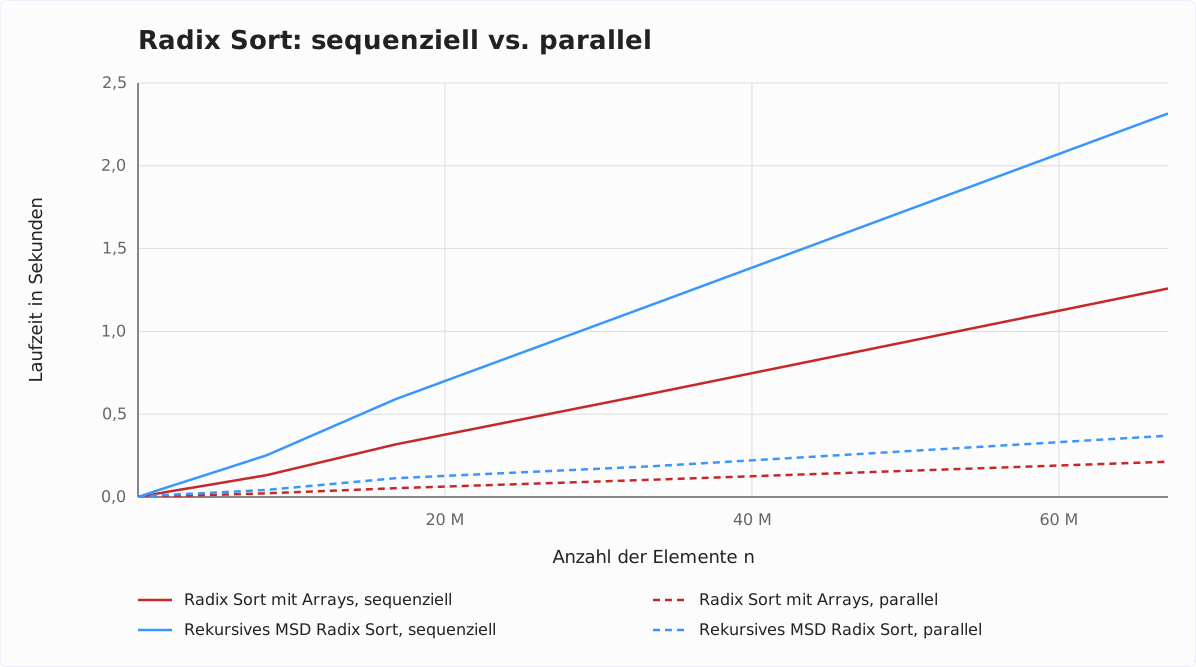
Die parallelen Varianten sind bei 67 Millionen Elementen 5,9-mal (Arrays) und 6,3-mal (MSD) schneller. Dass der Faktor 18 nicht einmal annähernd erreicht wird, hat bei den beiden Varianten unterschiedliche Gründe, wie eine Kontrollmessung mit instrumentierten Kopien der beiden Klassen zeigt.
Beim parallelen MSD Radix Sort laufen die Prüfung auf negative Zahlen, die Maximumsuche, die Partitionierung nach der höchsten Stelle und das abschließende Einsammeln sequenziell – bei 18 Kernen ist das die Hälfte der Laufzeit; selbst eine beliebig schnelle Rekursion könnte sie also höchstens halbieren.
Beim parallelen LSD Radix Sort machen die sequenziellen Teile dagegen nur 13 % aus; hier skalieren die parallelen Phasen selbst nicht linear: Das Zählen wird mit 18 Kernen 10,7-mal schneller als mit einem, das Verteilen auf die Buckets 7,8-mal.
Die 18 Kerne des M5 Pro sind dabei nicht gleich schnell: sechs sind „Super“-Kerne, zwölf langsamere „Performance“-Kerne. Auf einem Intel Core i7-12700H (14 Kerne, 20 Threads) liegen die Faktoren bei 3,9 und 4,4; auf dem i7 mit sechs Kernen der Messung von 2022 lagen sie bei 2,3 und 2,4.
Wenn wir uns einen kleineren Ausschnitt des Diagramms anschauen, sieht die Sache anders aus:
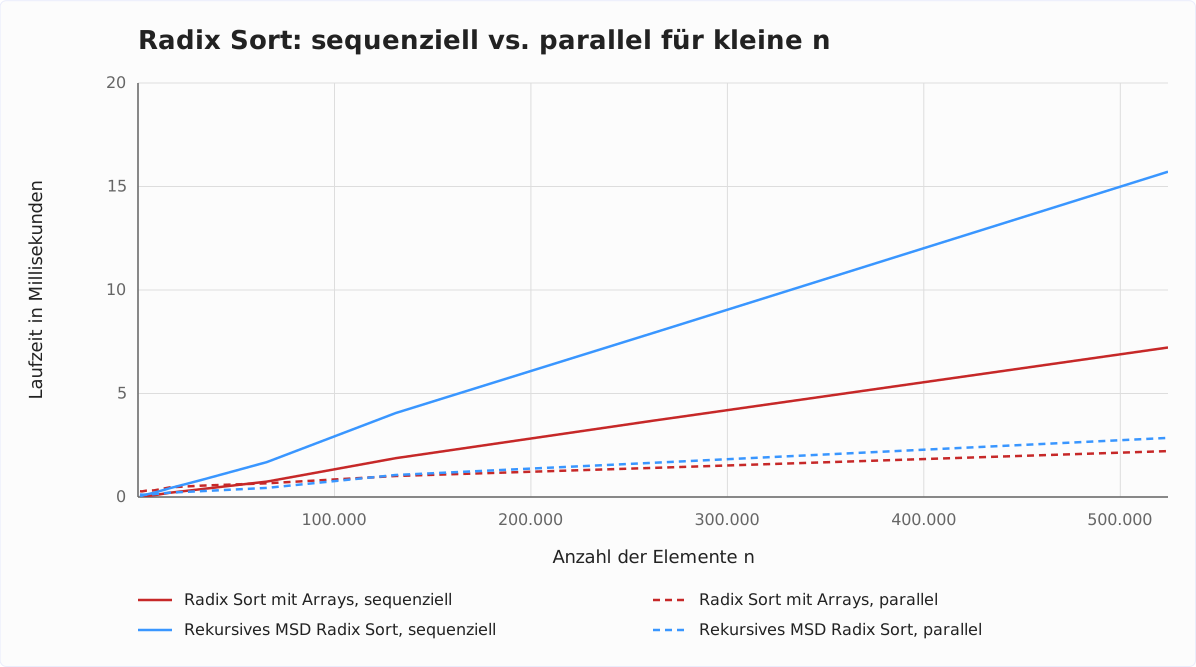
Bei einer halben Million Elemente ist das parallele Radix Sort mit Arrays nur 3,3-mal schneller als die sequenzielle Variante, die parallele MSD-Variante 5,5-mal. Unter 65.536 Elementen (Arrays) bzw. 4.096 Elementen (MSD) sind die parallelen Varianten sogar langsamer als die sequenziellen.
Radix Sort vs. Counting Sort
Beide Sortierverfahren verwenden Buckets zum Sortieren. Bei Counting Sort benötigen wir einen Bucket für jeden Wert. Wollten wir beispielsweise Integers sortieren, bräuchten wir etwa vier Milliarden Buckets. Bei Radix Sort hingegen entspricht die Anzahl der Buckets der gewählten Basis.
Bei Radix Sort sortieren wir iterativ Ziffer für Ziffer; bei Counting Sort sortieren wir die Elemente in einer einzigen Iteration.
Counting Sort eignet sich daher in erster Linie für kleine Zahlenräume.
Radix Sort vs. Bucket Sort
Bei Bucket Sort werden die Elemente zunächst so auf eine vorgegebene Anzahl Buckets verteilt, dass alle Elemente eines Buckets größer sind als alle Elemente des vorherigen Buckets (z. B. 0–99, 100–199, 200–299 usw.).
Danach wird jeder Bucket in sich sortiert – rekursiv mit Bucket Sort oder mit einem anderen Sortierverfahren; welches, legt Bucket Sort nicht fest. Abschließend werden die Elemente aus den sortierten Buckets aneinandergereiht.
Falls dir das bekannt vorkommt – eine Form von Bucket Sort hast du in diesem Artikel kennengelernt: das rekursive MSD Radix Sort.
Zusammenfassung
Radix Sort ist ein stabiler Sortieralgorithmus mit einer allgemeinen Zeitkomplexität von O(k · (b + n)), wobei k für die maximale Schlüssellänge („key length“) der zu sortierenden Elemente steht und b für die Basis.
Ist die maximale Länge der zu sortierenden Elemente bekannt und die Basis festgelegt, dann beträgt die Zeitkomplexität O(n).
Für nicht-negative Integers ist Radix Sort schneller als Quicksort (zumindest in meiner Testumgebung). Solltest du zeitkritische Sortiervorgänge in Java implementieren müssen, empfehle ich dir, Arrays.sort() mit einer Implementierung von Radix Sort zu vergleichen.
Weitere Sortieralgorithmen findest du in der Übersicht aller Sortieralgorithmen und ihrer Eigenschaften im ersten Teil der Artikelserie.
Hat dir dieser Artikel Zeit gespart? Dann freue ich mich, wenn du eine Minute davon in eine Bewertung auf meinem ProvenExpert-Profil investierst. Dein Feedback zeigt mir, dass sich die Arbeit an diesen Artikeln lohnt.