Ein int in einen String umwandeln – dafür gibt es in Java vier Wege. Welcher ist der schnellste?
Ich habe alle vier mit JMH-Microbenchmarks gemessen: auf Java 8 bis 27, jede Version mehrfach, auf einem x86- und einem arm64-Rechner. Das Ergebnis ist eindeutig – und es ist ein anderes als das, was die erste Fassung dieses Artikels 2019 behauptet hat. Warum die alte Antwort falsch war, zeige ich dir auch.
Wenn dich nur die Empfehlung interessiert: Hier geht es direkt zum Fazit.
Vier Varianten für die int-zu-String-Umwandlung
Abgesehen von absichtlich umständlichen Konstruktionen gibt es diese vier Optionen:
- Option 1:
Integer.toString(i) - Option 2:
String.valueOf(i) - Option 3:
String.format("%d", i) - Option 4:
"" + i
String.valueOf(i) ruft intern Integer.toString(i) auf. String.format() schickt die Zahl durch den Formatter. Und "" + i ist die Variante, bei der es interessant wird: Was daraus wird, entscheidet seit Java 9 nicht mehr der Compiler, sondern die JVM. Dazu später mehr.
Der Messaufbau
Für die Messung nutze ich den Java Microbenchmark Harness, kurz JMH – ein Framework, das kurze Code-Abschnitte millionenfach ausführt, erst nach einer Aufwärmphase für den JIT-Compiler zu messen beginnt und schließlich den Durchsatz samt Fehlerintervall ausgibt.
Ein gutes Einsteiger-Tutorial findest du bei Jakob Jenkov. Für IntelliJ gibt es ein JMH-Plugin, mit dem du Benchmarks direkt aus der IDE startest.
Der Benchmark
Den kompletten Quellcode findest du in meinem GitHub-Repository. Der eigentliche Benchmark ist kurz:
public class IntToStringBenchmark {

  @Benchmark
  public void option1(RandomInts state, Blackhole blackhole) {
    String s = Integer.toString(state.next());
    blackhole.consume(s);
  }

  @Benchmark
  public void option2(RandomInts state, Blackhole blackhole) {
    String s = String.valueOf(state.next());
    blackhole.consume(s);
  }

  @Benchmark
  public void option3(RandomInts state, Blackhole blackhole) {
    String s = String.format("%d", state.next());
    blackhole.consume(s);
  }

  @Benchmark
  public void option4(RandomInts state, Blackhole blackhole) {
    String s = "" + state.next();
    blackhole.consume(s);
  }

}
Die Zahlen kommen aus einem JMH-State. Darin initialisieren wir einmalig im Voraus ein Array mit 1.024 zufälligen Zahlen, und jeder Aufruf der Testmethode holt sich dann über die next()-Methode eine dieser Zahlen.
@State(Scope.Thread)
public class RandomInts {

  private static final int SIZE = 1024;

  private final int[] values = new int[SIZE];
  private int index;

  @Setup(Level.Trial)
  public void doSetup() {
    ThreadLocalRandom random = ThreadLocalRandom.current();
    for (int k = 0; k < SIZE; k++) {
      values[k] = 1_000_000 + random.nextInt(9_000_000);
    }
  }

  public int next() {
    return values[index++ & (SIZE - 1)];
  }

}
Drei Dinge daran sind Absicht:
- Die Zahlen sind zufällig, damit der JIT-Compiler die Umwandlung nicht wegoptimiert – die Umwandlung einer Konstante in einen String würde er kurzerhand durch das Ergebnis dieser Umwandlung ersetzen.
- Alle Zahlen haben sieben Stellen, damit jeder String gleich lang ist.
- Das Ergebnis wandert in ein
Blackhole– aus demselben Grund wie im ersten Punkt.
Und ein viertes Detail ist der Grund für die neue Fassung dieses Artikels: Die 1.024 Zahlen werden einmal pro Messlauf gezogen (Level.Trial), nicht vor jedem einzelnen Aufruf.
Die Testumgebung
Gemessen habe ich auf zwei Rechnern:
- einem Dell XPS 17 mit Intel Core i7-12700H (sechs Performance- und acht Efficiency-Kerne) unter WSL2 und
- einem Mac mit Apple M5 Pro (18 Kerne).
Als Java-Versionen kamen 8, 11, 17, 21, 22, 23, 24, 25 und 27 zum Einsatz, jeweils OpenJDK-Builds. JMH lief mit drei Forks zu je fünf Aufwärm- und fünf Messiterationen von fünf Sekunden – und mit dem GC-Profiler, der zu jeder Variante die allokierten Bytes pro Aufruf liefert. Und jede Version habe ich fünfmal gemessen; warum, steht in der folgenden Info-Box.
Noch ein Detail: Der Bytecode für "" + i hängt vom Compiler ab. Deshalb habe ich für jede Java-Version ein eigenes JAR gebaut, mit dem javac-Compiler dieser Version. Jede Spalte der Tabellen zeigt dir also das, was du bekommst, wenn du deinen Code mit genau dieser Java-Version kompilierst und ausführst. Was passiert, wenn mit Java 8 kompilierter Bytecode auf einer neuen JVM läuft, zeige ich dir im Abschnitt „Unter der Haube“.
Die Messergebnisse
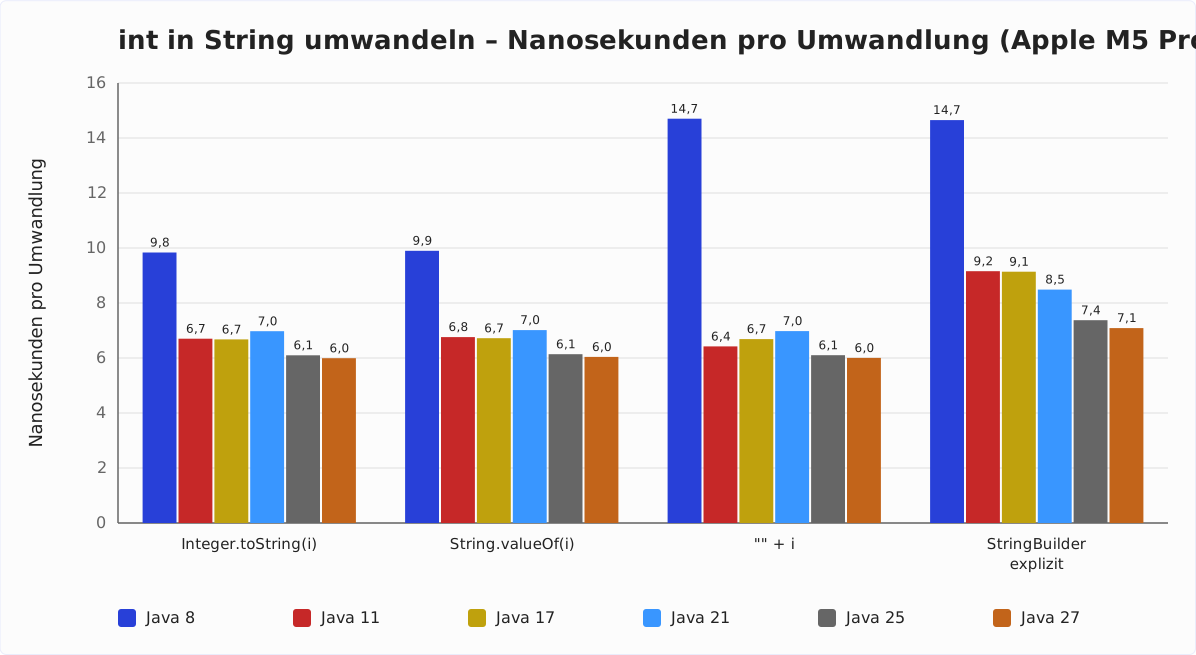
Die Tabellen zeigen, wie lang eine Umwandlung dauert, in Nanosekunden, als Mittelwert aus fünf Durchläufen – je weniger, desto besser. Die Spannweite der fünf Durchläufe liegt auf dem M5 Pro bei höchstens zwei Prozent des Mittelwerts, auf dem i7 bei höchstens vier Prozent; Ausnahmen sind Java 8, String.format() und zwei einzelne Zellen auf dem i7. In den Tabellen ist die Spannweite der Übersichtlichkeit halber weggelassen. Die Rohdaten aller Durchläufe mit Iterationen, Fehlerintervallen und Bytes pro Aufruf findest du als JMH-JSON im results/-Verzeichnis des Benchmark-Repositorys.
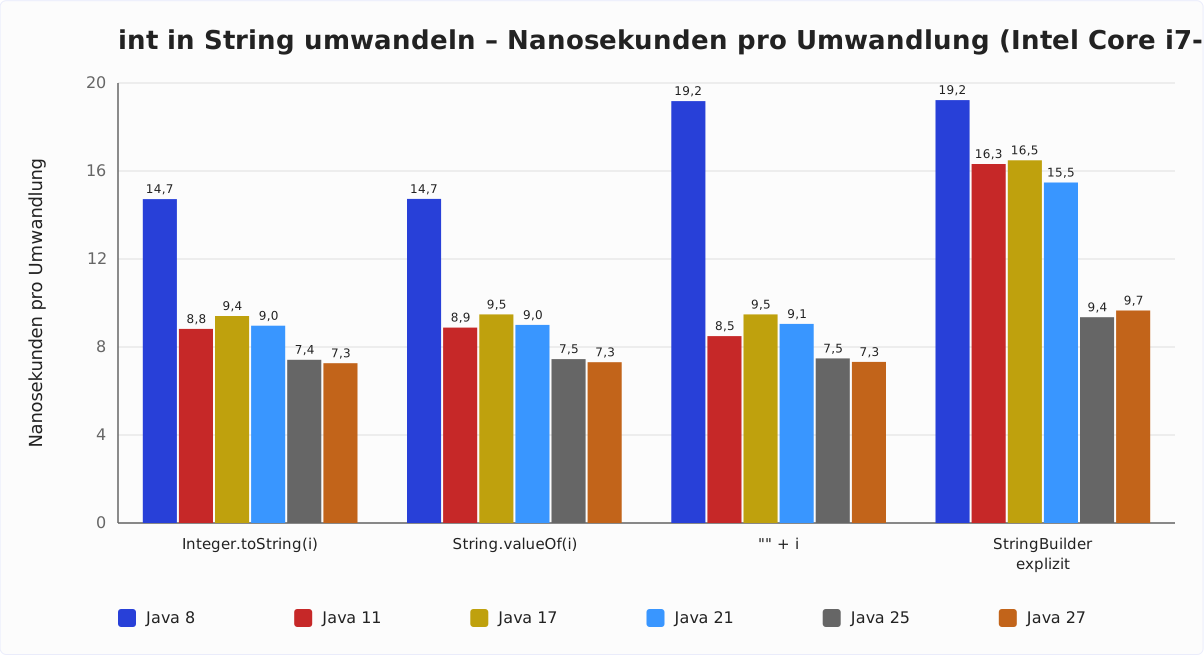
Die letzte Zeile jeder Tabelle – new StringBuilder().append("").append(i).toString() – ist keine der vier Varianten, sondern eine fünfte Messung. Genau diesen Code erzeugt der Compiler bis Java 8 aus "" + i. Ich habe ihn mitgemessen, weil er erklärt, warum "" + i auf Java 8 aus der Reihe fällt: Du siehst es an den Zahlen für Java 8 – identisch.
Intel Core i7-12700H (x86)
| Java 8 | Java 11 | Java 17 | Java 21 | Java 22 | Java 23 | Java 24 | Java 25 | Java 27 | |
|---|---|---|---|---|---|---|---|---|---|
Integer.toString(i) | 14,7 | 8,8 | 9,4 | 9,0 | 8,5 | 8,2 | 8,1 | 7,4 | 7,3 |
String.valueOf(i) | 14,7 | 8,9 | 9,5 | 9,0 | 8,4 | 8,2 | 8,1 | 7,5 | 7,3 |
"" + i | 19,2 | 8,5 | 9,5 | 9,1 | 8,4 | 8,3 | 8,2 | 7,5 | 7,3 |
String.format("%d", i) | 176,6 | 158,9 | 55,6 | 62,1 | 60,0 | 56,0 | 56,2 | 57,6 | 56,3 |
expliziter StringBuilder | 19,2 | 16,3 | 16,5 | 15,5 | 11,5 | 13,7 | 11,0 | 9,4 | 9,7 |
Im Diagramm dazu fehlt String.format(): Mit bis zu 177 Nanosekunden würde dieser Messwert die übrigen Balken so stark zusammendrücken, dass dort keine Unterschiede mehr erkennbar wären. Diese Variante bekommt weiter unten ihr eigenes Diagramm. Außerdem zeigt das Diagramm nur die LTS-Reihe plus das aktuelle GA-Release – Java 8, 11, 17, 21, 25 und 27; die Zwischenversionen 22 bis 24 stehen in der Tabelle darüber.
Apple M5 Pro (arm64)
| Java 8 | Java 11 | Java 17 | Java 21 | Java 22 | Java 23 | Java 24 | Java 25 | Java 27 | |
|---|---|---|---|---|---|---|---|---|---|
Integer.toString(i) | 9,8 | 6,7 | 6,7 | 7,0 | 6,2 | 6,1 | 6,1 | 6,1 | 6,0 |
String.valueOf(i) | 9,9 | 6,8 | 6,7 | 7,0 | 6,3 | 6,1 | 6,1 | 6,1 | 6,0 |
"" + i | 14,7 | 6,4 | 6,7 | 7,0 | 6,2 | 6,1 | 6,1 | 6,1 | 6,0 |
String.format("%d", i) | 150,2 | 145,3 | 149,0 | 45,0 | 43,2 | 42,1 | 41,1 | 40,6 | 39,7 |
expliziter StringBuilder | 14,7 | 9,2 | 9,1 | 8,5 | 7,7 | 12,0 | 7,5 | 7,4 | 7,1 |
Auch hier das Diagramm ohne String.format() und ohne die Versionen 22 bis 24, aus denselben Gründen.
Was die Zahlen sagen
Drei Varianten, eine Operation
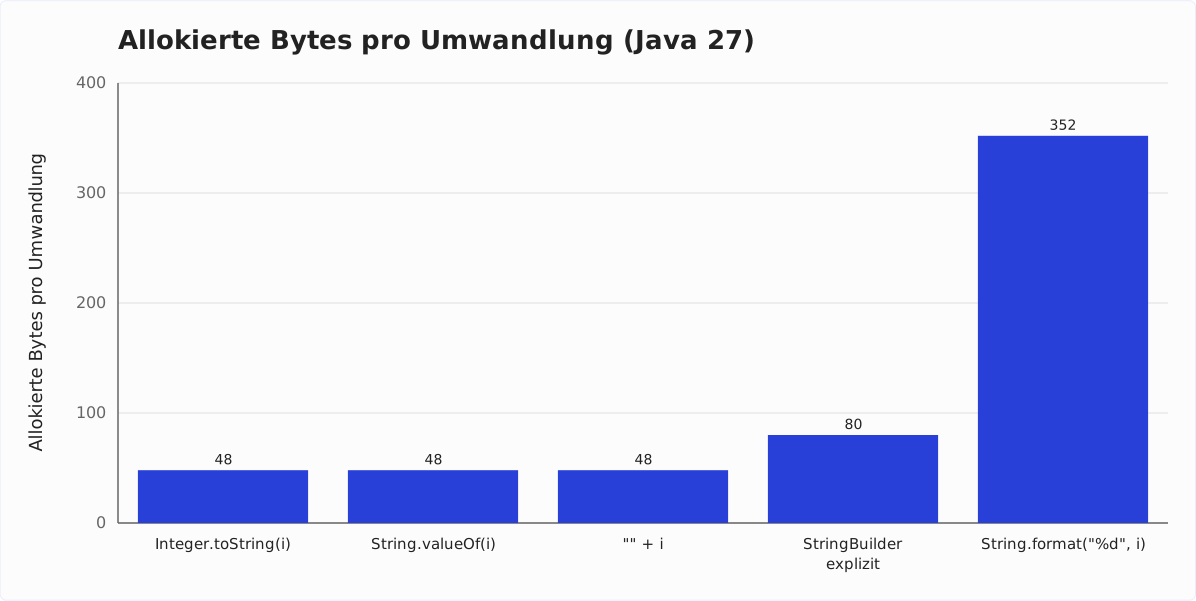
Seit Java 17 liegen Integer.toString(i), String.valueOf(i) und "" + i gleichauf – auf beiden Rechnern, in jeder Version: Der größte Unterschied zwischen den drei Methoden liegt unter einem Prozent. Der GC-Profiler bestätigt, dass das kein Zufall ist: Alle drei allokieren 48 Bytes pro Umwandlung, nämlich genau einen String mit einem Byte-Array für sieben Ziffern.
Es ist dieselbe Arbeit. Integer.toString() berechnet vorab die Stellenzahl, legt ein Array exakt dieser Länge an und schreibt die Ziffern hinein. Und "" + i macht seit Java 9 – über einen Umweg, den ich dir gleich zeige – das Gleiche.
Auf Java 11 liegt "" + i sogar 4 bis 5 % vorn. Auf Java 8 dagegen deutlich zurück: 30 % langsamer auf x86, knapp 50 % langsamer auf dem M5 Pro. Der Grund ist die StringBuilder-Kette, die javac 8 daraus macht – mit einem Puffer für 16 Zeichen, der am Ende in ein Array der richtigen Länge kopiert wird. Die letzte Tabellenzeile zeigt: Diese Kette bleibt auch auf neuen JVMs die langsamere Option, und sie allokiert 80 statt 48 Bytes – meistens jedenfalls; diese Zeile bekommt weiter unten ein eigenes Kapitel.
Von Java 8 bis 27: kein gerader Weg
Der große Schritt liegt zwischen Java 8 und 11: Integer.toString() wird auf dem i7 40 % schneller, auf dem M5 Pro 32 % – und "" + i auf beiden 56 %, weil hier zusätzlich der Bytecode wechselt: von der StringBuilder-Kette aus javac 8 zu invokedynamic.
Danach ist es keine gerade Linie mehr, und die beiden Rechner gehen verschiedene Wege. Auf dem i7 ist Java 17 langsamer als Java 11 – um 7 % bei Integer.toString() und String.valueOf(), um 12 % bei "" + i –, und erst ab Java 21 sinkt die Zeit wieder, am deutlichsten von 24 auf 25 mit 8 %. Auf dem M5 Pro sind Java 11 und 17 bei Integer.toString() und String.valueOf() nicht zu unterscheiden, "" + i wird 4 % langsamer. Java 21 ist dann gut 4 % langsamer als 17, Java 22 macht das mit 10 % mehr als wett. Zwischen 23 und 24 tut sich nichts, was sich vom Messrauschen unterscheiden ließe, und von 25 auf 27 wird es noch einmal knapp 2 % schneller.
Unterm Strich braucht eine Umwandlung auf Java 27 auf dem i7 nur noch halb so lang wie auf Java 8, auf dem M5 Pro 39 % weniger. Woran die Rückschritte auf Java 17 (i7) und Java 21 (M5 Pro) liegen, habe ich nicht untersucht – für die Empfehlung am Ende spielt es keine Rolle, denn wo eine der drei Varianten schneller oder langsamer wird, werden es die anderen beiden im selben Maß.
String.format() ist der Ausreißer
String.format("%d", i) braucht auf Java 27 rund 56 ns auf dem i7 und 40 ns auf dem M5 Pro – das 7,7- bzw. 6,6-Fache der anderen Varianten – und allokiert rund 350 Bytes pro Aufruf: einen Formatter, einen StringBuilder, die geparste Formatspezifikation und den Ergebnis-String.
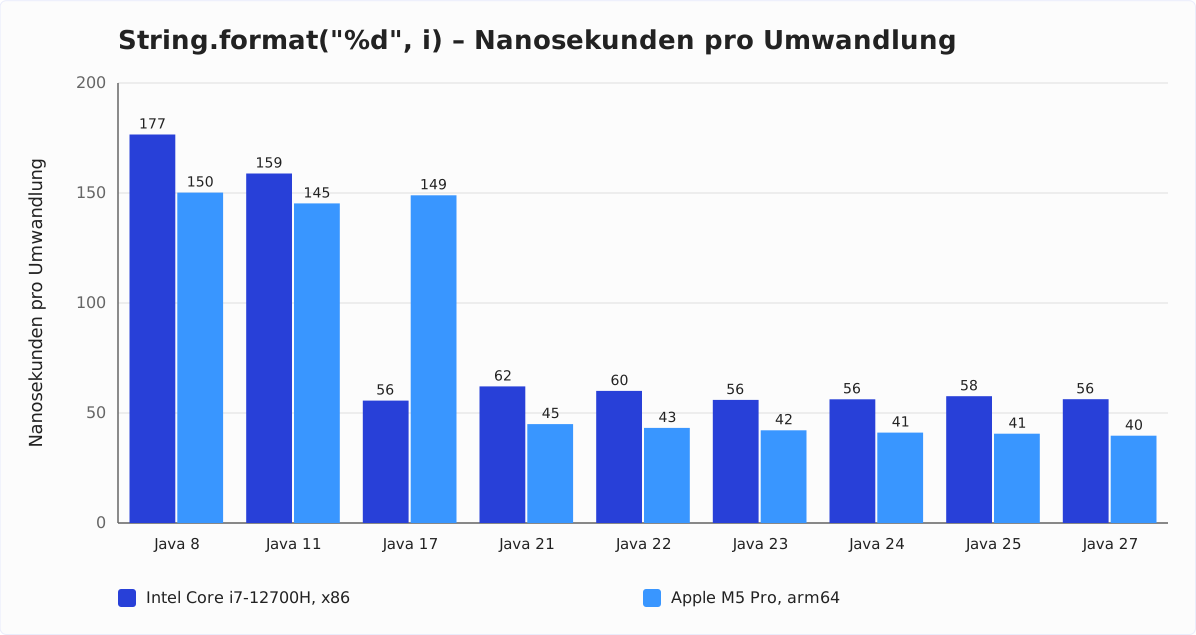
Bis Java 11 war String.format() noch langsamer: 145 bis 177 ns, das 12- bis 22-Fache der anderen Varianten. Seit Java 17 hat der Formatter einen schnellen Pfad für einfache Spezifikationen wie %d und %s, die ohne regulären Ausdruck geparst werden (JDK-8263038). Auf x86 siehst du den Sprung genau dort: von 159 auf 56 ns. Auf dem M5 Pro hingegen erst bei Java 21: Java 17 formatiert dort auch mit Build 17.0.20 in 149 ns und allokiert rund 1.150 Bytes pro Aufruf, dreimal so viel wie auf x86. Der schnelle Pfad ist derselbe Java-Code auf beiden Plattformen – die Ursache liegt also im JIT-Compiler für aarch64 in Java 17. Welche Optimierung dort fehlt, habe ich nicht untersucht.
Die weiteren Schritte sind klein – auf dem M5 Pro liegen die letzten beiden, von Java 24 auf 25 und von 25 auf 27, innerhalb der Streuung –, mit einer Ausnahme: Auf dem i7 ist Java 21 bei dieser Methode 12 % langsamer als Java 17, und erst Java 23 kommt wieder auf dessen Niveau.
Meine Empfehlung: String.format() nur, wenn du wirklich formatierst – Auffüllen mit Nullen, Tausendertrennzeichen, feste Breite. Für die bloße Umwandlung ist es die falsche Methode.
Unter der Haube: Was aus "" + i wird
Um zu verstehen, warum "" + i seit Java 9 gleich schnell ist wie Integer.toString(), schauen wir uns den Bytecode an. Dazu eine Datei IntToStringFast.java mit folgendem Inhalt:
import java.util.Random;

public class IntToStringFast {
  public static void main(String[] args) {
    int i = new Random().nextInt();
    System.out.println("" + i);
  }
}
Kompilieren:
javac IntToStringFast.javaUnd den Bytecode anzeigen lassen:
javap -c IntToStringFast.classJava 8: eine StringBuilder-Kette
Mit javac 8 sieht der relevante Ausschnitt so aus:
14: new           #6          // class java/lang/StringBuilder
17: dup
18: invokespecial #7          // Method java/lang/StringBuilder."<init>":()V
21: ldc           #8          // String
23: invokevirtual #9          // Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;
26: iload_1
27: invokevirtual #10         // Method java/lang/StringBuilder.append:(I)Ljava/lang/StringBuilder;
30: invokevirtual #11         // Method java/lang/StringBuilder.toString:()Ljava/lang/String;
Das entspricht diesem Java-Code:
new StringBuilder().append("").append(i).toString();Das append("") hat der Compiler nicht einmal wegoptimiert. Der StringBuilder legt einen char-Puffer für 16 Zeichen an, hängt einen leeren String an, schreibt die Ziffern hinein, und toString() kopiert sie in ein neues Array der exakten Länge. Zwei Arrays statt einem, eine Kopie – so werden aus 48 Bytes 80 Bytes.
Seit Java 9: invokedynamic
Ab javac 9 wird aus derselben Zeile Java-Code ein einziger Bytecode-Befehl:
15: invokedynamic #6, 0 // InvokeDynamic #0:makeConcatWithConstants:(I)Ljava/lang/String;Der Compiler legt sich nicht mehr fest, wie verkettet wird. Er hinterlässt nur ein „Rezept“ – hier: eine Konstante, gefolgt von einem int – und überlässt den Rest der JVM. Beim ersten Aufruf baut StringConcatFactory daraus eine Verkettungsmethode, und die geht anders vor als der StringBuilder: Sie berechnet zuerst die Länge des Ergebnisses – null Zeichen für die leere Konstante plus die Stellenzahl der Zahl – legt das Zielarray in exakt dieser Größe an und schreibt die Ziffern direkt hinein. Kein Puffer, keine Kopie. Das ist dieselbe Arbeit, die auch Integer.toString() macht, und deshalb sind es dieselben 48 Bytes und dieselben Nanosekunden.
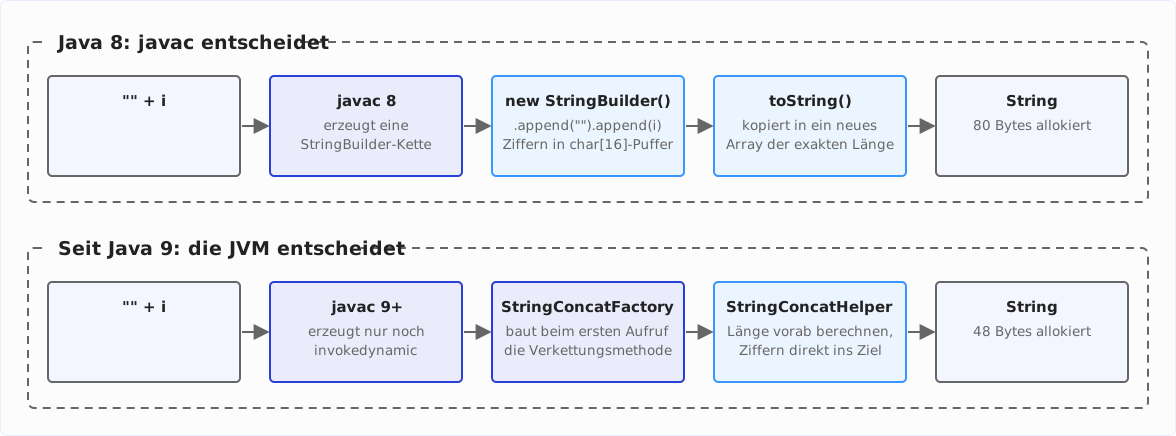
Dieser Mechanismus heißt Indified String Concatenation und kam mit JEP 280 in Java 9. Der Vorteil des Umwegs: Die JVM kann die Strategie verbessern, ohne dass du deinen Code erneut kompilieren musst.
Der Beweis: alter Bytecode auf neuen JVMs
Wenn die Erklärung stimmt, muss "" + i auch auf einer aktuellen JVM langsamer sein als Integer.toString() – vorausgesetzt, es ist als StringBuilder-Kette kompiliert. Das lässt sich prüfen: Ich habe den Benchmark zusätzlich mit --release 8 kompiliert. Dann erzeugt auch ein aktueller javac die alte StringBuilder-Kette. Dieses eine JAR habe ich unverändert auf allen JVMs laufen lassen. "" + i ist dann deutlich langsamer als Integer.toString():
| Java 11 | Java 17 | Java 21 | Java 22 | Java 23 | Java 24 | Java 25 | Java 27 | |
|---|---|---|---|---|---|---|---|---|
| x86 | +91 % | +71 % | +69 % | +35 % | +64 % | +32 % | +24 % | +31 % |
| arm64 | +43 % | +37 % | +22 % | +25 % | +98 % | +24 % | +21 % | +19 % |
Der Ausschlag auf Java 23 – und auf dem i7 auch die hohen Werte bis Java 21 – hat denselben Grund wie die Sprünge in der StringBuilder-Zeile der Tabellen oben: einen Allokationspfad, den ich im nächsten Kapitel zeige.
Baut dein Projekt noch mit --release 8 oder -target 8, oder läuft es gar noch auf Java 8, ist String.valueOf(i) also die schnellere Wahl.
Die Gegenprobe habe ich auch gemacht: ein JAR mit --release 11 auf allen JVMs ab Java 17. Es liefert auf jeder JVM-Version dieselben Zahlen wie das JAR, das mit dem javac der entsprechenden Version gebaut wurde – auf 0,1 ns genau. Der Compiler hat seit Java 11 an der Verkettung nichts mehr geändert – die Fortschritte kamen aus der JVM.
Der explizite StringBuilder: 80 Bytes, 104 Bytes und ein Widerspruch
Die fünfte Tabellenzeile – new StringBuilder().append("").append(i).toString() – ist keine der vier Varianten, mit denen dieser Artikel begonnen hat, hat aber mehr zu erzählen als alle vier zusammen. Deshalb bekommt sie ein eigenes Kapitel.
Auf Java 8 misst diese StringBuilder-Kette dasselbe wie "" + i, das hast du in den Tabellen gesehen. Ab Java 11 bleibt sie hinter den drei gleich schnellen Varianten zurück: auf dem i7 um 85 % auf Java 11 und noch um 33 % auf Java 27, auf dem M5 Pro um 37 % und 18 %. Der Grund steht im vorigen Kapitel: ein Puffer für 16 Zeichen, der am Ende in ein Array der exakten Länge kopiert wird.
Der GC-Profiler zeigt, was diese Zeile allokiert – und hier wird es interessant. Ein String aus sieben Ziffern kostet 48 Bytes: 24 für das String-Objekt und 24 für sein byte-Array. Der Puffer im StringBuilder, ein byte-Array für 16 Zeichen, kostet 32 Bytes. Und das StringBuilder-Objekt selbst 24. Zusammen sind das 104 Bytes. Gemessen werden aber meist 80: Die fehlenden 24 Bytes sind genau das StringBuilder-Objekt – es verlässt die Methode nie, und die Escape-Analyse des JIT-Compilers spart die Allokation ein.
Meist – nicht immer. Auf dem M5 Pro allokiert Java 23 die vollen 104 Bytes, und die Zeit springt von 7,7 auf 12,0 ns, 55 % nach oben; Java 24 ist mit 7,5 ns und 80 Bytes wieder da, wo 22 war. Das ist kein Messrauschen: fünf Durchläufe, Spannweite 0,3 %.
Auf dem i7 ist es keine Java-23-Geschichte. Dort allokieren Java 11, 17, 21 und 23 die 104 Bytes; nur Java 22, 24, 25 und 27 kommen mit 80 aus. Und dort siehst du den Preis auch in der Zeit: Java 22 ist 26 % schneller als 21, Java 23 fällt um 19 % zurück, Java 24 holt das wieder ein. Die Frage ist also nicht, was in Java 23 schiefgeht, sondern warum Java 22 den kürzeren Pfad findet und Java 23 ihn wieder verliert – und warum der eine Rechner ihn schon ab Java 11 hat, der andere erst ab 22. Welche Optimierung hier entscheidet, habe ich nicht untersucht.
Dass es an der JVM liegt und nicht an meinem Benchmark, zeigt das JAR aus dem Abschnitt „Der Beweis“: Mit --release 8 kompiliert, ist "" + i dieselbe StringBuilder-Kette – und zeigt exakt dasselbe Muster, 104 und 80 Bytes in derselben Reihenfolge, mit demselben Sprung bei Java 23 (auf dem i7 13,5 ns zwischen 11,4 und 10,8 ns, auf dem M5 Pro 12,1 ns zwischen 7,8 und 7,5 ns). Daher der Ausschlag von 98 % in der Tabelle dort.
Und der Widerspruch? Zwischen Java 25 und 27 ist der explizite StringBuilder die einzige Zeile der ganzen Messreihe, bei der die beiden Rechner sich widersprechen: Auf dem M5 Pro ist Java 27 3,9 % schneller (7,09 statt 7,37 ns), auf dem i7 3,3 % langsamer (9,66 statt 9,35 ns). Beides ist über fünf Durchläufe hinweg eindeutig, und beides bleibt, wenn man die Durchläufe weglässt, in denen ein anderer Prozess mehr als einen halben Kern beschäftigt hat.
Wo die Ursache nicht liegt, habe ich geprüft: Der Bytecode des Benchmarks ist auf beiden JDKs identisch, der Quellcode von StringBuilder und AbstractStringBuilder bis auf zwei entfernte Methoden, die dieser Pfad nicht benutzt, ebenso die Allokation (80 Bytes auf beiden) und sogar die Inlining-Entscheidungen des C2-Compilers – dieselben 46 Aufrufe, dieselben Entscheidungen. Was bleibt, ist der Maschinencode, den C2 aus identischem Zwischencode erzeugt: Registerzuteilung, Befehlsreihenfolge. Um den zu vergleichen, braucht es hsdis und -XX:+PrintAssembly, auf beiden Architekturen – das steht noch aus.
Was heißt das für dich? Für eine einzelne Umwandlung ist die StringBuilder-Kette in jeder Version die langsamere Wahl, und ob sie 80 oder 104 Bytes kostet, entscheidet die JVM-Version, nicht du. Wenn dein Bytecode mit --release 8 entsteht, läuft genau diese Kette – siehe oben.
Zusammenfassung
Seit Java 9 sind Integer.toString(i), String.valueOf(i) und "" + i dieselbe Operation: sie sind gleich schnell, und alle drei allokieren pro Umwandlung dieselben 48 Bytes – genau einen String, keinen Zwischenpuffer – auf x86 wie auf arm64. Welche du nimmst, entscheidet die Lesbarkeit, nicht die Geschwindigkeit. Von Version zu Version wird die Umwandlung mal schneller und mal langsamer – aber immer für alle drei Varianten gleichermaßen.
Ich empfehle String.valueOf(i): Du siehst auf den ersten Blick, dass hier umgewandelt wird, und die Variante ist schnell, egal mit welchem Compiler dein Bytecode entstanden ist – anders als "" + i, das auf Java 8 und mit --release 8 deutlich zurückfällt. "" + i ist gleichwertig, sobald dein Bytecode von einem javac ab Version 9 stammt; manche lesen es als Trick, deshalb ist es Geschmackssache im Team.
String.format("%d", i) nimmst du nur, wenn du wirklich formatierst. Für die bloße Umwandlung kostet es rund das Siebenfache. Und die StringBuilder-Kette von Hand ist in jeder Version die langsamere Wahl – ob sie 80 oder 104 Bytes allokiert, entscheidet die JVM-Version.
Und das Ergebnis von 2019, nach dem "" + i die schnellste Variante war? Es war ein Artefakt des Benchmarks, nicht eine Eigenschaft von Java. Die Info-Box im Abschnitt „Der Benchmark“ erklärt, was schiefging – falls du selbst Microbenchmarks schreibst, ist das der Teil dieses Artikels, der dir die meiste Zeit spart.
Im nächsten Artikel geht es in die andere Richtung: Was du beim Parsen von Strings in ints beachten musst – und was Boxing dabei kostet.
Hat dir dieser Artikel Zeit gespart? Dann freue ich mich, wenn du eine Minute davon in eine Bewertung auf meinem ProvenExpert-Profil investierst. Dein Feedback zeigt mir, dass sich die Arbeit an diesen Artikeln lohnt.
Möchtest du informiert werden, wenn ich das nächste Java-Release unter die Lupe nehme? Dann klicke hier, um dich für den HappyCoders-Newsletter anzumelden.