Ein Ringpuffer ist ein Array fester Größe, das du wie einen Kreis benutzt: Ist das letzte Feld beschrieben, geht es mit dem ersten weiter. Zwei Indizes – einer zum Schreiben, einer zum Lesen – wandern dabei immer in dieselbe Richtung, und kein Element wird jemals verschoben.
In diesem Artikel erfährst du:
- wie ein Ringpuffer Schritt für Schritt funktioniert – und warum sich an den beiden Indizes allein nicht ablesen lässt, ob er voll oder leer ist,
- wie du einen Ringpuffer in Java selbst implementierst,
- welche drei Varianten es gibt und wo sie im JDK stecken: in
ArrayBlockingQueue,ArrayDequeundMemoryHandler, - und was der LMAX Disruptor anders macht.
Was ist ein Ringpuffer?
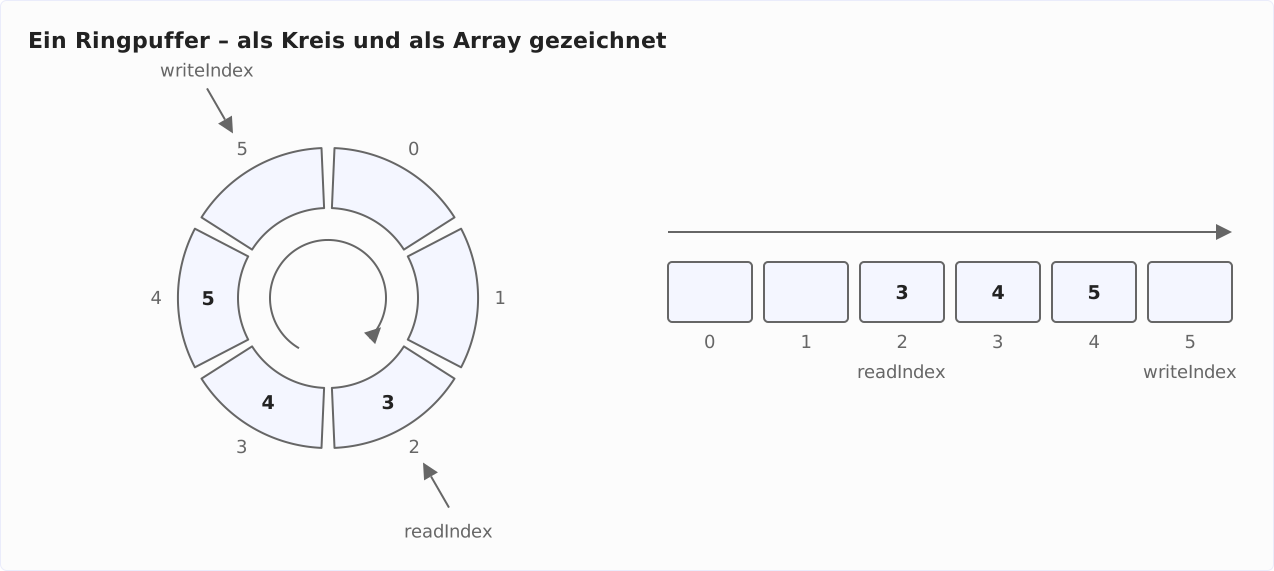
Ein Ringpuffer (englisch „ring buffer“ oder „circular buffer“) ist ein Array fester Länge, dessen Felder du dir auf einem Kreis angeordnet vorstellen kannst: Auf das letzte Feld folgt wieder das erste. Zwei Indizes zeigen in das Array – der Schreibindex auf das nächste freie Feld, der Leseindex auf das älteste Element.
Die folgende Grafik zeigt denselben Ringpuffer zweimal: links als Kreis, rechts als flaches Array. Er hat sechs Felder; in den Feldern 2 bis 4 liegen die Elemente 3, 4 und 5. readIndex zeigt auf die 3 in Feld 2, writeIndex auf das freie Feld 5. Die beiden Pfeile geben die Schreibrichtung an – im Kreis im Uhrzeigersinn, im Array nach rechts.
Elemente werden am Schreibindex eingefügt und am Leseindex entnommen, in der Reihenfolge, in der sie geschrieben wurden. Ein Ringpuffer ist damit eine Queue nach dem FIFO-Prinzip, deren Kapazität von Anfang an feststeht.
Für diese Datenstruktur gibt es mehrere Namen, die alle dasselbe meinen: „ring buffer“, „circular buffer“, „Ringbuffer“, „Ringspeicher“ – und „circular array“ für das Array selbst. Eine „circular queue“ ist die Queue, die auf einem solchen Array aufsetzt.
Was gewinnst du durch den Kreis? Beim Entnehmen muss kein Element nachrücken, und beim Einfügen muss kein Speicher angefordert werden: Das Array wird einmal angelegt und danach nur noch beschrieben. Schreiben und Lesen kosten deshalb immer dieselbe Zeit, unabhängig davon, wie voll der Puffer ist – mehr dazu im Abschnitt „Zeitkomplexität der Ringpuffer-Operationen“.
So funktioniert ein Ringpuffer
Schreiben und Lesen mit zwei Indizes
Beim Schreiben landet das neue Element in dem Feld, auf das writeIndex zeigt; danach rückt writeIndex um ein Feld weiter. Beim Lesen wird das Element aus dem Feld entnommen, auf das readIndex zeigt – das Feld wird auf null gesetzt –, und readIndex rückt um ein Feld weiter.
Beide Indizes bewegen sich also nur in eine Richtung. Der Leseindex läuft dem Schreibindex hinterher, und zwischen den beiden liegen die Elemente, die noch nicht gelesen wurden.
In der Grafik oben liegen drei Elemente dazwischen: die 3, die 4 und die 5. Die 1 und die 2 wurden bereits gelesen – ihre Felder 0 und 1 sind wieder frei.
Die folgende Grafik zeigt beide Operationen am Kreis, von links nach rechts. Links der Puffer aus der ersten Grafik. In der Mitte derselbe Puffer, nachdem write(6) die 6 in Feld 5 abgelegt hat – writeIndex steht jetzt auf dem Nachbarfeld 0. Rechts der Puffer, nachdem read() die 3 aus Feld 2 entnommen hat – readIndex steht jetzt auf Feld 3:
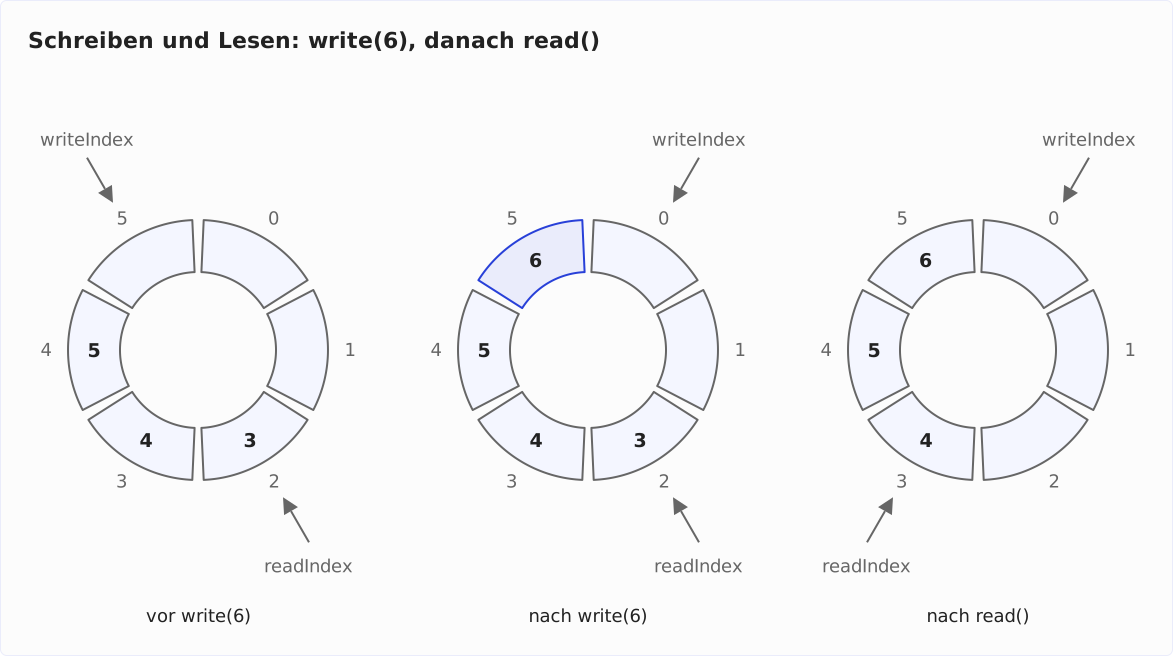
Im Kreis ist an write(6) nichts Besonderes: Feld 0 ist der Nachbar von Feld 5. Im flachen Array wird derselbe Schritt zum Sprung – darum geht es im nächsten Abschnitt.
Der Umbruch: vom letzten Feld zurück auf 0
Was passiert im Array, wenn writeIndex auf dem letzten Feld steht? Das zeigt die folgende Grafik. Oben der Puffer aus der ersten Grafik, writeIndex steht auf Feld 5. Unten derselbe Puffer, nachdem die 6 geschrieben wurde: Sie liegt in Feld 5, und writeIndex ist auf Feld 0 gesprungen:
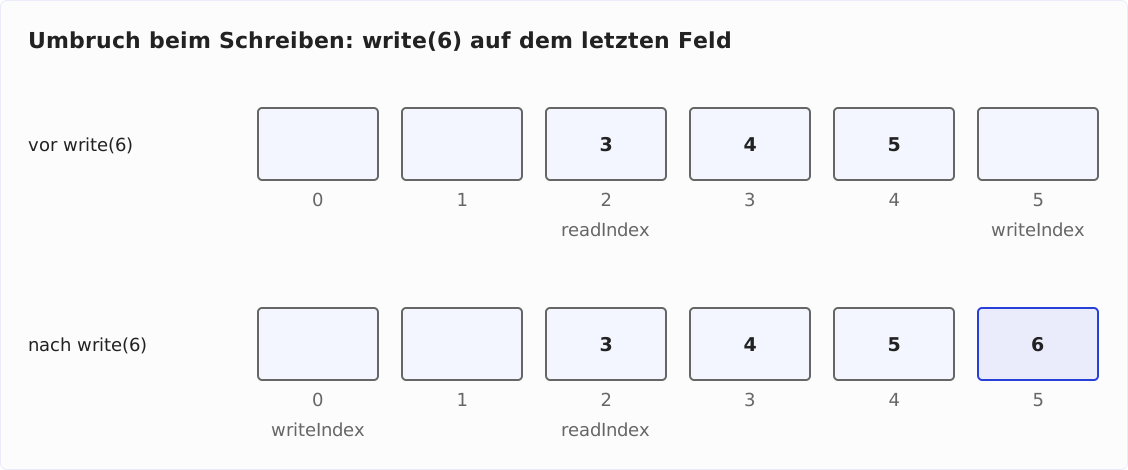
Dieser Sprung ist der ganze Trick des Ringpuffers. Im Code gibt es drei Wege, ihn zu schreiben:
- Vergleich: Der Index wird um 1 erhöht; ist er danach gleich der Länge des Arrays, wird er auf 0 gesetzt. So macht es das JDK, z. B. in
ArrayBlockingQueue:if (++putIndex == items.length) putIndex = 0; - Modulo: Der neue Index ist
(index + 1) % capacity. Für jeden Index unterhalb voncapacity - 1ist dasindex + 1, fürcapacity - 1selbst ist es 0. So rechnet derMemoryHandlerausjava.util.logging: Sein nächstes Schreibfeld ist(start + count) % buffer.length. - Bitmaske: Ist die Kapazität eine Zweierpotenz, etwa 8, liefert
(index + 1) & (capacity - 1)dasselbe Ergebnis wie Modulo: Die Maskecapacity - 1besteht binär nur aus Einsen (für 8:0b111), und ein bitweises Und mit ihr schneidet alle höheren Bits ab – aus 8 (0b1000) wird 0. So macht es der LMAX Disruptor, der deshalb nur Zweierpotenzen als Puffergröße akzeptiert.
Alle drei Wege führen zum selben Ergebnis; sie unterscheiden sich darin, was die CPU ausführt: einen Vergleich, eine Division oder ein bitweises Und. Ich empfehle den Vergleich: Er funktioniert mit jeder Kapazität, und das JDK macht es in ArrayDeque und ArrayBlockingQueue genauso. Die Bitmaske lohnt sich erst, wenn die Kapazität ohnehin eine Zweierpotenz ist.
Voll oder leer? Drei Antworten
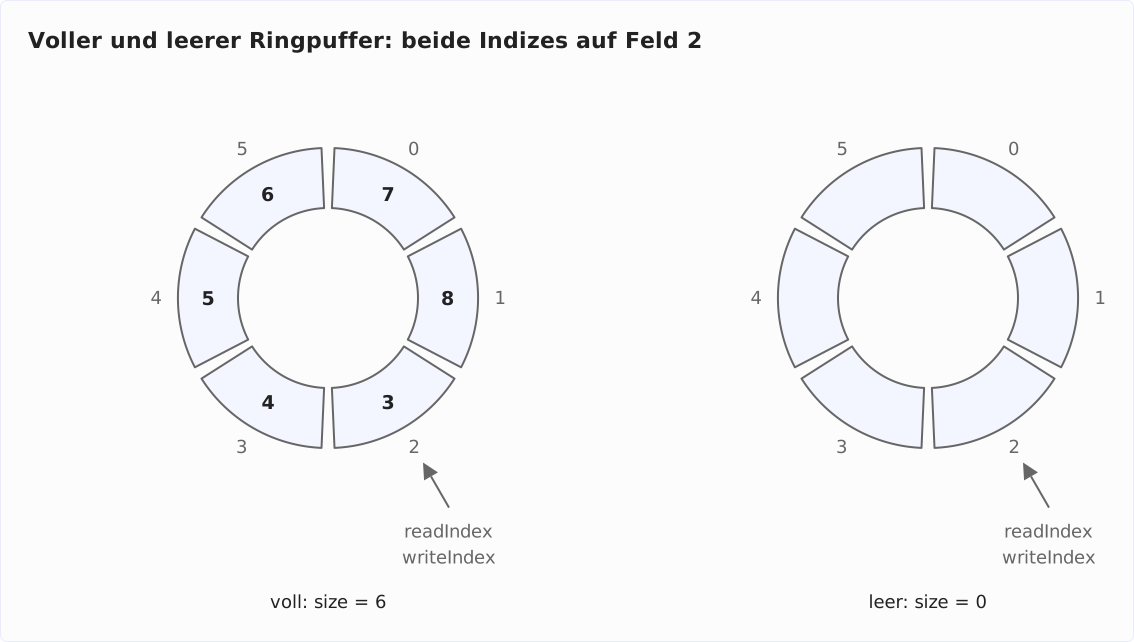
Ist der Puffer voll, zeigt writeIndex auf das Feld, in dem das älteste Element liegt – also auf dasselbe Feld wie readIndex. Ist der Puffer leer, hat readIndex den writeIndex eingeholt: Beide zeigen wieder auf dasselbe Feld.
Die folgende Grafik zeigt beide Fälle. Links ein voller Puffer mit den Elementen 3 bis 8 – nach der 6 in Feld 5 wurden die 7 und die 8 in die Felder 0 und 1 geschrieben –, rechts ein leerer Puffer. In beiden Puffern stehen readIndex und writeIndex auf Feld 2; an den Indizes allein ist der Unterschied nicht zu erkennen:
Drei Lösungen haben sich etabliert, und alle drei findest du im JDK:
- Ein Zähler. Der Puffer führt neben den beiden Indizes die Anzahl der Elemente mit:
size == 0heißt leer,size == capacityheißt voll. So macht esArrayBlockingQueuemit ihrem Feldcount– und so mache ich es in der Implementierung im Abschnitt „Ringpuffer in Java implementieren“. - Ein Feld bleibt frei. Der Puffer wird nie ganz gefüllt;
writeIndexzeigt immer auf ein leeres Feld. Dann heißtreadIndex == writeIndexeindeutig „leer“, und voll ist der Puffer, wenn das Feld nachwriteIndexdas FeldreadIndexist. Der Preis ist ein zusätzliches Feld im Array –ArrayDequezahlt diesen Preis und legt für 16 Elemente ein Array mit 17 Feldern an. - Das Feld prüfen. Zeigen beide Indizes auf dasselbe Feld, entscheidet dessen Inhalt: Ist er
null, ist der Puffer leer, ansonsten voll. Das funktioniert nur, wennnullkein gültiges Element ist –ArrayDequeundArrayBlockingQueuelehnennullbeide ab.ArrayDequebraucht diese Prüfung, obwohl es ein Feld frei hält:addLast()schreibt das neue Element erst in das letzte freie Feld und vergrößert das Array danach. In diesem Moment ist das Array voll, undhead == tailsähe aus wie „leer“ – deshalb prüftgrow()das Feldelements[head], bevor es den Inhalt auseinanderschiebt.
Ich empfehle den Zähler. Er hält den Code am besten lesbar und macht size() zu einem Feldzugriff – für den Preis eines zusätzlichen int-Felds.
Ringpuffer in Java implementieren
Ein Ringpuffer braucht lediglich ein Array, zwei Indizes und einen Zähler. Die folgende Klasse RingBuffer zeigt diese Minimalform – ohne Threadsicherheit: Greifen mehrere Threads gleichzeitig zu, brauchst du ein Lock wie in der ArrayBlockingQueue.
Den Code samt Unit-Tests findest du auch in der Klasse RingBuffer im GitHub-Repository zu diesem Artikel:
public class RingBuffer<E> {

  private final Object[] elements;
  private int readIndex;
  private int writeIndex;
  private int size;

  public RingBuffer(int capacity) {
    if (capacity < 1) {
      throw new IllegalArgumentException("Capacity must be 1 or higher");
    }
    elements = new Object[capacity];
  }

  public void write(E element) {
    if (isFull()) {
      throw new IllegalStateException("The ring buffer is full");
    }
    elements[writeIndex] = element;
    writeIndex = next(writeIndex);
    size++;
  }

  public E read() {
    if (isEmpty()) {
      throw new NoSuchElementException("The ring buffer is empty");
    }

    @SuppressWarnings("unchecked")
    E element = (E) elements[readIndex];

    elements[readIndex] = null;
    readIndex = next(readIndex);
    size--;
    return element;
  }

  public boolean isEmpty() {
    return size == 0;
  }

  public boolean isFull() {
    return size == elements.length;
  }

  public int size() {
    return size;
  }

  private int next(int index) {
    index++;
    if (index == elements.length) {
      index = 0;
    }
    return index;
  }
}
Die Methoden im Einzelnen:
write()prüft zuerst, ob der Puffer voll ist, legt das Element in dem Feld ab, auf daswriteIndexzeigt, rückt den Index weiter und erhöht den Zähler.read()prüft, ob der Puffer leer ist, holt das Element aus dem Feld, auf dasreadIndexzeigt, setzt das Feld aufnull– damit der Garbage Collector das Element einsammeln kann, sobald sonst niemand mehr eine Referenz darauf hat –, rückt den Index weiter und verringert den Zähler.next()ist die eine Stelle, an der die Indizes umbrechen: der Vergleich aus dem Abschnitt „Der Umbruch: vom letzten Feld zurück auf 0“. Willst du Modulo oder die Bitmaske ausprobieren, änderst du nur diese Methode.isEmpty(),isFull()undsize()lesen den Zähler.
Das Array hat den Typ Object[], weil new E[capacity] in Java nicht erlaubt ist; der Cast in read() ist trotzdem sicher, denn write() lässt nur Elemente vom Typ E hinein.
Das folgende Beispiel schreibt drei Elemente in einen Puffer mit der Kapazität 3, liest zwei davon und schreibt zwei weitere – die landen in den Feldern 0 und 1, während „c“ noch in Feld 2 liegt (→ Code auf GitHub):
RingBuffer<String> buffer = new RingBuffer<>(3);

buffer.write("a");
buffer.write("b");
buffer.write("c");
System.out.println("read: " + buffer.read());
System.out.println("read: " + buffer.read());

buffer.write("d"); // landet in Feld 0
buffer.write("e"); // landet in Feld 1
System.out.println("full: " + buffer.isFull());

while (!buffer.isEmpty()) {
  System.out.println("read: " + buffer.read());
}
Das Programm gibt Folgendes aus:
read: a
read: b
full: true
read: c
read: d
read: e
Die Elemente kommen in der Reihenfolge heraus, in der sie geschrieben wurden – der Umbruch von Feld 2 auf Feld 0 ist von außen nicht zu sehen.
Eine Fassung derselben Idee mit enqueue() und dequeue() hinter einem Queue-Interface ist die BoundedArrayQueue aus dem Artikel „Queue mit einem Array implementieren“ – dort zeige ich auch, wie das Array wächst, wenn die Queue nicht bounded bleiben soll.
Varianten des Ringpuffers
Was passiert, wenn der Puffer voll ist und ein weiteres Element geschrieben werden soll? Darauf gibt es drei Antworten, und jede hat ihren Vertreter im JDK.
Fester Puffer: ArrayBlockingQueue lehnt ab oder wartet
Die erste Antwort: Der Puffer nimmt das Element nicht an. ArrayBlockingQueue erkennt die volle Queue an ihrem Zähler – count == items.length – und reagiert je nach Methode anders: offer() liefert false, add() wirft eine IllegalStateException mit der Meldung „Queue full“, und put() lässt den aufrufenden Thread warten, bis ein Feld frei wird. offer() mit Timeout wartet höchstens die angegebene Zeit und liefert false, wenn bis dahin kein Feld frei geworden ist.
Im Quelltext (JDK 27) ist das Warten eine Schleife: Solange count == items.length gilt, ruft put() die Methode notFull.await() auf. Jede Entnahme – ob über take() oder poll() – signalisiert die Condition notFull und weckt damit einen wartenden Producer. Die Condition hängt an dem einen ReentrantLock der Klasse; warum sich Producer und Consumer damit gegenseitig ausbremsen können, zeige ich im Abschnitt „Ist ArrayBlockingQueue threadsicher?“ des Artikels über die ArrayBlockingQueue.
Wachsender Puffer: ArrayDeque legt ein größeres Array an
Die zweite Antwort: Der Puffer wächst. ArrayDeque hat keine Kapazitätsgrenze – ist das Array voll, legt die Klasse ein größeres an und kopiert die Elemente um.
Voll ist das Array, sobald nach dem Einfügen head und tail auf dasselbe Feld zeigen. Dann ruft die Einfügemethode – z. B. addLast() – sofort grow() auf. Ein Array mit weniger als 64 Feldern wächst um seine Länge plus 2 – aus den 17 Feldern des Standardkonstruktors werden 36 –, ein größeres um die Hälfte.
Läuft der Inhalt gerade über das Arrayende hinaus und setzt sich bei Feld 0 fort, verschiebt grow() den Teil von head bis zum alten Arrayende an das Ende des neuen Arrays, damit die Reihenfolge erhalten bleibt. Wie ein wachsendes Array beim Deque umkopiert wird, zeige ich mit Grafiken im Artikel „Deque mit einem Array implementieren“; die Eigenschaften der Klasse stehen im Artikel über das ArrayDeque.
Überschreibender Puffer: Die ältesten Werte fallen raus
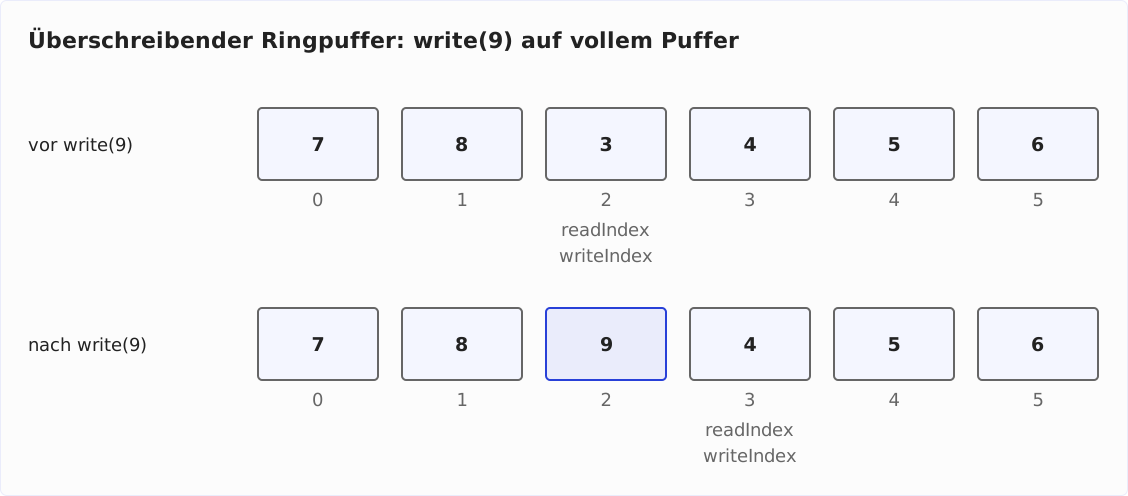
Die dritte Antwort: Das neue Element überschreibt das älteste. Der Puffer ist dann nie voll im Sinne von „nimmt nichts mehr an“ – er enthält immer die jüngsten Elemente, höchstens so viele, wie er Felder hat. Das ist die passende Variante für alles, wovon dich nur die letzten n Werte interessieren: die letzten 1.000 Logzeilen, die Messwerte der letzten Minute, die letzten Positionen einer Spielfigur.
Die folgende Grafik zeigt den vollen Puffer aus der vorherigen Grafik vor und nach write(9): Die 9 ersetzt in Feld 2 die 3 – das älteste Element –, und beide Indizes rücken auf Feld 3 weiter. Die 4 ist jetzt das älteste Element:
Im Code ist das eine if-Abfrage mehr. Die Klasse OverwritingRingBuffer erbt von RingBuffer und überschreibt nur write() (→ Code auf GitHub):
public class OverwritingRingBuffer<E> extends RingBuffer<E> {

  public OverwritingRingBuffer(int capacity) {
    super(capacity);
  }

  @Override
  public void write(E element) {
    if (isFull()) {
      read(); // verwirft das älteste Element
    }
    super.write(element);
  }
}
Ist der Puffer voll, liest write() das älteste Element und verwirft es – damit rückt readIndex weiter, und ein Feld wird frei. Dann schreibt die geerbte Methode das neue Element wie gewohnt.
Schreibst du fünf Zahlen in einen Puffer mit der Kapazität 3, bleiben die letzten drei übrig (→ Code auf GitHub):
RingBuffer<Integer> buffer = new OverwritingRingBuffer<>(3);

for (int i = 1; i <= 5; i++) {
  buffer.write(i);
}
System.out.println("size: " + buffer.size());

while (!buffer.isEmpty()) {
  System.out.println("read: " + buffer.read());
}
Die Ausgabe:
size: 3
read: 3
read: 4
read: 5
Einen überschreibenden Ringpuffer hat auch das JDK – nicht in java.util, sondern in java.util.logging. Der MemoryHandler hält Log-Einträge in einem Array von LogRecords, laut Javadoc einem „circular buffer“. Ist der Puffer voll, überschreibt der neue Eintrag den ältesten, und start – der Index des ältesten Eintrags – rückt um ein Feld weiter.
Damit hält der MemoryHandler immer die jüngsten Einträge bereit. An einen anderen Handler gibt er sie erst weiter, wenn ein Eintrag mit mindestens dem Level pushLevel eintrifft – standardmäßig SEVERE. Bei einem Fehler landen deshalb auch die bis zu 1.000 Einträge davor im Log (die Standardgröße des Puffers), ohne dass du dauerhaft alles mitschreiben musst.
LMAX Disruptor: der bekannteste Java-Ringpuffer
Außerhalb des JDK ist der bekannteste Ringpuffer in Java der LMAX Disruptor – eine Bibliothek der Handelsplattform LMAX Exchange, um Events zwischen Threads auszutauschen (Maven-Koordinaten com.lmax:disruptor, im Oktober 2026 in Version 4.0.0). Ihr Kern ist die Klasse RingBuffer, laut ihrem Javadoc ein „ring based store of reusable entries“.
Drei Dinge macht der Disruptor anders als die Puffer in diesem Artikel:
- Die Einträge sind vorab angelegt. Beim Erzeugen füllt der
RingBufferjedes Feld über eineEventFactorymit einem leeren Event-Objekt. Ein Producer legt kein neues Objekt an, sondern kopiert seine Daten in die Felder des vorhandenen Events – im Beispiel der Disruptor-Doku einenlong, den er aus einemByteBufferliest:event.set(buffer.getLong(0)). Weil die Events so lange leben wie der Disruptor, entsteht dabei kein Müll für den Garbage Collector. Das gilt nur, solange die Daten als Werte kopiert werden: Speichert der Producer im Event bloß die Referenz auf ein eigens angelegtes Objekt, entsteht derselbe Müll wie bei einerArrayBlockingQueue. - Statt zweier Indizes gibt es Sequenznummern. Ein Producer fordert mit
next()die nächste Sequenznummer an – einlong, das immer weiter zählt –, befüllt den Eintrag und gibt ihn mitpublish()frei. Jeder Consumer führt seine eigeneSequence, bis zu der er gelesen hat; so weiß der Disruptor, welche Einträge noch nicht alle Consumer gelesen haben und deshalb nicht überschrieben werden dürfen. - Die Kapazität muss eine Zweierpotenz sein. Der Konstruktor prüft das mit
Integer.bitCount(bufferSize) != 1und wirft sonst eineIllegalArgumentException(„bufferSize must be a power of 2“). Das Feld zu einer Sequenznummer ist dannsequence & indexMaskmitindexMask = bufferSize - 1– die Bitmaske aus dem Abschnitt „Der Umbruch: vom letzten Feld zurück auf 0“.
Willst du nur Elemente von einem Thread an einen anderen übergeben, ist eine ArrayBlockingQueue die einfachere Wahl. Der Disruptor lohnt sich, wenn die Latenz pro Event und jede Objektallokation im Betrieb zählen – dafür wurde er gebaut.
Zeitkomplexität der Ringpuffer-Operationen
Eine Einführung in das Thema Zeitkomplexität findest du im Artikel „O-Notation und Zeitkomplexität – anschaulich erklärt“.
Schreiben und Lesen greifen auf je ein Feld zu und rücken einen Index weiter – egal, wie viele Elemente im Puffer liegen. Ihre Zeitkomplexität ist O(1). Dasselbe gilt für isEmpty(), isFull() und size(), wenn der Puffer einen Zähler führt.
Wächst der Puffer wie bei ArrayDeque, kostet das Umkopieren beim Vergrößern einmalig O(n). Weil das Array dabei jedes Mal proportional zu seiner Größe wächst, kommt das selten vor, und über viele Einfügeoperationen gemittelt bleibt es bei amortisiert O(1).
Ein Element in der Mitte zu suchen oder zu entfernen kostet dagegen O(n): Dafür muss das Array durchlaufen und beim Entfernen alles hinter der Lücke aufgerückt werden – ArrayBlockingQueue.remove(Object) tut genau das.
Zusammenfassung und Ausblick
Ein Ringpuffer ist ein Array mit zwei Indizes, die, wenn sie das Ende des Arrays erreicht haben, wieder auf 0 springen. Schreiben und Lesen verschieben nie ein Element, und solange der Puffer nicht wachsen muss, legen sie keinen Speicher an – deshalb liegt ein Ringpuffer unter ArrayBlockingQueue, ArrayDeque und dem MemoryHandler des Logging-Pakets, und deshalb hat der LMAX Disruptor ihn zum Kern seines Designs gemacht.
Drei Punkte zum Mitnehmen:
- Ob der Puffer voll oder leer ist, sagen dir die Indizes allein nicht. Du brauchst einen Zähler, ein frei bleibendes Feld oder einen Blick in das Feld, auf das beide zeigen.
- Ist der Puffer voll, hast du drei Möglichkeiten: ablehnen oder warten (
ArrayBlockingQueue), wachsen (ArrayDeque) oder das älteste Element überschreiben (MemoryHandler,OverwritingRingBuffer). - Den Umbruch vom letzten Feld zurück auf 0 schreibst du am besten als Vergleich; die Bitmaske lohnt sich erst bei einer Kapazität, die ohnehin eine Zweierpotenz ist.
Wie du aus dem Ringpuffer eine Queue mit wachsendem Array machst, zeige ich im Artikel „Queue mit einem Array implementieren“ – und wie du an beiden Enden einfügst und entnimmst, im Artikel „Deque mit einem Array implementieren“.
Konntest du etwas aus diesem Artikel mitnehmen? Mit einer Bewertung auf meinem ProvenExpert-Profil hilfst du anderen Entwickler:innen einzuschätzen, ob sich das Lesen lohnt – und mir zu verstehen, welche Inhalte dir weiterhelfen.