Ein paralleler Stream verarbeitet die Elemente einer Stream-Pipeline auf mehreren Threads gleichzeitig. Du änderst dafür am Code nur ein Wort – aus stream() wird parallelStream(), oder du hängst parallel() an einen bestehenden Stream –, und die Java-Stream-API verteilt die Arbeit auf die Kerne deines Rechners.
So zählst du parallel, wie viele der elf Bücher in der Beispielbibliothek vor 1850 erschienen sind:
long before1850 = BOOKS.parallelStream()
    .filter(book -> book.year() < 1850)
.count();2Parallele Streams gibt es seit Java 8. Das Versprechen klingt einfach: ein Wort mehr, ein Vielfaches an Geschwindigkeit. Bei elf Büchern bekommst du allerdings das Gegenteil, denn Aufteilen und Zusammenfügen kosten mehr als die Arbeit selbst. Wo die Grenze liegt, habe ich gemessen – auf einem Mac mit 18 Kernen.
In diesem Artikel erfährst du,
- wie ein paralleler Stream seine Elemente aufteilt und wer sie verarbeitet,
- wie viele Threads mitarbeiten und wie du die Zahl änderst,
- ab welcher Elementzahl und welcher Arbeit pro Element sich
parallel()lohnt – mit Messwerten, - welche Quellen sich gut aufteilen lassen und welche nicht,
- was mit der Reihenfolge der Elemente passiert,
- welche Regeln dein Code einhalten muss, damit das Ergebnis stimmt,
- warum blockierende Aufrufe nicht in einen parallelen Stream gehören – und was du stattdessen nimmst,
- welche Fehler du vermeiden solltest.
Die Beispiele in diesem Artikel
Die Beispiele verwenden das Datenmodell des Artikels über Java Streams – ein Enum Genre, einen Record Book und eine kleine Bibliothek mit elf Klassikern:
public enum Genre {
  NOVEL,
  GOTHIC,
  ADVENTURE,
  FANTASY,
  SCIENCE_FICTION
}

public record Book(String title, String author, int year, Genre genre) {}
public class Library {
public static final List<Book> BOOKS = List.of(
new Book("Pride and Prejudice", "Jane Austen", 1813, NOVEL),
new Book("Frankenstein", "Mary Shelley", 1818, GOTHIC),
new Book("Moby-Dick", "Herman Melville", 1851, ADVENTURE),
new Book("From the Earth to the Moon", "Jules Verne", 1865, SCIENCE_FICTION),
new Book("Alice's Adventures in Wonderland", "Lewis Carroll", 1865, FANTASY),
new Book("Around the World in Eighty Days", "Jules Verne", 1873, ADVENTURE),
new Book("Treasure Island", "Robert Louis Stevenson", 1883, ADVENTURE),
new Book("Kidnapped", "Robert Louis Stevenson", 1886, ADVENTURE),
new Book("The Time Machine", "H. G. Wells", 1895, SCIENCE_FICTION),
new Book("Dracula", "Bram Stoker", 1897, GOTHIC),
new Book("The War of the Worlds", "H. G. Wells", 1898, SCIENCE_FICTION));
}Elf Bücher reichen, um zu zeigen, was ein paralleler Stream anders macht – welcher Thread welches Buch verarbeitet und was mit der Reihenfolge passiert. Um zu zeigen, wann er schneller ist, reichen sie nicht. Für die Messungen nehme ich deshalb Zahlenbereiche aus IntStream.range() und Listen mit bis zu einer Million Elementen, und ich steuere die Arbeit pro Element mit einer Funktion, die eine einstellbare Zahl von Rechenschritten ausführt.
Den vollständigen Code aller Beispiele findest du im GitHub-Repository java-streams-examples im Package eu.happycoders.parallel; die Benchmarks und ihre Ergebnisse liegen im selben Repository im Verzeichnis benchmarks/parallel-streams.
Einen parallelen Stream erzeugen
Für einen parallelen Stream gibt es zwei Wege. Collection.parallelStream() erzeugt ihn direkt aus einer Collection:
BOOKS.parallelStream()
    .map(Book::title)
    .forEach(System.out::println);
BaseStream.parallel() macht einen bestehenden Stream parallel – auch einen, der nicht aus einer Collection kommt, etwa aus LongStream.rangeClosed() oder Files.lines(). Das folgende Listing addiert die Zahlen von 1 bis 1.000.000 parallel:
long sum = LongStream.rangeClosed(1, 1_000_000)
    .parallel()
    .sum();
System.out.println(sum);500000500000Ein IntStream würde hier übrigens ein falsches Ergebnis liefern: Die Summe passt nicht in ein int, und IntStream.sum() läuft stillschweigend über.
Das Gegenstück ist BaseStream.sequential(), und BaseStream.isParallel() sagt dir, in welchem Modus ein Stream gerade ist.
Ob ein Stream parallel läuft, ist eine Eigenschaft der ganzen Pipeline, nicht eines Abschnitts. Du kannst nicht die erste Hälfte der Operationen parallel und die zweite sequenziell ausführen lassen. Der letzte Aufruf von parallel() oder sequential() vor der terminalen Operation entscheidet für alle:
boolean parallel = BOOKS.stream()
    .parallel()
    .filter(book -> book.year() > 1850)
    .sequential()
    .map(Book::title)
    .parallel()
.isParallel();trueHätte die Pipeline mit sequential() geendet, liefe sie komplett sequenziell – auch filter(), das zwischen den beiden parallel()-Aufrufen steht.
Wie funktioniert ein paralleler Stream?
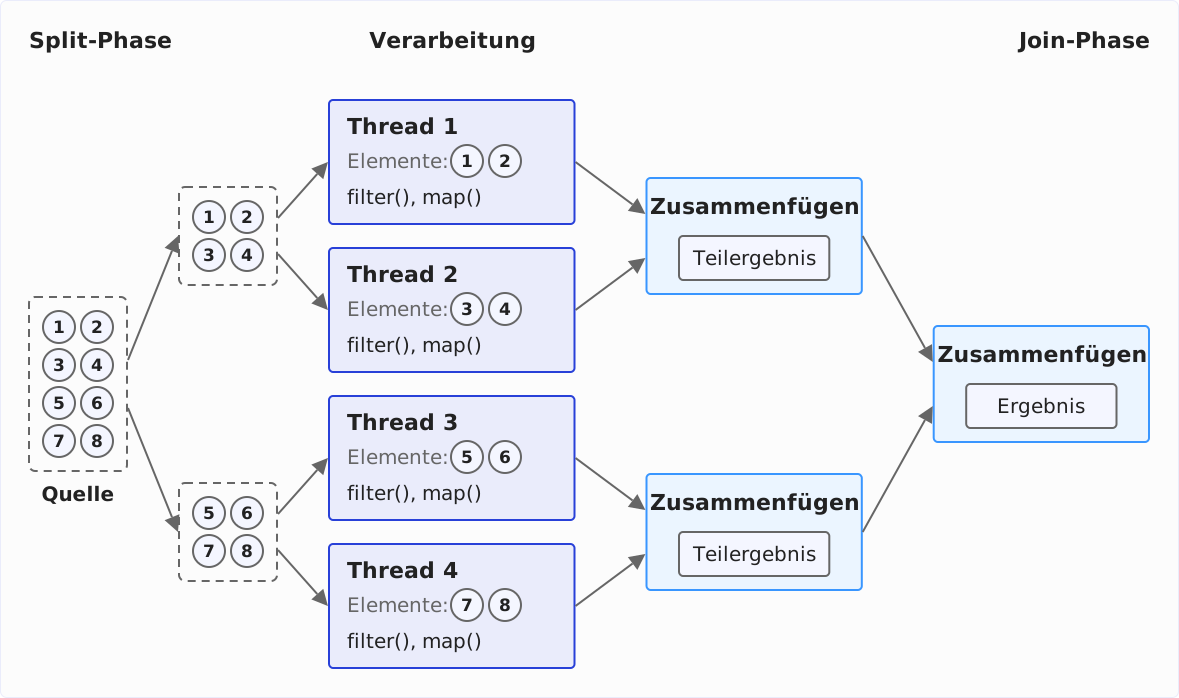
Ein paralleler Stream arbeitet in drei Phasen: Er teilt die Quelle in Teilstücke, verarbeitet die Teilstücke auf den Threads eines Thread-Pools und fügt die Teilergebnisse zusammen. Die Pipeline selbst – welche Operationen in welcher Reihenfolge – bleibt dieselbe wie im sequenziellen Stream.
Das folgende Diagramm zeigt die drei Phasen für eine Liste mit acht Elementen und vier Threads: Die Quelle wird zweimal halbiert, jedes Viertel läuft auf einem eigenen Thread durch dieselbe Pipeline, und die vier Teilergebnisse werden paarweise zu einem Ergebnis zusammengefügt.
Split-Phase: Der Spliterator teilt die Quelle
Zum Aufteilen fragt der Stream die Quelle nach ihrem Spliterator – das Interface java.util.Spliterator ist das Gegenstück zum Iterator für die parallele Verarbeitung. Seine Methode trySplit() spaltet einen Teil der Elemente ab und gibt einen zweiten Spliterator dafür zurück; estimateSize() schätzt, wie viele Elemente ein Spliterator noch hat.
Eine ArrayList z. B. halbiert sich bei jedem Aufruf. So sehen die ersten fünf Aufrufe von trySplit() für eine Million Elemente aus – jede Zeile ist die Größe des abgespaltenen Teils, die letzte die Zahl der Elemente, die danach noch im ursprünglichen Spliterator liegen:
List<Integer> numbers =
    new ArrayList<>(IntStream.range(0, 1_000_000).boxed().toList());
Spliterator<Integer> spliterator = numbers.spliterator();
for (int i = 0; i < 5; i++) {
  Spliterator<Integer> part = spliterator.trySplit();
  System.out.println(part.estimateSize());
}
System.out.println("remaining: " + spliterator.estimateSize());
500000
250000
125000
62500
31250
remaining: 31250Wie oft geteilt wird, entscheidet der Stream anhand einer Zielgröße: Er teilt so lange, bis ein Teilstück höchstens Elementzahl ÷ (4 × Parallelität) Elemente hat. So entstehen mindestens viermal so viele Teilstücke, wie es Worker-Threads gibt. Warum so viele, zeigt der nächste Abschnitt.
Bei 17 Worker-Threads (dazu gleich mehr) und einer Million Elementen darf ein Teilstück nach dieser Formel höchstens 1.000.000 ÷ (4 × 17) = 14.705 Elemente haben – der Stream rechnet ganzzahlig. Die ArrayList aus dem Beispiel teilt sich aber immer in der Mitte. Bei 64 Teilstücken hätte jedes 15.625 Elemente, mehr als 14.705 – also teilt der Stream noch einmal. Am Ende landet die ArrayList bei 128 Teilstücken mit je 7.812 oder 7.813 Elementen, gut siebenmal so vielen, wie es Worker-Threads gibt.
Diese Zielgröße kommt aus AbstractTask.suggestTargetSize() im JDK und ist nicht konfigurierbar.
Verarbeitung: der Common Pool und Work Stealing
Die Teilstücke verarbeitet der Common Pool – die eine ForkJoinPool-Instanz, die sich alle parallelen Streams und alle CompletableFuture-Aufrufe ohne eigenen Executor in einer JVM teilen. Du bekommst sie mit ForkJoinPool.commonPool().
Warum so viele Teilstücke? Nicht jedes Teilstück ist gleich schnell fertig – die Arbeit pro Element kann schwanken, und ein Kern kann zwischendurch anderes zu tun haben. Bekäme jeder Thread genau ein großes Teilstück, wäre der Stream erst fertig, wenn der langsamste Thread fertig ist, und alle anderen würden so lange warten. Deshalb teilt der Stream feiner, als es Threads gibt. Einen zentralen Verteiler gibt es dabei nicht: Ein Thread spaltet mit trySplit() vom Spliterator ein Teilstück ab, legt eine der beiden Hälften in seine eigene Warteschlange und teilt die andere weiter – bis sie die Zielgröße erreicht hat und er sie verarbeitet.
Ein ForkJoinPool arbeitet dabei mit Work Stealing: Ist die Warteschlange eines Threads abgearbeitet, holt er sich ein Teilstück aus der Warteschlange eines anderen Threads – er „stiehlt“ es. So bleiben bis zum Schluss alle Kerne beschäftigt, solange irgendwo noch ein Teilstück liegt.
Welcher Thread welches Buch verarbeitet, siehst du, wenn du in forEach() den Thread-Namen ausgibst:
BOOKS.parallelStream()
    .forEach(book -> System.out.println(
        Thread.currentThread().getName() + ": " + book.title()));
ForkJoinPool.commonPool-worker-10: Kidnapped
ForkJoinPool.commonPool-worker-7: Around the World in Eighty Days
ForkJoinPool.commonPool-worker-8: The War of the Worlds
ForkJoinPool.commonPool-worker-1: Moby-Dick
ForkJoinPool.commonPool-worker-3: Pride and Prejudice
ForkJoinPool.commonPool-worker-9: From the Earth to the Moon
ForkJoinPool.commonPool-worker-5: Dracula
main: Treasure Island
ForkJoinPool.commonPool-worker-2: Frankenstein
ForkJoinPool.commonPool-worker-6: The Time Machine
ForkJoinPool.commonPool-worker-4: Alice's Adventures in WonderlandZwei Dinge fallen auf. Erstens hat der Stream die elf Bücher auf elf Teilstücke verteilt – bei so wenigen Elementen ist die Zielgröße 1. Zweitens arbeitet der Thread main mit: Der Thread, der die terminale Operation aufruft, wartet nicht nur auf das Ergebnis, sondern verarbeitet selbst Teilstücke.
Join-Phase: Teilergebnisse zusammenfügen
Wie die Teilergebnisse zusammengefügt werden, hängt von der terminalen Operation ab. count() und sum() addieren die Teilergebnisse. reduce() verbindet sie mit dem Combiner, den du übergibst – oder mit dem Akkumulator, wenn Elemente und Ergebnis denselben Typ haben. collect() ruft den Combiner des Collectors auf, der zwei Ergebniscontainer zu einem verschmilzt: Collectors.toList() hängt die zweite Liste an die erste an, Collectors.toMap() fügt die Einträge der einen Map in die andere ein.
Das Zusammenfügen läuft paarweise, in umgekehrter Reihenfolge des Aufteilens: Die Teilergebnisse zweier Hälften werden zu einem, dann die beiden nächsthöheren – bis eines übrig ist. Beim reduce()-Beispiel im Artikel über Stream.reduce() kannst du jeden einzelnen Combiner-Aufruf verfolgen.
Wie viele Threads arbeiten mit?
Die Zahl der Worker-Threads im Common Pool ist die Zahl der verfügbaren Prozessoren minus eins:
System.out.println(Runtime.getRuntime().availableProcessors());
System.out.println(ForkJoinPool.getCommonPoolParallelism());
18
17Das Minus eins ist Absicht: Der aufrufende Thread arbeitet mit, und so sind es zusammen genau so viele Threads wie Kerne. Das folgende Programm zählt, auf wie vielen verschiedenen Threads die Elemente eines parallelen Streams ankommen:
Set<String> threadNames = ConcurrentHashMap.newKeySet();
IntStream.range(0, 1_000_000)
    .parallel()
    .forEach(i -> threadNames.add(Thread.currentThread().getName()));
System.out.println(threadNames.size());18Und auf einem Rechner mit nur einem Prozessor? Dort käme der Common Pool auf null Worker-Threads – deshalb legt er mindestens einen an. Mit der VM-Option -XX:ActiveProcessorCount=1, die der JVM einen einzigen Prozessor vorgibt, gibt das erste Programm zweimal 1 aus und das zweite 2: Ein Worker-Thread und der aufrufende Thread teilen sich den einen Kern.
Die Größe des Common Pool änderst du mit der System-Property java.util.concurrent.ForkJoinPool.common.parallelism. Mit -Djava.util.concurrent.ForkJoinPool.common.parallelism=4 z. B. gibt das Programm, das die Threads zählt, 5 aus – vier Worker plus den aufrufenden Thread. Die Property gilt für die ganze JVM; für einen einzelnen Stream lässt sich die Zahl nicht einstellen. Was du stattdessen tun kannst, zeigt der Abschnitt über den eigenen ForkJoinPool.
Parallele Streams in einem Container
In einem Container zählt availableProcessors() seit Java 10 nicht die Kerne des Hosts, sondern das CPU-Limit des Containers (JDK-8146115). Ein Container mit einem Limit von zwei CPUs bekommt also einen Common Pool mit einem Worker-Thread – unabhängig davon, wie viele Kerne der Host hat. Ein paralleler Stream läuft dort auf zwei Threads, dem Worker und dem Aufrufer.
Wann ist ein paralleler Stream schneller?
Ein paralleler Stream kostet zusätzlich zur eigentlichen Arbeit das Aufteilen, das Verteilen der Teilstücke auf die Threads und das Zusammenfügen der Teilergebnisse. Er lohnt sich nur, wenn die eingesparte Rechenzeit diese Kosten übersteigt.
Doug Lea, der Autor des ForkJoinPool, hat dafür in seiner Stream Parallel Guidance eine Faustregel aufgestellt: Das Produkt aus Elementzahl N und Arbeit pro Element Q sollte mindestens 10.000 betragen. Ob die Regel auf heutiger Hardware noch trägt, habe ich gemessen.
Elementzahl mal Arbeit pro Element
Die erste Messreihe verwendet die am besten teilbare Quelle, IntStream.range(), und variiert zwei Größen: die Elementzahl von 100 bis einer Million und die Arbeit pro Element von null bis 1.000 Rechenschritten. Das folgende Listing ist der parallele Benchmark; der sequenzielle ist derselbe ohne parallel():
@Benchmark
public long parallel() {
  return IntStream.range(0, size)
      .parallel()
      .mapToLong(this::work)
      .sum();
}

private long work(int i) {
  Blackhole.consumeCPU(tokens);
  return i;
}
mapToLong() ruft für jedes Element die Methode work() auf, und die erzeugt die Arbeit pro Element: Blackhole.consumeCPU() aus JMH führt so viele Rechenschritte aus, wie tokens angibt. Ein Rechenschritt ist ein Schleifendurchlauf mit einer Multiplikation, drei Additionen und einer UND-Verknüpfung. Die Felder size und tokens setzt JMH für jede Zelle der folgenden Tabelle neu.
Sequenziell kostet ein Element auf dem M5 Pro ohne Rechenschritte 2 Nanosekunden (ns), mit 10 Rechenschritten 5 ns, mit 100 Rechenschritten 127 ns und mit 1.000 Rechenschritten 1.534 ns. Die 2 ns ohne Rechenschritte sind das, was der Stream pro Element ohnehin tut: das nächste Element aus dem Bereich holen, work() aufrufen und das Ergebnis aufaddieren.
Die folgende Tabelle zeigt, um welchen Faktor der parallele Stream schneller ist als der sequenzielle; ein Wert unter 1 bedeutet, dass er langsamer ist.
| Elemente | 0 Schritte | 10 Schritte | 100 Schritte | 1.000 Schritte |
|---|---|---|---|---|
| 100 | 0,01 | 0,02 | 0,39 | 2,87 |
| 1.000 | 0,06 | 0,15 | 2,64 | 8,28 |
| 10.000 | 0,60 | 1,44 | 7,48 | 14,54 |
| 100.000 | 3,07 | 4,36 | 14,11 | 15,15 |
| 1.000.000 | 8,21 | 9,49 | 14,66 | 15,05 |
Die Tabelle zeigt drei Dinge.
Erstens hat ein paralleler Stream einen festen Grundpreis: Bei 100 bis 10.000 Elementen mit wenig Arbeit braucht er 32 bis 35 Mikrosekunden, egal, wie wenig zu tun ist. Der sequenzielle Stream ist mit 100 Elementen ohne Arbeit nach 0,2 Mikrosekunden fertig.
Zweitens entscheidet die Laufzeit des sequenziellen Streams, ob sich parallel() lohnt. Brauchte er höchstens 19 Mikrosekunden, war der parallele Stream langsamer; brauchte er 50 Mikrosekunden oder mehr, war der parallele schneller – in jeder Zelle der Tabelle. Dazwischen liegt kein Messpunkt. Mit Doug Leas Faustregel passt das zusammen: Für eine triviale Funktion setzt er mindestens 10.000 Elemente an, und ohne Arbeit pro Element liegt die Grenze auf dem M5 Pro zwischen 10.000 Elementen (Faktor 0,60) und 100.000 Elementen (Faktor 3,07).
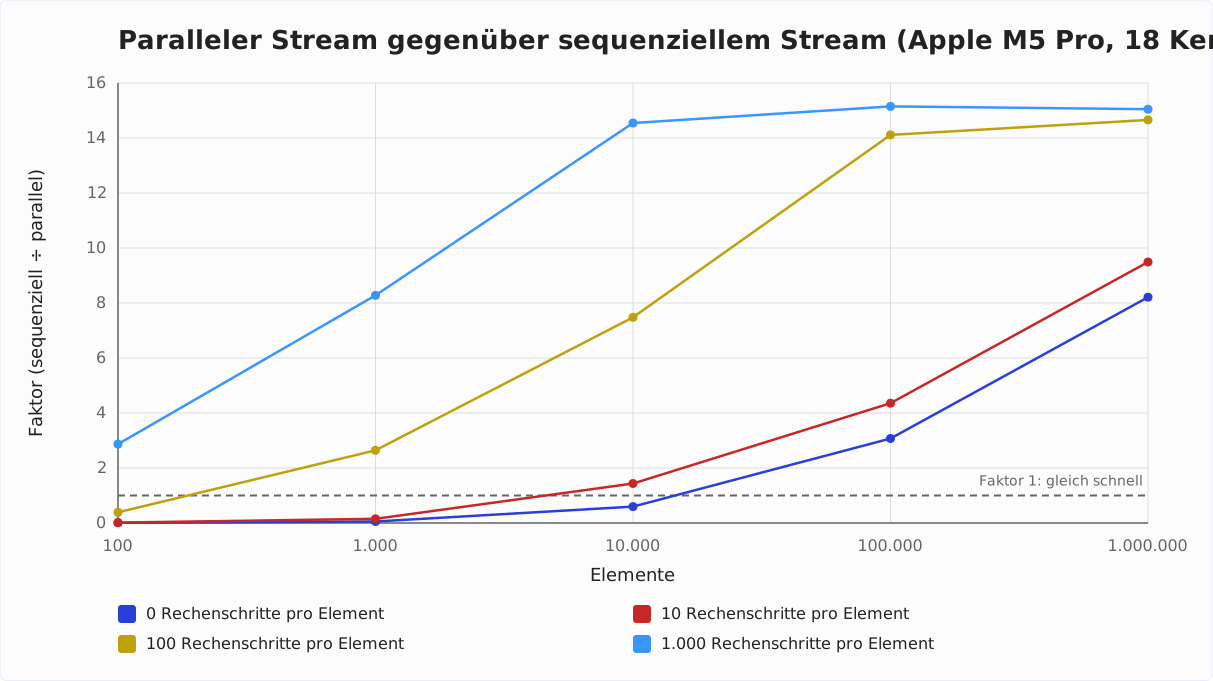
Drittens ist auf 18 Kernen bei rund Faktor 15 Schluss. Ab 10.000 Elementen mit 1.000 Rechenschritten oder 100.000 Elementen mit 100 Rechenschritten liegt der Faktor zwischen 14,1 und 15,2 – mehr Elemente oder mehr Arbeit ändern daran kaum etwas.
Das folgende Diagramm zeigt dieselben Faktoren als Linien – eine Linie pro Arbeitsmenge, die Elementzahl auf der x-Achse. Die gestrichelte Linie bei Faktor 1 ist die Grenze: Darüber ist der parallele Stream schneller, darunter langsamer.
Wie gut sich die Quelle aufteilen lässt
Die zweite Messreihe hält die Pipeline fest – eine Million Elemente, 100 Rechenschritte pro Element, sum() – und tauscht die Quelle. Vorher ein Blick darauf, wie die Quellen sich teilen.
Eine ArrayList kennt ihre Größe und halbiert sich mit jedem trySplit(), wie oben gezeigt. Eine LinkedList kennt ihre Größe auch, aber ihr Spliterator kann nicht in die Mitte springen – er muss die Elemente vom Anfang her abzählen. Deshalb spaltet er beim ersten Aufruf 1.024 Elemente ab, beim zweiten 2.048, dann 3.072 und so weiter:
List<Integer> numbers =
    new LinkedList<>(IntStream.range(0, 1_000_000).boxed().toList());
Spliterator<Integer> spliterator = numbers.spliterator();
for (int i = 0; i < 5; i++) {
  Spliterator<Integer> part = spliterator.trySplit();
  System.out.println(part.estimateSize());
}
System.out.println("remaining: " + spliterator.estimateSize());
1024
2048
3072
4096
5120
remaining: 984640Nach fünf Aufrufen sind erst 15.360 Elemente abgespalten, 984.640 liegen noch im ursprünglichen Spliterator. Dasselbe Verfahren – Blöcke, die um je 1.024 Elemente wachsen – verwenden die Quellen, die auf einem Iterator beruhen, z. B. Stream.iterate() und BufferedReader.lines().
Ein HashSet und ein TreeSet halbieren sich wie eine ArrayList: Das HashSet teilt seine interne Tabelle, das TreeSet den Baum. Beide wissen allerdings nicht, wie viele Elemente in einer Hälfte liegen – die Schätzung ist die halbe Gesamtgröße, die tatsächliche Zahl kann davon abweichen.
Bei Dateien kommt es darauf an, wie du sie liest. BufferedReader.lines() beruht auf einem Iterator und teilt sich in wachsenden Blöcken wie bei der LinkedList. Files.lines() dagegen halbiert die Datei selbst, wenn drei Bedingungen erfüllt sind: Die Datei liegt auf dem Standard-Dateisystem, sie ist in UTF-8, ISO-8859-1 oder US-ASCII kodiert, und sie ist höchstens 2.147.483.647 Bytes (Integer.MAX_VALUE) groß. Dann teilt Files.lines() den Bytebereich der Datei in der Mitte und verschiebt die Schnittstelle zum nächstgelegenen Zeilenumbruch. Fehlt eine der drei Bedingungen, greift es auf BufferedReader.lines() zurück.
Die folgende Tabelle zeigt für jede Quelle die Laufzeit des sequenziellen und des parallelen Streams und den Faktor, um den der parallele schneller ist:
| Quelle | sequenziell | parallel | Faktor |
|---|---|---|---|
ArrayList | 126,6 ms | 8,59 ms | 14,7 |
HashSet | 127,0 ms | 9,88 ms | 12,9 |
TreeSet | 126,1 ms | 15,9 ms | 7,92 |
LinkedList | 125,3 ms | 9,33 ms | 13,4 |
Stream.iterate() | 125,6 ms | 10,4 ms | 12,0 |
BufferedReader.lines() | 135,1 ms | 11,9 ms | 11,4 |
Bei 100 Rechenschritten pro Element fallen die wachsenden Blöcke kaum ins Gewicht: Die LinkedList kommt auf den Faktor 13,4, Stream.iterate() auf 12,0 und BufferedReader.lines() auf 11,4 – gegen 14,7 bei der ArrayList.
Am schwächsten schneidet mit dem Faktor 7,92 das TreeSet ab, obwohl es sich halbiert. Sein Spliterator teilt den Baum an der Wurzel des jeweiligen Teilbaums und schätzt jede Hälfte auf die Hälfte der vorigen Schätzung – der Rot-Schwarz-Baum ist aber nicht exakt balanciert. Zerlegt man das TreeSet so, wie es der Stream tut, ist das größte der 128 Teilstücke mit 82.497 Elementen mehr als zehnmal so groß wie der Durchschnitt von 7.813 Elementen. Dieses eine Teilstück braucht allein rund 10 Millisekunden, und auf seinen Thread wartet am Ende der ganze Stream.
Operationen, die an der Reihenfolge hängen
Einige Operationen müssen die Reihenfolge der Elemente kennen – und in einem parallelen Stream kostet die Reihenfolge Koordination zwischen den Threads. findFirst() muss das erste passende Element in der Reihenfolge der Quelle liefern, auch wenn ein anderer Thread längst ein späteres gefunden hat. limit() muss die ersten n Elemente liefern, nicht irgendwelche n. sorted() und distinct() müssen alle Teilergebnisse zusammenführen, bevor sie ein Element weitergeben können.
Die dritte Messreihe vergleicht diese Operationen mit ihren Gegenstücken, die keine Reihenfolge brauchen: findAny() statt findFirst(), und limit() auf einem Stream, dem unordered() die Reihenfolge genommen hat. Die Quelle ist eine ArrayList mit einer Million Elementen, 100 Rechenschritte pro Element. findFirst() und findAny() suchen ein Element aus der zweiten Hälfte – jedes der 500.000 Elemente ab der Mitte passt. sorted() läuft einmal auf den Zahlen in ihrer sortierten Reihenfolge und einmal auf denselben Zahlen gemischt, dort auch ohne Arbeit pro Element. distinct() läuft einmal mit 1.000 und einmal mit 100.000 verschiedenen Werten.
| Operation | sequenziell | parallel | Faktor |
|---|---|---|---|
findFirst() | 62,6 ms | 4,71 ms | 13,3 |
findAny() | 62,6 ms | 0,11 ms | 568 |
limit(1000) | 0,13 ms | 0,38 ms | 0,34 |
unordered().limit(1000) | 0,13 ms | 0,10 ms | 1,27 |
forEachOrdered() | 127,0 ms | 10,8 ms | 11,8 |
sorted(), sortiert | 128,7 ms | 9,26 ms | 13,9 |
sorted(), gemischt | 248,8 ms | 18,5 ms | 13,5 |
sorted(), gemischt, ohne Arbeit | 122,1 ms | 10,2 ms | 12,0 |
distinct(), 1.000 Werte | 127,8 ms | 8,88 ms | 14,4 |
distinct(), 100.000 Werte | 130,1 ms | 13,5 ms | 9,66 |
Bei findFirst() und findAny() gewinnt der parallele Stream beide Male, aber aus verschiedenen Gründen. Sequenziell arbeiten beide Methoden erst die 500.000 Elemente der ersten Hälfte ab. Parallel liefert findAny() den ersten Treffer irgendeines Threads – und ein Thread, dessen Teilstück in der zweiten Hälfte liegt, trifft gleich mit dem ersten Element. findFirst() muss dagegen warten, bis feststeht, dass in der ersten Hälfte kein Treffer liegt; diese Hälfte arbeiten aber 18 Threads gemeinsam ab, 13-mal so schnell wie einer.
Bei limit(1000) dreht sich das Bild: Der sequenzielle Stream hört nach 1.000 Elementen auf. Der parallele braucht mit Encounter Order fast dreimal so lang – nach unordered() ist er etwas schneller als der sequenzielle.
forEachOrdered(), sorted() und distinct() mit 1.000 Werten kommen auf Faktoren zwischen 11,8 und 14,4 – nah an den 14,7 der ArrayList aus der vorigen Messreihe, deren Pipeline nur summiert. Mit Arbeit pro Element hat das bei allen dreien denselben Grund: Die teure Arbeit steckt im filter() davor, und die erledigen die Threads parallel. Was danach kommt, unterscheidet sich:
forEachOrdered()lässt jedes Teilstück seinen Teil der Pipeline sofort abarbeiten. Ist ein Teilstück fertig, bevor die Teilstücke davor fertig sind, puffert es seine Ergebnisse. In der Reihenfolge der Quelle läuft nur die Aktion selbst – hier das Hinzufügen zu einer Liste.sorted()sammelt die Elemente parallel in ein Array und sortiert es danach mitArrays.parallelSort(). Sind die Zahlen schon sortiert, kostet das Sortieren kaum etwas. Gemischt kostet es sequenziell 122 Millisekunden, fast so viel wie die 100 Rechenschritte pro Element – aber auch das Sortieren läuft parallel: Ohne Arbeit pro Element ist der parallele Stream 12,0-mal so schnell, mit Arbeit 13,5-mal.distinct()sammelt in einem geordneten Stream jedes Teilstück in ein eigenesLinkedHashSetund fügt die Sets danach paarweise zusammen. Bei 1.000 verschiedenen Werten (i % 1000) bleiben die Sets klein, und das Zusammenfügen kostet wenig. Bei 100.000 verschiedenen Werten (i % 100_000) werden sie groß, und der Faktor sinkt von 14,4 auf 9,66.
Die Kosten des Zusammenfügens bei Collectors
Die vierte Messreihe misst, was das Zusammenfügen der Teilergebnisse kostet. Dazu läuft dieselbe Quelle – eine ArrayList mit einer Million Integer-Elementen – zweimal durch jeden Collector: einmal ohne Arbeit pro Element, sodass der Stream nur sammelt, und einmal mit 100 Rechenschritten pro Element.
In der Join-Phase fügen die Kandidaten der Tabelle ihre Teilergebnisse so zusammen:
Stream.toList()steht zum Vergleich in der Tabelle, es ist selbst kein Collector. Es schreibt die Teilergebnisse in ein gemeinsames Array; kennt der Stream die Zahl der Elemente im Voraus, schreibt er jedes Teilstück direkt an seinen Platz.Collectors.toSet()fügt die Elemente des kleinerenHashSeteinzeln in das größere ein.Collectors.toMap()fügt die Einträge der einenHashMapeinzeln in die andere ein, jeweils mit Hashwert und Prüfung auf einen doppelten Schlüssel.Collectors.groupingBy()fügt die Einträge der einen Map ebenso in die andere ein; steht ein Schlüssel in beiden, hängt es die zweite Liste an die erste an.Collectors.toConcurrentMap()undCollectors.groupingByConcurrent()sparen sich das Zusammenfügen: Alle Threads schreiben in eine gemeinsameConcurrentHashMap.Collectors.joining(",")hängt den Text des einenStringJoineran den anderen an.
Das Einfügen bei toSet(), toMap() und groupingBy() geschieht auf jeder Ebene des Zusammenfügens erneut, sodass ein Element mehrmals eingefügt werden kann. Deshalb nennt das Javadoc von toMap() das Zusammenfügen „an expensive operation“ und empfiehlt toConcurrentMap(), wenn die Reihenfolge keine Rolle spielt.
Die folgende Tabelle zeigt, um welchen Faktor der parallele Stream mit jedem Kandidaten schneller ist als der sequenzielle; ein Wert unter 1 bedeutet wieder, dass er langsamer ist:
| Collector | ohne Arbeit pro Element | 100 Schritte pro Element |
|---|---|---|
Stream.toList() | 7,94 | 14,4 |
toSet() | 0,66 | 5,82 |
toMap() | 0,79 | 6,61 |
toConcurrentMap() | 1,50 | 14,9 |
groupingBy() | 8,31 | 13,7 |
groupingByConcurrent() | 0,98 | 6,82 |
joining(",") | 9,06 | 13,5 |
Ohne Arbeit pro Element misst die erste Spalte fast nur das Sammeln, und da teilen sich die Kandidaten in zwei Gruppen. Stream.toList(), joining(",") und groupingBy() fügen billig zusammen – groupingBy() deshalb, weil der Benchmark nach i % 1000 gruppiert und die Maps nur 1.000 Schlüssel haben. toSet() und toMap() dagegen sind parallel langsamer als sequenziell: Bei einer Million verschiedener Schlüssel kostet das Einfügen Eintrag für Eintrag mehr, als die Parallelität spart. toMap() braucht parallel 11,1 statt 8,81 Millisekunden.
toConcurrentMap() schlägt toMap() in beiden Spalten. groupingByConcurrent() verliert dagegen gegen groupingBy() – ohne Arbeit pro Element ist es nicht schneller als sequenziell. Der Grund steht im JDK-Quellcode: groupingByConcurrent() fügt jedes Element in einem synchronized-Block in die Liste seines Schlüssels ein, und bei nur 1.000 Schlüsseln warten die 18 Threads ständig aufeinander. Die Concurrent-Variante ist also nicht automatisch die schnellere.
Mit 100 Rechenschritten pro Element überwiegt die Arbeit, und vier der sieben Kandidaten kommen auf den Faktor 13,5 bis 14,9. Nur toSet(), toMap() und groupingByConcurrent() bleiben bei 5,8 bis 6,8 – das Zusammenfügen und das Warten auf den Lock bremsen sie auch hier.
Die Concurrent-Varianten haben außerdem einen Preis, den die Tabelle nicht zeigt: Sie geben die Reihenfolge auf. Welcher Thread einen Schlüssel zuerst einfügt, ist Zufall. Eine Merge-Funktion wie (first, second) -> second behält dann nicht den Wert des Elements, das in der Quelle weiter hinten steht, sondern den Wert, den zeitlich zuletzt irgendein Thread eingefügt hat – first und second stehen für die Reihenfolge des Einfügens, nicht für die der Quelle. Das Beispiel dazu steht im Artikel über Collectors.toMap().
Zum Vergleich: Arrays.parallelSort()
Wie viel Parallelität auf derselben Hardware höchstens bringt, zeigt eine Operation, die ohne Stream auskommt: Arrays.parallelSort() sortiert 100 Millionen double-Werte auf dem M5 Pro (18 Kerne) um den Faktor 11,7 schneller als Arrays.sort(), auf einem Dell XPS 17 mit Intel Core i7-12700H (14 Kerne) um den Faktor 8,6. Die Messung steht im Artikel über das Sortieren in Java. Keiner der beiden Rechner wird um so viel schneller, wie er Kerne hat; der Zusammenführungsschritt, die Speicherbandbreite und die Thread-Verwaltung kosten ihren Anteil.
Reihenfolge in parallelen Streams
Ein Stream aus einer List, einem Array oder IntStream.range() hat eine Encounter Order – die Reihenfolge, in der die Quelle ihre Elemente liefert. Ein paralleler Stream behält diese Reihenfolge für alle Operationen, die auf sie angewiesen sind: toList(), sorted(), limit(), skip(), findFirst() und forEachOrdered() liefern parallel dasselbe Ergebnis wie sequenziell.
forEach() dagegen ruft die Aktion auf jedem Thread auf, sobald dort ein Element ankommt. Das folgende Beispiel gibt die Anfangsbuchstaben der elf Titel aus, erst mit forEach(), dann mit forEachOrdered():
BOOKS.parallelStream()
    .map(Book::title)
    .forEach(title -> System.out.print(title.charAt(0)));
System.out.println();

BOOKS.parallelStream()
    .map(Book::title)
    .forEachOrdered(title -> System.out.print(title.charAt(0)));
System.out.println();
TMAFTKTPFAD
PFMFAATKTDTDie erste Zeile sieht bei jedem Lauf anders aus; die zweite ist die Reihenfolge der Bibliothek.
findFirst() liefert in einem parallelen Stream das erste passende Element in Encounter Order – und muss dafür warten, bis feststeht, dass kein früheres Teilstück einen Treffer enthält. findAny() nimmt den ersten Treffer, den irgendein Thread meldet. Fünf Läufe mit der Suche nach einem Abenteuerroman:
for (int i = 0; i < 5; i++) {
  Book book = BOOKS.parallelStream()
      .filter(b -> b.genre() == ADVENTURE)
      .findAny()
      .orElseThrow();
  System.out.println(book.title());
}
Treasure Island
Treasure Island
Treasure Island
Moby-Dick
KidnappedMit findFirst() steht fünfmal „Moby-Dick“ da, der erste Abenteuerroman der Liste.
Wenn dir die Reihenfolge egal ist, sag es dem Stream mit unordered(). Für limit(), skip() und distinct() entfällt dann die Koordination zwischen den Threads; was das bei limit() bringt, zeigt die Messung oben. Für Quellen ohne Encounter Order – ein HashSet zum Beispiel – ist der Stream von Anfang an ungeordnet, und unordered() ändert nichts.
Regeln für korrekte Ergebnisse
Ein paralleler Stream liefert dasselbe Ergebnis wie ein sequenzieller – wenn dein Code drei Regeln einhält. Geprüft wird keine davon. Ein Verstoß fällt erst dann auf, wenn derselbe Code parallel läuft – und das auch nicht bei jedem Lauf. Was passiert, wenn ein Lambda eine Exception wirft, steht am Ende des Kapitels.
Regel 1: Kein geteilter veränderlicher Zustand
Ein Lambda in der Pipeline berechnet Werte; es verändert nichts außerhalb der Pipeline. Der häufigste Verstoß ist eine Liste, die in forEach() gefüllt wird:
List<Integer> result = new ArrayList<>();
IntStream.range(0, 100_000)
    .parallel()
    .forEach(result::add);
System.out.println(result.size());
Fünf Läufe:
16170
java.lang.ArrayIndexOutOfBoundsException
11907
12510
8624
ArrayList ist nicht thread-sicher. Zwei Threads, die gleichzeitig add() aufrufen, überschreiben sich gegenseitig den Eintrag oder das Größenfeld – oder einer von ihnen schreibt an eine Position, die es nach der Vergrößerung des internen Arrays durch den anderen nicht gibt. Von 100.000 Elementen kommen zwischen 8.624 und 16.170 an.
Die Lösung ist, den Stream das Ergebnis bauen zu lassen:
List<Integer> result = IntStream.range(0, 100_000)
    .parallel()
    .boxed()
    .toList();
toList() gibt jedem Teilstück seinen eigenen Platz im Ergebnis – kein Thread schreibt dorthin, wo ein anderer schreibt.
Eine thread-sichere Collection wie ConcurrentHashMap.newKeySet() oder eine synchronizedList() würde das falsche Ergebnis auch beheben – aber zu einem Preis: Alle Threads warten dann an einem Lock oder konkurrieren um eine Cache-Line, und das ist das Gegenteil von dem, was du mit parallel() erreichen wolltest.
Regel 2: Keine zustandsbehafteten Lambdas
Regel 2 betrifft Lambdas, die sich etwas merken – einen Zähler zum Beispiel, der die Bücher durchnummerieren soll:
int[] counter = {0};
List<String> numbered = BOOKS.parallelStream()
    .map(book -> ++counter[0] + ". " + book.title())
    .toList();
System.out.println(numbered);
[5. Pride and Prejudice,
4. Frankenstein,
6. Moby-Dick,
8. From the Earth to the Moon,
2. Alice's Adventures in Wonderland,
10. Around the World in Eighty Days,
11. Treasure Island,
3. Kidnapped,
7. The Time Machine,
9. Dracula,
1. The War of the Worlds]Die Liste ist in der richtigen Reihenfolge, denn toList() stellt die Encounter Order wieder her – aber die Nummern stammen aus der Reihenfolge, in der die Threads die Elemente verarbeitet haben. Und ++counter[0] ist nicht atomar; bei mehr Elementen können zwei Bücher dieselbe Nummer bekommen.
Eine Nummer, die vom Platz des Elements abhängt, berechnest du am besten aus einem Stream der Indizes. Das folgende Listing erzeugt mit IntStream.range() die Indizes von 0 bis 10 und holt sich zu jedem Index das Buch aus der Liste:
List<String> numbered = IntStream.range(0, BOOKS.size())
    .parallel()
    .mapToObj(i -> (i + 1) + ". " + BOOKS.get(i).title())
    .toList();
System.out.println(numbered);
[1. Pride and Prejudice,
2. Frankenstein,
3. Moby-Dick,
4. From the Earth to the Moon,
5. Alice's Adventures in Wonderland,
6. Around the World in Eighty Days,
7. Treasure Island,
8. Kidnapped,
9. The Time Machine,
10. Dracula,
11. The War of the Worlds]Das Lambda hängt jetzt nur noch von seinem Parameter i ab und liefert in jeder Reihenfolge dasselbe Ergebnis.
Regel 3: Teilergebnisse müssen sich korrekt zusammenfügen lassen
Die Funktionen, die du reduce() übergibst, müssen in beliebiger Reihenfolge und Gruppierung dasselbe Ergebnis liefern. Der Identitätswert darf das Ergebnis nicht verändern, denn jedes Teilstück beginnt mit ihm:
int sequential = IntStream.rangeClosed(1, 5).reduce(10, Integer::sum);
int parallel = IntStream.rangeClosed(1, 5).parallel().reduce(10, Integer::sum);
System.out.println(sequential + " " + parallel);
25 65Sequenziell wird die 10 einmal addiert, parallel fünfmal – einmal pro Teilstück. Was Identitätswert, Akkumulator und Combiner im Einzelnen erfüllen müssen, zeigt der Artikel über Stream.reduce() mit Beispielen.
Für collect() gilt dasselbe für den Combiner des Collectors. Die Collectors aus Collectors erfüllen die Regeln; einen eigenen Collector musst du mit einem Combiner ausstatten, der zwei Ergebniscontainer so verschmilzt, dass die Reihenfolge der Elemente erhalten bleibt – es sei denn, du markierst ihn mit Collector.Characteristics.UNORDERED.
Ein Stream Gatherer mit Zustand läuft in einem parallelen Stream nur dann parallel, wenn du ihm einen Combiner gibst. Ein Gatherer aus Gatherer.ofSequential() hat keinen, und der Stream führt ihn sequenziell aus – auch in einer parallelen Pipeline.
Exceptions in parallelen Streams
Wirft ein Lambda eine Exception, bekommt der Thread sie, der die terminale Operation aufgerufen hat – auch wenn sie auf einem Worker-Thread entstanden ist. Was dabei nicht festliegt: welche Exception du bekommst, wenn mehrere Teilstücke eine werfen, und was mit den übrigen Elementen passiert.
Das folgende Programm wirft bei zehn von einer Million Elementen eine Exception und zählt die Elemente, die es ohne Exception verarbeitet hat – einmal in dem Moment, in dem die Exception ankommt, und noch einmal zwei Sekunden später:
AtomicInteger processed = new AtomicInteger();
try {
  IntStream.range(0, 1_000_000)
      .parallel()
      .forEach(i -> {
        if (i % 100_000 == 7) throw new IllegalStateException("element " + i);
        processed.incrementAndGet();
      });
} catch (IllegalStateException e) {
  int atCatch = processed.get();
  Thread.sleep(2000);
  System.out.println(e.getMessage() + " | at catch: " + atCatch
      + " | 2 s later: " + processed.get());
}
Fünf Läufe:
java.lang.IllegalStateException: element 100007 | at catch: 405666 | 2 s later: 859447
java.lang.IllegalStateException: element 900007 | at catch: 438607 | 2 s later: 867259
java.lang.IllegalStateException: element 900007 | at catch: 287214 | 2 s later: 776628
java.lang.IllegalStateException: element 800007 | at catch: 316167 | 2 s later: 836009
java.lang.IllegalStateException: element 7 | at catch: 212332 | 2 s later: 614113
Dass vor jeder Nachricht der Name der Exception steht, hat einen Grund: Die Exception, die beim Aufrufer ankommt, ist nicht das Original (dessen Nachricht nicht mit dem Namen der Exception, sondern mit „element …“ beginnt). Stammt die Exception von einem Worker-Thread, erzeugt der Pool eine neue Exception desselben Typs mit dem Original als Ursache – so zeigt ihr Stack-Trace den Aufrufer, und die Nachricht der neuen Exception ist der Text des Originals samt dem Namen der Exception. An das Original kommst du mit getCause().
Sequenziell käme immer element 7, mit sieben verarbeiteten Elementen davor. Parallel kommt die Exception an, die zuerst geworfen wird – in den fünf Läufen vier verschiedene –, und die übrigen Exceptions gehen verloren; getSuppressed() ist leer.
Und der Aufrufer bekommt sie, während die anderen Worker-Threads noch arbeiten: Beim catch sind 210.000 bis 440.000 Elemente verarbeitet, zwei Sekunden später 610.000 bis 870.000.
Bei einer Exception in einem Teilstück bricht der Stream die anderen Teilstücke nicht ab. Jeder Worker-Thread verarbeitet sein aktuelles Teilstück zu Ende und holt sich danach das nächste aus einer Warteschlange – auch der Thread, in dem die Exception aufgetreten ist. Mit einer einzigen Exception bei Element 500.007 hat dieser Thread in drei von fünf Läufen danach noch 7.812 bis 15.626 Elemente verarbeitet.
Liegen bleiben der Rest des Teilstücks, in dem die Exception auftrat, und Teilstücke aus demselben Zweig der Aufteilung, die noch in einer Warteschlange warteten. Der Grund: Die Exception markiert auf ihrem Weg zum Aufrufer die Aufgaben, aus denen ihr Teilstück abgespalten wurde, als abgeschlossen – und eine abgeschlossene Aufgabe überspringt der Pool, wenn ein Thread sie aus der Warteschlange holt. Deshalb kommen im Beispiel nie alle 999.990 Elemente an.
Für dich heißt das: Ein paralleler Stream, der bei einem Fehler abbrechen soll, muss damit umgehen, dass ein zufälliger Teil der Elemente verarbeitet wurde – und dass die Verarbeitung weitergeht, während dein catch-Block schon läuft.
Blockierende Aufrufe in parallelen Streams
Der Common Pool hat so viele Threads wie Kerne, weil er für Rechenarbeit gebaut ist. Ein Thread, der auf eine HTTP-Antwort, eine Datenbank oder Thread.sleep() wartet, belegt seinen Platz im Pool, ohne einen Kern zu nutzen. Und weil sich alle parallelen Streams der JVM denselben Pool teilen, wartet nicht nur dein Stream – alle anderen warten mit.
Das folgende Programm misst, wie lang eine Rechenaufgabe im parallelen Stream dauert – allein, und während in einem anderen Thread ein paralleler Stream läuft, der 200-mal je 100 Millisekunden schläft:
static long computeMillis() {
  long start = System.nanoTime();
  LongStream.range(0, 400_000_000L)
      .parallel()
      .map(i -> i * i % 7)
      .sum();
  return (System.nanoTime() - start) / 1_000_000;
}

static void blockingStream() {
  IntStream.range(0, 200)
      .parallel()
      .forEach(_ -> sleep(100));
}

static void sleep(long millis) {
  try {
    Thread.sleep(millis);
  } catch (InterruptedException e) {
    Thread.currentThread().interrupt();
  }
}

public static void main(String[] args) throws InterruptedException {
  for (int i = 0; i < 3; i++) computeMillis(); // wärmt den JIT-Compiler auf
  System.out.println("alone: " + computeMillis() + " ms");

  Thread other = Thread.ofPlatform().start(Ch7Blocking::blockingStream);
  Thread.sleep(50);
  System.out.println("while the blocking stream runs: " + computeMillis() + " ms");
  other.join();

  long start = System.nanoTime();
  blockingStream();
  System.out.println("blocking stream alone: "
      + (System.nanoTime() - start) / 1_000_000 + " ms");
}
alone: 15 ms
while the blocking stream runs: 168 ms
blocking stream alone: 1246 msDie Rechenaufgabe braucht mehr als zehnmal so lang, denn 17 der 18 Threads schlafen gerade in forEach() des anderen Streams, und der Thread main rechnet allein. Der blockierende Stream selbst braucht 1,2 Sekunden für 200 Aufrufe von je 100 Millisekunden, weil nur 18 Aufrufe gleichzeitig warten – würden alle 200 Aufrufe gleichzeitig warten, wären sie nach 100 Millisekunden fertig.
Für blockierende Aufrufe nimmst du deshalb nicht parallel(), sondern virtuelle Threads – und in einer Stream-Pipeline den Gatherer mapConcurrent(), seit Java 24. Er startet für jedes Element einen virtuellen Thread, begrenzt die Zahl der gleichzeitigen Aufrufe auf den Wert, den du angibst, und behält die Reihenfolge der Elemente:
List<UserData> users = urls.stream()
    .gather(Gatherers.mapConcurrent(50, this::fetchUser))
    .toList();
Die Faustregel in Streams: parallel() für Rechenarbeit, mapConcurrent() für Warten.
Ein paralleler Stream in einem eigenen ForkJoinPool
Die Zahl der Threads lässt sich pro Stream nicht einstellen – jedenfalls nicht über die Stream-API. Es gibt aber einen Weg, der sich aus der Funktionsweise des ForkJoinPool ergibt: Erzeugt eine Aufgabe, die auf einem Thread eines ForkJoinPool läuft, Teilaufgaben, landen diese in den Warteschlangen desselben Pools. Startest du die terminale Operation also innerhalb eines eigenen Pools, laufen die Teilstücke des Streams in eben diesem Pool:
try (ForkJoinPool pool = new ForkJoinPool(4)) {
  Set<String> threadNames = pool.submit(() ->
      IntStream.range(0, 1_000_000)
          .parallel()
          .mapToObj(i -> Thread.currentThread().getName())
          .collect(Collectors.toSet())).get();
  System.out.println(threadNames);
}
[ForkJoinPool-1-worker-1,
ForkJoinPool-1-worker-4,
ForkJoinPool-1-worker-2,
ForkJoinPool-1-worker-3]Der Stream läuft auf den vier Threads des eigenen Pools, der Common Pool bleibt unberührt. ForkJoinPool ist seit Java 19 AutoCloseable, deshalb das Try-with-resources.
Ich nenne dir diesen Weg, weil du ihn in Projekten finden wirst – empfehlen kann ich ihn nicht. Er ist nicht Teil der Spezifikation der Stream-API: Das Javadoc von parallel() sagt nichts über den Pool, und der Mechanismus ist ein Nebeneffekt der ForkJoinPool-Implementierung. Zwei Einschränkungen zeigen das. Erstens richtet sich die Zielgröße der Teilstücke weiterhin nach der Parallelität des Common Pool, nicht nach der deines Pools – AbstractTask liest sie aus ForkJoinPool.getCommonPoolParallelism(). Zweitens startet jeder eigene Pool seine eigenen Threads, die mit denen des Common Pool um dieselben Kerne konkurrieren – zusammen laufen dann mehr Threads, als der Rechner Kerne hat.
Wenn du eine feste Zahl von Threads für eine Aufgabe brauchst, bist du mit einem ExecutorService und expliziten Tasks besser bedient. Und wenn du blockierende Aufrufe parallelisieren willst, mit mapConcurrent().
Häufige Fehler
parallel() ohne Messung
Der häufigste Fehler ist, parallel() zu setzen, weil es nicht schaden kann. Es kann – die erste Tabelle oben zeigt, in welchem Bereich: Bei wenigen Elementen und wenig Arbeit pro Element ist der parallele Stream langsamer als der sequenzielle. 100 Elemente ohne Arbeit verarbeitet er in 35 Mikrosekunden, der sequenzielle in 0,2. Und in einer Webanwendung konkurrieren die parallelen Streams aller gleichzeitigen Requests um denselben Common Pool.
Ich empfehle dir, parallel() als das zu behandeln, was es ist: eine Optimierung. Du setzt sie, wenn ein Profiler oder eine Messung zeigt, dass der Stream ein Engpass ist, und du behältst sie, wenn die Messung danach besser aussieht.
Mit System.currentTimeMillis() messen
Die Messung selbst ist der zweite Fehler. Ein Programm, das einen Stream einmal sequenziell und einmal parallel ausführt und die Zeit mit System.currentTimeMillis() nimmt, misst den JIT-Compiler, den ersten Aufbau des Common Pool und den Garbage Collector mit. Beim ersten parallelen Stream einer JVM erzeugt der Common Pool erst seine Worker-Threads – auf dem M5 Pro 17 Stück.
Nimm JMH – mit Aufwärm-Iterationen, mehreren Forks und einer Blackhole, die verhindert, dass der JIT-Compiler das Ergebnis wegoptimiert. Die Benchmarks dieses Artikels kannst du als Vorlage nehmen – sie liegen im Verzeichnis benchmarks/parallel-streams des GitHub-Repositorys java-streams-examples.
Mit forEach() sammeln
Wer das Ergebnis eines Streams mit forEach() in eine Liste oder Map schreibt, hat in einem parallelen Stream das Problem aus dem Abschnitt über den geteilten Zustand – und in einem sequenziellen eine Pipeline, die beim Umstellen auf parallel() falsche Ergebnisse liefert. Die Pipeline baut ihr Ergebnis mit toList(), collect() oder reduce(); forEach() ist für Aktionen, die kein Ergebnis liefern, etwa eine Ausgabe.
parallel() mitten in der Pipeline
parallel() nach filter() zu setzen, sieht so aus, als liefen nur die Operationen danach parallel. Das tut es nicht: Der Aufruf setzt ein Flag auf der Quelle, und die ganze Pipeline läuft parallel – einschließlich filter(). Schreib parallel() deshalb direkt hinter die Quelle, wo es keine falsche Erwartung weckt.
Zusammenfassung
Ein paralleler Stream teilt seine Quelle mit dem Spliterator in Teilstücke, verarbeitet sie auf dem Common Pool – so viele Threads, wie der Rechner Kerne hat, den aufrufenden Thread mitgezählt – und fügt die Teilergebnisse paarweise zusammen. Die Pipeline bleibt dieselbe; parallel() ändert nur, wer sie ausführt.
Ob das schneller ist, hängt vor allem davon ab, wie lange der sequenzielle Stream braucht. Auf dem M5 Pro war der parallele Stream langsamer, solange der sequenzielle höchstens 19 Mikrosekunden brauchte, und schneller ab 50 Mikrosekunden – mehr als den Faktor 15 brachte er auf 18 Kernen nicht. Die Quelle spielte bei 100 Rechenschritten pro Element kaum eine Rolle: Selbst die LinkedList kam auf den Faktor 13,4, nur das TreeSet fiel mit 7,92 deutlich ab. Beim Sammeln dagegen kann der Collector den Vorteil auffressen: toMap() und toSet() waren ohne Arbeit pro Element parallel langsamer als sequenziell.
Vier Empfehlungen für den Alltag:
- Setz
parallel()nur nach einer Messung, und miss mit JMH. - Lass den Stream sein Ergebnis bauen – mit
toList(),collect()oderreduce(), nie mitforEach()in eine geteilte Collection. - Nimm
findAny()stattfindFirst()undunordered()vorlimit(), wenn dir die Reihenfolge egal ist. - Nimm für blockierende Aufrufe
mapConcurrent()stattparallel().
Welche Operationen es in einer Pipeline sonst gibt und wie sie zusammenwirken, zeigt der Artikel über Java Streams.
Hat dieser Artikel deine Fragen beantwortet? Dann freue ich mich über eine Bewertung auf meinem ProvenExpert-Profil – sie hilft anderen Entwickler:innen, diese Inhalte zu finden.