Ein FileReader liest Text aus einer Datei. Er öffnet die Datei, liest ihre Bytes und dekodiert sie mit einer Zeichenkodierung zu Zeichen – seit Java 18 standardmäßig mit UTF-8.
Seit Java 25 kann er eine ganze Datei mit einem einzigen Methodenaufruf in einen String einlesen:
try (FileReader reader = new FileReader("files/server.log")) {
  String text = reader.readAllAsString();
  System.out.print(text);
}
2026-10-17 08:15:02 INFO Server started on port 8080
2026-10-17 08:15:07 INFO GET /java/java-bufferedreader/ 200
2026-10-17 08:15:09 WARN GET /java/bufferedreader/ 404
2026-10-17 08:15:11 INFO GET /java/java-streams/ 200
2026-10-17 08:15:12 ERROR Connection reset by peerDen FileReader gibt es seit Java 1.1. Meist steht er nicht allein, sondern verpackt in einem BufferedReader, der seinen Text Zeile für Zeile liefert. Er selbst hat keine einzige eigene Methode: Alles, was er kann, erbt er vom InputStreamReader.
In diesem Artikel erfährst du,
- was im
FileReadersteckt und wie er mitFileInputStreamundInputStreamReaderzusammenhängt, - wie du einen
FileReadererzeugst und die Zeichenkodierung festlegst, - wie du zeichenweise, blockweise und alles auf einmal liest – und was der
FileReadernicht kann, - warum er ungültige Bytes stillschweigend ersetzt und wie du stattdessen eine Exception bekommst,
- wie du mit einem
InputStreamReaderText aus einem beliebigenInputStreamliest, - wann du einen
BufferedReaderbrauchst und wannFileInputStreamdie richtige Klasse ist, - wie schnell der
FileReaderliest, - warum du den
FileReaderimmer schließen musst.
Die Beispiele in diesem Artikel
Die meisten Beispiele lesen die kleine Log-Datei files/server.log aus der Einleitung, die auch die Beispiele im Artikel über den BufferedReader lesen. Sie hat fünf Zeilen mit insgesamt 276 Zeichen, alle aus dem ASCII-Zeichensatz.
Den vollständigen Code findest du im GitHub-Repository java-file-io, im Package eu.happycoders.filereader. Jeder Abschnitt hat dort eine eigene Klasse mit einer main()-Methode, die die gezeigten Ausgaben erzeugt. Starte die Klassen im Hauptverzeichnis des Repositorys; Dateien, die von den Beispielen angelegt werden, landen im Verzeichnis target/.
Die Beispiele verwenden Methoden aus Java 25 und laufen deshalb erst ab dieser Version. Arbeitest du mit einer älteren Version: Bei den neueren Methoden steht im Text, seit wann es sie gibt – von transferTo() aus Java 10 bis readAllAsString() aus Java 25.
Was ist ein FileReader?
FileReader ist eine Unterklasse von InputStreamReader, und die ist wiederum eine Unterklasse von Reader, der abstrakten Basisklasse aller Klassen, die Zeichen lesen.
Die Klasse FileReader besteht nur aus fünf Konstruktoren. Jeder öffnet die Datei mit einem FileInputStream und übergibt diesen an den Konstruktor der Elternklasse InputStreamReader. So sieht beispielsweise der Konstruktor mit Dateiname und Zeichenkodierung aus:
public FileReader(String fileName, Charset charset) throws IOException {
  super(new FileInputStream(fileName), charset);
}
Ein new FileReader(fileName, charset) ist also dasselbe wie ein new InputStreamReader(new FileInputStream(fileName), charset) – nur kürzer geschrieben.
Die folgende Grafik zeigt, wie die Klassen zum Lesen von Dateien zusammenhängen. Die durchgezogenen Linien stehen für Binärdaten, also Bytes, die gestrichelten Linien für Textdaten, also Zeichen und Strings:
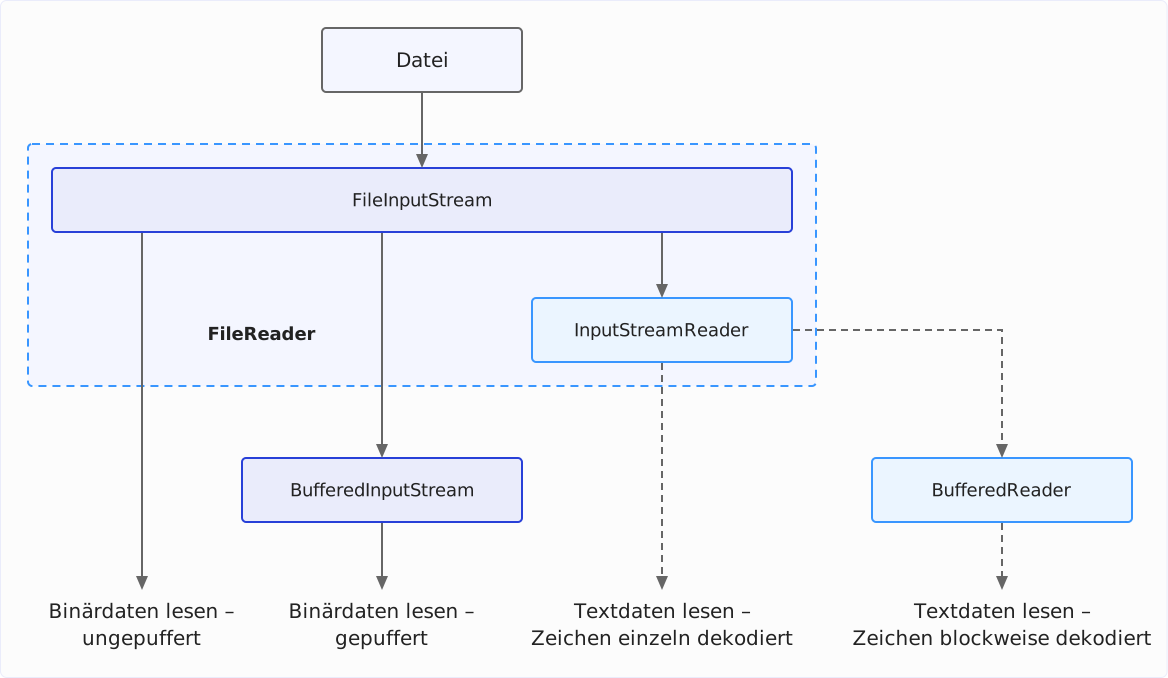
Der FileInputStream liefert die Bytes der Datei. Der InputStreamReader wandelt sie in Zeichen um – das nennt man Dekodieren. Das übernimmt allerdings nicht er selbst, sondern ein StreamDecoder aus dem JDK-internen Package sun.nio.cs, an den der InputStreamReader jeden Methodenaufruf weiterreicht.
Der StreamDecoder liest die Bytes in Blöcken von 8.192 Bytes aus dem FileInputStream und lässt einen CharsetDecoder der gewählten Zeichenkodierung daraus Zeichen machen. Der FileReader greift also auch dann nur alle 8.192 Bytes auf die Datei zu, wenn du ihn Zeichen für Zeichen liest.
Einen FileReader erzeugen
Die fünf FileReader-Konstruktoren unterscheiden sich in zwei Punkten: wie du die Datei angibst und ob du eine Zeichenkodierung übergibst.
| Konstruktor | Seit | Zeichenkodierung |
|---|---|---|
FileReader(String fileName) | Java 1.1 | Standard der JVM |
FileReader(File file) | Java 1.1 | Standard der JVM |
FileReader(FileDescriptor fd) | Java 1.1 | Standard der JVM |
FileReader(String fileName, Charset charset) | Java 11 | charset |
FileReader(File file, Charset charset) | Java 11 | charset |
Dateiname, File und Path
Die Datei übergibst du als Dateinamen oder als File-Objekt. Einen Konstruktor für einen Path aus der NIO.2-API gibt es nicht; einen Path wandelst du mit toFile() in ein File-Objekt um:
Path log = Path.of("files/server.log");
try (FileReader fromName = new FileReader("files/server.log");
    FileReader fromFile = new FileReader(new File("files/server.log"));
    FileReader fromPath = new FileReader(log.toFile())) {
  // alle drei lesen dieselbe Datei
}
Der dritte Weg, ein FileDescriptor, verweist auf eine Datei, die schon geöffnet ist, z. B. über FileDescriptor.in auf die Standardeingabe. Für das Lesen von Dateien brauchst du ihn nicht.
Die Zeichenkodierung festlegen
Die Konstruktoren mit Charset-Parameter gibt es seit Java 11. Ohne diesen Parameter verwendet der FileReader die Standard-Kodierung der JVM, Charset.defaultCharset().
Seit Java 18 ist diese Standard-Kodierung immer UTF-8 (JEP 400). Bis einschließlich Java 17 hing sie vom Betriebssystem und der Locale ab: Auf einem deutschen Windows war sie meist Windows-1252, auf Linux und macOS meist UTF-8. Derselbe Code las dieselbe Datei also je nach Rechner verschieden. Die Details stehen im Artikel über das Lesen von Dateien, im Abschnitt Welche Zeichenkodierung verwendet Java standardmäßig zum Lesen von Textdateien?
Welche Kodierung ein FileReader verwendet, liefert dir die Methode getEncoding(). Das folgende Beispiel erzeugt vier FileReader – ohne Kodierung und mit drei verschiedenen – und gibt jeweils getEncoding() aus, zuletzt für einen geschlossenen FileReader:
try (FileReader reader = new FileReader("files/server.log")) {
  System.out.println("Without charset: " + reader.getEncoding());
}
try (FileReader reader = new FileReader("files/server.log", UTF_8)) {
  System.out.println("UTF_8:           " + reader.getEncoding());
}
try (FileReader reader = new FileReader("files/server.log", ISO_8859_1)) {
  System.out.println("ISO_8859_1:      " + reader.getEncoding());
}
try (FileReader reader =
    new FileReader("files/server.log", Charset.forName("windows-1252"))) {
  System.out.println("windows-1252:    " + reader.getEncoding());
}

FileReader closed = new FileReader("files/server.log");
closed.close();
System.out.println("After close():   " + closed.getEncoding());
Without charset: UTF8
UTF_8: UTF8
ISO_8859_1: ISO8859_1
windows-1252: Cp1252
After close(): nullBeachte die Schreibweise: getEncoding() liefert nicht den Namen, unter dem du die Kodierung angegeben hast, sondern ihren sogenannten historischen Namen, also den Namen, den Java aus Kompatibilität mit den Versionen vor der Klasse Charset (Java 1.4) definiert, sofern die Kodierung einen hat – UTF8 statt UTF-8, Cp1252 statt windows-1252. Nach close() liefert die Methode null.
Ich empfehle, die Kodierung immer dann anzugeben, wenn dein Code auch auf Java 17 oder älter laufen muss oder die Datei nicht in UTF-8 vorliegt. Läuft er nur auf Java 18 oder neuer und liest UTF-8-Dateien, ändert ein UTF_8 im Konstruktor nichts am Ergebnis.
Wenn sich die Datei nicht öffnen lässt
Der Konstruktor öffnet die Datei sofort. Gibt es sie nicht, ist sie ein Verzeichnis oder darf das Programm sie nicht lesen, wirft er eine FileNotFoundException:
for (String fileName : new String[] {"files/missing.log", "files"}) {
  try (FileReader reader = new FileReader(fileName, UTF_8)) {
    System.out.println(reader.read());
  } catch (IOException e) {
    System.out.println(e);
  }
}
java.io.FileNotFoundException: files/missing.log (No such file or directory)
java.io.FileNotFoundException: files (Is a directory)Den Grund in Klammern liefert das Betriebssystem, die Ausgabe oben stammt von macOS. Bei einer Datei ohne Leserecht steht dort Permission denied.
Die beiden Konstruktoren mit Charset-Parameter deklarieren übrigens IOException statt FileNotFoundException, werfen aber in allen drei Fällen dieselbe FileNotFoundException.
Lesen mit dem FileReader
Alle Lesemethoden des FileReader stammen aus Reader und InputStreamReader. Mit ihnen kannst du zeichenweise, in Blöcken oder den ganzen Rest der Datei auf einmal lesen.
Zeichenweise lesen: read()
read() liefert das nächste Zeichen als int, am Ende der Datei -1. Der Rückgabetyp ist int statt char, damit -1 sich von jedem Zeichen unterscheidet. Die übliche Schleife weist das Ergebnis in der Bedingung zu und prüft es auf -1.
Das folgende Programm zählt so die Zeilenumbrüche der Log-Datei:
try (FileReader reader = new FileReader("files/server.log")) {
  int c;
  int count = 0;
  while ((c = reader.read()) != -1) {
    if (c == '\n') {
      count++;
    }
  }
  System.out.println(count + " lines");
}
5 linesEin read() liefert allerdings kein Zeichen im Sinne von Unicode, sondern ein char, also eine UTF-16-Codeeinheit. Zeichen außerhalb der sogenannten Basic Multilingual Plane, z. B. viele Emojis, belegen zwei davon, ein sogenanntes Surrogatpaar.
Das zeigt das folgende Programm. Es schreibt eine Kaffeetasse und eine Rakete in eine Datei, liest sie mit read() und gibt zu jedem Ergebnis den Hexadezimalwert und den Unicode-Namen aus:
Path coffee = Path.of("target/coffee.txt");
Files.writeString(coffee, "☕🚀");
try (FileReader reader = new FileReader(coffee.toFile())) {
  int c;
  while ((c = reader.read()) != -1) {
    System.out.println(Integer.toHexString(c) + " " + Character.getName(c));
  }
}
2615 HOT BEVERAGE
d83d HIGH SURROGATES D83D
de80 LOW SURROGATES DE80Die Kaffeetasse liegt in der Basic Multilingual Plane, deshalb liefert ein einziger read()-Aufruf sie vollständig. Die Rakete dagegen liefert read() in zwei Hälften, verteilt auf zwei Aufrufe. Wenn du Zeichen zählst, filterst oder einzeln mit (char) c weiterverarbeitest, musst du Surrogatpaare deshalb selbst zusammensetzen, z. B. mit Character.toCodePoint().
Blockweise lesen: read(char[])
read(char[]) füllt ein char-Array und liefert die Zahl der gelesenen Zeichen, am Ende der Datei -1. Die Schleife im folgenden Beispiel liest die Log-Datei in Blöcken von 100 Zeichen:
try (FileReader reader = new FileReader("files/server.log")) {
  char[] buffer = new char[100];
  int length;
  while ((length = reader.read(buffer)) != -1) {
    System.out.println("read " + length + " characters");
  }
}
read 100 characters
read 100 characters
read 76 charactersDie 276 Zeichen der Datei kommen in drei Blöcken, der letzte ist nur 76 Zeichen lang. Gültig sind nach jedem Aufruf nur die ersten length Zeichen des Arrays. Dahinter steht ggf. noch, was der vorige Aufruf hineingeschrieben hat.
Das zeigt das folgende Programm. Es hängt die Blöcke zweimal an einen StringBuilder an: einmal nur die ersten length Zeichen, einmal das ganze Array. Anschließend gibt es die Länge beider Ergebnisse aus und die letzte Zeile des zweiten:
StringBuilder correct = new StringBuilder();
StringBuilder wholeArray = new StringBuilder();
try (FileReader reader = new FileReader("files/server.log")) {
  char[] buffer = new char[100];
  int length;
  while ((length = reader.read(buffer)) != -1) {
    correct.append(buffer, 0, length);
    wholeArray.append(buffer);
  }
}
System.out.println("correct:     " + correct.length() + " characters");
System.out.println("whole array: " + wholeArray.length() + " characters");
System.out.println(wholeArray.substring(wholeArray.lastIndexOf("\n") + 1));
correct: 276 characters
whole array: 300 characters
10-17 08:15:11 INFO GETDas ganze Array ergibt 300 statt 276 Zeichen. Die 24 überzähligen Zeichen in der letzten Zeile stammen aus dem zweiten Block, der an diesen Positionen des Arrays stand.
Es gibt auch eine Variante read(char[], int, int), die das Array ab einer bestimmten Position bis zu einer bestimmten Länge füllt. read(char[]) ruft sie mit Position 0 und der Länge des Arrays auf.
Ein Surrogatpaar verteilt der FileReader dabei nicht auf zwei Blöcke: Ist im Array nur noch eine Position frei und folgt als Nächstes ein Surrogatpaar, liefert read(char[]) ein Zeichen weniger, und das Paar steht am Anfang des nächsten Blocks. Das ist allerdings ein Verhalten der Implementierung im JDK, keine Zusage aus der Dokumentation von Reader: Ein StringReader z. B. trennt das Paar. Und bei einem Array der Länge 1 liefert auch read(char[]) wie read() erst die eine und dann die andere Hälfte.
Alles auf einmal lesen: readAllAsString() und readAllLines()
Seit Java 25 hat jeder Reader zwei Methoden, die den Rest der Eingabe auf einmal lesen: readAllAsString() liefert ihn als String, readAllLines() als Liste von Zeilen.
Das folgende Programm liest die Log-Datei zuerst mit readAllLines(). Dann öffnet es sie ein zweites Mal, überspringt mit skip() die ersten 20 Zeichen, also Datum und Uhrzeit, und liest den Rest mit readAllAsString():
try (FileReader reader = new FileReader("files/server.log")) {
  List<String> lines = reader.readAllLines();
  System.out.println(lines.size() + " lines, the last one: " + lines.getLast());
}

try (FileReader reader = new FileReader("files/server.log")) {
  reader.skip(20);
  String rest = reader.readAllAsString();
  System.out.println(rest.lines().findFirst().orElseThrow());
}
5 lines, the last one: 2026-10-17 08:15:12 ERROR Connection reset by peer
INFO Server started on port 8080Beide Methoden lesen ab der aktuellen Position, nicht ab dem Anfang der Datei. readAllLines() erkennt dieselben Zeilenenden wie BufferedReader.readLine(): \n, \r\n und \r.
Für eine Datei, die du als Ganzes brauchst, gibt es schon länger zwei Methoden in der Klasse Files: Files.readString() seit Java 11 und Files.readAllLines() seit Java 7. Sie unterscheiden sich vom FileReader darin, wie sie auf ungültige Bytes reagieren – das zeigt der Abschnitt Ungültige Bytes: Ersatzzeichen oder Exception.
In einen Writer übertragen: transferTo()
Seit Java 10 kannst du mit transferTo() alle restlichen Zeichen eines Reader in einen Writer übertragen. So kannst du z. B. eine Datei umkodieren, indem du Reader und Writer mit einer unterschiedlichen Kodierung initialisierst.
Das folgende Programm schreibt „Grüße aus Köln“ als ISO-8859-1 in eine Datei, kodiert sie mit transferTo() nach UTF-8 um und gibt beide Dateigrößen und den Inhalt der neuen Datei aus:
Path latin1 = Path.of("target/greeting-latin1.txt");
Files.writeString(latin1, "Grüße aus Köln", ISO_8859_1);

Path utf8 = Path.of("target/greeting-utf8.txt");
long characters;
try (FileReader reader = new FileReader(latin1.toFile(), ISO_8859_1);
    FileWriter writer = new FileWriter(utf8.toFile(), UTF_8)) {
  characters = reader.transferTo(writer);
}

System.out.println(characters + " characters transferred");
System.out.println("ISO-8859-1: " + Files.size(latin1) + " bytes");
System.out.println("UTF-8:      " + Files.size(utf8) + " bytes");
System.out.println(Files.readString(utf8));
14 characters transferred
ISO-8859-1: 14 bytes
UTF-8: 17 bytes
Grüße aus KölnDie 14 Zeichen belegen in ISO-8859-1 14 Bytes, in UTF-8 17 Bytes: „ü“, „ß“ und „ö“ brauchen in UTF-8 je zwei Bytes statt einem.
Was der FileReader nicht kann: readLine(), mark() und reset()
Eine Methode, die eine einzelne Zeile liest, hat der FileReader nicht. readLine() gibt es nur im BufferedReader – wie du diesen um einen FileReader legst, zeigt der Abschnitt FileReader und BufferedReader.
Auch mark() und reset(), mit denen ein Reader sich eine Position merkt und später zu ihr zurückspringt, unterstützt der FileReader nicht. markSupported() liefert false, und beide Methoden werfen eine IOException:
try (FileReader reader = new FileReader("files/server.log")) {
  System.out.println("markSupported(): " + reader.markSupported());
  try {
    reader.mark(100);
  } catch (IOException e) {
    System.out.println(e);
  }
  try {
    reader.reset();
  } catch (IOException e) {
    System.out.println(e);
  }
}
markSupported(): false
java.io.IOException: mark() not supported
java.io.IOException: reset() not supportedDer BufferedReader dagegen unterstützt beide Methoden, denn er hat die gelesenen Zeichen in seinem Puffer und kann zu ihnen zurückkehren.
Ungültige Bytes: Ersatzzeichen oder Exception
Ein FileReader meldet keinen Fehler, wenn eine Datei nicht in der erwarteten Kodierung vorliegt. Er ersetzt jedes Byte, das in dieser Kodierung kein gültiges Zeichen ergibt, durch das Unicode-Ersatzzeichen U+FFFD, das die meisten Schriftarten als Raute mit Fragezeichen zeichnen.
Der FileReader ersetzt ungültige Bytes
Das folgende Programm schreibt „Grüße aus Köln“ als ISO-8859-1 in eine Datei und liest sie mit einem FileReader für UTF-8. In ISO-8859-1 belegt jeder Umlaut ein einzelnes Byte zwischen 128 und 255. In UTF-8 ist ein solches Byte nie ein Zeichen für sich, sondern höchstens Teil einer Folge mehrerer Bytes – einzeln ist es ungültig:
Path latin1 = Path.of("target/greeting-latin1.txt");
Files.writeString(latin1, "Grüße aus Köln", ISO_8859_1);

try (FileReader reader = new FileReader(latin1.toFile(), UTF_8)) {
  String text = reader.readAllAsString();
  System.out.println(text);
  System.out.println("Contains U+FFFD: " + (text.indexOf(0xFFFD) >= 0));
}
Gr��e aus K�ln
Contains U+FFFD: trueAus „ü“, „ß“ und „ö“ sind drei Ersatzzeichen geworden, und das Programm läuft ohne Exception weiter.
Woher kommt das? Der StreamDecoder erzeugt den CharsetDecoder für einen InputStreamReader – und damit für jeden FileReader – mit der Fehlerbehandlung REPLACE:
cs.newDecoder()
    .onMalformedInput(CodingErrorAction.REPLACE)
    .onUnmappableCharacter(CodingErrorAction.REPLACE)
onMalformedInput() legt fest, was bei einer ungültigen Bytefolge passiert, onUnmappableCharacter(), was bei einem Zeichen passiert, das es in der Zielkodierung nicht gibt. REPLACE heißt in beiden Fällen: Ersatzzeichen einsetzen und weiterlesen.
Eine Exception statt Ersatzzeichen
Ein CharsetDecoder, den du selbst mit newDecoder() erzeugst, hat dagegen die Fehlerbehandlung REPORT. Einen solchen Decoder kannst du dem InputStreamReader im Konstruktor übergeben. Der InputStreamReader meldet ein ungültiges Byte dann mit einer MalformedInputException.
Das folgende Programm liest dieselbe ISO-8859-1-Datei mit einem InputStreamReader um einen FileInputStream und einem Decoder mit REPORT. Die beiden on…()-Aufrufe sind nicht nötig, da REPORT schon der Standard ist; sie stehen hier, damit sichtbar ist, was der Decoder tut:
CharsetDecoder decoder =
    UTF_8
        .newDecoder()
        .onMalformedInput(CodingErrorAction.REPORT)
        .onUnmappableCharacter(CodingErrorAction.REPORT);
try (InputStreamReader reader =
    new InputStreamReader(new FileInputStream(latin1.toFile()), decoder)) {
  System.out.println(reader.readAllAsString());
} catch (IOException e) {
  System.out.println(e);
}
java.nio.charset.MalformedInputException: Input length = 1MalformedInputException ist eine Unterklasse von IOException. „Input length = 1“ bedeutet: Ein einzelnes Byte ließ sich nicht dekodieren.
So arbeitet übrigens auch Files.newBufferedReader(). Die Methode besteht im JDK aus drei Zeilen:
CharsetDecoder decoder = cs.newDecoder();
Reader reader = new InputStreamReader(newInputStream(path), decoder);
return new BufferedReader(reader);
Files.readString() und Files.readAllLines() werfen bei ungültigen Bytes ebenfalls eine Exception. Der FileReader ist von diesen Wegen also der einzige, der stillschweigend weiterliest.
Ich empfehle, Dateien mit Files.newBufferedReader() oder Files.readString() zu lesen. Eine Datei in der falschen Kodierung fällt dann beim ersten ungültigen Byte auf, statt mit Ersatzzeichen weiterverarbeitet zu werden. Eine Datei, die auch nur ein ungültiges Byte enthält, lässt sich so allerdings gar nicht lesen. Musst du solche Dateien trotzdem verarbeiten, ist der FileReader die richtige Wahl – dann prüfe den gelesenen Text auf U+FFFD.
Die Byte Order Mark bleibt stehen
Manche Programme schreiben an den Anfang einer UTF-8-Datei die drei Bytes EF BB BF, die sogenannte Byte Order Mark (BOM). Sie kennzeichnet die Datei als UTF-8. Der FileReader entfernt sie nicht, sondern liefert sie als erstes Zeichen, U+FEFF.
Das folgende Programm schreibt eine CSV-Datei mit BOM und liest sie mit einem FileReader. Es gibt die Kopfzeile, ihre Länge und ihr erstes Zeichen aus und vergleicht sie mit "id;name". Danach entfernt es die BOM und vergleicht erneut:
Path withBom = Path.of("target/bom.csv");
byte[] bom = {(byte) 0xEF, (byte) 0xBB, (byte) 0xBF};
Files.write(withBom, bom);
Files.writeString(withBom, "id;name\n1;Grüße\n", UTF_8, APPEND);

try (FileReader reader = new FileReader(withBom.toFile(), UTF_8)) {
  String text = reader.readAllAsString();
  String header = text.lines().findFirst().orElseThrow();
  System.out.println("Header:            " + header);
  System.out.println("Length:            " + header.length());
  System.out.println(
      "First character:   U+" + Integer.toHexString(header.charAt(0)).toUpperCase());
  System.out.println("equals(\"id;name\"): " + header.equals("id;name"));

  if (!text.isEmpty() && text.charAt(0) == 0xFEFF) {
    text = text.substring(1);
  }
  String firstLine = text.lines().findFirst().orElseThrow();
  System.out.println("Without BOM:       " + firstLine.equals("id;name"));
}
Header: id;name
Length: 8
First character: U+FEFF
equals("id;name"): false
Without BOM: trueDie Kopfzeile sieht in der Ausgabe aus wie id;name, ist aber acht Zeichen lang, und der Vergleich schlägt fehl. Erst ohne das erste Zeichen ist sie gleich.
Das ist keine Eigenheit des FileReader: Auch Files.newBufferedReader() und Files.readString() liefern die BOM als erstes Zeichen. Liest du Dateien, die eine BOM haben können, solltest du sie deshalb selbst entfernen, wie im Beispiel oben.
InputStreamReader: Text aus einem beliebigen InputStream
FileReader liest nur Dateien. Kommt der Text aus einer anderen Quelle – einer Ressource im Classpath, einem Netzwerk-Socket, einer komprimierten Datei –, liefert dir die jeweilige API einen InputStream. Den wandelt ein InputStreamReader in Zeichen um.
Der InputStreamReader hat vier Konstruktoren:
| Konstruktor | Seit | Zeichenkodierung |
|---|---|---|
InputStreamReader(InputStream in) | Java 1.1 | Standard der JVM |
InputStreamReader(InputStream in, String charsetName) | Java 1.1 | Name der Kodierung |
InputStreamReader(InputStream in, Charset cs) | Java 1.4 | cs |
InputStreamReader(InputStream in, CharsetDecoder dec) | Java 1.4 | Decoder mit eigener Fehlerbehandlung |
Den Konstruktor mit CharsetDecoder hat der Abschnitt Eine Exception statt Ersatzzeichen gezeigt. Das folgende Beispiel liest mit dem Konstruktor mit Charset eine Textdatei, die im Classpath neben der Klasse liegt:
InputStream in = Ch4InputStreamReader.class.getResourceAsStream("greeting.txt");
try (InputStreamReader reader = new InputStreamReader(in, UTF_8)) {
  System.out.print(reader.readAllAsString());
}
Grüße aus dem ClasspathDie Kodierung solltest du beim InputStreamReader immer angeben. Welche Kodierung die Bytes haben, hängt von ihrer Quelle ab – an den Bytes selbst lässt sie sich nicht ablesen.
Am besten übergibst du sie als Charset-Objekt, z. B. eine Konstante aus StandardCharsets. Der Konstruktor mit dem Namen als String prüft den Namen erst zur Laufzeit und wirft bei einem unbekannten Namen die Checked Exception UnsupportedEncodingException:
try {
  new InputStreamReader(InputStream.nullInputStream(), "UTF-9");
} catch (UnsupportedEncodingException e) {
  System.out.println(e);
}
java.io.UnsupportedEncodingException: UTF-9Bei zwei häufigen Quellen kennt das JDK die passende Kodierung bereits:
- Ausgabe eines Prozesses: Seit Java 17 liefert
Process.inputReader()einen fertigenBufferedReaderfür die Standardausgabe des Prozesses, mit der Kodierung des Betriebssystems aus der Systemeigenschaftnative.encoding. - Konsole: Für
System.inlegst du einenInputStreamReadermit der Kodierung aus der Systemeigenschaftstdin.encodingan – wie das geht, zeigt der Abschnitt BufferedReader um System.in im Artikel über denBufferedReader.
FileReader und BufferedReader
Meist steht der FileReader nicht allein, sondern verpackt in einem BufferedReader:
try (BufferedReader reader =
    new BufferedReader(new FileReader("files/server.log", UTF_8))) {
  String line;
  while ((line = reader.readLine()) != null) {
    System.out.println(line);
  }
}
2026-10-17 08:15:02 INFO Server started on port 8080
2026-10-17 08:15:07 INFO GET /java/java-bufferedreader/ 200
2026-10-17 08:15:09 WARN GET /java/bufferedreader/ 404
2026-10-17 08:15:11 INFO GET /java/java-streams/ 200
2026-10-17 08:15:12 ERROR Connection reset by peerWozu, wenn der FileReader die Datei schon in Blöcken von 8.192 Bytes liest? Der BufferedReader bringt zwei Vorteile:
readLine(): Nur derBufferedReaderkann Zeile für Zeile lesen.- Schnelles
read(): Einread()auf demFileReaderdekodiert bei jedem Aufruf höchstens zweichars – genug für ein Surrogatpaar – und betritt dabei einensynchronized-Block. DerBufferedReaderlässt denFileReaderdagegen bis zu 8.192 Zeichen auf einmal dekodieren und bedient die folgendenread()-Aufrufe aus seinem eigenen Puffer.
Liest du selbst in Blöcken mit read(char[]), bringt der BufferedReader keinen Vorteil. Ist dein Array mindestens so groß wie sein Puffer – standardmäßig 8.192 Zeichen –, reicht er den Aufruf sogar direkt an den FileReader weiter, ohne die Zeichen durch seinen Puffer zu kopieren.
Die folgende Tabelle vergleicht den FileReader mit dem BufferedReader um einen FileReader und den beiden Methoden aus der Klasse Files. Die beiden Methoden aus Files erwarten einen Path, die beiden anderen Wege einen Dateinamen oder ein File-Objekt:
| Seit | readLine() | Ungültige Bytes | |
|---|---|---|---|
new FileReader(file) | Java 1.1 | ✗ | Ersatzzeichen |
new BufferedReader(new FileReader(file)) | Java 1.1 | ✓ | Ersatzzeichen |
Files.newBufferedReader(path) | Java 7 | ✓ | Exception |
Files.readString(path) | Java 11 | ✗ (liefert alles auf einmal) | Exception |
Wie der BufferedReader puffert, welche Methoden er hat und wie schnell sie sind, zeigt der Artikel über den BufferedReader.
FileReader vs. FileInputStream
Ein FileInputStream liest Bytes, ein FileReader liest Zeichen. Den FileReader brauchst du für Text, den FileInputStream für alles andere – Bilder, Archive, Class-Dateien, serialisierte Objekte.
Liest du eine Binärdatei mit einem FileReader, verändert er die Daten. Das zeigt das folgende Programm: Es schreibt alle 256 möglichen Byte-Werte in eine Datei, liest sie einmal mit einem FileReader für UTF-8 und einmal mit einem FileInputStream:
byte[] allBytes = new byte[256];
for (int i = 0; i < allBytes.length; i++) {
  allBytes[i] = (byte) i;
}
Path binary = Path.of("target/all-bytes.bin");
Files.write(binary, allBytes);

try (FileReader reader = new FileReader(binary.toFile(), UTF_8)) {
  String text = reader.readAllAsString();
  long replaced = text.chars().filter(c -> c == 0xFFFD).count();
  System.out.println(text.length() + " characters, " + replaced + " of them U+FFFD");
  System.out.println("Back to bytes: " + text.getBytes(UTF_8).length + " bytes");
}

try (FileInputStream in = new FileInputStream(binary.toFile())) {
  byte[] bytes = in.readAllBytes();
  boolean identical = Arrays.equals(bytes, allBytes);
  System.out.println(bytes.length + " bytes, identical: " + identical);
}
256 characters, 128 of them U+FFFD
Back to bytes: 512 bytes
256 bytes, identical: trueDie Bytes 0 bis 127 sind in UTF-8 gültige Zeichen und kommen unverändert an. Die Bytes 128 bis 255 sind in UTF-8 nie ein Zeichen für sich, sondern höchstens Teil einer Folge mehrerer Bytes. In der Binärdatei stehen sie einzeln, und der FileReader ersetzt jedes durch U+FFFD. Welches Byte dort stand, lässt sich danach nicht mehr feststellen. Zurück in Bytes umgewandelt, belegt jedes Ersatzzeichen drei Bytes, daher die 512 (= 128 + 384) Bytes.
Der FileInputStream liefert dagegen alle 256 Bytes unverändert.
Wie du mit FileInputStream und BufferedInputStream große Dateien liest, zeigt der Abschnitt Lesen großer Binärdateien mit FileInputStream im Artikel über das Lesen von Dateien.
Wie schnell ist der FileReader?
Wie schnell der FileReader zeichenweise und blockweise liest und was ein BufferedReader daran ändert, habe ich für den Artikel über den BufferedReader mit dem Java Microbenchmark Harness (JMH) gemessen, dem Microbenchmark-Werkzeug des OpenJDK-Projekts. Jede Methode liest eine Textdatei von 100.000.000 Bytes vollständig. Die Datei ist UTF-8-kodiert und hat 1.222.747 Zeilen mit 0 bis 160 Zeichen, im Mittel 80, und im Mittel ist jedes hundertste Zeichen ein Umlaut.
Das folgende Diagramm stammt aus diesem Artikel und zeigt, wie lange jede Methode für die ganze Datei braucht, in Millisekunden. Grau sind InputStreamReader.read() und FileReader.read() ohne BufferedReader sowie Scanner.nextLine(), blau die Methoden des BufferedReader.
Alle BufferedReader-Methoden laufen auf einem new BufferedReader(new FileReader(…)), außer in der Zeile „Files.newBufferedReader() + readLine()“:
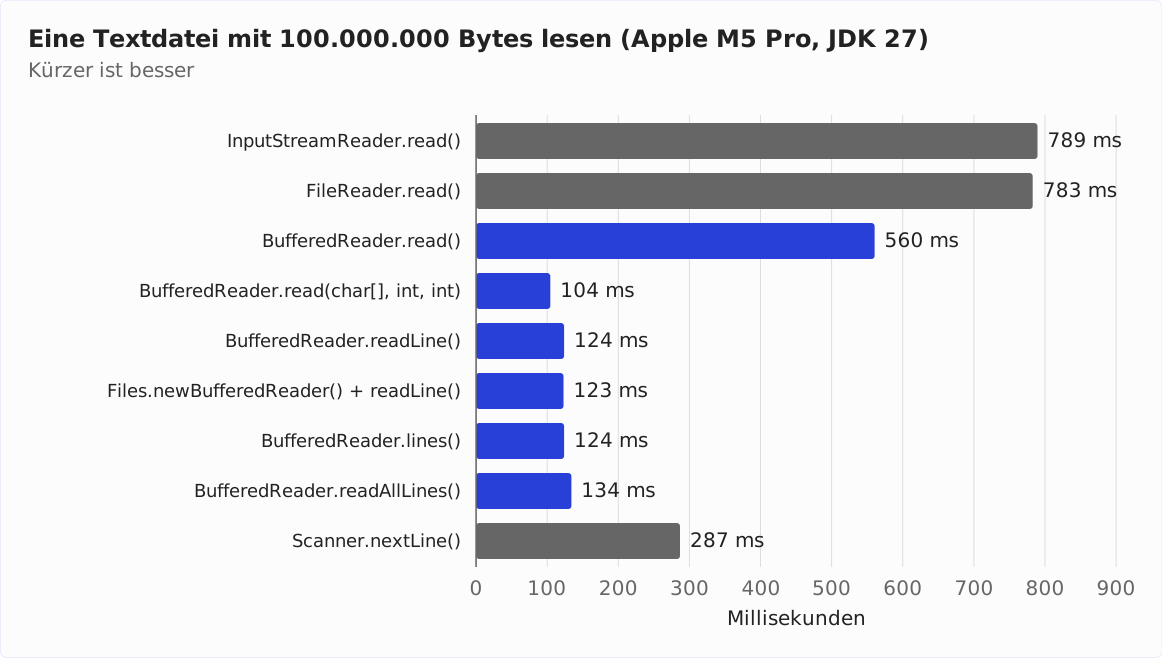
Zeichenweise braucht FileReader.read() 783 ms. InputStreamReader.read() liegt mit 789 ms gleichauf – der FileReader ist ja ein InputStreamReader.
Mit einem BufferedReader dazwischen braucht read() 560 ms, der FileReader allein ist also 40 % langsamer. Der Unterschied ist das Dekodieren von höchstens zwei Zeichen pro Aufruf, das der Abschnitt FileReader und BufferedReader beschreibt.
Der größere Hebel ist die Zahl der Aufrufe. Zeichenweise sind es 99.024.162 read()-Aufrufe, einer pro Zeichen der Datei. Die Zeile „BufferedReader.read(char[], int, int)“ liest dieselben Zeichen mit einem Array von 8.192 Zeichen in 12.088 Aufrufen und braucht dafür 104 ms. Weil das Array so groß ist wie der Puffer des BufferedReader, reicht dieser jeden Aufruf direkt an den FileReader weiter. Die 104 ms sind also die Zeit, die der FileReader blockweise braucht, plus ein Methodenaufruf des BufferedReader je Block.
Blockweise ist der FileReader damit mehr als siebenmal so schnell wie zeichenweise. Zeilenweise liest der BufferedReader mit readLine() in 124 ms; er sucht dabei das Zeilenende und legt für jede Zeile einen String an.
Daraus folgt: Mit dem FileReader solltest du nie Zeichen für Zeichen lesen, sondern in Blöcken, z. B. von 8.192 Zeichen – oder einen BufferedReader um ihn legen.
Einen FileReader schließen
Ein FileReader hält über seinen FileInputStream eine Datei offen. close() schließt den StreamDecoder und dieser den FileInputStream – und damit die Datei. Den FileReader solltest du deshalb immer schließen, am besten mit Try-with-resources.
Danach lässt er sich nicht mehr verwenden. Jeder Lesezugriff nach dem Schließen wirft eine IOException:
FileReader closed = new FileReader("files/server.log");
closed.close();
try {
  closed.read();
} catch (IOException e) {
  System.out.println(e);
}
java.io.IOException: Stream closedWas passiert, wenn du einen FileReader nicht schließt? Dann bleibt die Datei offen, bis der Garbage Collector den FileInputStream einsammelt. Erst dann schließt die JVM die Datei.
Das zeigt das folgende Programm. Es öffnet 100 FileReader, liest aus jedem ein Zeichen und schließt keinen davon. Vorher, danach und nach einer Garbage Collection gibt es aus, wie viele Dateien der Prozess geöffnet hat:
// works on Linux and macOS; Windows has no UnixOperatingSystemMXBean
UnixOperatingSystemMXBean os =
    (UnixOperatingSystemMXBean) ManagementFactory.getOperatingSystemMXBean();
System.out.println("Open files at the start:   " + os.getOpenFileDescriptorCount());
for (int i = 0; i < 100; i++) {
  FileReader reader = new FileReader("files/server.log");
  reader.read();
}
System.out.println("After 100 FileReaders:     " + os.getOpenFileDescriptorCount());
System.gc();
Thread.sleep(100);
System.out.println("After a garbage collection: " + os.getOpenFileDescriptorCount());
Open files at the start: 4
After 100 FileReaders: 104
After a garbage collection: 4Nach der Schleife sind 100 Dateien mehr geöffnet, obwohl das Programm keinen der FileReader mehr erreichen kann. Erst nach System.gc() sind sie wieder geschlossen. Wann der Garbage Collector in einem echten Programm läuft, bestimmt die JVM, nicht dein Code. Bis dahin können die offenen Dateien das Limit des Betriebssystems erreichen, und jeder weitere Versuch, eine Datei zu öffnen, scheitert mit einer FileNotFoundException mit dem Grund Too many open files.
Legst du einen BufferedReader um den FileReader, reicht es, den BufferedReader zu schließen – er schließt den FileReader mit.
Häufige Fehler
Die Abschnitte oben zeigen jeden der folgenden Fehler im Detail:
- Der Code muss auf Java 17 oder älter laufen und gibt keine Kodierung an. Dann liest er dieselbe Datei je nach Betriebssystem und Locale verschieden.
- Das Ergebnis von
read()wird als Zeichen behandelt. Ein Emoji liefertread()in zwei Hälften eines Surrogatpaars. - Nach
read(char[])wird das ganze Array verarbeitet. Gültig sind nur die erstenlengthZeichen, dahinter steht ggf. der Rest des vorigen Blocks. - Eine falsche Kodierung soll eine Exception auslösen. Der
FileReaderliefert stattdessen Ersatzzeichen. - Die erste Zeile einer CSV-Datei passt nicht zum erwarteten Text. Vorn steht eine Byte Order Mark.
- Eine Binärdatei wird mit einem
FileReadergelesen. Bytes mit einem Wert ab 128, die keine gültige UTF-8-Folge bilden, sind danach verloren. - Der
FileReaderwird nicht geschlossen. Die Datei bleibt offen, bis der Garbage Collector läuft.
Zusammenfassung
Ein FileReader ist ein InputStreamReader um einen FileInputStream. Die Klasse besteht nur aus Konstruktoren. Der InputStreamReader liest die Datei in Blöcken von 8.192 Bytes und dekodiert sie mit der angegebenen Zeichenkodierung, ohne Angabe seit Java 18 mit UTF-8.
read() liefert eine UTF-16-Codeeinheit, kein vollständiges Unicode-Zeichen, read(char[]) liefert die Zahl der gelesenen Zeichen. Seit Java 25 liest readAllAsString() den Rest der Datei auf einmal, und transferTo() überträgt ihn seit Java 10 in einen Writer. readLine(), mark() und reset() hat erst der BufferedReader.
Ungültige Bytes ersetzt der FileReader durch U+FFFD, ohne Fehlermeldung. Der Reader aus Files.newBufferedReader() und die Methode Files.readString() melden sie dagegen mit einer MalformedInputException.
Zeichenweise braucht der FileReader für eine Datei von 100.000.000 Bytes 783 ms, blockweise mit 8.192 Zeichen rund 104 ms.
Meine Empfehlungen:
- Lies Textdateien in neuem Code mit
Files.newBufferedReader()oderFiles.readString()statt mit demFileReader. Eine falsche Kodierung fällt dann als Exception auf. - Verwende den
FileReader, wenn du ungültige Bytes bewusst als U+FFFD weiterverarbeiten willst, oder wenn eine API einFile-Objekt oder einenReadererwartet. - Gib die Kodierung an, wenn dein Code auch auf Java 17 oder älter läuft oder die Datei nicht UTF-8 ist.
- Lies nie Zeichen für Zeichen direkt vom
FileReader. Lies in Blöcken oder lege einenBufferedReaderum ihn. - Lies Binärdateien mit einem
FileInputStream, nie mit einemFileReader. - Schließe jeden
FileReadermit Try-with-resources.
Wie du Dateien in einem Schritt in einen String, eine Liste oder ein Byte-Array liest, zeigt der Artikel über das Lesen von Dateien aus derselben Serie. Wie du Text in eine Datei schreibst, zeigt der Artikel über den FileWriter, und wie du ihn Zeile für Zeile mit println() und printf() schreibst, der Artikel über den PrintWriter.
Wenn dir der Artikel weitergeholfen hat, würde ich mich sehr über eine positive Bewertung auf meinem ProvenExpert-Profil freuen. Dein Feedback hilft mir, meine Inhalte weiter zu verbessern und motiviert mich, neue informative Artikel zu schreiben.