Ein FileWriter schreibt Text in eine Datei. Er kodiert die Zeichen mit einer Zeichenkodierung zu Bytes – seit Java 18 standardmäßig mit UTF-8 – und schreibt diese Bytes in die Datei.
Das folgende Programm schreibt zwei Log-Zeilen in die Datei target/server.log und gibt anschließend ihren Inhalt aus:
try (FileWriter writer = new FileWriter("target/server.log")) {
  writer.write("2026-10-17 08:15:02 INFO  Server started on port 8080\n");
  writer.write("2026-10-17 08:15:12 ERROR Connection reset by peer\n");
}

System.out.print(Files.readString(Path.of("target/server.log")));
2026-10-17 08:15:02 INFO Server started on port 8080
2026-10-17 08:15:12 ERROR Connection reset by peerDen FileWriter gibt es seit Java 1.1. Er selbst hat keine einzige eigene Methode: Alles, was er kann, erbt er vom OutputStreamWriter. Eine Methode, die ein Zeilenende schreibt, hat er nicht: Das schreibst du entweder selbst als \n in den Text, oder du legst einen BufferedWriter um den FileWriter und rufst dessen Methode newLine() auf. Um Zahlen und formatierten Text zu schreiben, musst du einen PrintWriter um den FileWriter legen – am besten mit einem BufferedWriter dazwischen.
In diesem Artikel erfährst du,
- was im
FileWritersteckt und wie er mitFileOutputStreamundOutputStreamWriterzusammenhängt, - wie du einen
FileWritererzeugst, Text an eine bestehende Datei anhängst und die Zeichenkodierung festlegst, - wie du einzelne Zeichen, Strings und
char-Arrays schreibst und wann die Bytes in der Datei ankommen, - warum der
FileWriterZeichen, die es in der Kodierung nicht gibt, stillschweigend durch ein Fragezeichen ersetzt und wie du stattdessen eine Exception bekommst, - wie du mit einem
OutputStreamWriterText in einen beliebigenOutputStreamschreibst, - wann du einen
BufferedWriterbrauchst und wannFileOutputStreamdie richtige Klasse ist, - wie schnell der
FileWriterschreibt, - warum du den
FileWriterimmer schließen musst.
Die Beispiele in diesem Artikel
Die meisten Beispiele schreiben Log-Zeilen in die Datei target/server.log. Fast alle Zeilen stammen aus der Log-Datei, die die Beispiele im Artikel über den FileReader lesen.
Den vollständigen Code findest du im GitHub-Repository java-file-io, im Package eu.happycoders.filewriter. Jeder Abschnitt hat dort eine eigene Klasse mit einer main()-Methode, die die gezeigten Ausgaben erzeugt. Starte die Klassen im Hauptverzeichnis des Repositorys; Dateien, die von den Beispielen geschrieben werden, landen im Verzeichnis target/.
Die Klassen im Repository brauchen Java 25, weil sie die vereinfachte main()-Methode ohne String[] args verwenden. Die Listings im Artikel laufen ab Java 17. Seit wann es einen bestimmten Konstruktor oder eine Methode gibt, steht jeweils im Text.
Was ist ein FileWriter?
FileWriter ist eine Unterklasse von OutputStreamWriter, und die ist wiederum eine Unterklasse von Writer, der abstrakten Basisklasse aller Klassen, die Zeichen schreiben.
Die Klasse FileWriter besteht nur aus neun Konstruktoren. Jeder öffnet die Datei mit einem FileOutputStream und übergibt diesen an den Konstruktor der Elternklasse OutputStreamWriter. So sieht beispielsweise der Konstruktor mit Dateiname und Zeichenkodierung aus:
public FileWriter(String fileName, Charset charset) throws IOException {
  super(new FileOutputStream(fileName), charset);
}
Ein new FileWriter(fileName, charset) ist also dasselbe wie ein new OutputStreamWriter(new FileOutputStream(fileName), charset) – nur kürzer geschrieben.
Die folgende Grafik zeigt, wie die Klassen zum Schreiben von Dateien zusammenhängen. Der gestrichelte Rahmen ist der FileWriter: Er umfasst den OutputStreamWriter und den FileOutputStream. Unter dem Rahmen stehen der BufferedOutputStream, der Bytes puffert, und der BufferedWriter, der Zeichen puffert.
Die gestrichelten Pfeile stehen für Textdaten, also Zeichen; die durchgezogenen Pfeile stehen für Binärdaten, also Bytes:
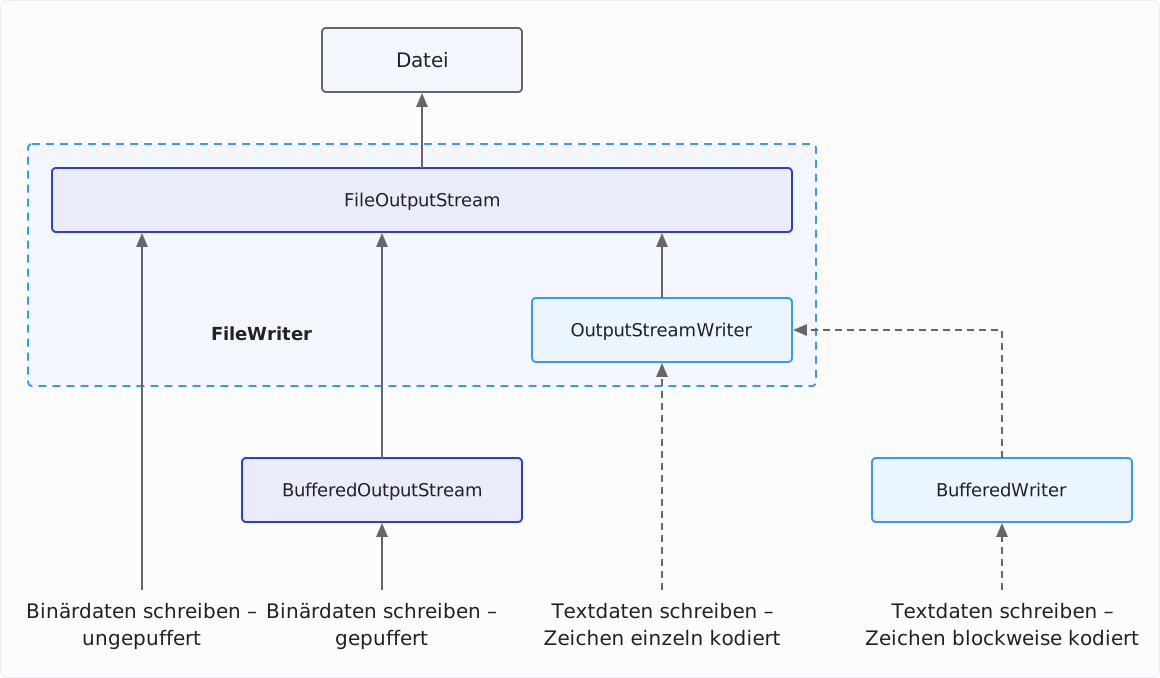
Der OutputStreamWriter wandelt die Zeichen in Bytes um – das nennt man Kodieren. Das übernimmt allerdings nicht er selbst, sondern ein StreamEncoder aus dem JDK-internen Package sun.nio.cs, an den der OutputStreamWriter jeden Methodenaufruf weiterreicht.
Der StreamEncoder lässt einen CharsetEncoder der gewählten Zeichenkodierung die Zeichen in Bytes umwandeln und sammelt diese Bytes in einem Puffer. Erst wenn der Puffer voll ist, schreibt er ihn in den FileOutputStream und damit in die Datei. Wie groß dieser Puffer ist und wann die Bytes in der Datei ankommen, zeigt der Abschnitt Wann die Bytes in der Datei ankommen: flush().
Einen FileWriter erzeugen
Die neun FileWriter-Konstruktoren unterscheiden sich in drei Punkten: wie du die Datei angibst, ob du eine Zeichenkodierung übergibst und ob du mit dem Parameter append Text an die Datei anhängen kannst.
| Konstruktor | Seit | Zeichenkodierung | Parameterappend |
|---|---|---|---|
FileWriter(String) | Java 1.1 | Standard der JVM | ✗ |
FileWriter(String, boolean) | Java 1.1 | Standard der JVM | ✓ |
FileWriter(File) | Java 1.1 | Standard der JVM | ✗ |
FileWriter(File, boolean) | Java 1.4 | Standard der JVM | ✓ |
FileWriter(FileDescriptor) | Java 1.1 | Standard der JVM | ✗ |
FileWriter(String, Charset) | Java 11 | übergebenes Charset | ✗ |
FileWriter(String, Charset, boolean) | Java 11 | übergebenes Charset | ✓ |
FileWriter(File, Charset) | Java 11 | übergebenes Charset | ✗ |
FileWriter(File, Charset, boolean) | Java 11 | übergebenes Charset | ✓ |
Dateiname, File und Path
Die Datei übergibst du als Dateinamen oder als File-Objekt. Einen Konstruktor für einen Path aus der NIO.2-API gibt es nicht; einen Path wandelst du mit toFile() in ein File-Objekt um:
Path path = Path.of("target/from-path.txt");
try (FileWriter fromName = new FileWriter("target/from-name.txt");
    FileWriter fromFile = new FileWriter(new File("target/from-file.txt"));
    FileWriter fromPath = new FileWriter(path.toFile())) {
  // jeder der drei öffnet seine eigene Datei
}
Ein FileDescriptor verweist auf eine Datei, die schon geöffnet ist, z. B. über FileDescriptor.out auf die Standardausgabe. Für das Schreiben in Dateien brauchst du ihn nicht.
An eine Datei anhängen
Ohne den Parameter append überschreibt der FileWriter eine bestehende Datei – und zwar schon im Konstruktor. Er leert die Datei, bevor du das erste Zeichen schreibst, auch wenn du nie eines schreibst.
Das zeigt das folgende Programm. Es schreibt eine Zeile in target/server.log, hängt mit append = true eine zweite Zeile an und erzeugt danach einen FileWriter ohne append, den es sofort wieder schließt. Nach jedem Schritt gibt es die Größe der Datei aus:
Path log = Path.of("target/server.log");
Files.writeString(log, "2026-10-17 08:15:02 INFO  Server started on port 8080\n");
System.out.println("At the start:           " + Files.size(log) + " bytes");

try (FileWriter writer = new FileWriter(log.toFile(), true)) {
  writer.write("2026-10-17 08:15:12 ERROR Connection reset by peer\n");
}
System.out.println("After append = true:    " + Files.size(log) + " bytes");

new FileWriter(log.toFile()).close();
System.out.println("After new FileWriter(): " + Files.size(log) + " bytes");
At the start: 54 bytes
After append = true: 105 bytes
After new FileWriter(): 0 bytesDer FileWriter mit append = true hängt seine Zeile an, die Datei wächst von 54 auf 105 Bytes. Der FileWriter ohne append schreibt kein einziges Zeichen und hinterlässt trotzdem eine leere Datei.
Den Parameter append haben vier der neun Konstruktoren; die beiden Konstruktoren, die zusätzlich ein Charset nehmen, gibt es seit Java 11.
Existiert die Datei noch nicht, legt der FileWriter sie auch mit append = true an:
Path missing = Path.of("target/appended.log");
Files.deleteIfExists(missing);
try (FileWriter writer = new FileWriter(missing.toFile(), true)) {
  writer.write("first line\n");
}
System.out.println(
    "Exists: " + Files.exists(missing) + ", " + Files.size(missing) + " bytes");
Exists: true, 11 bytesFiles.newBufferedWriter() dagegen legt die Datei mit der Option APPEND allein nicht an, sondern wirft eine NoSuchFileException. Dort musst du zusätzlich die Option CREATE angeben – wie das geht, zeigt der Artikel über den PrintWriter im Abschnitt An eine Datei anhängen.
Die Zeichenkodierung festlegen
Die Konstruktoren mit Charset-Parameter gibt es seit Java 11. Ohne diesen Parameter verwendet der FileWriter die Standard-Kodierung der JVM, Charset.defaultCharset().
Seit Java 18 ist diese Standard-Kodierung immer UTF-8 (JEP 400). Bis einschließlich Java 17 hing sie vom Betriebssystem und der Locale ab: Auf einem deutschen Windows war sie meist Windows-1252, auf Linux und macOS meist UTF-8. Derselbe Code schrieb ein „ü“ also je nach Rechner als andere Bytes: in Windows-1252 als ein Byte, in UTF-8 als zwei. Die Details stehen im Artikel über das Schreiben von Dateien, im Abschnitt Welche Zeichenkodierung verwendet Java standardmäßig zum Schreiben von Textdateien?
Welche Kodierung ein FileWriter verwendet, liefert dir die Methode getEncoding(). Das folgende Beispiel gibt sie für einen FileWriter ohne Kodierung, für einen mit ISO-8859-1 und für einen geschlossenen FileWriter aus:
try (FileWriter writer = new FileWriter("target/encoding.txt")) {
  System.out.println("Without charset: " + writer.getEncoding());
}
try (FileWriter writer = new FileWriter("target/encoding.txt", ISO_8859_1)) {
  System.out.println("ISO_8859_1:      " + writer.getEncoding());
}

FileWriter closed = new FileWriter("target/encoding.txt", UTF_8);
closed.close();
System.out.println("After close():   " + closed.getEncoding());
Without charset: UTF8
ISO_8859_1: ISO8859_1
After close(): nullgetEncoding() liefert nicht den Namen, unter dem du die Kodierung angegeben hast, sondern ihren sogenannten historischen Namen, also den Namen, den Java aus Kompatibilität mit den Versionen vor der Klasse Charset (Java 1.4) definiert – UTF8 statt UTF-8, ISO8859_1 statt ISO-8859-1. Nach close() liefert die Methode null.
Ich empfehle, die Kodierung immer dann anzugeben, wenn dein Code auch auf Java 17 oder älter laufen muss oder die Datei nicht in UTF-8 entstehen soll. Läuft dein Code nur auf Java 18 oder neuer und schreibt UTF-8, ändert ein UTF_8 im Konstruktor nichts am Ergebnis.
Wenn sich die Datei nicht anlegen lässt
Der Konstruktor öffnet oder erzeugt die Datei sofort. Fehlt das Verzeichnis, in dem sie liegen soll, ist sie selbst ein Verzeichnis oder darf das Programm sie nicht schreiben, wirft er eine FileNotFoundException.
Das folgende Programm legt zuerst eine schreibgeschützte Datei an. Dann versucht es nacheinander, in eine Datei in einem fehlenden Verzeichnis, in das Verzeichnis target und in die schreibgeschützte Datei zu schreiben:
File readOnly = new File("target/read-only.txt");
readOnly.createNewFile();
readOnly.setReadOnly();

for (String fileName :
    new String[] {"target/missing-dir/out.txt", "target", "target/read-only.txt"}) {
  try (FileWriter writer = new FileWriter(fileName, UTF_8)) {
    writer.write("x");
  } catch (IOException e) {
    System.out.println(e);
  }
}
java.io.FileNotFoundException: target/missing-dir/out.txt (No such file or directory)
java.io.FileNotFoundException: target (Is a directory)
java.io.FileNotFoundException: target/read-only.txt (Permission denied)Den Grund in Klammern liefert das Betriebssystem, die Ausgabe oben stammt von macOS.
Ein fehlendes Verzeichnis legt der FileWriter nicht an. Das musst du vorher mit Files.createDirectories() erledigen.
Alle Konstruktoren außer dem mit FileDescriptor deklarieren übrigens eine IOException. Geworfen wird in allen drei Fällen ihre Unterklasse FileNotFoundException.
Schreiben mit dem FileWriter
Alle Schreibmethoden des FileWriter stammen aus Writer und OutputStreamWriter. Mit ihnen schreibst du einzelne Zeichen, Strings und char-Arrays.
Zeichenweise schreiben: write(int)
write(int) schreibt ein einzelnes Zeichen. Der Parameter ist ein int, doch der FileWriter verwendet davon nur die unteren 16 Bits als char – die oberen 16 Bits ignoriert er.
In zwei Fällen bekommst du dadurch ein anderes Ergebnis, als du vielleicht erwartest. Der erste: Willst du mit write(200) die Zahl 200 schreiben, bekommst du stattdessen das Zeichen mit dem Code 200, ein „È“:
try (FileWriter writer = new FileWriter("target/status.txt")) {
  writer.write(200);
}
System.out.println(Files.readString(Path.of("target/status.txt")));ÈEine Zahl als Text kannst du mit write(String.valueOf(200)) schreiben – oder mit print() eines PrintWriter.
Der zweite Fall betrifft Zeichen außerhalb der sogenannten Basic Multilingual Plane, z. B. viele Emojis. Ihr Code Point liegt über 65.535 und passt nicht in 16 Bits. Übergibst du einen solchen Code Point an write(int), schreibt der FileWriter nur dessen untere 16 Bits.
Das folgende Programm schreibt so die Rakete U+1F680 in eine Datei, liest das erste Zeichen der Datei wieder ein und gibt seinen Hexadezimalwert und seinen Unicode-Namen aus:
Path codePoint = Path.of("target/code-point.txt");
try (FileWriter writer = new FileWriter(codePoint.toFile())) {
  writer.write("🚀".codePointAt(0)); // 0x1F680
}
char c = Files.readString(codePoint).charAt(0);
System.out.println(Integer.toHexString(c) + " " + Character.getName(c));
f680 PRIVATE USE AREA F680Aus der Rakete U+1F680 ist U+F680 geworden, ein Code Point aus dem Bereich für private Nutzung, dem Unicode kein Zeichen zuordnet.
Ein Zeichen außerhalb der Basic Multilingual Plane belegt in Java zwei chars, ein sogenanntes Surrogatpaar. Diese beiden Hälften musst du mit zwei write(int)-Aufrufen schreiben (oder mit write(String) – dazu gleich mehr):
Path rocket = Path.of("target/rocket.txt");
try (FileWriter writer = new FileWriter(rocket.toFile())) {
  writer.write(0xD83D);
  writer.write(0xDE80);
}
System.out.println(Files.readString(rocket) + " " + Files.size(rocket) + " bytes");
🚀 4 bytesDer StreamEncoder – das JDK-interne Objekt, das für den FileWriter die Zeichen in Bytes kodiert – hält die erste Hälfte nach dem ersten Aufruf zurück und kodiert sie erst zusammen mit der zweiten. Das ergibt die vier Bytes, die die Rakete in UTF-8 belegt.
Einfacher ist es, das Emoji als String zu schreiben: write("🚀") schreibt beide Hälften in einem Aufruf. Die Methode write(String) stellt der nächste Abschnitt vor.
Strings und Arrays schreiben: write(String), write(char[]) und append()
Neben write(int) hat der FileWriter die folgenden Schreibmethoden:
write(String)schreibt einen String,write(String, int, int)einen Teil eines Strings – ab einer Position, mit einer Länge.write(char[])schreibt einchar-Array,write(char[], int, int)einen Teil eineschar-Arrays.append(CharSequence)undappend(char)schreiben wiewrite(), geben aber denFileWriterzurück. So kannst du mehrere Aufrufe verketten. Dieappend()-Methoden gibt es seit Java 5.
Das folgende Programm setzt mit diesen Methoden eine Zeile aus HTTP-Methode, Pfad, Statuscode und Referrer zusammen. Der Referrer ist in diesem Beispiel null:
String path = "/java/java-filewriter/";
int code = 200;
String referrer = null;
try (FileWriter writer = new FileWriter("target/request.log")) {
  writer.write("GET ");
  writer.write(path);
  writer.append(' ').append(String.valueOf(code));
  writer.append(" referrer=").append(referrer).append('\n');
}
System.out.print(Files.readString(Path.of("target/request.log")));
GET /java/java-filewriter/ 200 referrer=nullBeachte das Ende der Zeile: append() schreibt für null die vier Zeichen „null“.
write() dagegen wirft für null eine NullPointerException:
try (FileWriter writer = new FileWriter("target/request.log")) {
  String nothing = null;
  writer.write(nothing);
} catch (NullPointerException e) {
  System.out.println(e);
}
java.lang.NullPointerException: Cannot invoke "String.length()" because "str" is nullWann die Bytes in der Datei ankommen: flush()
Was du mit write() schreibst, steht danach noch nicht in der Datei. Der StreamEncoder sammelt die kodierten Bytes in seinem Puffer und schreibt sie erst in die Datei, wenn der Puffer voll ist, wenn du flush() aufrufst oder wenn du den FileWriter schließt.
Das folgende Programm schreibt eine Zeile und gibt die Größe der Datei danach und nach einem flush() aus:
Path log = Path.of("target/server.log");
try (FileWriter writer = new FileWriter(log.toFile())) {
  writer.write("2026-10-17 08:15:02 INFO  Server started on port 8080\n");
  System.out.println("After write(): " + Files.size(log) + " bytes");
  writer.flush();
  System.out.println("After flush(): " + Files.size(log) + " bytes");
}
After write(): 0 bytes
After flush(): 54 bytesNach dem write() ist die Datei noch leer. Erst flush() schreibt die 54 Bytes der Zeile hinein.
Wie groß ist der Puffer? Seit Java 19 legt der StreamEncoder ihn initial mit nur 512 Bytes an. Er vergrößert den Puffer nur, wenn ein einzelner write()-Aufruf mehr Zeichen übergibt, als kodiert sicher in den Puffer passen – höchstens auf 8.192 Bytes. In UTF-8 belegt ein char bis zu drei Bytes. Der Puffer wächst also ab 171 Zeichen pro Aufruf (170 Zeichen belegen bis zu 510 Bytes, 171 Zeichen bis zu 513 Bytes, also mehr als 512). Bis einschließlich Java 18 war er immer 8.192 Bytes groß.
Das zeigt das folgende Programm. Es schreibt dieselbe Zeile mit 54 Bytes 20-mal und gibt jedes Mal, wenn die Datei gewachsen ist, ihre Größe aus. Danach schreibt es mit einem einzigen Aufruf 10.000 Zeichen in eine leere Datei:
Path log = Path.of("target/server.log");
String line = "2026-10-17 08:15:02 INFO  Server started on port 8080\n";
try (FileWriter writer = new FileWriter(log.toFile())) {
  long lastSize = 0;
  for (int i = 1; i <= 20; i++) {
    writer.write(line);
    long size = Files.size(log);
    if (size != lastSize) {
      System.out.println("After line " + i + ": " + size + " bytes in the file");
      lastSize = size;
    }
  }
}

try (FileWriter writer = new FileWriter(log.toFile())) {
  writer.write("x".repeat(10_000));
  long size = Files.size(log);
  System.out.println("After 10,000 characters: " + size + " bytes in the file");
}
After line 10: 512 bytes in the file
After line 19: 1024 bytes in the file
After 10,000 characters: 8192 bytes in the fileNach neun Zeilen liegen 486 Bytes im Puffer. Die zehnte Zeile passt nicht mehr ganz hinein: Der StreamEncoder schreibt die vollen 512 Bytes in die Datei und kodiert den Rest der Zeile in den geleerten Puffer. Nach der 19. Zeile – insgesamt 1.026 Bytes – ist der Puffer ein zweites Mal voll.
Der eine Aufruf mit 10.000 Zeichen dagegen lässt den Puffer auf 8.192 Bytes wachsen. Danach stehen 8.192 Bytes in der Datei, die übrigen 1.808 Bytes liegen noch im Puffer, bis close() sie schreibt.
Bei vielen kurzen Aufrufen mit maximal 170 Zeichen schreibt der FileWriter die Datei also in Blöcken von 512 Bytes.
flush() brauchst du, wenn ein anderes Programm die Datei liest, während dein Programm noch schreibt – z. B. bei einer Log-Datei, die jemand mit tail -f mitliest. Liegen Bytes im Puffer, ist jeder flush()-Aufruf ein eigener Schreibzugriff auf die Datei. In der Messung im Abschnitt Wie schnell ist der FileWriter? dauert das Schreiben über einen BufferedWriter mit einem flush() nach jeder Zeile 17-mal so lange wie ohne flush(). Liest niemand mit, solltest du deshalb nicht nach jeder Zeile flush() aufrufen. close() schreibt den Puffer ohnehin in die Datei, bevor es sie schließt.
Was der FileWriter nicht kann: newLine(), println() und printf()
Eine Methode, die ein Zeilenende schreibt, hat FileWriter nicht. Das Zeilenende schreibst du selbst, als "\n" oder als System.lineSeparator(), das Zeilenende des Betriebssystems: \r\n auf Windows, \n auf Linux und macOS. newLine() gibt es nur im BufferedWriter, println() nur im PrintWriter.
Auch Zahlen, Booleans und andere Objekte schreibt der FileWriter nicht als Text, und formatieren kann er nicht. Dafür kannst du einen PrintWriter um den FileWriter legen – am besten mit einem BufferedWriter dazwischen, wie der Artikel über den PrintWriter im Abschnitt new PrintWriter(Writer): ohne eigenen Puffer zeigt.
Nicht kodierbare Zeichen: Fragezeichen oder Exception
Ein FileWriter meldet keinen Fehler, wenn ein Zeichen in der gewählten Kodierung nicht existiert. Er ersetzt es stillschweigend durch ein Ersatzzeichen, bei UTF-8 und ISO-8859-1 durch ein Fragezeichen.
Der FileWriter ersetzt nicht kodierbare Zeichen
Die Kodierung ISO-8859-1 hat kein Euro-Zeichen. Das folgende Programm schreibt „Preis: 5 €“ trotzdem mit einem FileWriter für ISO-8859-1 und liest die Datei anschließend wieder ein:
Path price = Path.of("target/price.txt");
try (FileWriter writer = new FileWriter(price.toFile(), ISO_8859_1)) {
  writer.write("Preis: 5 €");
}
System.out.println(Files.readString(price, ISO_8859_1));
Preis: 5 ?Aus dem Euro-Zeichen ist ein Fragezeichen geworden, und das Programm läuft ohne Exception weiter.
Woher kommt das? Der StreamEncoder erzeugt den CharsetEncoder für einen OutputStreamWriter – und damit für jeden FileWriter – mit der Fehlerbehandlung REPLACE:
cs.newEncoder()
    .onMalformedInput(CodingErrorAction.REPLACE)
    .onUnmappableCharacter(CodingErrorAction.REPLACE)
onUnmappableCharacter() legt fest, was bei einem Zeichen passiert, das es in der Zielkodierung nicht gibt, wie beim Euro-Zeichen in ISO-8859-1. onMalformedInput() legt fest, was bei einer ungültigen Zeichenfolge passiert; beim Schreiben ist das eine einzelne Hälfte eines Surrogatpaars, wie der Abschnitt Ein halbes Emoji wird zum Fragezeichen zeigt. REPLACE heißt in beiden Fällen: Ersatzzeichen schreiben und weitermachen.
Eine Exception statt Fragezeichen
Ein CharsetEncoder, den du selbst mit newEncoder() erzeugst, hat dagegen die Fehlerbehandlung REPORT. Einen solchen Encoder kannst du dem OutputStreamWriter im Konstruktor übergeben. Der OutputStreamWriter meldet ein nicht kodierbares Zeichen dann mit einer UnmappableCharacterException. Beim FileWriter geht das nicht, denn keiner seiner Konstruktoren nimmt einen CharsetEncoder.
Das folgende Programm schreibt „Preis: 5 €“ mit einem OutputStreamWriter um einen FileOutputStream und einem Encoder mit REPORT. Die beiden on…()-Aufrufe sind nicht nötig, da REPORT schon der Standard ist; sie stehen hier, damit sichtbar ist, was der Encoder tut. Zuletzt gibt das Programm aus, was in der Datei steht:
CharsetEncoder encoder =
    ISO_8859_1
        .newEncoder()
        .onMalformedInput(CodingErrorAction.REPORT)
        .onUnmappableCharacter(CodingErrorAction.REPORT);
Path reported = Path.of("target/price-reported.txt");
try (OutputStreamWriter writer =
    new OutputStreamWriter(new FileOutputStream(reported.toFile()), encoder)) {
  writer.write("Preis: 5 €");
} catch (IOException e) {
  System.out.println(e);
}
String content = Files.readString(reported, ISO_8859_1);
System.out.println("In the file: \"" + content + "\"");
java.nio.charset.UnmappableCharacterException: Input length = 1
In the file: "Preis: 5 "UnmappableCharacterException ist eine Unterklasse von IOException. „Input length = 1“ bedeutet: Ein einzelnes Zeichen ließ sich nicht kodieren.
In der Datei steht danach der Text bis vor das Euro-Zeichen. Der StreamEncoder hatte „Preis: 5 “ schon in seinen Puffer kodiert, als er auf das Euro-Zeichen stieß, und das automatische close() am Ende des Try-Blocks hat diesen Puffer in die Datei geschrieben. Nach einer solchen Exception solltest du die Datei deshalb löschen oder neu schreiben, statt sie weiterzuverwenden.
Mit einer Exception melden ein solches Zeichen übrigens auch Files.newBufferedWriter() und Files.writeString(). Files.newBufferedWriter() erzeugt dafür genau so einen Encoder; die Methode besteht im JDK aus drei Zeilen:
CharsetEncoder encoder = cs.newEncoder();
Writer writer = new OutputStreamWriter(newOutputStream(path, options), encoder);
return new BufferedWriter(writer);
Das folgende Programm schreibt „Preis: 5 €“ mit beiden Methoden als ISO-8859-1:
Path reported = Path.of("target/price-reported.txt");
try (BufferedWriter writer = Files.newBufferedWriter(reported, ISO_8859_1)) {
  writer.write("Preis: 5 €");
} catch (IOException e) {
  System.out.println(e);
}

try {
  Files.writeString(reported, "Preis: 5 €", ISO_8859_1);
} catch (IOException e) {
  System.out.println(e);
}
java.nio.charset.UnmappableCharacterException: Input length = 1
java.nio.charset.UnmappableCharacterException: Input length = 1Beide Methoden melden das Euro-Zeichen mit einer UnmappableCharacterException. Der FileWriter und der OutputStreamWriter mit einem Charset sind von diesen Wegen also die einzigen, die stillschweigend weiterschreiben.
Ich empfehle, Textdateien mit Files.newBufferedWriter() oder Files.writeString() zu schreiben. Ein Zeichen, das es in der Kodierung nicht gibt, fällt dann als Exception auf, statt als Fragezeichen in der Datei zu landen.
Ein halbes Emoji wird zum Fragezeichen
Auch mit UTF-8, das jedes Unicode-Zeichen kodieren kann, landet ein Fragezeichen in der Datei, wenn ein String mit der ersten Hälfte eines Surrogatpaars endet. Das passiert z. B., wenn du einen Text mit substring() auf eine Höchstlänge kürzt und die Grenze mitten in einem Emoji liegt.
Das folgende Programm kürzt „Start 🚀“ auf sieben chars – die sechs Zeichen von „Start “ und die erste Hälfte der Rakete – und schreibt das Ergebnis mit einem FileWriter für UTF-8. Dann gibt es den Inhalt der Datei und ihre Bytes als Hexadezimalwerte aus. Zuletzt versucht es, denselben String mit Files.writeString() zu schreiben:
String message = "Start 🚀";
String truncated = message.substring(0, 7);
Path half = Path.of("target/half-rocket.txt");
try (FileWriter writer = new FileWriter(half.toFile(), UTF_8)) {
  writer.write(truncated);
}
String hex = HexFormat.ofDelimiter(" ").formatHex(Files.readAllBytes(half));
System.out.println(Files.readString(half) + "  " + hex);

try {
  Files.writeString(half, truncated);
} catch (IOException e) {
  System.out.println(e);
}
Start ? 53 74 61 72 74 20 3f
java.nio.charset.UnmappableCharacterException: Input length = 1Der FileWriter hat die halbe Rakete durch das Byte 3f ersetzt, ein Fragezeichen. Nach dem write() hält der StreamEncoder die erste Hälfte zurück, denn die zweite könnte mit dem nächsten Aufruf noch kommen – das hat der Abschnitt Zeichenweise schreiben: write(int) gezeigt. Erst close() stellt fest, dass keine zweite Hälfte mehr folgt, und schreibt das Ersatzzeichen.
Files.writeString() dagegen wirft eine UnmappableCharacterException, bevor es die Datei öffnet.
OutputStreamWriter: Text in einen beliebigen OutputStream
FileWriter schreibt nur in Dateien. Soll der Text woanders hin – z. B. in eine komprimierte Datei, über einen Netzwerk-Socket oder in die Antwort eines HTTP-Servers –, liefert dir die jeweilige API einen OutputStream. Um diesen legst du einen OutputStreamWriter, der die Zeichen in Bytes umwandelt.
Der OutputStreamWriter hat vier Konstruktoren:
| Konstruktor | Seit | Zeichenkodierung |
|---|---|---|
OutputStreamWriter(OutputStream) | Java 1.1 | Standard der JVM |
OutputStreamWriter(OutputStream, String) | Java 1.1 | übergebener Name der Kodierung |
OutputStreamWriter(OutputStream, Charset) | Java 1.4 | übergebenes Charset |
OutputStreamWriter(OutputStream, CharsetEncoder) | Java 1.4 | übergebener Encoder mit eigener Fehlerbehandlung |
Den Konstruktor mit CharsetEncoder hat der Abschnitt Eine Exception statt Fragezeichen gezeigt. Das folgende Beispiel schreibt mit dem Konstruktor mit Charset 1.000 Log-Zeilen in eine mit GZIP komprimierte Datei. Anschließend gibt es die Größe der Datei aus, entpackt sie mit einem GZIPInputStream und gibt auch die Zahl der entpackten Bytes aus:
Path gzip = Path.of("target/server.log.gz");
OutputStream out = new GZIPOutputStream(Files.newOutputStream(gzip));
try (OutputStreamWriter writer = new OutputStreamWriter(out, UTF_8)) {
  for (int i = 0; i < 1000; i++) {
    writer.write("2026-10-17 08:15:07 INFO  GET /java/java-filewriter/ 200\n");
  }
}
System.out.println("Compressed: " + Files.size(gzip) + " bytes");

try (InputStream in = new GZIPInputStream(Files.newInputStream(gzip))) {
  System.out.println("Unpacked:   " + in.readAllBytes().length + " bytes");
}
Compressed: 262 bytes
Unpacked: 57000 bytesDie 1.000 gleichen Zeilen mit je 57 Bytes ergeben 57.000 Bytes, die GZIP auf 262 Bytes komprimiert. Mit dem OutputStreamWriter schließt der Try-Block auch den GZIPOutputStream, der dabei die Prüfsumme und die Länge der Daten ans Ende der Datei schreibt.
Die Kodierung solltest du beim OutputStreamWriter immer explizit angeben. Welche Kodierung die Bytes haben müssen, sollte der Empfänger bestimmen – das Protokoll, der Prozess, das Programm, das die Datei später liest –, nicht die JVM, die sie schreibt.
Am besten übergibst du sie als Charset-Objekt, z. B. eine Konstante aus StandardCharsets. Der Konstruktor mit dem Namen als String prüft den Namen erst zur Laufzeit und wirft bei einem unbekannten Namen die Checked Exception UnsupportedEncodingException:
try {
  new OutputStreamWriter(OutputStream.nullOutputStream(), "UTF-9");
} catch (UnsupportedEncodingException e) {
  System.out.println(e);
}
java.io.UnsupportedEncodingException: UTF-9Für die Standardeingabe eines Prozesses legt das JDK den OutputStreamWriter selbst an: Seit Java 17 liefert Process.outputWriter() einen fertigen BufferedWriter um einen OutputStreamWriter, mit der Kodierung des Betriebssystems aus der Systemeigenschaft native.encoding.
FileWriter, BufferedWriter und PrintWriter
Meist steht der FileWriter nicht allein, sondern hinter einem BufferedWriter:
try (BufferedWriter writer =
    new BufferedWriter(new FileWriter("target/server.log", UTF_8))) {
  writer.write("2026-10-17 08:15:02 INFO  Server started on port 8080");
  writer.newLine();
  writer.write("2026-10-17 08:15:12 ERROR Connection reset by peer");
  writer.newLine();
}
System.out.print(Files.readString(Path.of("target/server.log")));
2026-10-17 08:15:02 INFO Server started on port 8080
2026-10-17 08:15:12 ERROR Connection reset by peerWozu, wenn der FileWriter die kodierten Bytes schon puffert? Der BufferedWriter bringt zwei Vorteile:
newLine(): Anders als derFileWriterhat derBufferedWritereine Methode, die das Zeilenende des Betriebssystems schreibt.- Schnelles
write()mit wenigen Zeichen: Jederwrite()-Aufruf auf demFileWriterbetritt einensynchronized-Block und lässt denCharsetEncoderdie übergebenen Zeichen kodieren.write(int)legt dafür zusätzlich ein Array mit einem Element an,write(String)kopiert den String in ein neueschar-Array. DerBufferedWriterdagegen legt die Zeichen nur in seinem Zeichenpuffer von 8.192 Zeichen ab und übergibt demFileWritererst den vollen Puffer in einem Aufruf.
Schreibst du große Blöcke mit write(char[], int, int), bringt der BufferedWriter keinen Vorteil. Ist der Block mindestens so groß wie der Zeichenpuffer des BufferedWriter, reicht dieser den Aufruf sogar direkt an den FileWriter weiter, ohne die Zeichen durch seinen Zeichenpuffer zu kopieren.
Die folgende Tabelle vergleicht den FileWriter mit dem BufferedWriter um einen FileWriter und den beiden Methoden aus der Klasse Files. Die beiden Methoden aus Files erwarten einen Path, die beiden anderen Wege einen Dateinamen oder ein File-Objekt:
| Seit | newLine() | Nicht kodierbare Zeichen | |
|---|---|---|---|
new FileWriter(file) | Java 1.1 | ✗ | ? |
new BufferedWriter(new FileWriter(file)) | Java 1.1 | ✓ | ? |
Files.newBufferedWriter(path) | Java 8 | ✓ | Exception |
Files.writeString(path, text) | Java 11 | ✗ (schreibt alles auf einmal) | Exception |
Files.newBufferedWriter() gibt es seit Java 7, die gezeigte Variante ohne Charset-Parameter seit Java 8.
Wenn du Zahlen und Text mit println() und printf() schreiben möchtest, musst du einen PrintWriter um den BufferedWriter legen: new PrintWriter(Files.newBufferedWriter(path)). Wie die drei Klassen zusammenarbeiten, zeigt der Artikel über den PrintWriter im Abschnitt PrintWriter vs. FileWriter vs. BufferedWriter.
FileWriter vs. FileOutputStream
Ein FileOutputStream schreibt Bytes, ein FileWriter schreibt Zeichen. Den FileWriter brauchst du für Text, den FileOutputStream für alles andere – Bilder, Archive, serialisierte Objekte.
Schreibst du Binärdaten mit einem FileWriter, verändert er sie. Das zeigt das folgende Programm: Es schreibt alle 256 möglichen Byte-Werte einmal mit einem FileWriter für UTF-8 und einmal mit einem FileOutputStream in eine Datei, liest beide Dateien wieder ein und vergleicht sie mit den ursprünglichen Bytes:
byte[] allBytes = new byte[256];
for (int i = 0; i < allBytes.length; i++) {
  allBytes[i] = (byte) i;
}

Path viaWriter = Path.of("target/all-bytes-writer.bin");
try (FileWriter writer = new FileWriter(viaWriter.toFile(), UTF_8)) {
  for (byte b : allBytes) {
    writer.write(b & 0xFF); // 0 bis 255 statt -128 bis 127
  }
}
byte[] written = Files.readAllBytes(viaWriter);
boolean identical = Arrays.equals(written, allBytes);
System.out.println(
    "FileWriter:       " + written.length + " bytes, identical: " + identical);

Path viaStream = Path.of("target/all-bytes-stream.bin");
try (FileOutputStream out = new FileOutputStream(viaStream.toFile())) {
  out.write(allBytes);
}
written = Files.readAllBytes(viaStream);
identical = Arrays.equals(written, allBytes);
System.out.println(
    "FileOutputStream: " + written.length + " bytes, identical: " + identical);
FileWriter: 384 bytes, identical: false
FileOutputStream: 256 bytes, identical: trueDie Werte 0 bis 127 schreibt der FileWriter als je ein Byte, denn in UTF-8 sind das die ASCII-Zeichen. Die Werte 128 bis 255 dagegen schreibt er als die Zeichen U+0080 bis U+00FF, und die belegen in UTF-8 je zwei Bytes. So werden aus 256 Bytes 128 + 2 × 128 = 384 Bytes.
Der FileOutputStream schreibt dagegen alle 256 Bytes unverändert.
Wie du mit FileOutputStream und BufferedOutputStream Binärdateien schreibst, zeigt der Abschnitt Schreiben von Byte-Arrays mit dem FileOutputStream im Artikel über das Schreiben von Dateien.
Wie schnell ist der FileWriter?
Wie schnell der FileWriter schreibt und was ein BufferedWriter daran ändert, habe ich mit dem Java Microbenchmark Harness (JMH) gemessen. Für jede Variante schreibt das Testprogramm WriteBenchmark dieselben 1.222.747 Zeilen mit 0 bis 160 Zeichen in eine Datei – insgesamt 99.024.162 Zeichen, mit UTF-8 kodiert 100.000.000 Bytes. Es sind dieselben Zeilen, die die Messung im Artikel über den PrintWriter schreibt.
Das folgende Diagramm zeigt, wie lange jede Variante für die ganze Datei braucht, in Millisekunden. Grau sind die drei Varianten, die direkt in den FileWriter schreiben: Zeichen für Zeichen mit write(int), Zeile für Zeile mit write(String) und einem write('\n') und in Blöcken von 8.192 Zeichen mit write(char[], int, int). Blau sind die drei Varianten mit einem BufferedWriter um den FileWriter: Zeichen für Zeichen, Zeile für Zeile mit write(String) und newLine() und noch einmal Zeile für Zeile mit einem flush() nach jeder Zeile:
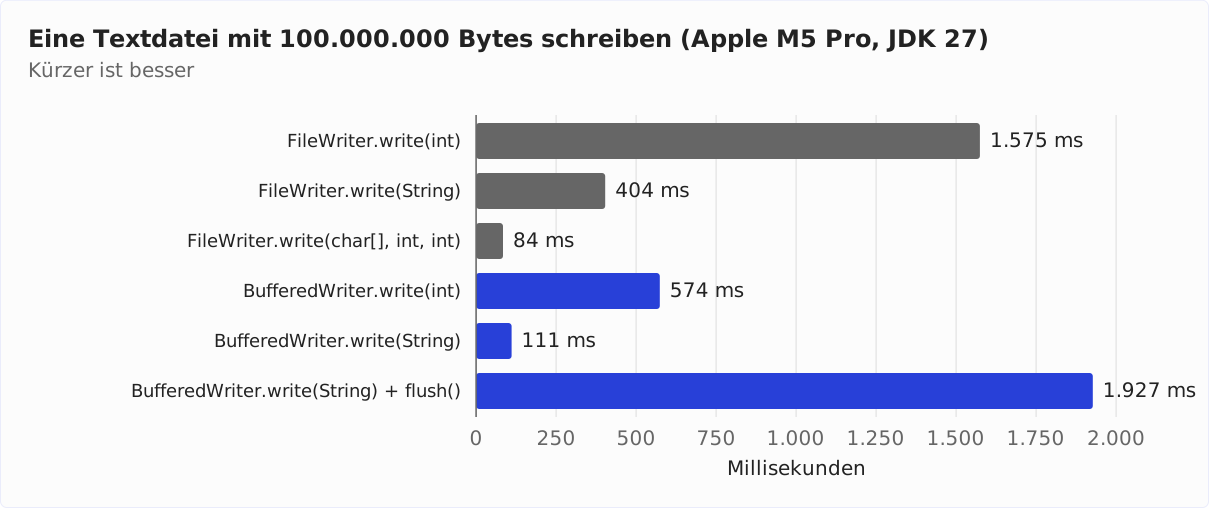
Zeichen für Zeichen braucht der FileWriter 1.575 ms, das sind 15,9 ns pro Zeichen. Mit einem BufferedWriter davor sind es 574 ms, also 5,8 ns pro Zeichen; ohne BufferedWriter ist der FileWriter damit 174 % langsamer. Der Unterschied ist die Arbeit pro Aufruf, die der Abschnitt FileWriter, BufferedWriter und PrintWriter beschreibt: Jedes write(int) auf dem FileWriter legt ein Array an, betritt einen synchronized-Block und kodiert ein einzelnes Zeichen. Der BufferedWriter legt das Zeichen dagegen nur in seinen Zeichenpuffer.
Zeile für Zeile braucht der FileWriter 404 ms, mit einem BufferedWriter davor 111 ms – ohne BufferedWriter ist er 264 % langsamer. Hier kommt der Puffer des StreamEncoder ins Spiel: Keine Zeile ist länger als 160 Zeichen, also bleibt der Puffer bei 512 Bytes, und der FileWriter schreibt die Datei in Blöcken von 512 statt 8.192 Bytes. Für dieselben Zeilen hat der Artikel über den PrintWriter gezählt, was das bedeutet: 195.317 statt 12.208 Schreibzugriffe auf die Datei. Eine Gegenprobe dort zeigt, dass diese zusätzlichen Zugriffe fast die ganze Differenz ausmachen.
Am schnellsten ist der FileWriter allein, wenn er große Blöcke bekommt: In Blöcken von 8.192 Zeichen braucht er 84 ms; Zeichen für Zeichen dauert es 18,7-mal so lange. Schon der erste Aufruf lässt den Puffer des StreamEncoder auf 8.192 Bytes wachsen, und so groß bleibt er. Außerdem gibt es keinen zweiten Puffer, durch den die Zeichen kopiert werden. Der BufferedWriter mit write(String) und newLine() ist mit 111 ms 32 % langsamer.
Mit einem flush() nach jeder Zeile braucht der BufferedWriter 1.927 ms, 17-mal so lange wie ohne. Jede Zeile wird so zu einem eigenen Schreibzugriff auf die Datei, insgesamt 1.222.747 statt 12.208 Schreibzugriffe; jeder der zusätzlichen Zugriffe kostet 1,5 µs.
Daraus folgt: Schreibst du mit einem FileWriter Zeichen für Zeichen oder Zeile für Zeile, solltest du immer einen BufferedWriter um ihn legen. Schreibst du in großen Blöcken, brauchst du keinen. Und flush() solltest du nur aufrufen, wenn jemand die Datei mitliest.
Einen FileWriter schließen
Ein FileWriter hält über seinen FileOutputStream eine Datei offen, und im Puffer seines StreamEncoder liegen die zuletzt kodierten Bytes. close() schreibt diese Bytes in die Datei und schließt dann den FileOutputStream – und damit die Datei. Den FileWriter musst du deshalb immer schließen, am besten mit Try-with-resources.
Was passiert, wenn du einen FileWriter nicht schließt? Dann fehlt am Ende der Datei, was noch im Puffer lag. Eine kurze Datei bleibt ganz leer.
Das zeigt das folgende Programm. Es schreibt eine Zeile, ohne den FileWriter zu schließen, und gibt die Größe der Datei danach und nach einer Garbage Collection aus:
Path log = Path.of("target/not-closed.log");
FileWriter writer = new FileWriter(log.toFile());
writer.write("2026-10-17 08:15:02 INFO  Server started on port 8080\n");
System.out.println("After write():              " + Files.size(log) + " bytes");

writer = null;
System.gc();
Thread.sleep(100);
System.out.println("After a garbage collection: " + Files.size(log) + " bytes");
After write(): 0 bytes
After a garbage collection: 0 bytesDie Datei bleibt leer. Geschlossen wird sie zwar, sobald der Garbage Collector den FileOutputStream eingesammelt hat – das zeigt der Artikel über den FileReader im Abschnitt Einen FileReader schließen. Den Puffer des StreamEncoder schreibt dabei aber niemand in die Datei: Die 54 Bytes der Zeile sind verloren. Dasselbe gilt, wenn das Programm endet, ohne den FileWriter zu schließen.
Nach close() lässt sich der FileWriter nicht mehr verwenden. Jeder Schreibzugriff nach dem Schließen wirft eine IOException:
FileWriter closed = new FileWriter("target/closed.log");
closed.close();
try {
  closed.write("too late");
} catch (IOException e) {
  System.out.println(e);
}
java.io.IOException: Stream closedLegst du einen BufferedWriter um den FileWriter, reicht es, den BufferedWriter zu schließen. Er schreibt seinen Puffer in den FileWriter und schließt diesen mit.
Häufige Fehler
Die Abschnitte oben zeigen jeden der folgenden Fehler im Detail:
- Der
FileWriterwird nicht geschlossen: Die letzten Bytes bleiben im Puffer, und eine kurze Datei bleibt leer. appendfehlt: Der Konstruktor leert die Datei, bevor das erste Zeichen geschrieben ist.- Der Code muss auf Java 17 oder älter laufen und gibt keine Kodierung an: Dann schreibt er dieselben Zeichen je nach Betriebssystem und Locale als verschiedene Bytes.
write(int)bekommt eine Zahl oder einen Code Point:write(200)schreibt ein „È“, und aus einer Rakete wird ein Zeichen aus dem Bereich für private Nutzung.- Ein Zeichen, das es in der Kodierung nicht gibt, soll eine Exception auslösen: Der
FileWriterschreibt stattdessen ein Fragezeichen. - Ein gekürzter String endet mit der ersten Hälfte eines Surrogatpaars: In der Datei steht dann ein Fragezeichen.
- Eine Binärdatei wird mit einem
FileWritergeschrieben: Aus jedem Byte mit einem Wert ab 128 werden zwei Bytes. - Text wird Zeichen für Zeichen direkt in den
FileWritergeschrieben: Mit einemBufferedWriterdavor geht es in der Messung 2,7-mal so schnell. flush()nach jeder Zeile, obwohl niemand mitliest: Jede Zeile wird ein eigener Schreibzugriff, und das Schreiben dauert 17-mal so lange wie ohneflush().- Das Verzeichnis der Datei fehlt: Der Konstruktor wirft eine
FileNotFoundException, statt das Verzeichnis anzulegen.
Zusammenfassung
Ein FileWriter ist ein OutputStreamWriter um einen FileOutputStream. Die Klasse besteht nur aus Konstruktoren. Der OutputStreamWriter kodiert die Zeichen mit der angegebenen Kodierung – ohne Angabe seit Java 18 mit UTF-8 – in einen Byte-Puffer, der initial 512 Bytes groß ist und bis auf 8.192 Bytes wächst.
Ohne append = true leert schon der Konstruktor die Datei. Was du schreibst, steht erst in der Datei, wenn der Puffer voll ist, nach flush() oder nach close().
Zeichen, die es in der Kodierung nicht gibt, und eine einzelne Hälfte eines Surrogatpaars ersetzt der FileWriter durch ein Fragezeichen, ohne Fehlermeldung. Der Writer aus Files.newBufferedWriter() und die Methode Files.writeString() melden sie dagegen mit einer Exception.
Für eine Textdatei mit 100.000.000 Bytes braucht der FileWriter Zeichen für Zeichen 1.575 ms, in Blöcken von 8.192 Zeichen 84 ms. Ein BufferedWriter davor bringt das zeichenweise Schreiben auf 574 ms und das zeilenweise von 404 auf 111 ms.
Meine Empfehlungen:
- Schreib Textdateien in neuem Code mit
Files.newBufferedWriter()oderFiles.writeString()statt mit demFileWriter. Ein Zeichen, das es in der Kodierung nicht gibt, fällt dann als Exception auf. Auch einFile-Objekt kannst du mitfile.toPath()anFiles.newBufferedWriter()übergeben. - Gib die Kodierung an, wenn dein Code auch auf Java 17 oder älter läuft oder die Datei nicht in UTF-8 entstehen soll.
- Setz
appendauftrue, wenn du an eine Datei anhängen willst. Ohneappendleert schon der Konstruktor die Datei. - Schreib nie Zeichen für Zeichen direkt in den
FileWriter. Schreib in größeren Blöcken oder leg einenBufferedWriterum ihn. - Schreib Binärdateien mit einem
FileOutputStream, nie mit einemFileWriter. - Schließ jeden
FileWritermit Try-with-resources.
Wie du einen String, eine Liste von Zeilen oder ein Byte-Array in einem Schritt in eine Datei schreibst, zeigt der Artikel über das Schreiben von Dateien aus derselben Serie. Wie du Text Zeile für Zeile mit println() und printf() schreibst, zeigt der Artikel über den PrintWriter, und wie du die Datei wieder einliest, der Artikel über den FileReader.
Hat dieser Artikel deine Fragen beantwortet? Dann freue ich mich über eine Bewertung auf meinem ProvenExpert-Profil – sie hilft anderen Entwickler:innen, diese Inhalte zu finden.