Seit Java 25 legt die JVM nicht nur geladene und gelinkte Klassen in den AOT-Cache, sondern auch die Methodenprofile aus dem Trainingslauf. JEP 515: Ahead-of-Time Method Profiling verspricht damit eine kürzere Aufwärmphase: Der JIT-Compiler muss die Profile nicht erst sammeln, sondern kann direkt nach dem Start mit ihnen arbeiten.
Für die ersten Runden trifft das zu: An einem Beispielprogramm, das in jeder Runde 50 Quelldateien kompiliert, brauchen die Runden 2 bis 5 unter Java 25 mit den Profilen 14 % weniger Zeit als ohne.
Auf Dauer wird das Programm mit den Profilen aber langsamer als ohne Cache – unter Java 28 nach 200 Runden um 5 %. Den Grund habe ich im Quellcode der JVM gefunden: Beim Schreiben des Caches verlieren die Profile ihre Einträge zu Lambda-Ausdrücken, und der C2-Compiler baut diese Lambdas danach nicht mehr in den aufrufenden Code ein.
In diesem Artikel erfährst du:
- Was ein Methodenprofil ist und was JEP 515 verspricht
- Wie du die Profile in den AOT-Cache bekommst – und wie du sie zum Vergleich abschaltest
- Wie viel die Profile am Beispiel aus dem JEP und an einem größeren Beispiel bringen
- Was die JVM mit den Profilen aus dem Cache macht und warum in Java 28 die erste Runde langsamer wird
- Warum der Code mit den Profilen auf Dauer langsamer ist – an einem kleinen Beispielprogramm und im Quellcode der JVM
- Wie lang der Trainingslauf sein sollte und ob das neue iterative Training in Java 28 hilft
Die Beispielprogramme, die Messskripte und alle Messergebnisse findest du im GitHub-Repository java-aot-cache.
Methodenprofile und Tiered Compilation
HotSpot führt Java-Code zunächst im Interpreter aus und kompiliert häufig aufgerufene Methoden in zwei Stufen: erst mit dem schnellen C1-Compiler, dann mit dem stark optimierenden C2-Compiler. Wie das im Einzelnen abläuft, beschreibe ich im Artikel Ahead-of-Time Code Compilation.
In diesem Artikel geht es vor allem um das Methodenprofil: Interpreter und C1-Code zählen, wie oft eine Methode aufgerufen wird, wie oft jede Schleife läuft, welche Zweige genommen werden und welche Klassen an einer Aufrufstelle tatsächlich vorkommen. Mit diesem Profil entscheidet der C2-Compiler dann, welche aufgerufenen Methoden er in den aufrufenden Code einbaut – das sogenannte Inlining.
Außerdem optimiert der C2-Compiler auf Verdacht: Kann ein Aufruf Methoden verschiedener Klassen treffen (Polymorphismus), ist laut Profil aber bisher nur eine Klasse vorgekommen, baut er deren Methode ein und prüft vorher nur noch die Klasse. Und einen Zweig, der laut Profil nie genommen wurde, kompiliert er gar nicht erst. Trifft eine solche Annahme später nicht mehr zu, verwirft die JVM den C2-Code und führt die Methode wieder im Interpreter aus – die sogenannte Deoptimierung.
Die Stufen, auf denen HotSpot eine Methode ausführt, sind nummeriert:
- Stufe 0: Interpreter, mit Profiling
- Stufe 1: C1-Code ohne Zähler und ohne Profiling
- Stufe 2: C1-Code, der nur Aufrufe und Schleifendurchläufe zählt
- Stufe 3: C1-Code mit vollem Profiling
- Stufe 4: C2-Code, ohne Profiling
Ohne Profile aus dem Cache durchläuft eine heiße Methode normalerweise die Stufen 0, 3 und 4. Stufe 1 bekommen Methoden, bei denen C2 nichts mehr herausholen würde – Getter, Methoden, die nur eine Konstante zurückgeben, und native Methoden –, sowie Methoden, die C2 nicht kompilieren kann. Die Stufe 2 spielt erst mit den Profilen aus dem Cache eine größere Rolle – dazu gleich mehr.
Was JEP 515 verspricht
Laut JEP sammelt der Trainingslauf die Methodenprofile, und die JVM legt sie im AOT-Cache ab. Im Produktionslauf liest sie die Profile wieder ein, sodass der JIT-Compiler heiße Methoden sofort kompilieren kann. Dafür muss weder der Code der Anwendung noch der von Libraries und Frameworks geändert werden. Wer AOT Class Loading & Linking bereits nutzt, braucht auch keinen neuen Workflow: Die Profile landen mit denselben Kommandos im Cache wie seit Java 25 die Klassen.
Die Profile aus dem Cache verhindern dabei nicht, dass die JVM im Produktionslauf weiter profiliert und optimiert.
Als Beispiel nennt der JEP das Programm HelloStreamWarmup, das 100.000-mal eine kurze Stream-Pipeline durchläuft. Mit einem AOT-Cache ohne Profile läuft es laut JEP in 90 Millisekunden, mit Profilen in 73 Millisekunden – 23 % schneller. Der Cache wird dabei um 250 KB größer, das sind etwa 2,5 %.
Neue Risiken sieht der JEP nicht. Er nennt nur eine Annahme: dass der Trainingslauf eine gute Quelle für Beobachtungen ist, die dem Produktionslauf nützen. Auf diese Annahme komme ich im Abschnitt Warum der Code auf Dauer langsamer wird zurück.
Profile in den AOT-Cache legen
Um die Methodenprofile in den AOT-Cache zu legen, brauchst du keinen eigenen Schritt. Seit Java 25 nimmt der Trainingslauf bei der AOT-Cache-Erzeugung mit -XX:AOTCacheOutput die Profile automatisch in den Cache auf:
java -XX:AOTCacheOutput=App.aot -cp App.jar App
java -XX:AOTCache=App.aot -cp App.jar App
Wie Trainingslauf und Cache-Erzeugung im Einzelnen funktionieren, zeige ich im Artikel Ahead-of-Time Class Loading & Linking.
Um zu messen, was die Profile bringen, brauchst du einen Vergleich mit demselben Cache, aber ohne die Profile. Den liefert die diagnostische Option -XX:-AOTReplayTraining: Mit ihr verwendet die JVM die geladenen und gelinkten Klassen aus dem Cache, liest die Profile aber nicht ein.
java -XX:+UnlockDiagnosticVMOptions -XX:-AOTReplayTraining \
     -XX:AOTCache=App.aot -cp App.jar App
In Java 28 schaltet diese Option auch den vorkompilierten Code aus dem Cache ab, der durch JEP 544 hinzugefügt wird – die JVM verwendet den AOT-Code nur zusammen mit den Profilen. Für meine Messungen habe ich die Java-28-Caches deshalb mit -XX:-AOTCodeCaching ohne AOT-Code erzeugt. Sie enthalten dann dieselben Bestandteile wie ein Cache aus Java 25: die geladenen und gelinkten Klassen, die vorinitialisierten Objekte und die Methodenprofile.
In den folgenden Tabellen heißen die drei Varianten:
- ohne Cache: das Programm ohne
-XX:AOTCache - ohne Profile: mit Cache, aber mit
-XX:-AOTReplayTraining - mit Profilen: mit demselben Cache, ohne weitere Option
Nachgemessen: das Beispiel aus dem JEP
Das Programm HelloStreamWarmup habe ich unverändert aus dem JEP übernommen; du findest es im Repository. Die Tabelle zeigt, wie lange der ganze java-Prozess läuft, in Millisekunden:
| ohne Cache | ohne Profile | mit Profilen | |
|---|---|---|---|
| Java 25 | 49,7 | 45,2 | 43,5 |
| Java 28 | 50,3 | 44,6 | 40,2 |
Mit Profilen braucht das Programm unter Java 25 3,8 % weniger Zeit als ohne Profile, unter Java 28 9,9 %. Die Richtung stimmt also, der Effekt ist auf meinem Rechner aber kleiner als im JEP, wo das Programm mit Profilen 19 % weniger Zeit braucht. Auf welcher Hardware die JEP-Autoren gemessen haben, steht im JEP nicht.
Ein größeres Beispiel: 100 Runden javac
HelloStreamWarmup läuft nur 40 bis 50 Millisekunden. Um die Aufwärmphase und die Zeit danach zu sehen, verwende ich das Programm AotCompile aus dem Artikel Ahead-of-Time Code Compilation. Es übersetzt in jeder Runde 50 generierte Quelldateien mit dem javac-Compiler im Speicher und gibt aus, wie lange die Runde gedauert hat. Den Cache habe ich mit einem Trainingslauf über 20 Runden erzeugt.
Die Tabelle zeigt, wie lange eine Runde unter Java 25 dauert, in Millisekunden. Für die Zeilen mit mehreren Runden ist es der Mittelwert pro Runde:
| Runden | ohne Cache | ohne Profile | mit Profilen |
|---|---|---|---|
| 1 | 501 | 399 | 372 |
| 2 bis 5 | 133,2 | 131,0 | 112,8 |
| 11 bis 20 | 67,3 | 67,4 | 61,9 |
| 21 bis 30 | 64,3 | 64,4 | 60,3 |
| 31 bis 40 | 59,8 | 59,9 | 61,0 |
| 81 bis 100 | 53,8 | 54,1 | 56,9 |
In der Aufwärmphase bringen die Profile, was der JEP verspricht: In den Runden 2 bis 5 dauert eine Runde ohne Profile 131,0 Millisekunden, mit Profilen 112,8 ms – mit Profilen braucht sie 13,9 % weniger Zeit. Auch in den Runden 11 bis 20 ist das Programm mit Profilen noch schneller.
Danach kippt das Bild allerdings. Gegenüber dem Programm ohne Cache braucht eine Runde mit Profilen:
- in den Runden 21 bis 30 noch 6,2 % weniger Zeit (ohne Cache 64,3 ms, mit Profilen 60,3 ms),
- in den Runden 31 bis 40 schon 2,0 % mehr Zeit (59,8 gegen 61,0 ms),
- in den Runden 81 bis 100 5,7 % mehr Zeit (53,8 gegen 56,9 ms).
Die folgende Grafik zeigt alle 100 Runden einzeln, als Median jeder Runde. Die blaue Linie ist die Variante ohne Cache, die rote die Variante ohne Profile und die gelbe die Variante mit Profilen. Damit die späten Runden zu unterscheiden sind, beginnt die y-Achse bei 40 Millisekunden und endet bei 160: Die ersten beiden Runden liegen deshalb größtenteils über dem oberen Rand.
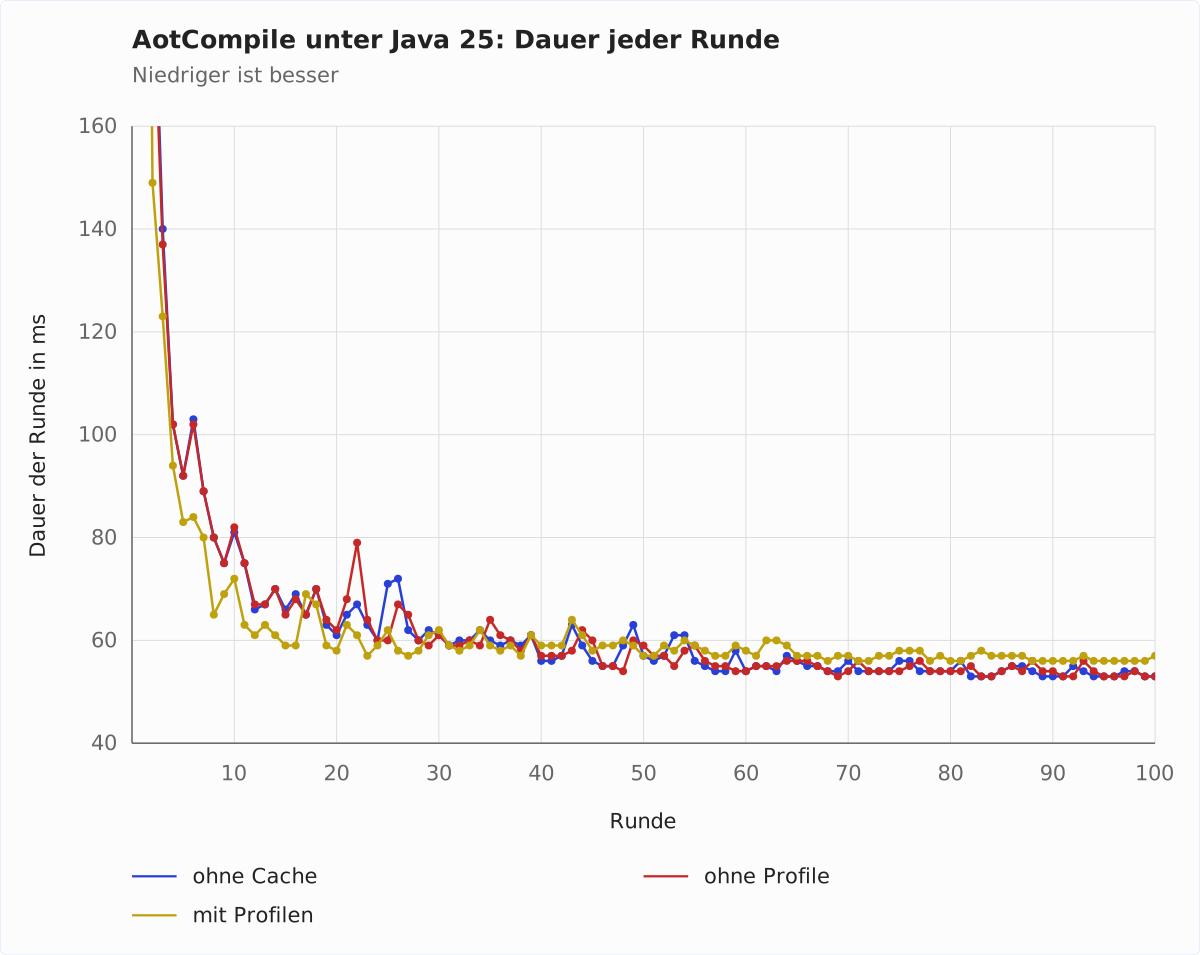
Die blaue und die rote Linie liegen ab Runde 2 fast übereinander: Ohne Profile bringen die geladenen und gelinkten Klassen nur in der ersten Runde einen Vorsprung. Die gelbe Linie liegt bis etwa Runde 30 unter der blauen und der roten – und danach darüber.
Was die JVM mit den Profilen macht
Woher kommt der Vorsprung in der Aufwärmphase, und woher der Rückstand danach? Ein Blick in den Quellcode von HotSpot zeigt vier Mechanismen, über die die Profile aus dem Cache die Kompilierung steuern:
- Das Profil aus dem Training wird das Profil der Methode. Legt HotSpot das Profil einer Methode an, setzt es das Profil aus dem Cache ein, statt ein leeres anzulegen. Alle Zähler stehen beim Start auf dem Stand vom Ende des Trainingslaufs.
- Methoden, die im Training durch C2 kompiliert wurden, überspringen das Profiling. Diese Methoden gehen von Stufe 0 über Stufe 2 direkt zu Stufe 4, ohne die profilierende Stufe 3. C2 kompiliert sie mit dem Profil aus dem Training.
- Lauwarme Methoden warten. Eine Methode, die im Training nur durch C1 kompiliert wurde, bleibt auf Stufe 2, bis sie im Produktionslauf öfter aufgerufen wurde als im ganzen Trainingslauf. Das gilt seit Java 26. Java 25 vergleicht noch nicht mit den Zählern aus dem Training. Es verzögert Methoden aus dem Training pauschal: Die Schwelle für den Wechsel von Stufe 0 multipliziert es mit 100, die für den Wechsel von Stufe 2 mit 250.
- Kompilieren auf Vorrat (Java 28). Wird eine Klasse initialisiert, gibt die JVM die Kompilierungen ihrer Methoden aus dem Training in Auftrag, bevor diese Methoden aufgerufen werden. Das hängt an der Option
AOTCompileEagerly. In Java 25 ist sie aus. Java 28 schaltet sie ein, wenn beim Öffnen des AOT-Caches die OptionAOTCodeCachinggesetzt ist. Die ist im Produktionslauf standardmäßig an – auch dann, wenn der Cache gar keinen AOT-Code enthält.
Die Mechanismen 1 und 2 erklären den Vorsprung in der Aufwärmphase: C2 kompiliert die heißen Methoden früh und mit einem fertigen Profil. Mechanismus 4 erklärt, warum unter Java 28 die erste Runde langsamer wird, Mechanismus 3, warum das Programm später noch einmal zurückfällt – frühestens, wenn der Produktionslauf so viele Runden hinter sich hat wie der Trainingslauf. Beides zeige ich in den nächsten beiden Abschnitten. Den dauerhaften Rückstand erklärt keiner der vier Mechanismen – dazu gleich mehr.
Java 28: eine langsamere erste Runde
Unter Java 28 dauert die erste Runde von AotCompile mit Profilen 490 Millisekunden, ohne Profile nur 417 Millisekunden – das sind 17,5 % mehr. In den Runden 2 bis 5 ist das Programm mit Profilen dagegen schneller: Eine Runde dauert ohne Profile 147,5 Millisekunden, mit Profilen 133,2 ms, also 9,7 % weniger. Unter Java 25 ist mit Profilen auch die erste Runde schneller, wie die Tabelle im Abschnitt Ein größeres Beispiel zeigt.
Der Grund ist das Kompilieren auf Vorrat: Die JVM gibt die Methoden aus dem Training schon beim Initialisieren ihrer Klasse zum Kompilieren in Auftrag, bevor das Programm sie aufruft. Das zeigt je ein Lauf mit der Option -XX:+LogCompilation, die jeden Kompilierauftrag mit Zeitpunkten protokolliert:
- In den ersten 0,25 Sekunden stellt die JVM mit gecachten Methodenprofilen 3.468 Aufträge für Stufe 2 in die Warteschlange. 3.073 davon sind Aufträge auf Vorrat, nur 395 gelten Methoden, die das Programm bereits aufgerufen hat. Diese 395 Aufträge warten im Median 562 Millisekunden, beim 90. Perzentil 614 Millisekunden.
- Ohne gecachte Profile stellt die JVM in derselben Zeit 2.161 Aufträge für Stufe 3 ein, alle für Methoden, die das Programm bereits aufgerufen hat. Mehr als die Hälfte davon kommt noch in derselben Millisekunde an die Reihe, in der sie eingestellt wurde; das Log hat Zeitstempel in ganzen Millisekunden, der Median der Wartezeit ist deshalb 0. Beim 90. Perzentil wartet ein Auftrag 1 Millisekunde.
- Auch bei C2 gibt es Aufträge auf Vorrat: Von den 370 C2-Aufträgen aus der Zeit von 0,25 bis 0,5 Sekunden sind mit gecachten Profilen 221 auf Vorrat. Die übrigen 149, für bereits aufgerufene Methoden, warten im Median 534 Millisekunden. Ohne gecachte Profile warten C2-Aufträge in dieser Zeit weniger als eine Millisekunde.
Die Methoden, die das Programm gerade braucht, stehen also in der Warteschlange hinter den Aufträgen, die die JVM auf Vorrat eingestellt hat – und bis sie drankommen, laufen sie im Interpreter.
Die vielen Kompilierungen bremsen das Programm dabei nicht über die CPU-Last: Das Programm selbst läuft in einem einzigen Thread, die übrigen der 18 Prozessorkerne meines Rechners sind für die 12 Compiler-Threads der JVM frei. Langsamer wird das Programm, weil die Methoden, die es gerade braucht, später kompiliert werden.
Den Zusammenhang belegt eine Gegenprobe mit umgeschalteter Option: -XX:+UnlockDiagnosticVMOptions -XX:-AOTCompileEagerly schaltet das Kompilieren auf Vorrat in Java 28 ab, wo es standardmäßig an ist, -XX:+UnlockExperimentalVMOptions -XX:+AOTCompileEagerly schaltet es in Java 25 ein, wo es standardmäßig aus ist. Die Tabelle zeigt die erste Runde und die Mittelwerte der Runden 2 bis 5 und 6 bis 10, in Millisekunden:
| ohne Profile | mit Profilen, ohne Kompilieren auf Vorrat | mit Profilen, mit Kompilieren auf Vorrat | |
|---|---|---|---|
| Java 28, Runde 1 | 417 | 405 (umgeschaltet) | 491 |
| Java 28, Runden 2 bis 5 | 144,8 | 128,8 (umgeschaltet) | 133,8 |
| Java 28, Runden 6 bis 10 | 86,4 | 85,6 (umgeschaltet) | 77,8 |
| Java 25, Runde 1 | 398 | 372 | 500 (umgeschaltet) |
| Java 25, Runden 2 bis 5 | 129,0 | 112,0 | 97,2 (umgeschaltet) |
| Java 25, Runden 6 bis 10 | 84,4 | 73,6 | 70,4 (umgeschaltet) |
Mit der umgeschalteten Option dreht sich in beiden Versionen um, ob die erste Runde mit Profilen kürzer oder länger dauert als ohne Profile:
- Unter Java 28 dauert die erste Runde mit Kompilieren auf Vorrat 491 Millisekunden, länger als ohne Profile (417 ms). Ohne Kompilieren auf Vorrat dauert sie 405 Millisekunden, kürzer als ohne Profile.
- Unter Java 25 dauert die erste Runde mit Kompilieren auf Vorrat 500 Millisekunden, länger als ohne Profile (398 ms). Ohne Kompilieren auf Vorrat dauert sie 372 Millisekunden, kürzer als ohne Profile.
Das Kompilieren auf Vorrat macht also die erste Runde langsamer und erst spätere Runden schneller: unter Java 25 schon die Runden 2 bis 5, unter Java 28 erst die Runden 6 bis 10. Die Runden 2 bis 5 dauern unter Java 28 mit Kompilieren auf Vorrat sogar länger als ohne.
Den Rückstand aus der ersten Runde holt das Kompilieren auf Vorrat in diesem Beispiel in keiner der beiden Versionen wieder auf. Aus den Werten der Tabelle gerechnet, brauchen die ersten fünf Runden zusammen:
- unter Java 25 mit Kompilieren auf Vorrat 889 Millisekunden, ohne 820 ms,
- unter Java 28 mit Kompilieren auf Vorrat 1.026 Millisekunden, ohne 920 ms.
Auch nach 20 Runden liegt die Variante mit Kompilieren auf Vorrat noch hinten: Die ersten 20 Runden dauern unter Java 25 mit Kompilieren auf Vorrat 1.858 Millisekunden, ohne 1.809 ms, unter Java 28 mit 2.062 ms, ohne 2.006 ms (Median der Summen je Lauf). Später ist das Kompilieren auf Vorrat auch pro Runde nicht mehr schneller: In den Runden 81 bis 100 dauert eine Runde mit Kompilieren auf Vorrat unter Java 25 58,2 statt 57,3 Millisekunden, unter Java 28 57,3 statt 56,8 ms.
Die Option AOTCompileEagerly ist in Java 28 diagnostisch und in Java 25 experimentell. Ich verwende sie hier als Messinstrument; für den Produktivbetrieb empfehle ich sie nicht.
Die nachgeholte Aufwärmphase
Lauwarme Methoden – also solche, die im Training nur durch C1 kompiliert wurden – bleiben unter Java 28 auf Stufe 2, bis der Produktionslauf ihre Aufrufzahl aus dem Training überschreitet. Danach holen sie ihre Aufwärmphase nach: Sie wechseln auf die profilierende Stufe 3 und werden anschließend mit frischen Profilen von C2 kompiliert.
Der Zeitpunkt dieser nachgeholten Aufwärmphase hängt also von der Länge des Trainingslaufs ab. Das zeigt die Zahl der Kompilierungen auf Stufe 3, gezählt mit -XX:+PrintCompilation:
- Nach 5 Runden Training sind es in den 5 anschließenden Runden mit Cache 926 Stufe-3-Kompilierungen, ohne Cache nur 349.
- Nach 20 Runden Training sind es in den 5 anschließenden Runden mit Cache 392 Stufe-3-Kompilierungen, ohne Cache nur 49.
- Nach 60 Runden Training sind es in den 10 anschließenden Runden mit Cache 148 Stufe-3-Kompilierungen, ohne Cache 66. Die meisten folgen hier aber erst in den Runden 81 bis 90: mit Cache 305, ohne Cache 62.
Dass sich die Kompilierungen so bündeln, liegt an der Schwelle für die Stufe-3-Kompilierungen: Unter Java 28 ist sie für jede lauwarme Methode ihre Aufrufzahl aus dem Training. Weil AotCompile in jeder Runde dieselben 50 Quelldateien übersetzt, erreichen viele lauwarme Methoden diese Schwelle in denselben wenigen Runden – frühestens, wenn der Produktionslauf so viele Runden hinter sich hat wie der Trainingslauf.
Unter Java 25 gibt es diese Welle von Stufe-3-Kompilierungen nicht: Mit dem Cache aus 20 Runden Training sind es dort in keinem der Rundenblöcke mehr als 86. Java 25 verzögert lauwarme Methoden nicht bis zu ihrer Aufrufzahl aus dem Training, sondern bis zu einem festen Vielfachen der üblichen Schwelle. Häufig aufgerufene Methoden erreichen diese Schwelle früh, selten aufgerufene spät – die Stufe-3-Kompilierungen verteilen sich deshalb über den ganzen Lauf.
In der Laufzeit zeigt sich die nachgeholte Aufwärmphase unter Java 28 als Stufe. Die folgende Grafik zeigt 200 Runden ohne Cache und mit dem Cache aus 100 Runden Training. Jeder Punkt ist der Mittelwert aus fünf Runden, jede Runde der Median aus 10 Läufen:
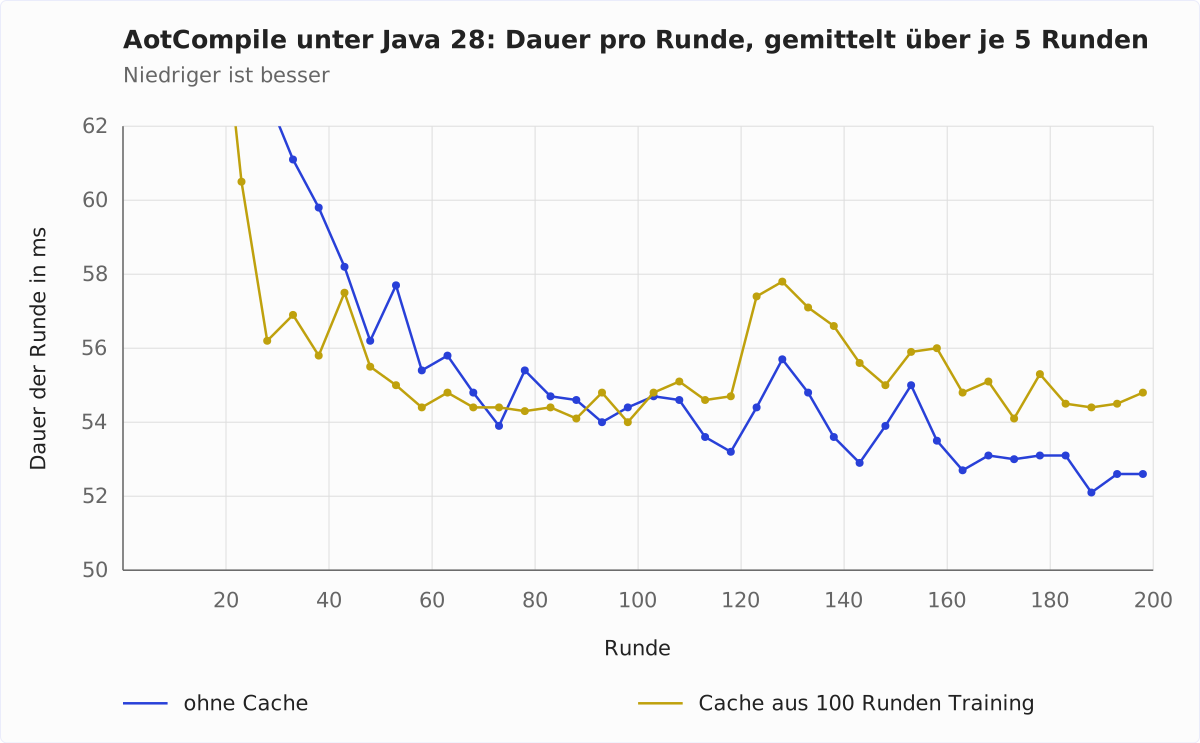
Bis etwa Runde 60 liegt die gelbe Linie unter der blauen, mit Cache ist das Programm dort schneller. Von Runde 60 bis Runde 120 liegen beide Linien etwa gleichauf; in den Runden 101 bis 120 dauert eine Runde mit Cache im Mittel 54,9 Millisekunden, ohne Cache 54,1 ms. Ab Runde 121 liegt die gelbe Linie dauerhaft über der blauen: in den Runden 121 bis 140 mit 57,5 gegen 54,7 Millisekunden, in den Runden 181 bis 200 noch mit 54,6 gegen 52,7 ms. Die Ausschläge, die beide Linien gemeinsam haben, etwa um Runde 125 und um Runde 155, kommen nicht vom Cache.
Unter Java 25 fehlt mit der Welle auch die Stufe. Die folgende Grafik zeigt dieselbe Messung unter Java 25, ebenfalls mit einem Cache aus 100 Runden Training:
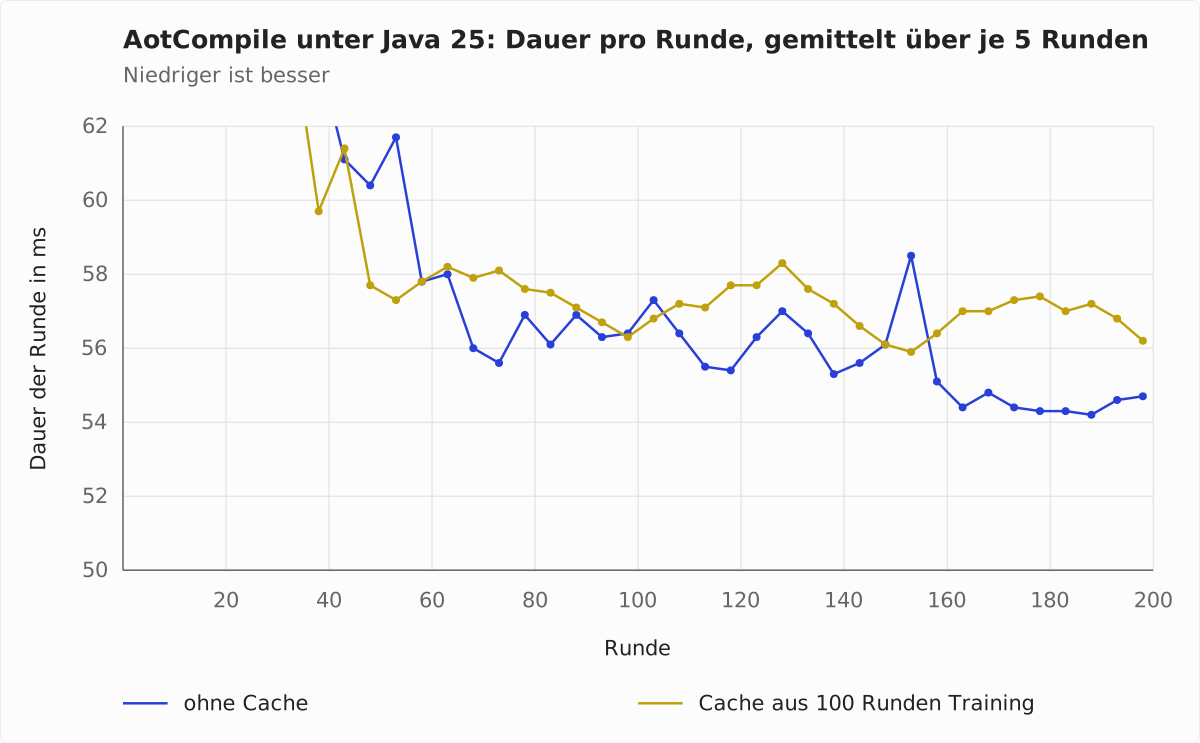
Die gelbe Linie liegt hier ab etwa Runde 60 fast durchgehend über der blauen, ohne Sprung bei Runde 121: In den Runden 61 bis 80 dauert eine Runde mit Cache im Mittel 58,0 Millisekunden, ohne Cache 56,7 ms, in den Runden 121 bis 140 dann 57,8 gegen 56,0 ms und in den Runden 181 bis 200 schließlich 57,0 gegen 54,6 ms. Langsamer wird das Programm mit Cache also auch unter Java 25 – nur setzt der Rückstand allmählich ein statt in einer Stufe. Warum das Programm mit Cache in beiden Versionen auf Dauer langsamer bleibt, zeigt der nächste Abschnitt.
Warum der Code auf Dauer langsamer wird
Bleibt die Frage, warum AotCompile – das Beispielprogramm, das in jeder Runde 50 Quelldateien mit javac übersetzt – mit den Profilen auf Dauer langsamer ist als ohne Cache.
Ab hier wird es sehr technisch – bis hinunter in den C++-Quellcode von HotSpot. Für die Praxis genügt eine Erkenntnis: Code, der Lambda-Ausdrücke aufruft, kann mit den Methodenprofilen aus dem AOT-Cache derzeit auf Dauer langsamer laufen als ohne Methodenprofile, unter Java 25 wie unter Java 28. Wenn dir das reicht, kannst du direkt zum Abschnitt Wie lang sollte der Trainingslauf sein? springen. Wenn du genau wissen willst, warum das so ist, bist du herzlich eingeladen, weiterzulesen.
Der Befund: auch nach 200 Runden langsamer
Hat der Produktionslauf nur noch nicht lange genug gedauert? Nein. Die Tabelle zeigt den Mittelwert der Runden 181 bis 200 unter Java 28, in Millisekunden, für Caches aus drei verschiedenen Trainingsläufen:
| Variante | Runden 181 bis 200 | gegenüber ohne Cache |
|---|---|---|
| ohne Cache | 52,7 | – |
| mit Cache aus 20 Runden, ohne Profile | 53,0 | +0,6 % |
| mit Cache und Profilen aus 20 Runden | 55,4 | +5,1 % |
| mit Cache und Profilen aus 60 Runden | 55,6 | +5,5 % |
| mit Cache und Profilen aus 100 Runden | 54,6 | +3,6 % |
Alle drei Caches mit Profilen bleiben langsamer. Mit 100 Runden Training liegt das Programm bis Runde 100 noch etwa gleichauf mit der Variante ohne Cache – in den Runden 81 bis 100 dauert eine Runde 54,4 statt 54,7 Millisekunden – und fällt erst mit der nachgeholten Aufwärmphase ab Runde 121 zurück. Ein längeres Training verschiebt also nur den Zeitpunkt, ab dem das Programm langsamer ist.
Ein kleines Beispiel: AotLambda
Bei AotCompile verteilt sich der Unterschied auf Hunderte von Aufrufstellen im Code von javac – dazu mehr im Abschnitt Zurück zu AotCompile. Deshalb habe ich den Effekt in einem kleinen Programm nachgebaut, das in einer Schleife einen Lambda-Ausdruck aufruft:
import java.util.function.IntUnaryOperator;

void main(String[] args) throws InterruptedException {
  int rounds = args.length > 0 ? Integer.parseInt(args[0]) : 10;
  int factor = 31;
  int offset = 7;
  IntUnaryOperator op = x -> (x * factor + offset) ^ (x >>> 3);

  Steps.init();
  Thread.sleep(500); // Zeit, um `Steps` vor dem ersten Aufruf zu kompilieren

  for (int i = 1; i <= rounds; i++) {
    long start = System.nanoTime();
    int sum = 0;
    for (int j = 0; j < 1_000; j++) {
      sum = Steps.run(op, sum);
    }
    long millis = (System.nanoTime() - start) / 1_000_000;
    IO.println("Iteration %2d: %4d ms (%d)".formatted(i, millis, sum));
  }
}

class Steps {
  static final int[] DATA = new int[100_000];

  static void init() {}

  static int run(IntUnaryOperator op, int sum) {
    int[] data = DATA;
    for (int i = 0; i < data.length; i++) {
      sum += step(op, data[i] + i);
    }
    return sum;
  }

  static int step(IntUnaryOperator op, int value) {
    return op.applyAsInt(value);
  }
}
Das Programm ruft in jeder Runde 1.000-mal Steps.run() auf. Diese Methode ruft für jedes der 100.000 Elemente des Arrays DATA über Steps.step() den Lambda-Ausdruck op auf. Der Lambda-Ausdruck verwendet die beiden lokalen Variablen factor und offset; dadurch wird seine Methode applyAsInt() 13 Bytes groß, und C2 baut sie nur ein, wenn er die Aufrufstelle für häufig genug hält.
Zwei Zeilen sind für den Effekt nötig: Steps.init() initialisiert die Klasse Steps, und die halbe Sekunde Pause gibt der JVM Zeit, Steps aus den Profilen des Trainings zu kompilieren, bevor Steps.run() zum ersten Mal läuft. Ohne die Pause führt der Interpreter Steps.run() und Steps.step() zuerst aus. Er zählt dabei im Profil aus dem Cache weiter und trägt die Lambda-Klasse samt ihren Aufrufen wieder ein, bevor C2 die Methode kompiliert – und der Effekt tritt nicht auf.
So kompilierst du das Programm, packst es in eine JAR-Datei und erzeugst den Cache mit einem Trainingslauf über fünf Runden:
javac -d classes AotLambda.java
jar cf AotLambda.jar -C classes .
java -XX:AOTCacheOutput=AotLambda.aot -cp AotLambda.jar AotLambda 5
Ohne Cache gibt das Programm unter Java 28 Folgendes aus:
java -cp AotLambda.jar AotLambda 10Iteration 1: 50 ms (-564873344)
Iteration 2: 27 ms (-564873344)
Iteration 3: 24 ms (-564873344)
Iteration 4: 23 ms (-564873344)
Iteration 5: 23 ms (-564873344)
Iteration 6: 23 ms (-564873344)
Iteration 7: 23 ms (-564873344)
Iteration 8: 23 ms (-564873344)
Iteration 9: 23 ms (-564873344)
Iteration 10: 23 ms (-564873344)Mit dem Cache sieht die Ausgabe so aus:
java -XX:AOTCache=AotLambda.aot -cp AotLambda.jar AotLambda 10Iteration 1: 128 ms (-564873344)
Iteration 2: 87 ms (-564873344)
Iteration 3: 87 ms (-564873344)
Iteration 4: 87 ms (-564873344)
Iteration 5: 87 ms (-564873344)
Iteration 6: 87 ms (-564873344)
Iteration 7: 87 ms (-564873344)
Iteration 8: 87 ms (-564873344)
Iteration 9: 87 ms (-564873344)
Iteration 10: 87 ms (-564873344)Mit dem Cache dauert jede Runde fast viermal so lange wie ohne Cache, und daran ändert sich auch nach zehn Runden nichts. Startest du das Programm mit demselben Cache und -XX:-AOTReplayTraining, also ohne die Profile, ist es so schnell wie ohne Cache: ab Runde 4 dauert jede Runde dann 23 Millisekunden.
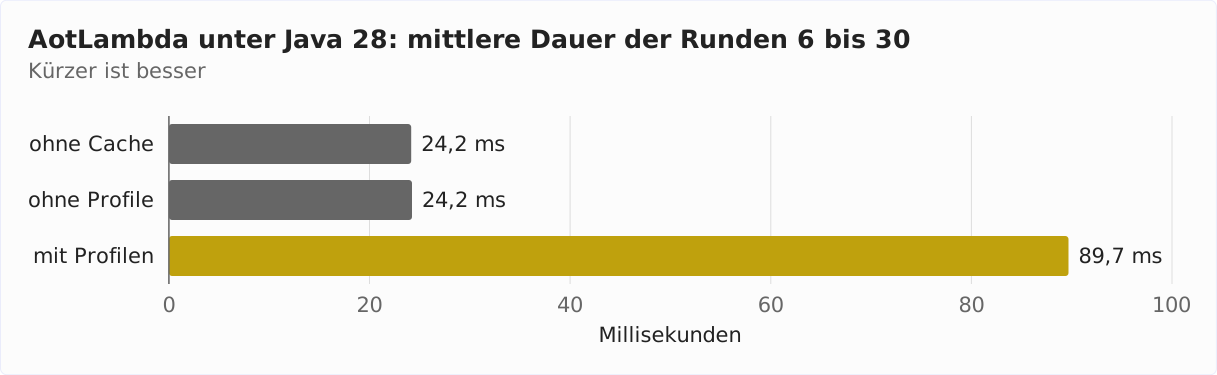
Der Cache enthält unter Java 28 auch AOT-Code. Ohne AOT-Code ist das Ergebnis dasselbe. Die Tabelle zeigt den Mittelwert der Runden 6 bis 30 aus einer Messreihe mit Caches ohne AOT-Code, in Millisekunden:
| ohne Cache | ohne Profile | mit Profilen | |
|---|---|---|---|
| Java 25 | 24,0 | 24,0 | 90,9 |
| Java 28 | 24,2 | 24,2 | 89,7 |
Mit Profilen ist das Programm unter Java 25 3,8-mal und unter Java 28 3,7-mal so langsam wie ohne.
Den Grund zeigt die Option -XX:+PrintInlining, die für jede Kompilierung ausgibt, welche Aufrufe C2 einbaut und welche nicht. Der folgende Befehl filtert die Zeilen zum Aufruf von applyAsInt() heraus, zuerst ohne die Profile:
java -XX:+UnlockDiagnosticVMOptions -XX:-AOTReplayTraining \
     -XX:AOTCache=AotLambda.aot -XX:+PrintInlining -cp AotLambda.jar AotLambda 10 \
     | grep -oE "applyAsInt.*(inline \(hot\)|to inline: [a-z ]+)"
applyAsInt (13 bytes) inline (hot)
applyAsInt (13 bytes) inline (hot)
applyAsInt (13 bytes) inline (hot)Ohne die Profile baut C2 den Lambda-Ausdruck in allen drei Kompilierungen ein, die die Aufrufstelle enthalten. Mit den Profilen sieht die Ausgabe desselben Befehls ohne -XX:-AOTReplayTraining so aus:
applyAsInt (13 bytes) failed to inline: low call site frequencyC2 hält die Aufrufstelle für selten aufgerufen und baut den Lambda-Ausdruck nicht ein. Damit bleibt pro Element des Arrays ein Methodenaufruf über das Interface IntUnaryOperator. Weil der Lambda-Ausdruck selbst nur aus wenigen Instruktionen besteht, fällt dieser Aufruf stark ins Gewicht.
Dabei ist die Aufrufstelle im Training sehr häufig gelaufen. Warum C2 sie trotzdem für selten hält, zeigt der Quellcode der JVM – nach der folgenden Infobox im Abschnitt Der Mechanismus im Quellcode.
Der Mechanismus im Quellcode
Den Grund habe ich im Quellcode von JDK 28 gefunden, in vier Schritten:
- Die Lambda-Klasse wird ausgeschlossen. Zu jedem Lambda-Ausdruck erzeugt die JVM zur Laufzeit eine versteckte Klasse (Hidden Class). Am Ende des Trainingslaufs schreibt die JVM eine Vorstufe des Caches, die sogenannte AOT-Konfiguration. Versteckte Klassen nimmt sie dort nur auf, wenn ein archivierbarer Eintrag im Konstantenpool oder ein archiviertes Objekt auf sie verweist (
AOTArtifactFinder::find_artifacts()inaotArtifactFinder.cpp). Die Verweise der aufgelösten Lambda-Aufrufstellen archiviert aber erst der zweite Schritt der Cache-Erzeugung, die sogenannte Assembly-Phase. Also gilt jede Lambda-Klasse hier als „Unreferenced hidden class“ und wird ausgeschlossen. - Ihre Zeilen verschwinden aus den Profilen – samt Zähler. Unmittelbar danach entfernt die JVM alle ausgeschlossenen Klassen aus den Profilen (
TrainingData::cleanup_training_data()). An einer Aufrufstelle wieop.applyAsInt()inSteps.step()speichert das Profil pro Empfängerklasse eine Zeile mit einem Zähler.ReceiverTypeData::clear_row()inmethodData.cpplöscht die Zeile der Lambda-Klasse und setzt dabei auch den Zähler der Aufrufstelle auf 0. - C2 hält die Aufrufstelle für kalt. C2 berechnet die Häufigkeit einer Aufrufstelle aus ihrem Zähler und der Zahl der Aufrufe der Methode laut Profil (
InlineTree::should_not_inline()inbytecodeInfo.cpp). Der Methodenzähler steht auf dem Stand des Trainings, der Zähler der Aufrufstelle auf 0. Ergebnis: „low call site frequency“. - Der Produktionslauf repariert das nicht. Kompiliert die JVM die Methode aus den Profilen des Trainings, bevor der Interpreter sie im Produktionslauf profiliert hat, bleibt der Zähler 0. Auf Stufe 2 sammelt der C1-Code keine Profildaten.
ReceiverTypeData::clear_row() setzt den Zähler mit Absicht auf 0. Der Kommentar im Quellcode begründet das mit entladenen Klassen: Wurde eine Klasse entladen, hat sich die Programmphase geändert, und der alte Zähler sagt nichts mehr aus. Beim Schreiben der AOT-Konfiguration ist aber keine Klasse entladen – die Aufrufstelle war heiß, nur ihre Empfängerklasse kommt nicht in diese Vorstufe des Caches.
In der Assembly-Phase erzeugt die JVM die Lambda-Klassen neu und archiviert sie. Ihre Profilzeilen sind zu diesem Zeitpunkt aber schon gelöscht.
Beim Schreiben der AOT-Konfiguration verlieren außerdem die Methoden der Lambda-Klassen ihre eigenen Trainingsdaten ganz (MethodTrainingData::cleanup() in trainingData.cpp).
Sichtbar wird das Löschen mit der Option -Xlog:aot+training=debug beim Trainingslauf:
java -Xlog:aot+training=debug::none -XX:AOTCacheOutput=AotLambda.aot \
     -cp AotLambda.jar AotLambda 5 | grep 'AotLambda\$\$'
Cleanup KTD AotLambda$$Lambda+0x800000001
Purged AotLambda$$Lambda+0x800000001 from MDO: excluded class„MDO“ ist in HotSpot die Abkürzung für das Methodenprofil, ein Objekt der Klasse MethodData. Dieses Löschen gibt es seit JEP 515, also seit Java 25 – mit einem Cache aus Java 25 ist AotLambda genauso langsam.
Zurück zu AotCompile
Beim Cache für AotCompile aus 20 Runden Training listet -Xlog:aot+training=debug 445 gelöschte Profilzeilen, 444 davon für Lambda-Klassen. Dazu verlieren 448 Methoden ihre Trainingsdaten ganz.
Welche Folgen das hat, zeigt ein Vergleich der Inlining-Entscheidungen von C2 mit und ohne die Profile, Aufrufstelle für Aufrufstelle. Ich habe dazu je einen Lauf mit -XX:+LogCompilation mit dem Skript compare-inlining.py aus dem Repository ausgewertet:
- 342 Aufrufstellen baut C2 nur ohne die Profile ein. 157 davon führen durch Lambda-, MethodHandle- oder String-Verkettungsklassen, also durch Klassen, die die JVM zur Laufzeit erzeugt. 134 dieser 157 Stellen haben mit Profilen den Zähler 0 oder gar keinen.
- 324 Aufrufstellen baut C2 nur mit den Profilen ein. Davon führt nur eine einzige durch eine solche Klasse.
Der häufigste Grund, aus dem C2 mit den Profilen nicht inlined, ist „low call site frequency“ – bei 154 der 342 Stellen.
Das Ergebnis zeigen die Hardware-Zähler der CPU – die Tabelle zeigt sie für den Anwendungsthread, pro Runde, ermittelt aus den letzten zwei Sekunden eines Laufs über 100 Runden:
| Variante | Takte | Instruktionen | Instruktionen pro Takt |
|---|---|---|---|
| ohne Cache | 240,2 Mio. | 1.037,8 Mio. | 4,315 |
| ohne Profile | 241,6 Mio. | 1.040,9 Mio. | 4,310 |
| mit Profilen | 249,9 Mio. | 1.065,3 Mio. | 4,266 |
Mit Profilen führt javac pro Runde 2,3 % mehr Instruktionen aus als ohne Profile, und die Instruktionen pro Takt sinken um 1,0 %. Zusammen braucht eine Runde 3,4 % mehr Takte. Wie viel davon allein auf die gelöschten Lambda-Zeilen entfällt, kann ich nicht direkt messen, denn keine Option schaltet das Löschen ab.
Wie lang sollte der Trainingslauf sein?
Unter Java 28 gilt: Je länger der Trainingslauf, desto mehr Methoden kompiliert die JVM auf Vorrat und desto langsamer wird die erste Runde. Java 25 kompiliert standardmäßig nicht auf Vorrat; die folgende Messung lief deshalb nur unter Java 28. Die Tabelle zeigt die erste Runde und die Mittelwerte der Runden 2 bis 5 und 81 bis 100 in Millisekunden sowie die Dauer von Trainingslauf und Cache-Erzeugung und die Größe des Caches:
| Variante | Runde 1 | Runden 2 bis 5 | Runden 81 bis 100 | Training und Cache | Cache- Größe |
|---|---|---|---|---|---|
| ohne Cache | 525 | 149,5 | 54,0 | – | – |
| mit Cache aus 20 Runden, ohne Profile | 417 | 147,5 | 54,6 | 3,7 s | 38,2 MB |
| mit Cache und Profilen aus 5 Runden | 415 | 113,8 | 57,3 | 2,2 s | 36,2 MB |
| mit Cache und Profilen aus 20 Runden | 490 | 133,2 | 57,0 | 3,7 s | 38,2 MB |
| mit Cache und Profilen aus 60 Runden | 536 | 136,5 | 57,5 | 6,3 s | 39,5 MB |
| mit Cache und Profilen aus 100 Runden | 596 | 132,8 | 54,5 | 8,5 s | 39,8 MB |
Mit fünf Runden Training ist die erste Runde am schnellsten, mit 100 Runden Training ist sie hingegen langsamer als ganz ohne Cache. Auf Stufe 2 kompiliert die JVM in der ersten Runde nach fünf Runden Training 4.397 Methoden, nach 100 Runden 5.493 Methoden.
In den Runden 81 bis 100 liegen die Caches mit Profilen aus 5, 20 und 60 Runden 3,0 bis 3,5 Millisekunden hinter dem Lauf ohne Cache. Nur der Cache aus 100 Runden Training liegt noch etwa gleichauf – aber nicht, weil er auf Dauer schneller wäre: Seine nachgeholte Aufwärmphase kommt erst ab Runde 121, danach fällt auch er zurück, wie die Grafik im Abschnitt Die nachgeholte Aufwärmphase zeigt.
Für Java 28 empfehle ich deshalb ein kurzes Training, wenn es dir um den Start geht: Es beschleunigt die ersten Runden am meisten. Ein längeres Training hingegen kostet mehr Zeit beim Erzeugen des Caches und verschiebt vor allem den Zeitpunkt der nachgeholten Aufwärmphase. Mit AOT-Code sieht die Rechnung anders aus; die Zahlen dazu stehen im Artikel Ahead-of-Time Code Compilation.
Iteratives Training in Java 28
Seit dem Build 28-ea+23 darf ein Trainingslauf einen vorhandenen AOT-Cache laden (JDK-8353598). Er startet dann wie ein Produktionslauf mit den Profilen aus dem Cache und zählt in ihnen weiter. Am Ende schreibt er diese fortgeschriebenen Profile in seine AOT-Konfiguration.
Außerdem führt er zusammen, was beide Trainingsläufe darüber festgehalten haben, auf welcher Stufe welche Methode kompiliert wurde. Wurde eine Methode in den beiden Läufen auf unterschiedlichen Stufen kompiliert, zählt die höhere: Wurde sie im ersten Lauf nur durch C1 kompiliert und im zweiten durch C2, behandelt der Produktionslauf sie wie eine Methode, die im Training durch C2 kompiliert wurde.
So kannst du einen Cache aus mehreren Trainingsläufen zusammensetzen:
java -XX:AOTCache=AotLambda.aot -XX:AOTCacheOutput=AotLambda-2.aot \
     -cp AotLambda.jar AotLambda 5
Die Ausgabe bestätigt in dieser Zeile, dass die JVM beides tut:
Reading AOTCache AotLambda.aot and writing AOTConfiguration AotLambda-2.aot.configMan könnte erwarten, dass das iterative Training das Problem mit den Lambda-Ausdrücken löst: Im ersten Trainingslauf schließt die JVM die Lambda-Klassen aus, weil sie sie zur Laufzeit erzeugt hat und kein archivierbarer Verweis auf sie zeigt. Im zweiten Trainingslauf kommen sie dagegen schon aus dem Cache – also müssten sie samt ihren Profilzeilen erhalten bleiben.
Das stimmt nur zur Hälfte: Die Lambda-Klasse kommt tatsächlich aus dem Cache – -Xlog:class+load meldet für sie „source: shared objects file“.
Aber auch dieser Trainingslauf schreibt nur eine AOT-Konfiguration, und dort gilt dieselbe Regel wie oben: Zeigt kein archivierbarer Verweis auf eine Lambda-Klasse, schließt die JVM sie aus der AOT-Konfiguration aus – auch wenn sie aus dem Cache stammt. -Xlog:aot=debug meldet erneut „Unreferenced hidden class“, und -Xlog:aot+training=debug meldet direkt danach die gelöschte Profilzeile.
Entsprechend ändert das iterative Training an den Laufzeiten nichts. Mit einem Cache aus fünf Runden Training dauert eine Runde von AotLambda 88,5 Millisekunden, mit einem Cache aus fünf weiteren Runden darauf ebenso 88,5 Millisekunden – ohne Cache 24,0 ms.
Bei AotCompile sieht es genauso aus: Auch mit iterativem Training bleibt das Programm langsamer als ohne Cache, und es ist nicht schneller als mit einem einzelnen Trainingslauf. Die Tabelle zeigt den Mittelwert der Runden 81 bis 100 in Millisekunden:
| Variante | Runden 81 bis 100 | gegenüber ohne Cache |
|---|---|---|
| ohne Cache | 54,9 | – |
| mit Cache aus 20 Runden, ohne Profile | 55,2 | +0,5 % |
| mit Cache und Profilen aus 20 Runden | 57,8 | +5,3 % |
| mit Cache und Profilen aus 20 Runden und 20 weiteren iterativ | 58,3 | +6,2 % |
| mit Cache und Profilen aus 40 Runden am Stück | 57,0 | +3,8 % |
Mit iterativem Training dauert eine Runde 0,9 % länger als mit einem einzelnen Trainingslauf aus 20 Runden und 2,3 % länger als mit 40 Runden am Stück.
Auch der zweite Trainingslauf löscht 412 Profilzeilen von Lambda-Klassen; im ersten waren es 445.
Was das für die Praxis heißt
Aus zwei Programmen lässt sich kein Urteil über alle Anwendungen ableiten. Drei Dinge aber schon:
- Für die Aufwärmphase bringen die Profile, was der JEP verspricht, für den Start nur unter Java 25. Unter Java 25 dauert die erste Runde des Beispielprogramms ohne Profile 399 Millisekunden, mit Profilen 372 ms, also 6,8 % weniger, und die Runden 2 bis 5 brauchen mit Profilen sogar 13,9 % weniger Zeit – ohne dass du dafür etwas tun musst. Unter Java 28 ist die erste Runde mit den Profilen dagegen langsamer, weil die JVM auf Vorrat kompiliert; die Runden 2 bis 5 sind auch dort schneller.
- Auf Dauer können die Profile Leistung kosten, und zwar dort, wo heißer Code Lambda-Ausdrücke aufruft. Weder ein längeres noch ein iteratives Training umgeht das, und auch der AOT-Code aus Java 28 nicht, denn die JVM kompiliert ihn aus denselben Profilen.
- Ob deine Anwendung betroffen ist, kannst du messen. Starte sie mit demselben Cache einmal ohne weitere Option und einmal mit
-XX:-AOTReplayTrainingund vergleiche den Durchsatz, nachdem sie warm ist. Bedenke, dass die Option in Java 28 auch den AOT-Code abschaltet.
Ich empfehle, den AOT-Cache mit Profilen zu verwenden, wenn der Start und die Aufwärmphase zählen – etwa bei kurzlebigen Prozessen oder Diensten, die häufig neu gestartet werden. Läuft eine Anwendung tagelang, war in meinen beiden Beispielen die Variante ohne Profile auf Dauer schneller. Das liegt am Löschen der Lambda-Profilzeilen beim Schreiben des Caches, also an einem Verhalten der heutigen Versionen, nicht an den Profilen an sich. Wird dieses Löschen in Java 28 oder einer späteren Version behoben, fällt der Nachteil voraussichtlich weg. Messen solltest du lange laufende Anwendungen aber auch dann: Sind sie mit Profilen nur gleich schnell oder kaum schneller als ohne Profile, dann lohnt sich der Aufwand für Trainingslauf und Cache-Erzeugung womöglich nicht.
Fazit
Seit Java 25 legt der Trainingslauf die Methodenprofile in den AOT-Cache, und der C2-Compiler kompiliert damit die heißen Methoden direkt nach dem Start. An einem Beispielprogramm, das in jeder Runde 50 Quelldateien mit javac kompiliert, dauert unter Java 25 die erste Runde ohne Profile 399 Millisekunden, mit Profilen 372 ms, also 6,8 % weniger. Eine der Runden 2 bis 5 dauert ohne Profile 131,0 ms, mit Profilen 112,8 ms, also 13,9 % weniger.
Unter Java 28 ist die erste Runde mit Profilen dagegen langsamer als ohne, weil die JVM die Methoden aus dem Training auf Vorrat kompiliert: 490 statt 417 Millisekunden mit einem Cache aus 20 Runden Training, also 17,5 % mehr.
Auf Dauer ist das Programm mit den Profilen langsamer als ohne Cache – unter Java 28 nach 200 Runden um 5,1 % mit einem Cache aus 20 Runden Training. Der Grund: Beim Schreiben der AOT-Konfiguration – der Vorstufe des Caches am Ende des Trainingslaufs – löscht die JVM die Lambda-Klassen aus den Profilen, samt dem Zähler der Aufrufstelle, und C2 baut diese Lambda-Ausdrücke danach nicht mehr ein. An einem kleinen Beispiel wird das Programm dadurch fast viermal so langsam.
Miss den Durchsatz deiner Anwendung nach der Aufwärmphase mit und ohne Profile, bevor du dich für einen Cache mit Profilen entscheidest. Ein längeres oder iteratives Training ändert am Löschen der Lambda-Klassen aus den Profilen nichts.
Wenn dir der Artikel weitergeholfen hat, würde ich mich sehr über eine positive Bewertung auf meinem ProvenExpert-Profil freuen. Dein Feedback hilft mir, meine Inhalte weiter zu verbessern und motiviert mich, neue informative Artikel zu schreiben.