Mit Java 28 legt die JVM nicht mehr nur geladene Klassen und Methodenprofile in den AOT-Cache, sondern auch fertig kompilierten Maschinencode. JEP 544: Ahead-of-Time Code Compilation ist seit Oktober 2026 in die Codebasis von JDK 28 integriert; Java 28 soll laut Zeitplan am 9. März 2027 erscheinen.
An meinem Beispielprogramm halbiert der vorkompilierte Code die Ausführungszeit der ersten Runde: 252 statt 527 Millisekunden. Dafür musst du nichts umstellen – derselbe Trainingslauf, der seit Java 25 den AOT-Cache erzeugt, legt jetzt auch den Maschinencode in den Cache.
Der JIT-Compiler läuft trotzdem weiter. Sobald eine Methode oft genug aufgerufen wurde, ersetzt HotSpot den vorkompilierten Code durch neu kompilierten – und in meiner Messung ist die Anwendung währenddessen langsamer als mit einem Cache ohne vorkompilierten Code.
In diesem Artikel erfährst du:
- Was beim Start und in der Aufwärmphase einer Java-Anwendung passiert und welcher Teil davon jetzt in den AOT-Cache wandert
- Wie du den Cache mit Maschinencode erzeugst und am Log erkennst, dass die JVM ihn lädt
- Wie viel der vorkompilierte Code an einem Beispiel bringt – gemessen ohne Cache, mit Cache ohne Maschinencode und mit Maschinencode
- Warum HotSpot den vorkompilierten Code nach und nach ersetzt
- Wie lang der Trainingslauf sein sollte
- Unter welchen Bedingungen die JVM den Maschinencode nicht lädt, ohne das zu melden
- Wie sich JEP 544 von GraalVM Native Image und dem früheren
jaotcunterscheidet
Das Beispielprogramm, die Messskripte und alle Messergebnisse findest du im GitHub-Repository java-aot-cache.
Start, Aufwärmphase, Spitzenleistung
Eine Java-Anwendung durchläuft in der HotSpot-JVM drei Phasen:
- Start: Die JVM lädt, linkt und initialisiert jede Klasse erst, wenn das Programm sie zum ersten Mal verwendet, und führt den Code zunächst im Bytecode-Interpreter aus. Dabei zählt sie, wie oft Methoden aufgerufen und Schleifen durchlaufen werden. Häufig aufgerufene Methoden kompiliert der C1-Compiler schnell in mäßig optimierten Maschinencode („C1-Code“).
- Aufwärmphase: Der C1-Code sammelt weitere Profildaten, z. B. welche Typen an einer Aufrufstelle tatsächlich vorkommen. Mit diesen Daten kompiliert der C2-Compiler die meistgenutzten Methoden in stark optimierten Code („C2-Code“).
- Spitzenleistung: Schließlich liegen die meistgenutzten (die „heißen“) Methoden als C2-Code vor, und die Compiler haben nichts mehr zu tun.
Ändert sich das Verhalten der Anwendung, verwirft HotSpot Code, dessen Annahmen nicht mehr stimmen – die sogenannte Deoptimierung –, und kompiliert die betroffenen Methoden mit den neuen Profildaten erneut.
Bis die Spitzenleistung erreicht ist, kostet diese Arbeit Zeit: Der Interpreter und der Profiling-Code von C1 sind langsamer als optimierter Code, und die Compiler-Threads brauchen CPU-Zeit, die der Anwendung dann fehlt. Und diesen ganzen Ablauf – Klassen laden, interpretieren, profilieren, kompilieren – durchläuft die JVM bei jedem Start wieder von vorn.
Was der AOT-Cache vor Java 28 speichert
Project Leyden verlagert diese Arbeit Schritt für Schritt in einen Trainingslauf. Die Ergebnisse dieses Trainingslaufs werden im sogenannten AOT-Cache gespeichert, einer Datei, die die JVM bei späteren Starts einliest:
- Java 24 speichert mit JEP 483 die Klassen in geladener und gelinkter Form.
- Java 25 ergänzt mit JEP 515 die Methodenprofile, sodass C2 direkt nach dem Start kompilieren kann. JEP 514 fasst im selben Release Trainingslauf und Cache-Erzeugung zu einem Kommando zusammen.
- Seit Java 26 lässt sich der AOT-Cache mit JEP 516 mit jedem Garbage Collector erzeugen und nutzen, auch mit ZGC.
Wie diese Schritte im Einzelnen funktionieren und was sie beim Start sparen, zeige ich im Artikel Ahead-of-Time Class Loading & Linking.
Was JEP 544 hinzufügt
Mit den seit Java 25 verfügbaren Profilen aus dem Cache kann der C2-Compiler früher loslegen – aber er muss die heißen Methoden bei jedem Start erneut kompilieren. JEP 544 verlegt auch diesen Schritt nach vorn: Beim Erzeugen des Caches kompilieren C1 und C2 die Methoden, die im Trainingslauf häufig liefen, und die JVM legt den Maschinencode mit in den Cache.
Der JEP nennt den gecachten Code AOT-Code und den, den der JIT-Compiler zur Laufzeit erzeugt, JIT-Code. Ich verwende im Folgenden dieselben Begriffe.
Laut JEP hat der AOT-Code vier Eigenschaften:
- Kein neuer Schalter: Die JVM erzeugt den AOT-Code standardmäßig, mit denselben Kommandos wie seit Java 25.
- Dieselben Compiler: Den AOT-Code erzeugen dieselben Compiler wie den JIT-Code, C1 und C2. Deshalb passen beide zusammen: AOT-Code kann JIT-Code aufrufen und umgekehrt, und HotSpot kann den AOT-Code einer Methode durch JIT-Code ersetzen, ohne dass die Anwendung etwas davon merkt.
- Kein reiner AOT-Modus: Was nicht im Cache liegt, interpretiert und kompiliert HotSpot wie gewohnt.
- Keine Cross-Compilation: Der AOT-Code läuft nur auf derselben CPU-Architektur mit denselben CPU-Features wie beim Erzeugen. Unterstützt werden zunächst AArch64 und x64.
AOT-Code erzeugen: Schritt für Schritt
Ein Programm, das wenig Code ausführt, profitiert kaum vom AOT-Code – die Zahlen dazu stehen im Abschnitt Programme, die wenig Code ausführen. Ich habe deshalb ein Beispielprogramm geschrieben, das viel Code lädt und kompiliert: Es übersetzt in jeder Runde 50 generierte Quelldateien mit dem javac-Compiler im Speicher und gibt aus, wie lange die Runde gedauert hat. Dieselbe Idee steckt hinter dem javac-Benchmark, mit dem die JEP-Autoren die Aufwärmphase messen.
Das Programm ist eine kompakte Quelldatei. main() ruft compile() so oft auf, wie das erste Argument angibt, und compile() übergibt die 50 Quelldateien an den Compiler:
void main(String[] args) {
  int iterations = args.length > 0 ? Integer.parseInt(args[0]) : 10;
  JavaCompiler compiler = ToolProvider.getSystemJavaCompiler();
  for (int i = 1; i <= iterations; i++) {
    long start = System.nanoTime();
    boolean success = compile(compiler);
    long millis = (System.nanoTime() - start) / 1_000_000;
    String result = success ? "ok" : "failed";
    IO.println("Iteration %2d: %4d ms (%s)".formatted(i, millis, result));
  }
}

boolean compile(JavaCompiler compiler) {
  var sources = new ArrayList<JavaFileObject>();
  for (int n = 0; n < 50; n++) {
    sources.add(new SourceFile("Shapes" + n, SOURCE_TEMPLATE.formatted(n)));
  }
  var standardFileManager = compiler.getStandardFileManager(null, null, null);
  var fileManager = new DiscardingFileManager(standardFileManager);
  return compiler.getTask(null, fileManager, null, null, null, sources).call();
}
Drei Dinge sind hier nicht mit abgedruckt – du findest sie in der vollständigen Datei AotCompile.java im Repository:
- Die Konstante
SOURCE_TEMPLATEist die Vorlage der 50 Quelldateien: eine Klasse mit einem versiegelten Interface, drei Records, einemswitchmit Record Patterns und einem Stream. - Die Klasse
SourceFileliefert dem Compiler eine Quelldatei aus einem String. - Die Klasse
DiscardingFileManagerverwirft die erzeugten.class-Dateien, statt sie ins Dateisystem zu schreiben.
Du brauchst einen Early-Access-Build von Java 28 (jdk.java.net/28); ich verwende Build 28-ea+20. Die folgenden Kommandos kompilieren die Datei und packen die Klassen in eine JAR-Datei:
javac -d classes AotCompile.java
jar cf AotCompile.jar -C classes .
Die JAR-Datei ist nötig: Steht statt einer JAR ein Verzeichnis mit Klassen im Klassenpfad, bricht die JVM die Erzeugung des Caches mit der Meldung „Cannot have non-empty directory in paths“ ab.
Den Trainingslauf startest du wie seit Java 25 mit -XX:AOTCacheOutput, hier mit 20 Runden:
java -XX:AOTCacheOutput=AotCompile.aot -cp AotCompile.jar AotCompile 20Nach den 20 Runden meldet die JVM, dass sie einen zweiten Prozess startet. Dieser liest die Beobachtungen des Trainingslaufs ein und erzeugt daraus den Cache – und kompiliert dabei den AOT-Code. Die letzten Zeilen der Ausgabe sehen so aus:
Reading AOTConfiguration AotCompile.aot.config and writing AOTCache AotCompile.aot
AOTCache creation is complete: AotCompile.aot 87998464 bytes
Removed temporary AOT configuration file AotCompile.aot.config
Zwischen der ersten und der zweiten dieser Zeilen gibt die JVM in meinem Lauf drei Warnungen der Form „Cannot aot-resolve Lambda proxy because … is not loaded“ aus. Sie betreffen Lambda-Ausdrücke in javac, deren Klassen der Trainingslauf nicht geladen hat. Diese Lambdas löst die JVM nicht vorab im Cache auf, sondern – wie ohne Cache – erst, wenn das Programm sie braucht.
Der Cache ist rund 88 MB groß. Zum Vergleich: Ein Cache aus einem Trainingslauf mit ebenfalls 20 Runden, aber ohne AOT-Code, hat in meiner Messung 38 MB.
Jetzt startest du das Programm einmal ohne und einmal mit Cache, jeweils mit fünf Runden:
java -cp AotCompile.jar AotCompile 5
java -XX:AOTCache=AotCompile.aot -cp AotCompile.jar AotCompile 5
Ohne Cache gibt das Programm Folgendes aus:
Iteration  1:  620 ms (ok)
Iteration  2:  280 ms (ok)
Iteration  3:  218 ms (ok)
Iteration  4:  158 ms (ok)
Iteration  5:  132 ms (ok)
Mit Cache sieht die Ausgabe so aus:
Iteration  1:  330 ms (ok)
Iteration  2:  215 ms (ok)
Iteration  3:  180 ms (ok)
Iteration  4:  126 ms (ok)
Iteration  5:  103 ms (ok)
Mit Cache dauert die erste Runde nur gut halb so lange. Einzelne Läufe schwanken; die Mediane aus vielen Läufen stehen im nächsten Abschnitt.
Am Log erkennen, dass die JVM AOT-Code lädt
Ob die JVM AOT-Code lädt, zeigt die Option -Xlog:aot. Sie gibt viele Zeilen aus; die zum AOT-Code enthalten die Wörter „AOT Code“. Mit stdout:none schreibt die JVM sie auf die Standardausgabe und ohne Zeitstempel und Tags:
java -Xlog:aot:stdout:none -XX:AOTCache=AotCompile.aot \
     -cp AotCompile.jar AotCompile 1 | grep "AOT Code"
Die Ausgabe sieht so aus:
Mapped 49955040 bytes at address 0x000000013ee70010 from AOT Code Cache
Loaded 7812 AOT code entries from AOT Code Cache
Read 1915 preload entries from AOT Code Cache
Rund 50 der 88 MB im Cache sind also AOT-Code. Hinter den 1.915 „preload entries“ steckt eine zweite Fassung des AOT-Codes, der sogenannte Preload-Code.
Wann die JVM den Preload-Code einer Methode verwendet und wann ihren AOT-Code, zeigt die Option -XX:+PrintCompilation. Sie gibt für jede Methode, die HotSpot kompiliert oder aus dem Cache lädt, eine Zeile aus. Die folgende Tabelle zeigt diese Zeilen für die javac-Methode Names.fromString() aus meinem Lauf mit 40 Runden. Sie hat diese Spalten:
- Zeit: Millisekunden seit dem Start der JVM
- ID: die fortlaufende Nummer, die HotSpot dem Code beim Kompilieren oder Laden gibt; verwirft HotSpot den Code, steht in der Zeile wieder dessen Nummer
- Kennzeichen:
Afür AOT-Code aus dem Cache,APfür Preload-Code aus dem Cache, leer für JIT-Code - Stufe: 1 bis 3 sind Varianten von C1, 4 ist C2
- Ereignis: ob der Code geladen bzw. kompiliert oder verworfen wurde
| Zeit | ID | Kennzeichen | Stufe | Ereignis |
|---|---|---|---|---|
| 26 | 350 | AP | 4 | Preload-Code aus dem Cache geladen |
| 145 | 4527 | A | 4 | AOT-Code aus dem Cache geladen |
| 145 | 350 | AP | 4 | Preload-Code verworfen („made not entrant: not used“) |
| 772 | 8584 | 4 | von C2 kompiliert | |
| 778 | 4527 | A | 4 | AOT-Code verworfen („made not entrant: not used“) |
Die Methode wechselt also zweimal den Code: Nach 145 Millisekunden ersetzt HotSpot den Preload-Code durch AOT-Code, und nach 772 Millisekunden ersetzt er den AOT-Code durch C2-JIT-Code.
Warum es zwei Fassungen des AOT-Codes gibt und warum HotSpot ihn wieder ersetzt, steht im Abschnitt Warum HotSpot den AOT-Code wieder ersetzt.
Wie viel bringt der AOT-Code?
Um den Anteil des AOT-Codes vom übrigen Inhalt des Caches – den geladenen und gelinkten Klassen, den Methodenprofilen und den vorinitialisierten Objekten – zu trennen, habe ich drei Varianten gemessen: ohne Cache, mit einem Cache ohne AOT-Code und mit einem Cache mit AOT-Code. Den Cache ohne AOT-Code erzeugt derselbe Trainingslauf mit der diagnostischen Option -XX:-AOTCodeCaching:
java -XX:+UnlockDiagnosticVMOptions -XX:-AOTCodeCaching \
     -XX:AOTCacheOutput=AotCompile-ohne-code.aot -cp AotCompile.jar AotCompile 20
Die Tabelle zeigt, wie lange eine Runde in jeder Variante dauert, in Millisekunden. Für die Zeilen mit mehreren Runden ist es der Mittelwert pro Runde:
| Runden | ohne Cache | Cache ohne AOT-Code | Cache mit AOT-Code |
|---|---|---|---|
| 1 | 527 | 489 | 252 |
| 2 bis 5 | 151 | 132 | 106 |
| 6 bis 10 | 87 | 83 | 77 |
| 11 bis 20 | 73 | 66 | 74 |
| 21 bis 30 | 65 | 67 | 71 |
| 31 bis 40 | 61 | 64 | 64 |
Mit AOT-Code dauert die erste Runde 52 % kürzer als ohne Cache, mit dem Cache ohne AOT-Code nur 7 %. Das ist eine eindrucksvolle Beschleunigung der Anfangsphase des Programms.
In den Runden 2 bis 10 bleibt der Vorsprung, wird aber kleiner: In den Runden 2 bis 5 dauert eine Runde mit AOT-Code im Mittel 106 Millisekunden, ohne Cache 151 und mit dem Cache ohne AOT-Code 132; in den Runden 6 bis 10 sind es 77, 87 und 83 Millisekunden.
In den Runden 11 bis 20 kehrt sich das Bild um: Mit AOT-Code dauert eine Runde 74 Millisekunden, mit dem Cache ohne AOT-Code nur 66. Den Grund erkläre ich im Abschnitt Warum HotSpot den AOT-Code wieder ersetzt. Danach gleichen sich die beiden Caches wieder an: In den Runden 21 bis 30 ist der Abstand kleiner, und ab Runde 31 dauert eine Runde mit und ohne AOT-Code gleich lang.
Die folgende Grafik zeigt die ersten 40 Runden einzeln, als Median jeder Runde. Die blaue Linie ist die Variante ohne Cache, die rote der Cache ohne AOT-Code und die gelbe der Cache mit AOT-Code:
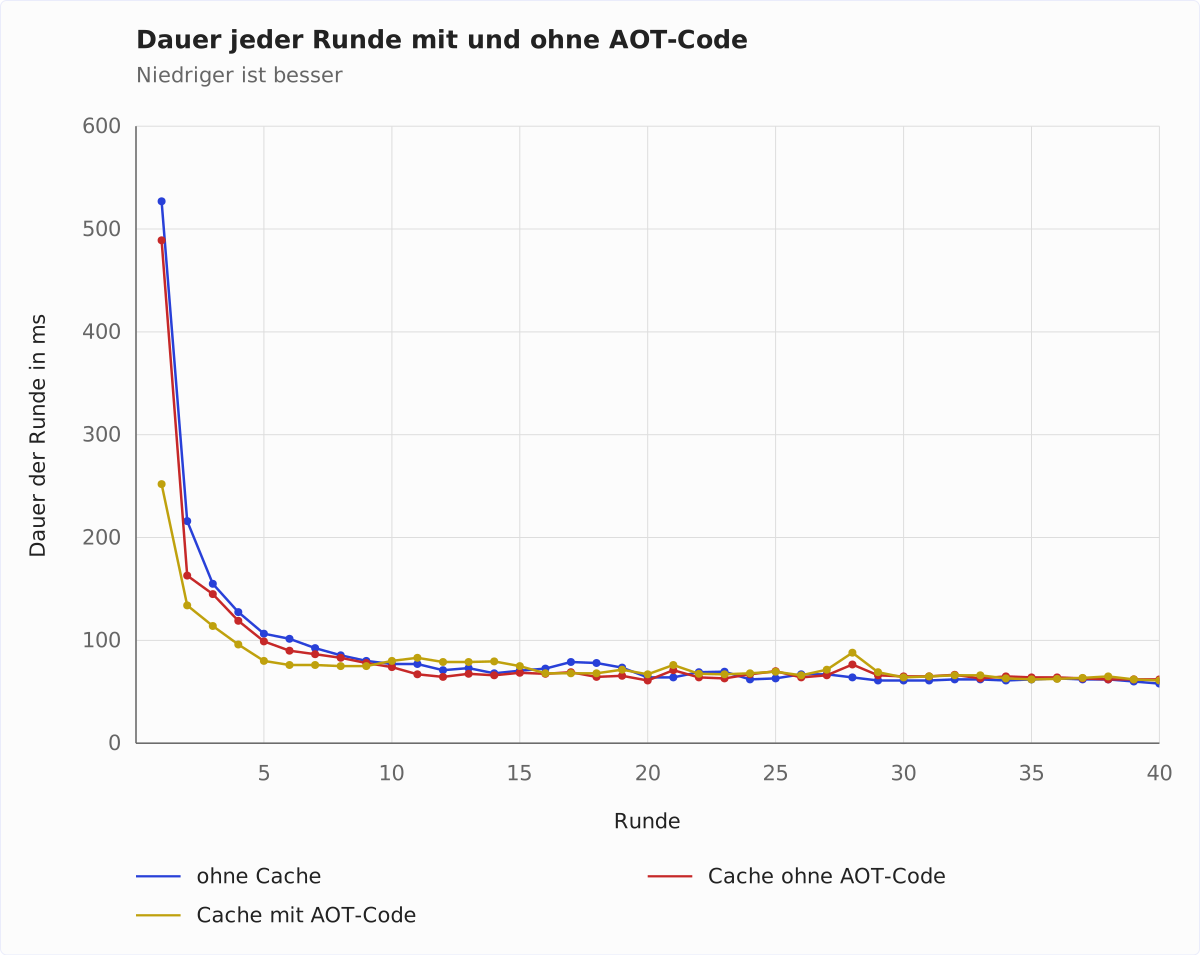
Deutlich zu erkennen ist, dass das Programm in der Anfangsphase mit dem Cache mit AOT-Code (gelbe Linie) viel schneller ist als ohne Cache (blaue Linie) und mit dem Cache ohne AOT-Code (rote Linie). Ab Runde 10 liegen die Linien nah beieinander; bis etwa Runde 30 verläuft die gelbe Linie (Cache mit AOT-Code) meist über der roten (Cache ohne AOT-Code), danach liegen beide fast übereinander.
Die JEP-Autoren messen größere Effekte. Bei fünf Anwendungen auf verbreiteten Frameworks verkürzt der Cache ohne AOT-Code den Start um 50 bis 70 %, mit AOT-Code um 65 bis 80 %. Bei ihrem javac-Benchmark verkürzt der Cache ohne AOT-Code die erste Runde um etwa 30 %, mit AOT-Code um etwa 75 %. Gemessen haben sie auf einem Linux-System mit zwei Kernen, auf dem die JIT-Compiler mit der Anwendung um die CPU konkurrieren – mein MacBook hat 18 Kerne.
Programme, die wenig Code ausführen
Ein Programm, das wenig Code ausführt, profitiert kaum vom AOT-Code, sondern hauptsächlich vom übrigen Inhalt des Caches – den geladenen und gelinkten Klassen, den Methodenprofilen und den vorinitialisierten Objekten. Das Programm AotTest aus dem Artikel Ahead-of-Time Class Loading & Linking gibt nur das aktuelle Datum aus. Es startet ohne Cache in 44,7 Millisekunden, mit Cache ohne AOT-Code in 33,4 und mit AOT-Code in 32,9 Millisekunden.
Warum HotSpot den AOT-Code wieder ersetzt
AOT-Code kann schlechter optimiert sein als JIT-Code. Denn C2 kompiliert ihn nicht im Produktionslauf, sondern – wie im Abschnitt AOT-Code erzeugen: Schritt für Schritt beschrieben – nach einem Trainingslauf in einem separaten Prozess, der den Cache erzeugt – und in dem die Anwendung selbst nicht mehr läuft. Ihm fehlen daher Informationen, die er im Produktionslauf hätte.
Der JEP nennt zwei Beispiele:
- Klasseninitialisierung: Ruft eine Methode eine statische Methode einer anderen Klasse auf oder liest sie ein statisches Feld, muss die andere Klasse vorher initialisiert sein. Ob sie es schon ist, hängt im Produktionslauf von der Reihenfolge der Aufrufe ab. Der C2-Compiler erzeugt deshalb zwei Fassungen der Methode: eine langsame, die vor jedem Zugriff prüft, ob die Klasse initialisiert ist (der zuvor erwähnte Preload-Code), und eine schnelle ohne diese Prüfung (der AOT-Code). HotSpot verwendet zuerst die langsame Fassung und wechselt zur schnellen, sobald alle benötigten Klassen initialisiert sind.
- Statische finale Felder: Im Produktionslauf kennt der C2-Compiler den Wert eines
static final-Felds und setzt ihn als Konstante direkt in den Maschinencode ein. Beim Erzeugen des Caches ist keine Klasse initialisiert, und der Wert kann in jedem Lauf ein anderer sein, z. B. der Zeitpunkt des Starts der Anwendung. Der AOT-Code muss das Feld deshalb jedes Mal lesen.
Ein dritter, im JEP nicht genannter Grund kommt hinzu: Das Profil, mit dem der C2-Compiler den AOT-Code kompiliert, kommt aus dem Trainingslauf. Ein Produktionslauf dauert meist länger, und sein Profil kann ganz anders aussehen.
Damit die Anwendung trotzdem ihre Spitzenleistung erreicht, ersetzt HotSpot den AOT-Code nach und nach durch JIT-Code. Dazu zählt jede per AOT kompilierte C2-Methode ihre Aufrufe. Überschreitet der Zähler eine Grenze, kompiliert HotSpot die Methode mit dem JIT-Compiler neu und verwirft den AOT-Code. Die Grenze richtet sich nach der Zahl der Aufrufe im Trainingslauf und liegt zwischen etwa 100 und etwa einer Million.
Das Zählen hat seinen Preis: Es kostet bei jedem Aufruf einen Lese- und einen Schreibzugriff sowie einen Vergleich. C2-JIT-Code zählt seine Aufrufe nicht. Solange eine Methode als AOT-Code läuft, ist sie also auch deshalb langsamer als JIT-Code.
In meinem Lauf mit 40 Runden lädt HotSpot 1.625 C2-Methoden als AOT-Code. 889 davon ersetzt er später durch C2-JIT-Code – 808 davon schon innerhalb der ersten 20 Runden. Die Methode Names.fromString() aus der Tabelle oben ist eine davon.
Während dieses Austauschs ist das Beispielprogramm mit AOT-Code langsamer als mit dem Cache ohne AOT-Code: In den Runden 11 bis 20 dauert eine Runde im Mittel 74 statt 66 Millisekunden.
Ab Runde 31 dauert eine Runde mit beiden Caches praktisch gleich lang. Ohne Cache ist das Programm ab Runde 21 allerdings schneller und bleibt es: In den Runden 81 bis 100 braucht eine Runde ohne Cache 56 Millisekunden, mit einem der beiden Caches 59 – das sind 5 % mehr.
Am AOT-Code liegt das also nicht, sondern an den Methodenprofilen aus dem Trainingslauf. Das zeigt die diagnostische Option -XX:-AOTReplayTraining: Mit ihr liest die JVM die Profile aus dem Cache nicht ein, verwendet aber weiterhin die geladenen und gelinkten Klassen. In einer weiteren Messreihe mit 15 Läufen je Variante dauert eine Runde in den Runden 81 bis 100 ohne Cache 55,8 Millisekunden, mit dem Cache ohne AOT-Code 58,9 und mit demselben Cache, aber ohne die Profile, 56,1 Millisekunden. Warum die Profile aus dem Training auf Dauer zu langsamerem Code führen, habe ich nicht weiter untersucht.
Ohne Zähler bleibt der AOT-Code langsamer
Was ohne den Austausch von AOT-Code zu JIT-Code passiert, zeigt ein Cache, dessen AOT-Code keine Zähler hat. Die diagnostische Option -XX:-UseAOTCodeCounters schaltet sie ab. Sie wirkt nur beim Erzeugen des Caches, deshalb übergibst du sie über die Umgebungsvariable JDK_AOT_VM_OPTIONS, die nur für diesen Schritt gilt:
JDK_AOT_VM_OPTIONS='-XX:+UnlockDiagnosticVMOptions -XX:-UseAOTCodeCounters' \
  java -XX:AOTCacheOutput=AotCompile-ohne-zaehler.aot -cp AotCompile.jar AotCompile 20
Die folgende Grafik zeigt 60 Runden mit beiden Caches, als Median jeder Runde aus acht Läufen. Die blaue Linie ist der Cache mit Zählern, wie die JVM ihn standardmäßig erzeugt, die rote der Cache ohne Zähler:
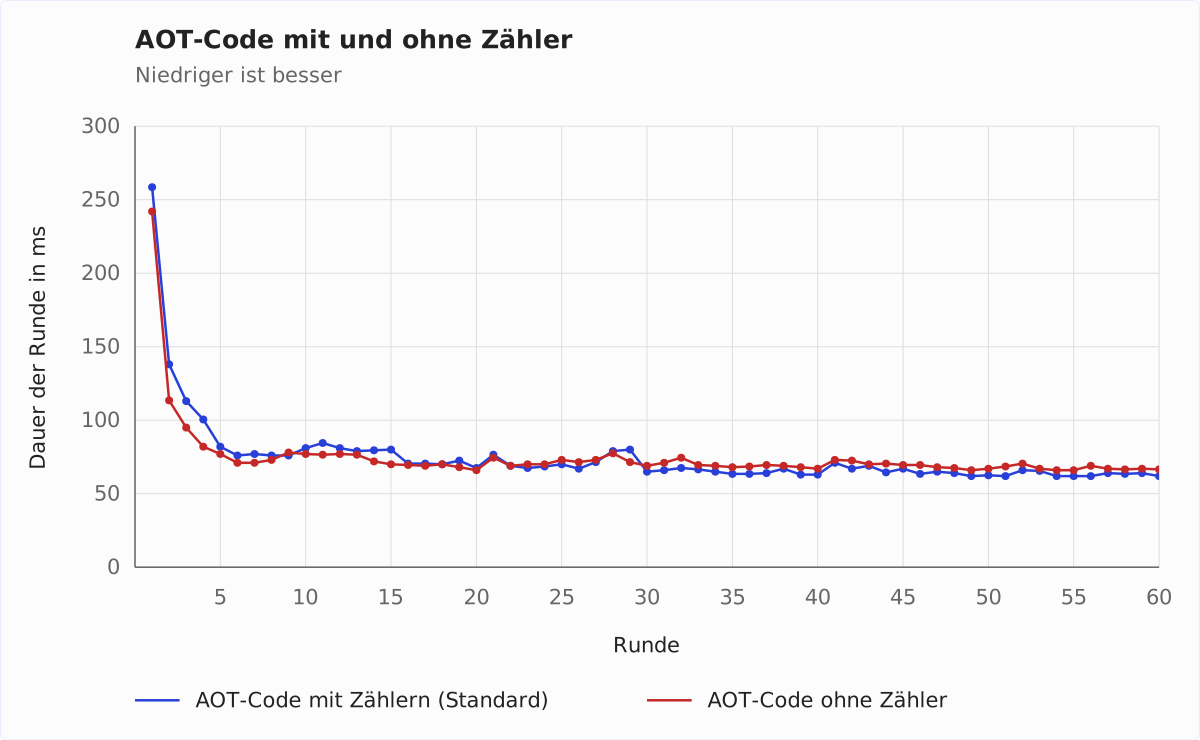
Ohne Zähler ist das Programm in den ersten 20 Runden schneller: In den Runden 2 bis 5 dauert eine Runde im Mittel 92 statt 108 Millisekunden, in den Runden 11 bis 20 im Mittel 72 statt 76 Millisekunden. Ab etwa Runde 30 bleibt es aber langsamer – in den Runden 51 bis 60 braucht eine Runde 68 Millisekunden, mit Zählern 63 Millisekunden. Ohne Zähler ist das Programm dort also 8 % langsamer.
Der Grund: Ohne Zähler ersetzt HotSpot den AOT-Code nicht durch JIT-Code. In einem Lauf mit 60 Runden lädt er 1.639 C2-Methoden als AOT-Code und ersetzt keine davon; nur 75 verwirft er per Deoptimierung, weil eine Annahme im Code nicht mehr stimmt. Die Nachteile des AOT-Codes aus der Liste oben bleiben also bis zum Ende bestehen.
Wie lang sollte der Trainingslauf sein?
Der Trainingslauf bestimmt, welche Methoden C1 und C2 vorab kompilieren und mit welchem Profil. Um zu sehen, wie viel seine Länge ausmacht, habe ich Caches aus Trainingsläufen mit 5, 20 und 60 Runden erzeugt und das Programm mit jedem Cache achtmal 60 Runden lang laufen lassen.
Die Tabelle zeigt die erste Runde und den Mittelwert der Runden 6 bis 10 in Millisekunden sowie die Größe des Caches:
| Training | Runde 1 | Runden 6 bis 10 | Cache-Größe |
|---|---|---|---|
| 5 Runden | 266 ms | 106 ms | 66,4 MB |
| 20 Runden | 259 ms | 77 ms | 87,0 MB |
| 60 Runden | 256 ms | 76 ms | 101,2 MB |
Ein längeres Training macht das Programm mit dem AOT-Code schneller – allerdings nur bis zu einer gewissen Länge. In der ersten Runde liegen die drei Caches nah beieinander, zwischen 256 und 266 Millisekunden. Deutlicher wird der Unterschied in den folgenden Runden: In den Runden 6 bis 10 ist das Programm mit dem Cache aus 20 Runden Training 27 % schneller als mit dem aus fünf Runden. Mit 60 Runden Training ist es dort nur noch 1 Millisekunde schneller, in den Runden 2 bis 5 sogar langsamer: 118 statt 108 Millisekunden.
Dazu passt, dass kürzere Trainings weniger AOT-Code liefern: Laut -Xlog:aot enthält der Cache aus fünf Runden 31 MB AOT-Code, der aus 20 Runden 49 MB und der aus 60 Runden 62 MB. Die Größe des AOT-Caches schwankt übrigens von Lauf zu Lauf: Drei Caches aus je 20 Runden Training hatten 86,9 bis 87,4 MB.
Berücksichtigen solltest du auch, dass das Erzeugen des AOT-Codes Zeit kostet: Trainingslauf und Cache-Erzeugung dauern damit etwa doppelt so lange wie für einen Cache ohne AOT-Code. In meiner Messung dauern beide Schritte zusammen 7,9 bis 8,1 Sekunden, ohne AOT-Code 4,0 Sekunden – und ganz ohne AOT-Cache 2,6 Sekunden.
Ich empfehle einen Trainingslauf, der die Arbeit abdeckt, die die Anwendung nach dem Start leistet – also die typischen Anfragen, nicht nur den Start. Soll der Cache nur die erste Runde beschleunigen – bei einer Anwendung also den Start und die ersten Anfragen –, reicht ein kurzes Training. Soll er auch die Zeit verkürzen, bis die Anwendung ihre Spitzenleistung erreicht, zahlt sich ein längeres Training aus.
Wann die JVM den AOT-Code nicht lädt
Laut JEP verwendet die JVM den AOT-Code nur unter zwei Bedingungen, zusätzlich zu denen, die laut JEP 483 für den gesamten Cache gelten (dasselbe JDK-Release, dieselbe Hardware-Architektur, dasselbe Betriebssystem, ein Klassenpfad, der mit denselben JAR-Dateien beginnt, und dieselben Moduloptionen):
- Trainingslauf und Produktionslauf laufen auf derselben CPU-Architektur mit denselben CPU-Features. AOT-Code für eine x64-CPU mit AVX-512 (Vektorbefehle, die 512 Bit auf einmal verarbeiten) läuft z. B. nicht auf einer x64-CPU ohne AVX-512.
- Beide verwenden denselben Garbage Collector, denn der AOT-Code enthält Barrieren, die zum jeweiligen GC gehören.
Ist eine Bedingung verletzt, verwendet die JVM die geladenen und gelinkten Klassen und die Profildaten aus dem Cache weiter, aber nicht den AOT-Code. Laut JEP gibt HotSpot dann eine Warnung aus. Im Build 28-ea+20 meldet die JVM das nur, wenn du die Meldungen mit der VM-Option -Xlog:aot ausdrücklich anforderst.
Startest du das Beispielprogramm mit dem unter G1 erzeugten Cache und dem Serial GC, erscheint keine Meldung:
java -XX:+UseSerialGC -XX:AOTCache=AotCompile.aot -cp AotCompile.jar AotCompile 1Iteration 1: 392 ms (ok)Erst -Xlog:aot zeigt, dass die JVM den AOT-Code verworfen hat:
java -XX:+UseSerialGC -Xlog:aot:stdout:none -XX:AOTCache=AotCompile.aot \
     -cp AotCompile.jar AotCompile 1 | grep "AOT Code"
Mapped 49955040 bytes at address 0x000000012e3c8010 from AOT Code Cache
AOT Code Cache disabled: it was created with UseCondCardMark = true vs current false
Unable to use AOT Code CacheBeachte, dass die Meldung nicht den Garbage Collector nennt, sondern die Option UseCondCardMark, die G1 automatisch einschaltet und der Serial GC nicht.
Mit -XX:AOTMode=required bricht die JVM dagegen ab, wenn sie den Cache nicht vollständig nutzen kann. Den Wert required gibt es seit Java 27; vorher hieß er on. Die letzten beiden Zeilen der Ausgabe lauten dann:
Error occurred during initialization of VM
Unable to use AOT Code Cache.
Davor nennt die JVM in einer Fehlerzeile denselben Grund wie oben.
Mit ZGC trifft es den ganzen Cache, nicht nur den AOT-Code. Startest du das Programm mit dem unter G1 erzeugten Cache und -XX:+UseZGC, meldet die JVM „Unable to use AOT cache.“ und als Grund „The saved state of UseCompressedOops (1) is different from runtime (0)“. G1 hat den Cache mit Compressed Oops erzeugt, ZGC arbeitet ohne. Das Programm läuft dann ganz ohne Cache. Erzeugst du den Cache mit ZGC, lädt die JVM unter ZGC auch den AOT-Code.
Meine Empfehlung: Erzeuge den Cache mit demselben Garbage Collector und auf Rechnern mit denselben CPU-Features, auf denen die Anwendung produktiv läuft. Und starte die Anwendung nach jedem Deployment einmal mit -XX:AOTMode=required, etwa in einem Smoke-Test – so fällt ein unbrauchbarer AOT-Code auf, bevor er in Produktion nur Startzeit kostet.
Willst du den AOT-Code bewusst abschalten, z. B. um seinen Effekt in Produktion zu messen, startest du die Anwendung mit -XX:+UnlockDiagnosticVMOptions -XX:-AOTCodeCaching. Die geladenen und gelinkten Klassen und die Profildaten aus dem Cache verwendet die JVM dann weiter.
Und was ist mit GraalVM Native Image und jaotc?
Vorab kompilierten Code gab es für Java schon vor JEP 544, in zwei anderen Formen:
- GraalVM Native Image kompiliert beim Build alle erreichbaren Teile einer Anwendung zusammen mit Teilen der Java-Laufzeitumgebung in eine ausführbare Datei. Danach kann die Anwendung keine Klassen nachladen – die GraalVM-Dokumentation nennt das die Closed-World-Annahme. Klassen und Methoden, auf die per Reflection zugegriffen wird, müssen beim Build in Metadaten angegeben sein, wenn die statische Analyse sie nicht findet.
- Das Werkzeug
jaotckam mit Java 9 (JEP 295) und kompilierte Klassen vorab in eine native Bibliothek. Es war experimentell, auf Linux/x64 beschränkt und wurde mit Java 17 (JEP 410) wieder entfernt.
JEP 544 geht einen anderen Weg. Der AOT-Code ist nur ein Vorsprung: HotSpot lädt Klassen weiterhin dynamisch, interpretiert, profiliert und kompiliert neu, wo der AOT-Code nicht passt. Laut JEP muss dafür weder der Code der Anwendung noch der der Libraries und Frameworks geändert werden. Eine eigenständige ausführbare Datei entsteht dabei nicht: Die Anwendung braucht weiterhin eine JVM, und der Cache muss durch einen Trainingslauf erzeugt werden.
Fazit
Mit Java 28 legt der AOT-Cache neben Klassen und Profilen auch Maschinencode ab, den C1 und C2 beim Erzeugen des Caches kompilieren. An meinem Beispielprogramm, das in jeder Runde 50 Quelldateien kompiliert, dauert die erste Runde damit 252 statt 527 Millisekunden, und auch in den folgenden Runden bis Runde 10 ist es mit AOT-Code schneller als ohne Cache.
Nutzt du den AOT-Cache schon, bekommst du den AOT-Code mit Java 28 ohne ein zusätzliches Kommando. Er kostet allerdings Platz und Zeit beim Erzeugen: Der Cache meines Beispielprogramms wächst von 38 auf 87 bis 88 MB, und Trainingslauf und Cache-Erzeugung dauern 8 statt 4 Sekunden.
Der AOT-Code bleibt ein Vorsprung beim Start. HotSpot ersetzt ihn durch JIT-Code, sobald eine Methode oft genug aufgerufen wurde – in meiner Messung 889 von 1.625 C2-Methoden binnen 40 Runden. Während dieses Austauschs ist das Programm vorübergehend langsamer als mit einem Cache ohne AOT-Code.
Erzeuge den Cache mit demselben Garbage Collector und auf Rechnern mit denselben CPU-Features wie in Produktion. Passt eines davon nicht, verwirft die JVM den AOT-Code, ohne das zu melden. Starte die Anwendung deshalb nach jedem Deployment einmal mit -XX:AOTMode=required – dann bricht die JVM in diesem Fall mit einer Fehlermeldung ab.
Konntest du etwas aus diesem Artikel mitnehmen? Mit einer Bewertung auf meinem ProvenExpert-Profil hilfst du anderen Entwickler:innen einzuschätzen, ob sich das Lesen lohnt – und mir zu verstehen, welche Inhalte dir weiterhelfen.