Seit 2014 arbeitet das JDK-Team an Project Valhalla. Mit Java 28 kommt der erste Teil als Preview ins JDK: Value Objects – Objekte ohne Identität, die allein durch die Werte ihrer Felder bestimmt sind.
Für deinen Code heißt das – vorerst nur mit aktivierten Preview-Features – zweierlei. Erstens vergleicht == zwei Value Objects anhand ihrer Felder: Integer 1996 ist dann immer == Integer 1996. Zweitens darf die JVM Value Objects flach im Speicher ablegen, statt über einen Pointer auf ein eigenes Objekt zuzugreifen. Eine Million LocalDates belegen dann 8 statt 20 MB Heap.
Ganz umsonst ist das nicht: Ein Value Object, das die JVM nicht flach ablegen kann, belegt oft mehr Speicher als ein gewöhnliches Objekt und macht Schleifen langsamer. Wann das passiert, lässt sich an der JVM ablesen. Das zeige ich dir in diesem Artikel.
In diesem Artikel erfährst du:
- Was Project Valhalla ist und wie du Value Objects heute schon ausprobieren kannst
- Welche 30 Klassen des JDK zu Value Classes werden und wie du eigene deklarierst
- Wie sich
==undequals()bei Value Objects unterscheiden - Was ohne Identität nicht mehr geht – von
synchronizedbis Serialisierung - Welche Regeln für Konstruktoren gelten und warum
- Wie die JVM Value Objects umsetzt: Flattening, Null-Marker, Scalarization, der Objekt-Header und
== - Wie viel Speicher und Laufzeit Value Objects sparen – und wann sie mehr kosten
- Was du prüfen solltest, bevor du eigene Klassen umstellst
Alle Beispielprogramme findest du im GitHub-Repository project-valhalla.
Was ist Project Valhalla?
Project Valhalla ist ein OpenJDK-Projekt, das das Objektmodell von Java um Value Objects erweitert. Das Ziel ist, die Abstraktion von Klassen – Namen, Methoden, Validierung im Konstruktor – mit der Performance primitiver Typen wie int und long zusammenzubringen.
Die JDK-Entwickler:innen liefern Valhalla nicht in einem Stück, sondern Schritt für Schritt über mehrere Java-Versionen. Die Projektseite nennt derzeit fünf Feature-Sets; das erste sind die Value Objects. Dazu gehören zwei JDK Enhancement Proposals (JEPs), die beide bereits in Java 28 integriert sind:
- JEP 401: Value Objects (Preview) führt Value Classes in Sprache und JVM ein.
- JEP 539: Strict Field Initialization in the JVM (Preview) sorgt dafür, dass niemand ein Feld eines Value Objects vor seiner Zuweisung lesen kann.
Java 28 soll im März 2027 erscheinen. Was danach kommt, steht im Abschnitt Wie es mit Valhalla weitergeht.
Value Objects ausprobieren
Value Objects sind ein Preview-Feature und deshalb standardmäßig deaktiviert. Du brauchst einen Early-Access-Build von Java 28 (jdk.java.net/28) und musst die Preview-Features beim Kompilieren und beim Starten einschalten:
javac --release 28 --enable-preview Main.java
java --enable-preview Main
Du kannst ein Programm auch ohne vorheriges Kompilieren direkt aus dem Quellcode starten:
java --enable-preview Main.javaUnd die JShell startest du mit jshell --enable-preview.
Alle Ausgaben in diesem Artikel stammen vom Early-Access-Build 28-ea+23. Bis zum Release kann sich noch einiges ändern – vor allem die Speicher-Layouts und die Diagnose-Optionen der JVM, die ich ab dem Abschnitt Wie die JVM Value Objects umsetzt verwende.
Warum Objekte ohne Identität?
Jedes Java-Objekt hat eine Identität: Zwei Objekte mit denselben Feldwerten sind trotzdem zwei verschiedene Objekte. Der ==-Operator vergleicht bei Objekten nicht den Inhalt, sondern die Identität.
Das folgende Programm vergleicht zwei Integer-Objekte mit dem Wert 1996 und zwei LocalDate-Objekte für den 9. März 2027:
void main() {
  Integer i = 1996, j = 1996;
  IO.println("i == j: " + (i == j));

  LocalDate d1 = LocalDate.of(2027, 3, 9);
  LocalDate d2 = d1.plusYears(1).minusYears(1);
  IO.println("d1 == d2: " + (d1 == d2));
  IO.println("d1.equals(d2): " + d1.equals(d2));
}
Vor Java 28 oder in Java 28 ohne aktivierte Preview-Features gibt das Programm Folgendes aus:
i == j: false
d1 == d2: false
d1.equals(d2): true
Die beiden Integer-Objekte i und j sind verschiedene Objekte, denn Integer.valueOf() hält nur die Werte von -128 bis 127 in einem Cache und liefert ansonsten ein neu erzeugtes Integer-Objekt zurück. Und d1.plusYears(1).minusYears(1) erzeugt ein neues LocalDate, auch wenn es dasselbe Datum darstellt wie d1. Nur equals() sagt, dass beide Daten gleich sind.
Bei veränderlichen Objekten brauchst du die Identität. Zwei leere ArrayLists sind zwar gleich, aber fügst du der einen ein Element hinzu, darf die andere leer bleiben. Bei unveränderlichen Werten wie einer Zahl oder einem Datum gibt es dagegen keinen Grund, zwei Objekte mit demselben Inhalt zu unterscheiden.
Die Identität kostet außerdem Speicher und Zeit. Die JVM muss jedes Objekt auf dem Heap anlegen, mit einem eigenen Header, und greift über einen Pointer darauf zu. Ein LocalDate z. B. besteht aus 6 Bytes Daten – einem int für das Jahr und je einem byte für Monat und Tag. Auf dem Heap belegt es aber 16 Bytes, und das Array, das darauf zeigt, noch einmal 4 Bytes pro Element.
Die folgende Grafik zeigt links ein Array mit Pointern auf einzelne Objekte, rechts dasselbe Array, in dem die Daten direkt in den Elementen stehen:
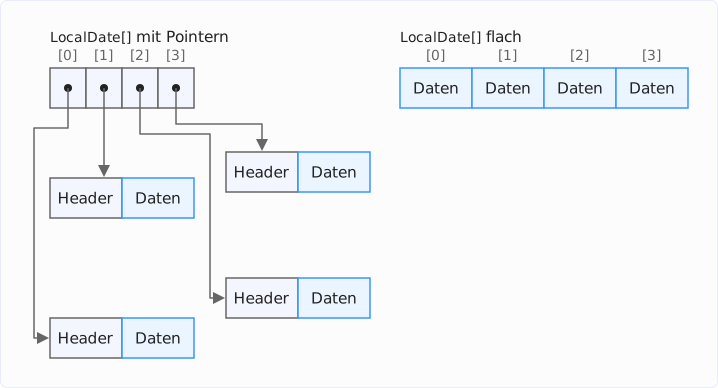
Durchläuft ein Programm das linke Array, muss die CPU für jedes Element dem Pointer folgen. Liegen die Objekte verstreut im Speicher, muss sie dabei für fast jedes Element eine eigene Cache-Line aus dem Hauptspeicher laden. Im rechten Array liegen die Daten dagegen hintereinander. Array und Daten belegen so zusammen deutlich weniger Speicher, und weil die CPU den Speicher sequenziell liest, durchläuft sie das Array wesentlich schneller als die verstreuten Objekte.
Value Objects machen den Weg frei für das rechte Array: Weil sie keine Identität haben, darf die JVM ihre Daten direkt in die Array-Elemente kopieren.
Integer, LocalDate und 28 weitere JDK-Klassen werden Value Classes
Eine Value Class ist eine Klasse, deren Instanzen keine Identität haben. Diese Instanzen heißen Value Objects. Alle anderen Klassen heißen ab jetzt Identity Classes, ihre Instanzen Identity Objects.
Mit aktivierten Preview-Features sind 30 Klassen des JDK Value Classes:
| Package | Klassen |
|---|---|
java.lang | Integer, Long, Float, Double, Byte, Short, Character, Boolean, Number, Record |
java.util | Optional, OptionalInt, OptionalLong, OptionalDouble |
java.time | LocalDate, LocalTime, LocalDateTime, ZonedDateTime, OffsetTime, OffsetDateTime, Duration, Instant, Period, Year, YearMonth, MonthDay |
java.time.chrono | MinguoDate, HijrahDate, JapaneseDate, ThaiBuddhistDate |
Number und Record sind abstrakte Value Classes – was das bedeutet, erkläre ich im Abschnitt Vererbung: abstrakte Value Classes.
Startest du das Programm aus dem vorigen Abschnitt unter Java 28 mit --enable-preview, gibt es Folgendes aus:
i == j: true
d1 == d2: true
d1.equals(d2): true
Jetzt sind auch die beiden ==-Vergleiche true, ohne dass du eine Zeile am Code geändert hast. Du musst das Programm allerdings mit aktivierten Preview-Features kompilieren und dann auch mit ihnen starten. Kompilierst du ohne --enable-preview, verwendet der Compiler die bisherigen Identity Classes, und der Code verhält sich wie in Java 27.
Ob ein Objekt eine Identität hat, prüft die neue Methode Objects.hasIdentity():
void main() {
  IO.println("Integer:   " + Objects.hasIdentity(1996));
  IO.println("LocalDate: " + Objects.hasIdentity(LocalDate.of(2027, 3, 9)));
  IO.println("Optional:  " + Objects.hasIdentity(Optional.of("Duke")));
  IO.println("String:    " + Objects.hasIdentity("Duke"));
  IO.println("ArrayList: " + Objects.hasIdentity(new ArrayList<String>()));
}
Mit --enable-preview gibt das Programm aus:
Integer:   false
LocalDate: false
Optional:  false
String:    true
ArrayList: true
String ist – wie du am Beispiel "Duke" siehst – keine Value Class. Laut JEP 401 hängen API und Implementierung von String an der Objektidentität. Die neue Methode Objects.requireIdentity() wirft eine IdentityException, wenn ein Objekt keine Identität hat.
Vorbereitet seit Java 9
Diese 30 Klassen sind nicht zufällig gewählt. Die konkreten Klassen unter ihnen nennt das Javadoc schon lange value-based und rät davon ab, sich auf die Identität ihrer Instanzen zu verlassen. Die Konstruktoren der Wrapper-Klassen wie new Integer(int) sind seit Java 9 deprecated. Und seit Java 16 warnt der Compiler, wenn du auf eine Instanz einer value-based Klasse synchronisierst (JEP 390).
Wer die Wrapper-Konstruktoren trotzdem verwendet, bekommt mit Valhalla ein anderes Ergebnis. Das folgende Programm vergleicht zwei per Konstruktor erzeugte Integer-Objekte:
void main() {
  Integer a = new Integer(1996);
  Integer b = new Integer(1996);
  IO.println(a == b);
}
Ohne Preview-Features gibt es false aus, mit --enable-preview dagegen true. Laut Javadoc erzeugt der Konstruktor ein „newly allocated Integer object“ – also ein neues Objekt, das sich von allen bisherigen unterscheidet – selbst von Integer-Objekten mit dem gleichen Wert. Bei einer Value Class gibt es ein solches Objekt mit eigener Identität nicht: Ein new liefert ein Value Object, und der Vergleich zweier Value Objects mit denselben Feldwerten per == ergibt true.
Eigene Value Classes deklarieren
Eine eigene Value Class deklarierst du mit dem neuen Modifier value. Er passt zu jeder Klasse, deren Instanzen zwei Bedingungen erfüllen:
- Unveränderlich: Der Wert einer Instanz ändert sich nach dem Erzeugen nicht mehr.
- Austauschbar: Zwei getrennt erzeugte Instanzen mit demselben Wert müssen nicht unterscheidbar sein.
Records erfüllen beide Bedingungen von Haus aus und eignen sich deshalb besonders gut:
value record Point(int x, int y) {}Eine konkrete Value Class ist implizit final, und auch alle ihre Felder sind implizit final. Versucht eine Methode, ein Feld zu ändern, lehnt der Compiler das ab:
value class Counter {
  private int count;

  void increment() {
    count++;
  }
}
error: cannot assign a value to final variable countNicht jede unveränderliche Klasse passt als Record. Die folgende Klasse Money speichert einen Geldbetrag intern als Cent-Betrag in einem einzigen long, nach außen bietet sie aber Euro und Cent getrennt an – der interne Cent-Betrag ist nicht sichtbar. Ein Record müsste seine Felder so offenlegen, wie sie gespeichert sind – eine Value Class nicht.
Die Klasse Money steht in einer eigenen Datei Money.java:
value class Money {
  private long cents;

  Money(long euros, int cents) {
    this.cents = euros * 100 + cents;
  }

  long euros() { return cents / 100; }
  int cents() { return (int) (cents % 100); }

  @Override
  public String toString() {
    return "%d,%02d €".formatted(euros(), cents());
  }
}
Das folgende Programm MoneyDemo.java legt zwei Money-Objekte mit demselben Betrag an, vergleicht sie mit == und prüft, ob sie eine Identität haben:
void main() {
  Money a = new Money(12, 34);
  Money b = new Money(12, 34);
  IO.println(a + " == " + b + ": " + (a == b));
  IO.println(Objects.hasIdentity(a));
}
Liegen beide Dateien im selben Verzeichnis, startest du das Programm mit java --enable-preview MoneyDemo.java – der Source Launcher findet Money.java selbst. Die Ausgabe:
12,34 € == 12,34 €: true
falseDie Felder einer Value Class dürfen auf Identity Objects zeigen. Der folgende Record Person speichert einen String – ein Identity Object – und ein LocalDate:
value record Person(String name, LocalDate birthday) {}Person bleibt trotzdem eine Value Class: Unveränderlich muss das Feld sein, nicht das Objekt, auf das es zeigt. Was das für den ==-Vergleich bedeutet, zeigt der nächste Abschnitt.
== und equals() bei Value Objects
Für Identity Objects prüft == weiterhin, ob zwei Referenzen auf dasselbe Objekt – also auf dieselbe Speicheradresse – zeigen. Für Value Objects prüft ==, ob die beiden Objekte ununterscheidbar sind. Das sind sie, wenn drei Bedingungen erfüllt sind:
- Beide sind Instanzen derselben Value Class.
- Ihre Felder primitiver Typen haben dieselben Bitmuster.
- Ihre Referenzfelder sind ununterscheidbar – geprüft wieder mit
==.
Die dritte Bedingung macht den Vergleich rekursiv. Zeigt ein Feld auf ein Value Object, entscheidet dessen Wert. Zeigt ein Feld auf ein Identity Object, entscheidet dessen Identität – also die Adresse im Speicher. Das folgende Programm legt drei Person-Objekte an – zwei mit dem String-Literal "Duke" und eines mit einem per new String() erzeugten String:
value record Person(String name, LocalDate birthday) {}

void main() {
  Person p1 = new Person("Duke", LocalDate.of(1995, 5, 23));
  Person p2 = new Person("Duke", LocalDate.of(1995, 5, 23));
  Person p3 = new Person(new String("Duke"), LocalDate.of(1995, 5, 23));
  IO.println("p1 == p2: " + (p1 == p2));
  IO.println("p1 == p3: " + (p1 == p3));
  IO.println("p1.equals(p3): " + p1.equals(p3));
}
Die Ausgabe:
p1 == p2: true
p1 == p3: false
p1.equals(p3): true
p1 == p2 ist true, weil beide String-Literale "Duke" auf dasselbe String-Objekt im String-Pool zeigen und die zwei LocalDate-Value-Objekte wertgleich sind. p1 == p3 ist false, weil new String() ein neues String-Objekt mit eigener Identität erzeugt. Für equals() sind alle drei gleich, denn equals() eines Records vergleicht die Felder mit equals().
Zwei weitere Fälle, in denen == und equals() auseinanderlaufen, zeigen die nächsten beiden Abschnitte. Danach geht es darum, was ein rekursiver Vergleich kostet, und um die Methoden, die eine Value Class von Object erbt.
Eigene equals()-Methode
Hat eine Value Class eine eigene equals()-Methode, können zwei Objekte laut equals() gleich sein, obwohl ihre Felder verschiedene Werte haben – == ergibt dann false. Die folgende Klasse Fraction speichert einen Bruch ungekürzt, betrachtet aber 1/2 und 2/4 als gleich:
value class Fraction {
  private int numerator;
  private int denominator;

  Fraction(int numerator, int denominator) {
    this.numerator = numerator;
    this.denominator = denominator;
  }

  @Override
  public boolean equals(Object o) {
    return o instanceof Fraction f
        && (long) numerator * f.denominator == (long) f.numerator * denominator;
  }

  @Override
  public int hashCode() {
    return Double.hashCode((double) numerator / denominator);
  }
}
Das Programm FractionDemo.java vergleicht 1/2 und 2/4 auf beide Arten:
void main() {
  Fraction half = new Fraction(1, 2);
  Fraction twoQuarters = new Fraction(2, 4);
  IO.println("half.equals(twoQuarters): " + half.equals(twoQuarters));
  IO.println("half == twoQuarters: " + (half == twoQuarters));
}
half.equals(twoQuarters): true
half == twoQuarters: false== vergleicht die Felder, also 1 mit 2 und 2 mit 4. equals() vergleicht den Wert, den die Felder darstellen.
NaN-Werte
Für float und double gibt es viele verschiedene Bitmuster, die alle „Not a Number“ (NaN) bedeuten. Das folgende Programm speichert zwei davon in je einem Measurement-Record:
value record Measurement(double value) {}

void main() {
  double nan1 = Double.longBitsToDouble(0x7ff8000000000000L);
  double nan2 = Double.longBitsToDouble(0x7ff8000000000001L);
  Measurement m1 = new Measurement(nan1);
  Measurement m2 = new Measurement(nan2);
  IO.println(m1 + " / " + m2);
  IO.println("m1.equals(m2): " + m1.equals(m2));
  IO.println("m1 == m2: " + (m1 == m2));
}
Measurement[value=NaN] / Measurement[value=NaN]
m1.equals(m2): true
m1 == m2: falseDas equals() eines Records behandelt alle NaN-Werte als gleich. == vergleicht dagegen die Bitmuster, und die unterscheiden sich im letzten Bit.
Tief verschachtelte Objekte
Weil == Referenzfelder rekursiv vergleicht, kann ein einzelner Vergleich beliebig lange dauern. Das folgende Programm baut zwei verkettete Listen aus je 100.000 Node-Objekten auf und vergleicht deren Köpfe:
value record Node(int value, Node next) {}

void main() {
  Node a = null;
  Node b = null;
  for (int i = 0; i < 100_000; i++) {
    a = new Node(i, a);
    b = new Node(i, b);
  }
  IO.println(a == b);
}
Der Vergleich steigt für jedes Element eine Ebene tiefer und endet in einem StackOverflowError:
Exception in thread "main" java.lang.StackOverflowError
    at java.base/java.lang.runtime.ValueObjectMethods.isSubstitutable(...)
    at java.base/java.lang.runtime.ValueObjectMethods.isSubstitutable(...)
    ...
Eine Endlosschleife kann es dabei nicht geben: Die Konstruktorregeln, die ich im Abschnitt Initialisierer und eine Folge für == erkläre, verhindern, dass zwei Value Objects aufeinander zeigen.
Die geerbten Methoden von Object
Überschreibt eine Value Class equals(), hashCode() und toString() nicht, erbt sie die Methoden von Object. Für Value Objects arbeiten diese aber mit den Feldwerten statt mit der Identität:
equals()vergleicht mit==.hashCode()berechnet einen Hash aus der Klasse und den Feldwerten. Denselben Wert liefertSystem.identityHashCode().toString()liefert wie bisher Klassenname und Hash, z. B.Pixel@50287055.
Die folgende Klasse Pixel überschreibt keine der drei Methoden:
value class Pixel {
  private int x;
  private int y;

  Pixel(int x, int y) {
    this.x = x;
    this.y = y;
  }
}
Das Programm PixelDemo.java vergleicht zwei gleiche und ein anderes Pixel und gibt Hash-Werte und toString() aus:
void main() {
  Pixel p1 = new Pixel(17, 3);
  Pixel p2 = new Pixel(17, 3);
  Pixel p3 = new Pixel(3, 17);
  IO.println("p1.equals(p2):        " + p1.equals(p2));
  IO.println("p1.equals(p3):        " + p1.equals(p3));
  IO.println("p1.hashCode():        " + p1.hashCode());
  IO.println("p2.hashCode():        " + p2.hashCode());
  IO.println("p3.hashCode():        " + p3.hashCode());
  IO.println("identityHashCode(p1): " + System.identityHashCode(p1));
  IO.println("p1.toString():        " + p1);
}
p1.equals(p2): true
p1.equals(p3): false
p1.hashCode(): 1344827477
p2.hashCode(): 1344827477
p3.hashCode(): 1344827057
identityHashCode(p1): 1344827477
p1.toString(): Pixel@50287055Die JVM berechnet den Hash in ValueObjectMethods.valueObjectHashCode(): Sie beginnt mit dem Identity-Hash der Klasse und verrechnet dann die Bits jedes Feldes, bei Referenzfeldern deren Identity-Hash. Innerhalb eines Programmlaufs haben ununterscheidbare Value Objects deshalb immer denselben Hash. In einem anderen Lauf kann er anders ausfallen, weil sich der Identity-Hash der Klasse ändern kann.
Für Value Records gilt das alles nicht. Ein Record bringt wie bisher eigene Implementierungen der drei Methoden mit:
equals()vergleicht die Komponenten paarweise – Referenzen mitObjects.equals(), primitive Werte mit dercompare()-Methode ihrer Wrapper-Klasse.hashCode()kombiniert die Hashes der Komponenten.toString()gibt den Namen des Records und seine Komponenten aus, z. B.Point[x=1, y=2].
Für den Vergleich zweier Werte bleibt equals() die richtige Methode. == sagt nur, ob zwei Value Objects ununterscheidbar sind – nicht, ob sie denselben Wert darstellen. Wie die JVM diesen Vergleich ausführt, zeige ich im Abschnitt Wie die JVM == ausführt.
Was ohne Identität nicht mehr geht
Einige Operationen brauchen die Identität eines Objekts. Auf Value Objects lehnt der Compiler sie ab, oder die JVM wirft zur Laufzeit eine Exception.
Dazu gehört synchronized. Das folgende Programm versucht, auf ein LocalDate zu synchronisieren:
void main() {
  LocalDate date = LocalDate.of(2027, 3, 9);
  synchronized (date) {
    IO.println("locked");
  }
}
Der Compiler lehnt das ab:
error: unexpected type
  synchronized (date) {
  ^
  required: identity class
  found:    LocalDate
Ist die Variable dagegen vom Typ Object, kann der Compiler nicht wissen, worauf sie zur Laufzeit zeigt. Das folgende Programm probiert vier Operationen, die eine Identität brauchen, über eine Object-Variable aus:
import java.lang.ref.WeakReference;

void main() {
  Object date = LocalDate.of(2027, 3, 9);

  try {
    synchronized (date) {
      IO.println("locked");
    }
  } catch (IdentityException e) {
    IO.println(e);
  }

  try {
    date.notify();
  } catch (IllegalMonitorStateException e) {
    IO.println(e);
  }

  try {
    new WeakReference<>(date);
  } catch (IdentityException e) {
    IO.println(e);
  }

  try {
    new WeakHashMap<Object, String>().put(date, "Release");
  } catch (IdentityException e) {
    IO.println(e);
  }
}
Die Ausgabe:
java.lang.IdentityException: Cannot synchronize on an instance of value class java.time.LocalDate
java.lang.IllegalMonitorStateException: current thread is not owner
java.lang.IdentityException: java.time.LocalDate is not an identity class
java.lang.IdentityException: java.time.LocalDate is not an identity class
wait() und notify() setzen voraus, dass der aktuelle Thread das Objekt gesperrt hat. Da das bei einem Value Object nie der Fall sein kann, schlagen sie immer fehl. Eine WeakReference und alle anderen Referenztypen aus java.lang.ref hängen an der Identität – und damit auch die WeakHashMap, die ihre Schlüssel in WeakReferences hält.
Ist der Typ bekannt, warnt der Compiler bei den Referenztypen schon beim Kompilieren:
import java.lang.ref.WeakReference;

void main() {
  LocalDate date = LocalDate.of(2027, 3, 9);
  WeakReference<LocalDate> ref = new WeakReference<>(date);
  IO.println(ref.get());
}
warning: [identity] use of a value-based class with an operation that expects reliable identityDiese Warnung erscheint auch ohne --enable-preview, denn sie gilt für alle value-based Klassen.
Zwei weitere Methoden von Object ändern ihr Verhalten für Value Objects:
finalize(): Laut JEP 401 ruft der Garbage Collectorfinalize()für Value Objects nie auf, und der Compiler warnt, wenn eine Value Class die Methode überschreibt. Im Build 28-ea+23 ist das sogar ein Fehler: „value classes cannot have finalize methods“.clone(): Eine geklonte Kopie ist vom Original nicht zu unterscheiden,copy == originalist alsotrue. Die übliche Erwartungx.clone() != xgilt nicht mehr.
Die folgende Tabelle fasst zusammen, ob der Compiler eine Operation ablehnt oder vor ihr warnt, wenn der Typ der Variablen eine Value Class ist, und was zur Laufzeit passiert:
| Operation | beim Kompilieren | zur Laufzeit |
|---|---|---|
synchronized | Fehler | IdentityException |
wait(), notify() | keine Meldung | IllegalMonitorStateException |
WeakReference, SoftReference, PhantomReference | Warnung | IdentityException |
WeakHashMap.put() | Warnung | IdentityException |
finalize() überschreiben | Fehler | – (kompiliert nicht) |
clone() | keine Meldung | Kopie ist == Original |
Vererbung: abstrakte Value Classes
Eine konkrete Value Class ist implizit final, keine andere Klasse kann von ihr erben. Soll eine Value Class Unterklassen haben, deklarierst du sie als abstrakte Value Class. Eine abstract value class braucht selbst keine Identität und lässt ihren Unterklassen die Wahl: Von ihr dürfen sowohl Value Classes als auch Identity Classes erben.
Ein Beispiel aus dem JDK ist Number. Mit Preview-Features ist Number eine abstrakte Value Class. Integer erbt davon als Value Class, BigInteger als Identity Class:
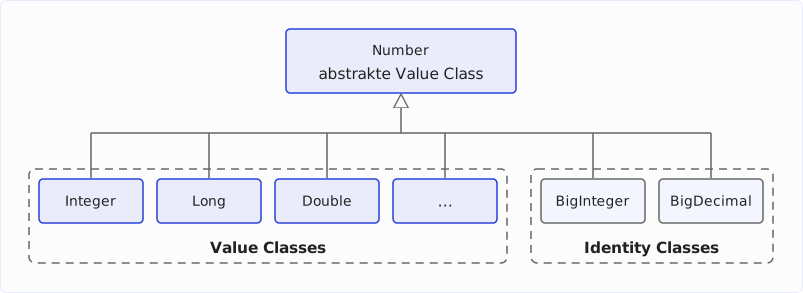
Das folgende Programm weist einer Variablen vom Typ Number nacheinander ein Integer und ein BigInteger zu:
import java.math.BigInteger;

void main() {
  Number n = 1996;
  IO.println(n.getClass().getSimpleName() + ": " + Objects.hasIdentity(n));
  n = BigInteger.valueOf(1996);
  IO.println(n.getClass().getSimpleName() + ": " + Objects.hasIdentity(n));
}
Integer: false
BigInteger: trueEine Value Class darf nur von Object oder von einer abstrakten Value Class erben. Eine konkrete Value Class kommt als Oberklasse nicht infrage, weil sie implizit final ist. Eine Identity Class scheidet aus, weil ihr Code auf Identität angewiesen sein darf: Sie darf veränderliche Felder und synchronized-Methoden haben. In einer abstrakten Value Class lehnt der Compiler beides ab – der Modifier value garantiert also, dass auch der geerbte Code ohne Identität auskommt.
Versuchst du trotzdem, eine Value Class von einer Identity Class erben zu lassen, meldet der Compiler einen Fehler:
import java.util.ArrayList;

value class Stack extends ArrayList<String> {}
error: The identity type ArrayList<String> cannot be a supertype of the value type StackObject ist dabei die Ausnahme: Es ist weder abstrakt noch eine Value Class, und new Object() erzeugt ein Identity Object – trotzdem erben alle Value Classes davon. Das ist möglich, weil Object weder Felder noch synchronized-Methoden hat. Seine Methoden equals() und hashCode() arbeiten bei Value Objects mit den Feldwerten statt mit der Identität, wie im Abschnitt Die geerbten Methoden von Object beschrieben.
Abstrakte Value Classes lassen sich auch versiegeln. Die folgende Hierarchie erlaubt genau zwei Unterklassen von Shape:
sealed abstract value class Shape permits Circle, Square {
  abstract double area();
}
value class Circle extends Shape {
private double radius;
Circle(double radius) {
this.radius = radius;
}
@Override
double area() { return Math.PI * radius * radius; }
}value class Square extends Shape {
private double side;
Square(double side) {
this.side = side;
}
@Override
double area() { return side * side; }
}Value Classes können außerdem Interfaces implementieren. Eine Variable vom Typ Comparable<?> kann deshalb auf Value Objects und auf Identity Objects zeigen. Value Interfaces gibt es nicht: Ein value interface lehnt der Compiler ab. Jedes Interface kann sowohl von Value Classes als auch von Identity Classes implementiert werden.
Konstruktoren: erst die Felder, dann super()
Ein Value Object darf nie halb initialisiert sichtbar werden. Sonst könnte ein Programm dasselbe Objekt einmal mit dem Default-Wert eines Feldes und einmal mit dessen endgültigem Wert sehen – und zwei Zustände widersprechen der Idee, dass ein Value Object nur durch seine Feldwerte bestimmt ist.
Ein Objekt, dessen Konstruktor noch läuft, heißt im JEP larval (im Larvenstadium): Es existiert schon, ist aber noch nicht fertig. In einer Identity Class ruft ein Konstruktor üblicherweise zuerst den Konstruktor der Oberklasse auf – steht kein super(…) im Code, setzt der Compiler ein super() an den Anfang. Erst danach setzt er die eigenen Felder. Gibt der Konstruktor der Oberklasse this weiter, sieht der Empfänger ein Objekt, dessen Felder teilweise noch ihre Default-Werte (null, 0, false) haben.
Early und Late Construction
Seit Java 25 gibt es die Flexible Constructor Bodies: Code darf vor dem super(…)-Aufruf stehen und Felder setzen. Damit hat die Initialisierung zwei Phasen:
- Early Construction: vor
super(…). Der Konstruktor darf Felder setzen, aberthisnicht verwenden – also keine Instanzmethoden aufrufen undthisnicht weitergeben. - Late Construction: nach
super(…). Jetzt istthisfreigegeben.
Ein Konstruktor kann seine Felder also auf zwei Arten setzen – nach dem super()-Aufruf in der Late Construction oder davor in der Early Construction:
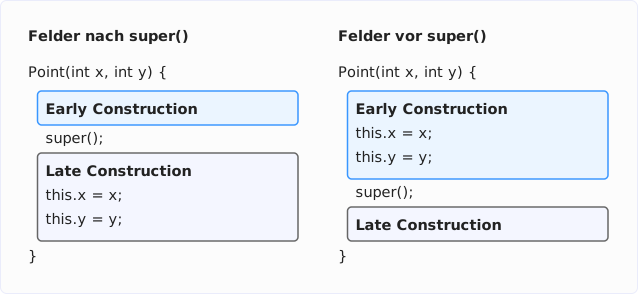
In einer Identity Class war vor den Flexible Constructor Bodies, also bis Java 24, nur die linke Variante möglich – die fehleranfällige, weil die Oberklasse this weitergeben kann, bevor die Felder gesetzt sind. Seit Java 25 ist auch die rechte Variante möglich. Erzwingen lässt sie sich bei Identity Classes nicht: Bestehender Code, der seine Felder nach super() setzt, muss weiter kompilieren.
Value Classes sind neu, für sie gibt es keinen solchen Bestand. Bei ihnen ist deshalb von Anfang an nur die rechte Variante möglich. Steht kein super() im Code, setzt der Compiler es ans Ende des Konstruktors – der gesamte Konstruktor läuft dann in der Early Construction.
Instanzmethoden im Konstruktor
Der folgende Konstruktor versucht, ein Feld über eine Instanzmethode zu berechnen:
import java.util.Locale;

value class UserName {
  private String name;
  private String normalized;

  UserName(String name) {
    this.name = name;
    this.normalized = normalize();
  }

  private String normalize() {
    return name.strip().toLowerCase(Locale.ROOT);
  }
}
In einer Identity Class wäre das kein Problem: Dort läuft der Aufruf von normalize() nach dem impliziten super(), also in der Late Construction. Im Konstruktor einer Value Class läuft dagegen jeder Code in der Early Construction, und dort sind Aufrufe von Instanzmethoden, wie oben beschrieben, nicht erlaubt. Der Compiler lehnt den Aufruf deshalb ab:
error: reference to normalize() may only appear after an explicit constructor invocationDie Lösung: Die Methode wird static und bekommt den Namen als Parameter. Braucht der Konstruktor this doch noch, setzt er super() selbst – nachdem alle Felder gesetzt sind:
import java.util.Locale;

value class UserName {
  private String name;
  private String normalized;

  UserName(String name) {
    this.name = name;
    this.normalized = normalize(name);
    super();
    IO.println("Created: " + this);
  }

  private static String normalize(String name) {
    return name.strip().toLowerCase(Locale.ROOT);
  }

  @Override
  public String toString() {
    return name + " (" + normalized + ")";
  }
}
Ein new UserName("Duke") gibt Created: Duke (duke) aus.
Warum lösen wir das Problem mit der nicht-statischen normalize()-Methode dann nicht einfach, indem wir super() an den Anfang schreiben? Die Antwort: Nach super() dürfte der Konstruktor zwar normalize() aufrufen – aber keine Felder mehr setzen. Der Compiler meldet dann:
error: strict field name is not initialized before the supertype constructor has been calledDer Grund ist die Strict Field Initialization, die ich im Abschnitt Strict Field Initialization in der JVM – JEP 539 erkläre.
Initialisierer und eine Folge für ==
Zwei weitere Regeln betreffen Initialisierungen außerhalb des Konstruktors:
- Ein Feld, dem du schon bei der Deklaration einen Wert zuweist (z. B.
private String currency = "EUR";), wird am Anfang des Konstruktors gesetzt, also in der Early Construction. Der Ausdruck rechts vom Gleichheitszeichen darf deshalb weder Instanzmethoden aufrufen nochthisverwenden. - Ein Instanz-Initialisierungsblock (
{ … }im Klassenrumpf) läuft dagegen erst in der Late Construction. Er darf deshalb zwar Instanzmethoden aufrufen undthisverwenden, aber keine Felder der Value Class setzen.
Dass der Konstruktor einer Value Class erst alle Felder setzt und erst danach this verwenden darf, hat eine indirekte Folge für den ==-Vergleich: Ein Konstruktor kann kein anderes Value Object erzeugen, ihm dabei this übergeben und es dann einem eigenen Feld zuweisen. Denn this ist erst nach super() verfügbar, und dann sind die Felder schon gesetzt. Zwei Value Objects können deshalb nie gegenseitig aufeinander zeigen, und der rekursive Vergleich aus dem Abschnitt == und equals() endet immer.
Inkompatible Änderung bei allen Records
Mit aktivierten Preview-Features gelten die Konstruktorregeln aus den vorigen Abschnitten für alle Records, auch für solche ohne value. Ein kanonischer Konstruktor – kompakt oder ausgeschrieben –, der this verwendet, kompiliert dann nicht mehr. Ein ausgeschriebener kanonischer Konstruktor kann this nur noch nach einem expliziten super() verwenden, das erst nach allen Feldzuweisungen stehen darf – und das ein Record-Konstruktor ohne --enable-preview gar nicht enthalten darf. In einem Compact Constructor ist super() auch mit Preview-Features nicht erlaubt – dort lässt sich this überhaupt nicht verwenden.
Der folgende Record Node übergibt this an eine Prüfmethode:
record Node(String label, List<Node> edges) {
  Node {
    requireNonNull(label, this);
    requireNonNull(edges, this);
  }

  static void requireNonNull(Object arg, Object owner) {
    if (arg == null) {
      throw new IllegalArgumentException("null argument for " + owner);
    }
  }
}

void main() {
  IO.println(new Node("A", List.of()));
}
Ohne Preview-Features gibt das Programm Node[label=A, edges=[]] aus. Mit --enable-preview meldet der Compiler zwei Fehler:
error: reference to this may only appear after an explicit constructor invocation
    requireNonNull(label, this);
                          ^
error: reference to this may only appear after an explicit constructor invocation
    requireNonNull(edges, this);
                          ^
Laut JEP kommt das selten vor, und meist ist ein solcher Zugriff ohnehin ein Bug: Wäre label im Beispiel null, würde die Fehlermeldung toString() auf einem Record aufrufen, dessen Felder noch nicht gesetzt sind.
Strict Field Initialization in der JVM – JEP 539
Die Regeln aus dem Abschnitt Konstruktoren: erst die Felder, dann super() – Felder vor super() setzen, this erst danach verwenden – prüft der Compiler. Das reicht nicht: Bytecode kann auch aus anderen Quellen kommen als aus javac. Deshalb führt JEP 539 in der JVM strikt initialisierte Felder ein. Ein solches Feld muss geschrieben werden, bevor es gelesen werden kann, und ein finales Feld darf nach dem ersten Lesen nicht mehr verändert werden. Bei Instanzfeldern prüft das schon die Bytecode-Verifikation.
Welche Felder strikt initialisiert werden, entscheidet der Compiler. javac markiert mit aktivierten Preview-Features die Felder aller Value Classes und aller Records mit dem neuen Flag ACC_STRICT_INIT. Für den Record Point aus dem Abschnitt Eigene Value Classes deklarieren zeigt javap -v -p Point.class:
  private final int x;
    descriptor: I
    flags: (0x0812) ACC_PRIVATE, ACC_FINAL, ACC_STRICT_INIT
Ein neues Schlüsselwort gibt es dafür nicht. Mehr zu JEP 539 steht im Artikel Java 28 Features.
Serialisierung und Deep Reflection
Strikt initialisierte Felder (JEP 539) kann nur ein Konstruktor setzen. Das trifft zwei Mechanismen, die Objekte bisher am Konstruktor vorbei befüllen.
Serialisierung
Die Serialisierung legt beim Deserialisieren ein Objekt an, ohne den Konstruktor der Klasse aufzurufen, und schreibt die Felder erst danach. Für Value Records funktioniert das Deserialisieren trotzdem, denn Records deserialisiert Java seit jeher über den kanonischen Konstruktor. Für andere Value Classes scheitert es.
Für das folgende Beispiel implementieren der Value Record Point und die Value Class Money – diesmal mit einem einzigen Konstruktorparameter für den Cent-Betrag – das Interface Serializable:
import java.io.Serializable;

value record Point(int x, int y) implements Serializable {}
import java.io.Serializable;
value class Money implements Serializable {
private long cents;
Money(long cents) {
this.cents = cents;
}
}Das Programm SerializeValues.java schreibt je ein Objekt in einen Byte-Stream und liest es wieder ein:
import java.io.*;

void main() throws IOException, ClassNotFoundException {
  IO.println(roundTrip(new Point(17, 3)));
  try {
    roundTrip(new Money(1234));
  } catch (InvalidClassException e) {
    IO.println(e);
  }
}

Object roundTrip(Object o) throws IOException, ClassNotFoundException {
  var bytes = new ByteArrayOutputStream();
  try (var out = new ObjectOutputStream(bytes)) {
    out.writeObject(o);
  }
  try (var in = new ObjectInputStream(
      new ByteArrayInputStream(bytes.toByteArray()))) {
    return in.readObject();
  }
}
Der Point kommt unverändert zurück, das Money-Objekt nicht:
Point[x=17, y=3]
java.io.InvalidClassException: Money; cannot serialize due to final value class or strictly-initialized instance fields
Mit -Xlint:serial warnt der Compiler schon vorher: „serializable value class does not declare, or inherits, a writeReplace method“. Die Lösung ist ein Stellvertreter-Objekt, ein sogenannter Serialization Proxy: writeReplace() schreibt statt des Value Objects einen Record, und dessen readResolve() erzeugt beim Einlesen über den Konstruktor ein neues Value Object:
import java.io.*;

value class Money implements Serializable {
  private long cents;

  Money(long cents) {
    this.cents = cents;
  }

  @Serial
  private Object writeReplace() {
    return new MoneyProxy(cents);
  }

  @Override
  public String toString() {
    return "%d,%02d €".formatted(cents / 100, cents % 100);
  }
}
import java.io.*;
record MoneyProxy(long cents) implements Serializable {
@Serial
private Object readResolve() {
return new Money(cents);
}
}Das Programm SerializeMoney.java schreibt ein Money-Objekt und liest es wieder ein:
import java.io.*;

void main() throws IOException, ClassNotFoundException {
  var bytes = new ByteArrayOutputStream();
  try (var out = new ObjectOutputStream(bytes)) {
    out.writeObject(new Money(1234));
  }
  try (var in = new ObjectInputStream(
      new ByteArrayInputStream(bytes.toByteArray()))) {
    Money money = (Money) in.readObject();
    IO.println(money + ", identity: " + Objects.hasIdentity(money));
  }
}
12,34 €, identity: falseDeep Reflection
Deep Reflection – das Ändern finaler Felder per Field.setAccessible(true) und Field.set() – funktioniert bei Value Objects gar nicht. Für das folgende Beispiel speichern zwei Klassen einen Cent-Betrag in einem Feld cents: IdentityMoney als gewöhnliche Klasse mit einem private final long cents, ValueMoney als Value Class. Das Programm ReflectValue.java versucht, bei beiden den Betrag zu ändern:
import java.lang.reflect.Field;

void main() throws ReflectiveOperationException {
  var identityMoney = new IdentityMoney(1234);
  Field field = IdentityMoney.class.getDeclaredField("cents");
  field.setAccessible(true);
  field.setLong(identityMoney, 9999);
  IO.println(identityMoney.cents());

  var valueMoney = new ValueMoney(1234);
  field = ValueMoney.class.getDeclaredField("cents");
  field.setAccessible(true);
  try {
    field.setLong(valueMoney, 9999);
  } catch (IllegalAccessException e) {
    IO.println(e);
  }
}
Gestartet mit --enable-final-field-mutation=ALL-UNNAMED, gibt das Programm aus:
9999
java.lang.IllegalAccessException: Can not set final long field ValueMoney.cents to (long)9999
Das finale Feld der Identity Class lässt sich ändern. Lässt du die Option --enable-final-field-mutation=ALL-UNNAMED weg, gibt die JVM dabei seit Java 26 eine Warnung aus (JEP 500). Das Feld der Value Class bleibt dagegen auch mit --enable-final-field-mutation unverändert. Bibliotheken, die Objekte per Deep Reflection befüllen, müssen Value Objects über ihre Konstruktoren erzeugen.
Wie die JVM Value Objects umsetzt
Weil ein Programm zwei Value Objects mit denselben Feldwerten nicht unterscheiden kann, darf die JVM sie frei im Speicher anordnen. JEP 401 legt nicht fest, wie sie das tut. Was der Build 28-ea+23 tut, lässt sich aber beobachten – und daraus ergeben sich Regeln für deine eigenen Value Classes.
Drei Formen eines Value Objects
Die JVM kennt drei Formen, in denen ein Value Object existieren kann:
- Auf dem Heap (buffered): als gewöhnliches Objekt mit Header, auf das ein Pointer zeigt.
- Flach (flattened): Die Felder stehen direkt im Feld eines anderen Objekts oder im Element eines Arrays – ohne eigenen Header, ohne Pointer.
- In Registern (scalarized): Der JIT-Compiler hält die Felder in Parametern, Rückgabewerten und lokalen Variablen in einzelnen CPU-Registern oder auf dem Stack.
Die folgende Grafik zeigt dasselbe LocalDate in allen drei Formen:
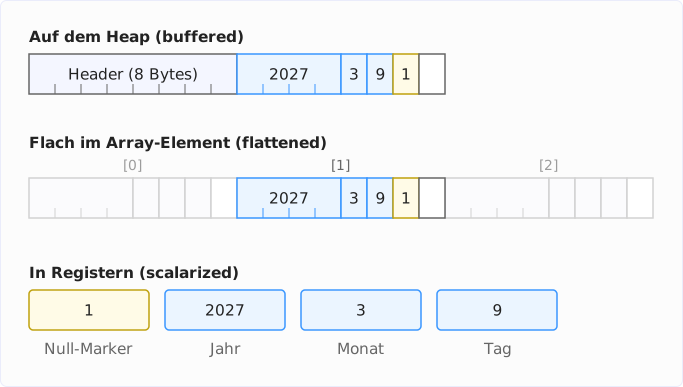
Für Java-Code macht es keinen Unterschied, in welcher Form ein Value Object vorliegt. Die JVM wandelt zwischen den Formen um, wann immer es nötig ist.
Flattening sichtbar machen
Welche Felder und Arrays die JVM flach anlegt, zeigen zwei Diagnose-Optionen:
java --enable-preview -Xshare:off -XX:+UnlockDiagnosticVMOptions \
     -XX:+PrintFieldLayout -XX:+PrintFlatArrayLayout Main.java
-XX:+PrintFieldLayout gibt für jede geladene Klasse das Layout ihrer Felder aus, -XX:+PrintFlatArrayLayout die Layouts der flachen Arrays. -Xshare:off ist nötig, damit auch die Klassen des JDK erscheinen. Sonst lädt die JVM sie fertig aus dem CDS-Archiv und gibt ihr Layout nicht aus.
Diagnose-Optionen sind zum Nachsehen da, nicht für die Produktion. Name und Ausgabe können sich mit jedem Build ändern.
Die Ausgabe für LocalDate
Für LocalDate gibt die JVM Folgendes aus (gekürzt auf die Instanzfelder und die Layouts):
Layout of class java/time/LocalDate
Instance fields:
 @0 RESERVED 8/-
 @8 REGULAR 4/4 "year" I
 @12 REGULAR 1/1 "month" B
 @13 REGULAR 1/1 "day" B
 @14 NULL_MARKER 1/1
Instance size = 16 bytes
BUFFERED layout: 8/8
NULL_FREE_NON_ATOMIC_FLAT layout: -/-
NULL_FREE_ATOMIC_FLAT layout: 8/8
NULLABLE_ATOMIC_FLAT layout: 8/8
NULLABLE_NON_ATOMIC_FLAT layout: 7/4
Null marker offset = 14
Die folgende Tabelle erklärt die Zeilen zum Objekt auf dem Heap. Unter Instance fields: steht je Zeile ein Feld mit Offset (@), Art, Größe/Ausrichtung in Bytes, Name und Typ:
| Zeile | Bedeutung |
|---|---|
@0 RESERVED 8/- | Der Objekt-Header, mit Compact Object Headers 8 Bytes groß. Er ist kein Feld und hat deshalb keine Ausrichtung. |
@8 REGULAR 4/4 "year" I | Das Feld year an Offset 8: 4 Bytes groß, an 4 Bytes ausgerichtet. I ist der Typdeskriptor der JVM für int. |
@12 REGULAR 1/1 "month" B | Das Feld month: 1 Byte vom Typ byte (B). |
@13 REGULAR 1/1 "day" B | Das Feld day, ebenfalls ein byte. |
@14 NULL_MARKER 1/1 | Ein Byte für den Null-Marker, den der Abschnitt Null-Marker und die 8-Byte-Grenze erklärt. Im Objekt auf dem Heap hat er keine Bedeutung, denn dieses ist nie null. Die JVM reserviert den Platz trotzdem, damit sie die Bytes ab Offset 8 am Stück in ein flaches Feld kopieren kann. |
Instance size = 16 bytes | Das Objekt auf dem Heap belegt 16 Bytes: 8 Bytes Header, 6 Bytes Felder, 1 Byte Null-Marker, 1 Byte Auffüllung. Die Auffüllung (Padding) entsteht, weil die JVM die Größe jedes Objekts auf ein Vielfaches von 8 Bytes aufrundet (-XX:ObjectAlignmentInBytes, Standardwert 8). |
Die flachen Layouts
Unter den Instanzfeldern listet die JVM die Layouts, die sie für LocalDate berechnet hat. Ein Layout legt fest, wie die Bytes eines LocalDate angeordnet sind und wie viel Platz sie belegen. BUFFERED ist das Layout der Daten im Objekt auf dem Heap. Die vier übrigen sind flache Layouts für Felder und Array-Elemente. Welches davon die JVM verwendet, hängt von zwei Fragen ab: Darf das Feld null enthalten – dann braucht es einen Null-Marker? Und muss die JVM das Feld atomar schreiben, weil es sich ändern kann? Die Ausgabe nennt für jedes Layout Größe/Ausrichtung in Bytes:
| Zeile | Bedeutung |
|---|---|
BUFFERED layout: 8/8 | Die Daten des Objekts auf dem Heap ab Offset 8: 8 Bytes, an 8 Bytes ausgerichtet. |
NULL_FREE_NON_ATOMIC_FLAT layout: -/- | Flach, ohne Null-Marker, nicht atomar. Dieses Layout gibt es für LocalDate nicht: Eine Value Class mit mehr als einem Feld muss die JVM atomar schreiben, solange die Klasse nicht die JDK-interne Annotation @LooselyConsistentValue trägt. Integer dagegen hat dieses Layout (4/4): Ein einzelnes Feld schreibt die CPU ohnehin atomar. |
NULL_FREE_ATOMIC_FLAT layout: 8/8 | Flach, ohne Null-Marker, atomar: 6 Bytes Felder, aufgerundet auf 8. Ohne Null-Marker kann ein solches Feld kein null speichern. In Java 28 nutzt nur das JDK intern dieses Layout, für deinen Code kommt es in einer zukünftigen Java-Version mit den Null-Restricted Types. Ausprobieren lässt es sich schon heute über eine JDK-interne API (siehe Null-freie Arrays schon heute messen). |
NULLABLE_ATOMIC_FLAT layout: 8/8 | Flach, mit Null-Marker, atomar: 7 Bytes (6 Bytes für die Felder plus 1 Byte für den Null-Marker), aufgerundet auf 8 und an 8 Bytes ausgerichtet. Dieses Layout nutzt die JVM für gewöhnliche Felder und für Arrays vom Typ LocalDate. Es passt in einen einzigen Schreibzugriff. |
NULLABLE_NON_ATOMIC_FLAT layout: 7/4 | Flach, mit Null-Marker, nicht atomar: 7 Bytes ohne Aufrunden, an 4 Bytes ausgerichtet wie das int-Feld. Die JVM nutzt es nur für finale, strikt initialisierte Felder, z. B. in Value Objects. Die schreibt nach dem Konstruktor niemand mehr, Atomarität ist dort also unnötig. |
Null marker offset = 14 | Der Null-Marker der Layouts NULLABLE_… steht an Offset 14, also direkt hinter day. |
Warum muss ein atomares Layout an seiner Größe ausgerichtet sein? Die JVM schreibt ein solches Feld mit einem einzigen Maschinenbefehl. Atomar ist dieser Zugriff auf Intel- und ARM-Prozessoren garantiert, wenn seine Adresse durch seine Größe teilbar ist – bei 8 Bytes also durch 8. Ein nicht ausgerichteter Zugriff kann dagegen über die Grenze zweier Cache-Lines reichen, und dafür garantieren weder Intel noch ARM Atomarität. Ein anderer Thread könnte dann einen Teil der Bytes schon neu und den Rest noch alt lesen.
Flache Felder und Arrays
Das Layout NULLABLE_ATOMIC_FLAT nutzt die JVM in Feldern. Die folgende Klasse Holder hat ein Feld vom Typ LocalDate und eines vom Typ Point – dem Value Record Point(int x, int y) aus dem Abschnitt Eigene Value Classes deklarieren:
import java.time.LocalDate;

class Holder {
  LocalDate date;
  Point point;
}
Layout of class Holder
Instance fields:
@0 RESERVED 8/-
@8 FLAT 8/8 "date" Ljava/time/LocalDate; java/time/LocalDate NULLABLE_ATOMIC_FLAT
@16 REGULAR 4/4 "point" LPoint;
Instance size = 24 bytesDas Feld date ist kein Pointer, sondern enthält die 8 Bytes des LocalDate selbst. Das Feld point ist dagegen ein gewöhnlicher Pointer (REGULAR, 4 Bytes) – warum, erklärt der nächste Abschnitt.
Die Grafik zeigt die 24 Bytes eines Holder-Objekts – den Header, das flache LocalDate mit seinem Null-Marker und einem ungenutzten Byte, den Pointer auf den Point und 4 Bytes Auffüllung:
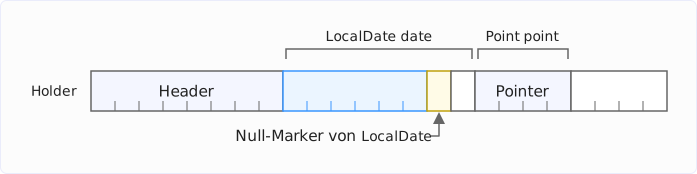
Für Arrays gilt dasselbe wie für Felder. -XX:+PrintFlatArrayLayout meldet für ein LocalDate[]:
Flat Type Array: [Ljava.time.LocalDate;
 - element klass: 'java/time/LocalDate'
 - layout kind: NULLABLE_ATOMIC_FLAT
 - array properties: NULLABLE ATOMIC
 - element size 8 aligned layout size 8
Jedes Element belegt 8 Bytes – statt 4 Bytes für den Pointer plus 16 Bytes für das Objekt.
Null-Marker und die 8-Byte-Grenze
Eine Variable vom Typ LocalDate darf null sein. Ist sie ein Pointer, ist das einfach: null ist der Pointer 0. Ein flaches Feld hat aber keinen Pointer. Deshalb ergänzt die JVM die Felder um ein zusätzliches Byte, den Null-Marker: 1 bedeutet, das Feld enthält ein Objekt, 0 bedeutet null.
Den Platz für den Null-Marker sucht die JVM in einer Lücke zwischen den Feldern; gibt es keine, hängt sie ihn ans Ende. Danach rundet sie die Größe auf die nächste Zweierpotenz auf.
Wo der Null-Marker steht
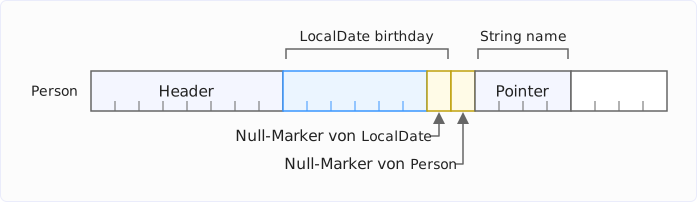
Beim LocalDate steht der Null-Marker am Ende, an Offset 14. Ein Beispiel für eine Lücke ist der Record Person(String name, LocalDate birthday) aus dem Abschnitt == und equals() – hier sein Layout:
Layout of class Person
Instance fields:
 @0 RESERVED 8/-
 @8 FLAT 7/4 "birthday" Ljava/time/LocalDate; java/time/LocalDate NULLABLE_NON_ATOMIC_FLAT
 @15 NULL_MARKER 1/1
 @16 REGULAR 4/4 "name" Ljava/lang/String;
Das flache birthday belegt die sieben Bytes von Offset 8 bis 14, einschließlich seines eigenen Null-Markers. Der Pointer name muss an einer durch 4 teilbaren Adresse beginnen, also bei Offset 16. In die Lücke an Offset 15 setzt die JVM den Null-Marker der Person selbst:
Warum bei 8 Bytes Schluss ist
Die JVM rundet die Größe mit Null-Marker auf die nächste Zweierpotenz auf – beim LocalDate also von 7 auf 8 Bytes –, weil sie ein Feld, das sich ändern kann, atomar schreiben muss: in einem einzigen Schreibzugriff. Schreibt ein Thread ein flaches LocalDate in zwei Schritten, könnte ein anderer Thread dazwischen das neue Jahr mit dem alten Monat lesen (Tearing).
HotSpot schreibt ein flaches Feld höchstens 8 Bytes groß am Stück. So breit ist der größte Schreibzugriff, den Intel- und ARM-Prozessoren ohne Zusatzfunktionen garantiert atomar ausführen. Intel-Prozessoren mit AVX und ARM-Prozessoren mit der Erweiterung FEAT_LSE2 schreiben auch 16 Bytes atomar, doch das nutzt HotSpot in Java 28 (noch) nicht. Außerdem schreibt HotSpot ein flaches Feld nur an Adressen, die durch seine Größe teilbar sind.
In einem veränderlichen Feld oder einem Array muss ein Value Object mit Null-Marker also in 1, 2, 4 oder 8 Bytes passen, sonst legt die JVM es dort nicht flach ab.
Welche Klassen passen
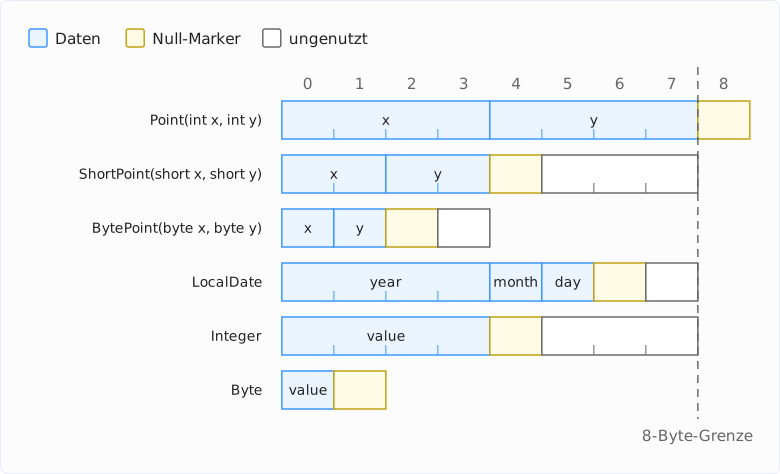
Was die 8-Byte-Grenze bedeutet, lässt sich an drei Records mit zwei Feldern und an drei JDK-Klassen ablesen. Die Tabelle zeigt für jede Klasse die Größe der Felder, die Größe mit Null-Marker und den Platz, den ein flaches Feld oder Array-Element belegt – alles in Bytes:
| Klasse | Felder | mit Null-Marker | flach | ungenutzt |
|---|---|---|---|---|
Point(int x, int y) | 8 | 9 | – (Pointer) | – |
ShortPoint(short x, short y) | 4 | 5 | 8 | 3 |
BytePoint(byte x, byte y) | 2 | 3 | 4 | 1 |
LocalDate | 6 | 7 | 8 | 1 |
Integer | 4 | 5 | 8 | 3 |
Byte | 1 | 2 | 2 | 0 |
Ausgerechnet der naheliegendste Punkt passt nicht: Zwei ints belegen schon 8 Bytes, mit dem Null-Marker sind es 9. In einem veränderlichen Feld und in einem Array legt die JVM einen Point(int x, int y) deshalb als Pointer auf ein Heap-Objekt ab – das war das Feld point im Holder oben.
Ein ShortPoint passt dagegen, kostet aber 3 ungenutzte Bytes: 4 Bytes Daten, 1 Byte Null-Marker, aufgerundet auf 8. Die Grafik zeigt die Bytes der Klassen aus der Tabelle – Daten blau, den Null-Marker gelb und ungenutzte Bytes weiß. Die gestrichelte Linie markiert die 8-Byte-Grenze:
Drei Beobachtungen aus der Ausgabe von -XX:+PrintFieldLayout:
- Feld und Array: Der Null-Marker steht an derselben Stelle, egal ob das Value Object in einem Feld oder einem Array-Element liegt. Die JVM berechnet seine Position einmal pro Klasse.
- Keine Zusammenfassung: Mehrere flache Felder teilen sich keinen Null-Marker. Vier
BytePoint-Felder belegen 4 × 4 Bytes, und ein zusätzlichesbyte-Feld neben dreiShortPoint-Feldern landet hinter ihnen, nicht in einer ihrer Lücken. Der Grund ist der atomare Schreibzugriff: Die JVM reserviert für ein flaches Feld die volle Größe seines Layouts, ungenutzte Bytes eingeschlossen, und überschreibt beim Schreiben immer alle diese Bytes – also auch alles, was in einer Lücke stünde. LongundDouble: Für diese beiden Klassen schaltet die JVM die Layouts mit Null-Marker derzeit ganz ab. Laut Kommentar im Quellcode verursachten sie eine Performance-Regression. Felder der TypenLongundDoublesind deshalb immer Pointer.
Was ein nicht flach abgelegter Point(int x, int y) an Speicher kostet, zeigt der Abschnitt Messung: mehr als ein gewöhnlicher Record.
Verschachtelte Value Objects: innen flach, außen ein Pointer
Für die Felder einer Value Class oder eines Value Records gilt die 8-Byte-Grenze nicht, und mit Preview-Features auch nicht für die Felder eines Records ohne value. Beide Arten von Feldern sind final und strikt initialisiert: Sie ändern sich nach dem Konstruktor nie, also kann auch kein anderer Thread ein halb geschriebenes Feld sehen. Die JVM darf hier das Layout NULLABLE_NON_ATOMIC_FLAT verwenden, das größer sein darf als 8 Bytes. Ein finales Feld einer gewöhnlichen Klasse ist dagegen nicht strikt initialisiert; für dieses gilt die 8-Byte-Grenze weiterhin.
Ein Beispiel ist LocalDateTime, das aus einem LocalDate und einem LocalTime besteht:
Layout of class java/time/LocalDateTime
Instance fields:
 @0 RESERVED 8/-
 @8 FLAT 8/4 "time" Ljava/time/LocalTime; java/time/LocalTime NULLABLE_NON_ATOMIC_FLAT
 @16 FLAT 7/4 "date" Ljava/time/LocalDate; java/time/LocalDate NULLABLE_NON_ATOMIC_FLAT
 @23 NULL_MARKER 1/1
Instance size = 24 bytes
First field offset = 8
BUFFERED layout: 16/4
NULL_FREE_NON_ATOMIC_FLAT layout: -/-
NULL_FREE_ATOMIC_FLAT layout: -/-
NULLABLE_ATOMIC_FLAT layout: -/-
NULLABLE_NON_ATOMIC_FLAT layout: 16/4
Beide Felder liegen flach im LocalDateTime, jedes mit seinem eigenen Null-Marker: 8 Bytes für das LocalTime, 7 für das LocalDate. Schon ohne den Null-Marker des LocalDateTime selbst sind das 15 Bytes, mit ihm 16 – beides zu viel für ein atomares Layout. Deshalb steht bei NULL_FREE_ATOMIC_FLAT und NULLABLE_ATOMIC_FLAT ein -/-.
In einem veränderlichen Feld ist ein LocalDateTime also ein Pointer. Er zeigt auf ein LocalDateTime-Objekt auf dem Heap, in dem LocalTime und LocalDate flach liegen:
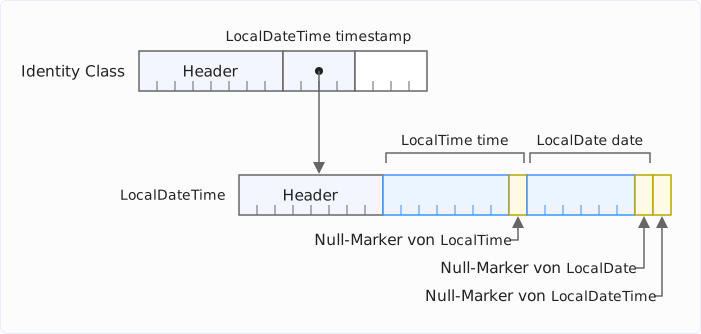
Ohne Valhalla wären das drei Objekte auf dem Heap: das LocalDateTime und dazu je ein LocalTime- und ein LocalDate-Objekt, auf die es mit Pointern zeigt. Mit Valhalla ist es eines.
Das folgende Beispiel zeigt die ganze Kette: Ein Value Record Event speichert einen Zeitstempel, eine Identity Class Button das letzte Event:
import java.time.LocalDateTime;

value record Event(LocalDateTime timestamp) {}
class Button {
Event lastEvent;
}Die JVM gibt für beide Klassen aus (gekürzt):
Layout of class Event
Instance fields:
 @0 RESERVED 8/-
 @8 FLAT 16/4 "timestamp" Ljava/time/LocalDateTime; java/time/LocalDateTime NULLABLE_NON_ATOMIC_FLAT
 @24 NULL_MARKER 1/1
Instance size = 32 bytes
NULLABLE_ATOMIC_FLAT layout: -/-
NULLABLE_NON_ATOMIC_FLAT layout: 17/4

Layout of class Button
Instance fields:
 @0 RESERVED 8/-
 @8 REGULAR 4/4 "lastEvent" LEvent;
Das LocalDateTime liegt flach im Event. Das Event selbst ist mit seinem Null-Marker 17 Bytes groß und hat kein atomares Layout. Im Feld lastEvent von Button steht deshalb ein Pointer auf ein Event-Objekt auf dem Heap – und in diesem stehen alle Daten flach:
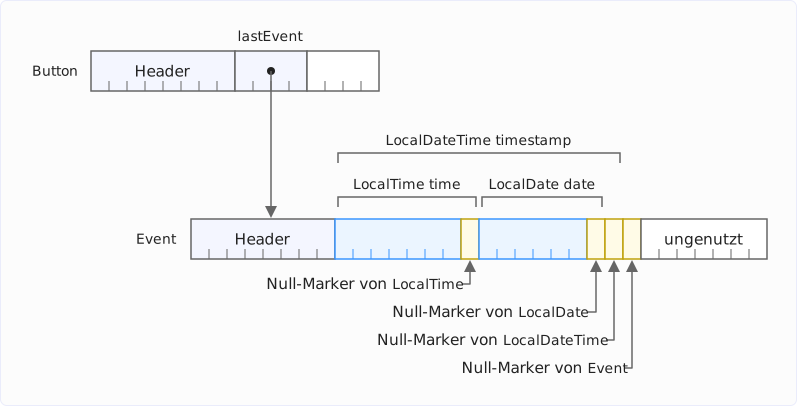
Das Event-Objekt belegt 32 Bytes: 8 Bytes Header und 17 Bytes Daten samt Null-Markern ergeben 25 Bytes, und die JVM füllt mit 7 Bytes auf das nächste Vielfache von 8 auf. Beim LocalDateTime-Objekt oben ergaben 8 Bytes Header und 16 Bytes Daten dagegen genau 24 Bytes, eine Auffüllung war nicht nötig.
Ohne Valhalla käme zu den drei Objekten von oben noch das Event hinzu, mit Valhalla bleibt es bei einem. Jede Ebene bringt dabei ihren eigenen Null-Marker mit: Ein Value Record Wrapper(Event event) wäre 18 Bytes groß.
Scalarization: Value Objects in Registern
Flattening betrifft Felder und Arrays. Für Parameter, Rückgabewerte und lokale Variablen hat die JVM eine zweite Technik: Der JIT-Compiler zerlegt das Value Object in seine Felder und übergibt sie in einzelnen Registern. Das heißt Scalarization.
Das folgende Programm misst, wie viele Bytes zehn Millionen Aufrufe einer Methode allokieren, die einen Punkt verschiebt und einen neuen zurückgibt – einmal mit einem gewöhnlichen Record, einmal mit einem Value Record:
import java.lang.management.ManagementFactory;

record IdentityPoint(int x, int y) {}
value record ValuePoint(int x, int y) {}

static final int CALLS = 10_000_000;

void main() {
  var threads = (com.sun.management.ThreadMXBean)
      ManagementFactory.getThreadMXBean();
  for (int round = 1; round <= 5; round++) {
    long before = threads.getCurrentThreadAllocatedBytes();
    int sum = sumIdentityPoints();
    long identityBytes = threads.getCurrentThreadAllocatedBytes() - before;

    before = threads.getCurrentThreadAllocatedBytes();
    sum += sumValuePoints();
    long valueBytes = threads.getCurrentThreadAllocatedBytes() - before;

    IO.println("Round %d: identity %,d bytes, value %,d bytes (%d)"
        .formatted(round, identityBytes, valueBytes, sum));
  }
}

int sumIdentityPoints() {
  IdentityPoint p = new IdentityPoint(0, 0);
  for (int i = 0; i < CALLS; i++) {
    p = moveIdentity(p, i);
  }
  return p.x() + p.y();
}

IdentityPoint moveIdentity(IdentityPoint p, int i) {
  return new IdentityPoint(p.x() + (i & 1), p.y() + (i & 2));
}

int sumValuePoints() {
  ValuePoint p = new ValuePoint(0, 0);
  for (int i = 0; i < CALLS; i++) {
    p = moveValue(p, i);
  }
  return p.x() + p.y();
}

ValuePoint moveValue(ValuePoint p, int i) {
  return new ValuePoint(p.x() + (i & 1), p.y() + (i & 2));
}
Damit der JIT-Compiler die beiden move-Methoden nicht in die Schleifen inlined, starte ich das Programm mit -XX:CompileCommand=dontinline,*::move*. So bleibt ein echter Methodenaufruf übrig, der den Punkt als Parameter übergeben bekommt und einen neuen zurückgibt:
Round 1: identity 160.000.144 bytes, value 6.052.432 bytes (30000000)
Round 2: identity 160.000.016 bytes, value 6.291.456 bytes (30000000)
Round 3: identity 160.000.016 bytes, value 0 bytes (30000000)
Round 4: identity 160.000.016 bytes, value 0 bytes (30000000)
Round 5: identity 160.000.016 bytes, value 0 bytes (30000000)
Der gewöhnliche Record allokiert in jeder Runde 160 MB – 16 Bytes für jeden der zehn Millionen Punkte. Der Value Record allokiert ab der dritten Runde nichts mehr. In den ersten beiden Runden ist der Code noch nicht vollständig vom JIT-Compiler übersetzt; der Interpreter legt Value Objects als Heap-Objekte an.
Wie viel der Interpreter allokiert, zeigt ein Lauf mit -Xint, der den JIT-Compiler ganz abschaltet:
Round 1: identity 160.000.056 bytes, value 240.000.088 bytes (30000000)Im Interpreter belegt jeder ValuePoint 24 Bytes – mehr als ein IdentityPoint mit 16 Bytes. Der Grund ist der Null-Marker: 8 Bytes Header, 8 Bytes Daten und 1 Byte Null-Marker ergeben 17 Bytes, aufgerundet auf 24. Auf dem Heap hat der Null-Marker keine Bedeutung – ein Heap-Objekt ist nie null –, die JVM reserviert ihn aber, damit sie die Bytes am Stück in ein flaches Feld kopieren kann.
Dass der Value Record nur dank der Übergabe in Registern nichts allokiert, zeigen zwei weitere Diagnose-Optionen. -XX:-ValueTypePassFieldsAsArgs und -XX:-ValueTypeReturnedAsFields schalten die Scalarization für Parameter und für Rückgabewerte ab: Der JIT-Compiler übergibt das Value Object dann als Pointer auf ein Objekt auf dem Heap. Dann allokiert auch der kompilierte Code in jeder Runde 240 MB.
Wann die JVM ein Value Object flach ablegt
Flattening und Scalarization sind Optimierungen. Du kannst sie nicht erzwingen, aber du kannst sie verhindern. Vier Bedingungen bestimmen, ob die JVM sie anwendet:
- Der Typ ist konkret. Ein
Integer[]legt die JVM flach an, einObject[]mit denselbenInteger-Werten nicht – in einemObject[]könnte später jedes beliebige Objekt landen. Dasselbe gilt für generische Typen: Ein Feld vom TypTist nach der Type Erasure ein Feld vom TypObject. - Die Größe passt. In veränderlichen Feldern und Arrays muss das Value Object mit Null-Marker in 8 Bytes passen.
- Die JVM kennt die Klasse früh genug. Sie muss beim Laden einer Klasse wissen, welche Feldtypen Value Classes sind. Dafür schreibt
javacdas neue AttributLoadableDescriptorsin die Klassendatei jeder Klasse, die eine Value Class als Feldtyp oder in einer Methodensignatur verwendet. - Der Code ist kompiliert (nur für Scalarization). In lokalen Variablen, Parametern und Rückgabewerten hält der Interpreter Value Objects als Objekte auf dem Heap, erst der JIT-Compiler zerlegt sie in Register. Felder und Arrays legt dagegen schon der Interpreter flach an, denn ihr Layout steht beim Laden der Klasse fest.
Zur ersten Bedingung ein Beispiel. Ein value record Box<T>(T value) hat ein Feld vom Typ Object, und das Layout zeigt dort einen Pointer:
Layout of class Box
Instance fields:
 @0 RESERVED 8/-
 @8 REGULAR 4/4 "value" Ljava/lang/Object;
 @12 NULL_MARKER 1/1
Die Box selbst kann dagegen flach in einem anderen Objekt liegen: 4 Bytes für den Pointer und 1 Byte Null-Marker passen in 8 Bytes. Ein Feld Box<Integer> box in einer gewöhnlichen Klasse zeigt die JVM als FLAT 8/8 an. Flach liegt dann aber nur der Pointer, nicht der Integer, auf den er zeigt.
Mit dem konkreten Typ sieht es anders aus. In einem value record IntegerBox(Integer value) liegt das Integer flach im Feld value, mit eigenem Null-Marker:
Layout of class IntegerBox
Instance fields:
 @0 RESERVED 8/-
 @8 FLAT 5/4 "value" Ljava/lang/Integer; java/lang/Integer NULLABLE_NON_ATOMIC_FLAT
 @13 NULL_MARKER 1/1
Instance size = 16 bytes
NULLABLE_ATOMIC_FLAT layout: 8/8
NULLABLE_NON_ATOMIC_FLAT layout: 6/4
Mit dem Null-Marker der Box sind das 6 Bytes, und auch ein Feld IntegerBox integerBox legt die JVM als FLAT 8/8 an – diesmal aber mit dem int-Wert selbst statt eines Pointers.
Zur dritten Bedingung: javap -v zeigt für die Klasse Holder aus dem Abschnitt Flattening sichtbar machen zwei Einträge im neuen Attribut:
LoadableDescriptors:
  Ljava/time/LocalDate;
  LPoint;
Beim Laden von Holder lädt die JVM LocalDate und Point deshalb vorab. So kennt sie deren Layout, bevor sie das von Holder berechnet, und kann das LocalDate flach in Holder ablegen. Den Point legt sie trotzdem als Pointer ab – er passt mit Null-Marker nicht in 8 Bytes.
Steht eine eigene Value Class dort nicht, weil die Klassendatei gegen eine ältere Version kompiliert wurde, in der sie noch keine Value Class war, lädt die JVM sie nicht vorab. Flach wird das Feld dann nur, wenn die Klasse zufällig schon geladen ist. Die Value Classes des JDK kennt die JVM dagegen immer. Machst du eine eigene Klasse zur Value Class, solltest du deshalb auch den Code neu kompilieren, der sie verwendet.
Der Header von Value Objects
Ein Value Object auf dem Heap hat einen Header wie jedes andere Objekt. Mit Compact Object Headers, die seit Java 27 Standard sind, ist er 8 Bytes groß – das zeigt das RESERVED 8/- an Offset 0 in jeder Layout-Ausgabe oben.
In diesem Header sind seit Java 24 vier Bits für Project Valhalla reserviert – bei den klassischen Headern im Mark Word, bei den Compact Object Headers im 64-Bit-Header selbst. Mit aktivierten Preview-Features belegt die JVM in Java 28 drei davon:
- Value Type: Das Objekt ist ein Value Object.
- Flat Array: Das Array speichert seine Elemente flach.
- Null-free Array: Das Array enthält kein
null. Im Java-Code lassen sich solche Arrays noch nicht anlegen, nur über eine JDK-interne API – ihr Bit bereitet die Null-Restricted Types vor.
Das vierte Bit bleibt reserviert. Die Grafik zeigt den Objekt-Header mit Compact Object Headers:
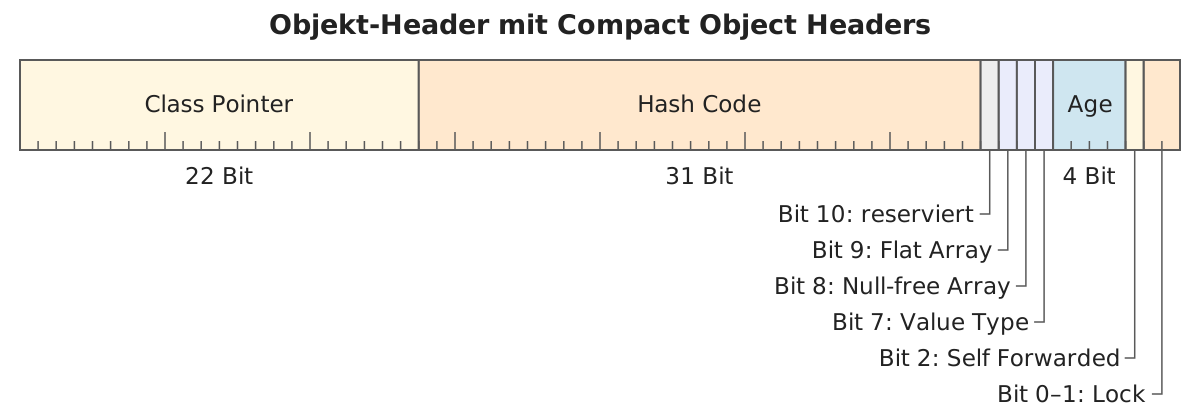
Dass die JVM diese Bits tatsächlich setzt, lässt sich nachprüfen. Das Programm MarkWord.java im Repository liest die ersten 8 Bytes einiger Objekte mit sun.misc.Unsafe aus. Der Header eines ValuePoint unterscheidet sich von dem eines IdentityPoint in Bit 7, dem Value-Type-Bit. Bei einem flachen LocalDate[] und einem flachen Integer[] ist Bit 9 gesetzt, das Flat-Array-Bit, bei einem Object[] nicht.
Die Lock-Bits zeigen bei Value Objects immer „nicht gesperrt“, denn ein Value Object kann nicht gesperrt werden. Den Hash berechnet die JVM aus der Klasse und den Feldwerten und darf ihn im Header zwischenspeichern.
Wie die JVM == ausführt
Für zwei Identity Objects vergleicht == zwei Pointer. Für zwei Value Objects muss die JVM ihre Felder vergleichen – und zwar Bit für Bit, wie im Abschnitt == und equals() beschrieben.
Dafür legt sie beim Laden jeder Value Class zwei Listen an und speichert sie in einem versteckten statischen Feld .acmp_maps der Klasse. -XX:+PrintFieldLayout gibt sie am Ende jedes Layouts aus. Für Point(int x, int y):
Non-oop acmp map <offset,size>: <8,8>
oop acmp map:
Die erste Liste nennt die Bytes, die die JVM direkt vergleicht – hier die 8 Bytes ab Offset 8, also x und y am Stück. Die zweite Liste nennt die Referenzfelder, für die sie rekursiv weitervergleicht. Point hat keine.
Für Person(String name, LocalDate birthday) sehen die beiden Listen so aus:
Non-oop acmp map <offset,size>: <8,7>
oop acmp map: 16
Die 7 Bytes ab Offset 8 sind das flache birthday samt Null-Marker. An Offset 16 steht der Pointer name – den vergleicht die JVM mit ==, und weil String eine Identity Class ist, endet die Rekursion dort.
Mehrere Einträge in der ersten Liste zeigt JapaneseDate aus java.time.chrono, mit Preview-Features ebenfalls eine Value Class:
Layout of class java/time/chrono/JapaneseDate
Instance fields:
 @0 RESERVED 8/-
 @8 FLAT 7/4 "isoDate" Ljava/time/LocalDate; java/time/LocalDate NULLABLE_NON_ATOMIC_FLAT
 @15 NULL_MARKER 1/1
 @16 REGULAR 4/4 "yearOfEra" I
 @20 REGULAR 4/4 "era" Ljava/time/chrono/JapaneseEra;
Non-oop acmp map <offset,size>: <8,7> <16,4>
oop acmp map: 20
Die JVM vergleicht die 7 Bytes des flachen isoDate und die 4 Bytes von yearOfEra, aber nicht das Byte dazwischen: An Offset 15 steht der Null-Marker des JapaneseDate selbst, und der hat auf dem Heap keine Bedeutung. Dasselbe gilt für die Person oben, deren <8,7> vor dem Null-Marker an Offset 15 endet. Den Pointer era an Offset 20 vergleicht die JVM wie name mit ==.
Die Rekursion sieht man im Stacktrace des Beispiels mit den verketteten Node-Objekten im Abschnitt == und equals(): Die Methode ValueObjectMethods.isSubstitutable() ruft sich für jede Ebene selbst auf.
Messung: Speicher und Laufzeit
Wie viel Speicher und Laufzeit Value Objects sparen – und wann sie mehr kosten –, habe ich mit dem Early-Access-Build von Java 28 gemessen: zuerst den Speicherbedarf eines Arrays mit einer Million LocalDates, dann die Laufzeit von Schleifen über große Arrays.
Speicher
Das folgende Programm legt ein Array mit einer Million verschiedener LocalDates an. Danach gibt es die Zeilen des Klassenhistogramms aus, die LocalDate betreffen – dieselbe Ausgabe wie jcmd <pid> GC.class_histogram:
import java.lang.management.ManagementFactory;
import javax.management.ObjectName;

static final int COUNT = 1_000_000;

void main() throws Exception {
  LocalDate[] dates = new LocalDate[COUNT];
  LocalDate start = LocalDate.of(2000, 1, 1);
  for (int i = 0; i < COUNT; i++) {
    dates[i] = start.plusDays(i);
  }
  printHistogram();
  IO.println(dates[COUNT - 1]);
}

void printHistogram() throws Exception {
  var server = ManagementFactory.getPlatformMBeanServer();
  var command = new ObjectName("com.sun.management:type=DiagnosticCommand");
  String histogram = (String) server.invoke(command, "gcClassHistogram",
      new Object[] { null }, new String[] { String[].class.getName() });
  histogram.lines()
      .filter(line -> line.contains("num ") || line.contains("java.time.LocalDate ")
          || line.contains("[Ljava.time.LocalDate;"))
      .forEach(IO::println);
}
Die letzte Zeile gibt das letzte Datum aus, damit das Array beim Erstellen des Histogramms noch erreichbar ist.
Die Ausgabe ohne Preview-Features:
 num     #instances         #bytes  class name (module)
   1:       1000003       16000048  java.time.LocalDate (java.base@28-ea)
   2:             1        4000016  [Ljava.time.LocalDate; (java.base@28-ea)
Mit --enable-preview:
 num     #instances         #bytes  class name (module)
   1:             1        8000016  [Ljava.time.LocalDate; [flat, nullable, atomic] (java.base@28-ea)
 495:             4             64  java.time.LocalDate (java.base@28-ea)
Ohne Valhalla belegen die Daten 20 MB: 16 MB für eine Million LocalDate-Objekte zu je 16 Bytes und 4 MB für das Array mit den Pointern. Mit Valhalla sind es 8 MB, alles im flachen Array – 60 % weniger.
Ein zweites Programm vergleicht drei Arrays mit je einer Million Punkten: ValuePoint(int x, int y) und ShortPoint(short x, short y) als Value Records und IdentityPoint(int x, int y) als gewöhnlichen Record. Die Methode printHistogram() filtert wie oben, diesmal nach den drei Klassennamen:
static final int COUNT = 1_000_000;

void main() throws Exception {
  var valuePoints = new ValuePoint[COUNT];
  var shortPoints = new ShortPoint[COUNT];
  var identityPoints = new IdentityPoint[COUNT];
  for (int i = 0; i < COUNT; i++) {
    valuePoints[i] = new ValuePoint(i, -i);
    shortPoints[i] = new ShortPoint((short) i, (short) -i);
    identityPoints[i] = new IdentityPoint(i, -i);
  }
  printHistogram();
  IO.println(valuePoints.length + shortPoints.length + identityPoints.length);
}
Die Ausgabe (die fehlende Zeile 4 betrifft eine andere Klasse):
 num     #instances         #bytes  class name (module)
   1:       1000001       24000024  ValuePoint
   2:       1000000       16000000  IdentityPoint
   3:             1        8000016  [LShortPoint; [flat, nullable, atomic]
   5:             1        4000016  [LIdentityPoint;
   6:             1        4000016  [LValuePoint;
 933:             1             16  ShortPoint
Die ShortPoints belegen 8 MB im flachen Array (die letzte Zeile zählt ein einzelnes ShortPoint auf dem Heap, außerhalb des Arrays). Die IdentityPoints belegen 20 MB: 16 MB Objekte plus 4 MB Array.
Und die ValuePoints belegen sogar 28 MB: 24 MB Objekte plus 4 MB Array – hier belegt ein Value Object, das die JVM nicht flach ablegen kann, 40 % mehr Speicher als ein gewöhnliches Objekt. Grund ist wieder der Null-Marker: 8 Bytes Header und 8 Bytes Daten füllen 16 Bytes genau aus, das zusätzliche Byte bringt das Heap-Objekt mit sieben zusätzlichen Füllbytes auf durch acht teilbare 24 Bytes.
Hat ein gewöhnliches Objekt dagegen noch wenigstens ein Byte Auffüllung frei, passt der Null-Marker dort hinein, und beide sind gleich groß. Ein Record aus einem int und einem short z. B. belegt als Value Record wie als gewöhnlicher Record 16 Bytes.
Laufzeit
Weniger Speicher – bis auf die oben beschriebene Ausnahme – ist das eine. Wird der Code auch schneller? Das habe ich mit JMH gemessen.
Der Benchmark
Der Benchmark summiert die Elemente dreier Arrays: ein int[] als Vergleich, ein Integer[] und ein LocalDate[], bei dem er die Jahre addiert.
Die Schleife verteilt die Elemente auf vier unabhängige Summen. So misst der Benchmark in erster Linie den Zugriff auf die Elemente und nicht die Additionen – mit nur einer Summe müsste jede Addition auf das Ergebnis der vorigen warten. Für das Integer[] sieht das so aus:
@Benchmark
public long sumIntegersFourSums() {
  Integer[] a = integers;
  long s0 = 0, s1 = 0, s2 = 0, s3 = 0;
  for (int i = 0; i < a.length; i += 4) {
    s0 += a[i];
    s1 += a[i + 1];
    s2 += a[i + 2];
    s3 += a[i + 3];
  }
  return s0 + s1 + s2 + s3;
}
Die Methoden für int[] und LocalDate[] sind genauso aufgebaut; die für LocalDate[] addiert a[i].getYear().
Ohne Preview-Features enthalten das Integer-Array und das LocalDate-Array Pointer auf je ein Objekt pro Element im Heap. Mit --enable-preview stehen die Werte direkt im Array.
Wie teuer ein Pointer ist, hängt davon ab, wo die Objekte liegen. Legt ein Programm viele Objekte in einer Schleife an, liegen sie im Heap direkt hintereinander, und der Prozessor kann die folgenden Speicherbereiche schon laden, bevor die Schleife sie braucht – das nennt sich Prefetching. In einer Anwendung, die schon eine Weile läuft, liegen Objekte, die zu verschiedenen Zeiten entstanden sind, eher verstreut.
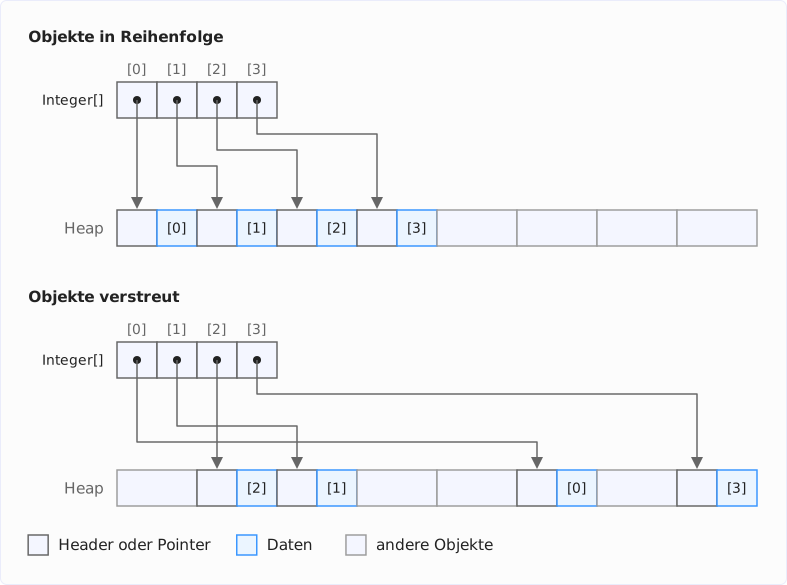
Deshalb läuft jeder Benchmark einmal mit den Objekten in der Reihenfolge, in der sie angelegt wurden, und einmal mit durchmischtem Array – dann springt jeder Zugriff an eine andere Stelle im Heap. Damit keine Garbage Collection die Objekte während der Messung verschiebt, bekommen die Benchmarks einen Heap, der für die ganze Messung reicht.
Der Prozessor hält außerdem kürzlich gelesene Daten in seinen Caches. Beim M5 Pro, auf dem ich gemessen habe, hat jeder der sechs schnellsten Kerne einen L1-Datencache von 128 KB, und gemeinsam teilen sie sich einen L2-Cache von 16 MB. Damit sich zeigt, was passiert, wenn die Daten nicht mehr hineinpassen, läuft beides mit einer Million, zehn Millionen und hundert Millionen Elementen.
Verstreute Objekte
Die Grafik zeigt die Laufzeiten mit hundert Millionen Elementen, jeweils ohne und mit Preview-Features. Kürzere Balken sind besser:
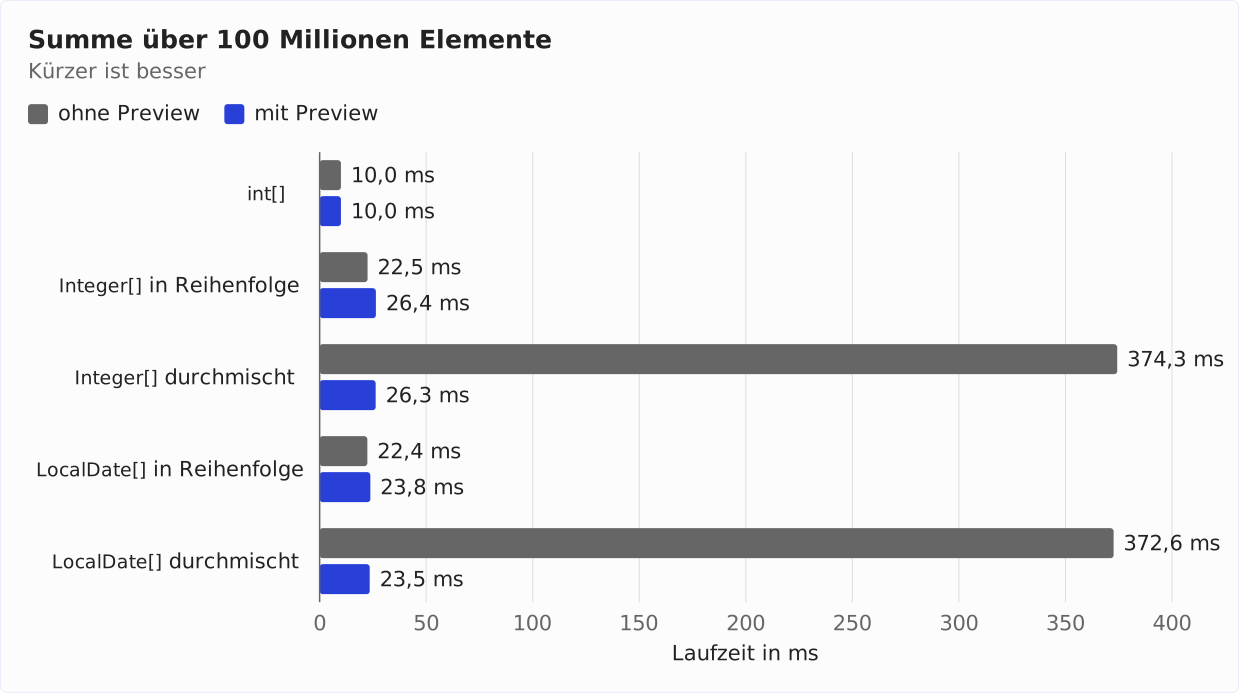
Mit Preview-Features ist es egal, in welcher Reihenfolge die Objekte entstanden sind: Das flache Array enthält die Werte selbst, und die Schleife liest es am Stück. Ohne Preview-Features hängt alles an der Lage der Objekte. Liegen sie verstreut, braucht die Schleife 14- bis 16-mal so lange wie über das flache Array.
Wie viel die verstreute Lage kostet, hängt stark von der Größe des Arrays ab. Die Grafik zeigt für alle drei Größen, wie viel länger die Schleife über verstreute Objekte ohne Preview-Features braucht als über das flache Array:
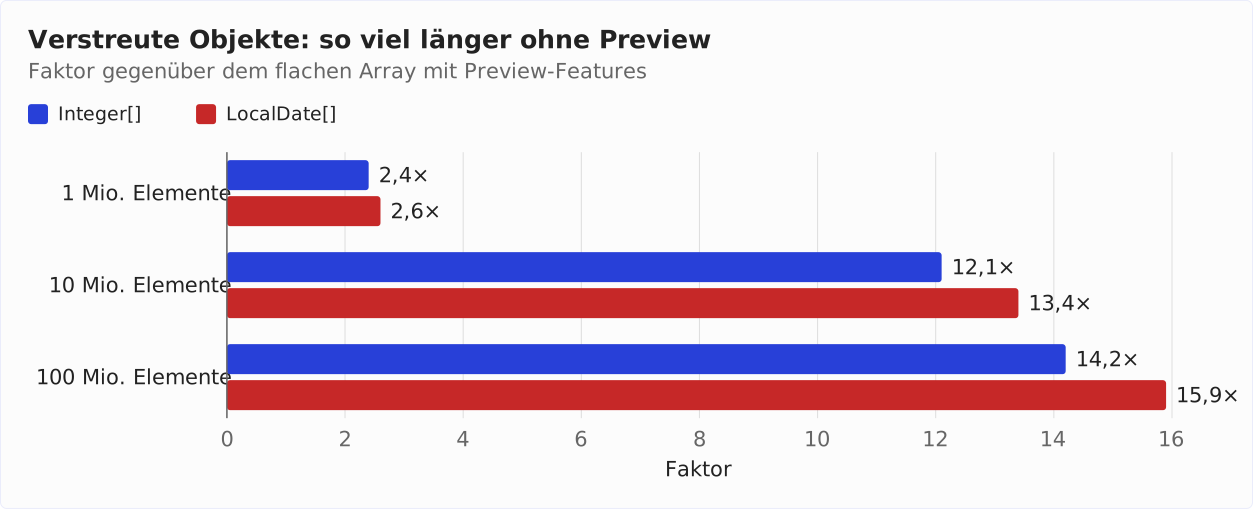
Bei einer Million Elementen belegen die Daten ohne Preview-Features 20 MB – 16 MB für die Objekte und 4 MB für das Array mit den Pointern. Ein großer Teil davon passt in die Caches des Prozessors, allein in den L2-Cache passen 16 MB. Die meisten Sprünge an eine verstreute Stelle landen dann im Cache. Bei hundert Millionen Elementen sind es 2 GB, und fast jedes Objekt muss aus dem Hauptspeicher geladen werden.
Objekte in Reihenfolge
Liegen die Objekte hintereinander, ist das flache Array nicht schneller als das Array mit Pointern. Das zeigen in der Grafik mit den Laufzeiten die Balken „in Reihenfolge“: Der blaue Balken mit Preview-Features ist jeweils etwas länger als der graue ohne – beim LocalDate[] braucht die Schleife 6 % länger, beim Integer[] sogar 17 %.
Das liegt am Null-Marker. Ein Integer[] darf null enthalten, und s0 += a[i] muss dann eine NullPointerException werfen. Der kompilierte Code prüft deshalb bei jedem Element das Null-Marker-Bit, mit zusätzlichen Befehlen und einem bedingten Sprung pro Element. Bei einem Pointer kostet diese Prüfung nichts: Die JVM lässt den Zugriff über einen null-Pointer vom Prozessor abfangen.
Am schnellsten bleibt int[]: Die Schleife braucht weniger als die Hälfte der Zeit wie über jedes andere Array. Bei hundert Millionen Elementen liest die Schleife darüber 400 MB – beim flachen Array sind es 800 MB, beim Array mit Pointern 2 GB.
Flache Arrays machen die Laufzeit unabhängig davon, wo die Objekte liegen. Das zahlt sich aus, wenn die Objekte verstreut im Heap liegen; liegen sie ohnehin hintereinander, gewinnen sie nichts.
Das ändert sich, sobald die JVM ohne Null-Marker auskommt – siehe Null-freie Arrays schon heute messen.
Value Objects, die nicht flach liegen
Und der ValuePoint aus dem Abschnitt über den Speicher, den die JVM nicht flach ablegen kann? Ich habe ihn mit demselben Benchmark-Aufbau mit IdentityPoint verglichen, beides mit Preview-Features. Als Gegenprobe kommt WideIdentityPoint(int x, int y, int z) hinzu, ein gewöhnlicher Record, der mit 24 Bytes genauso groß ist wie ein ValuePoint-Objekt. Die Laufzeiten für hundert Millionen Punkte, deren Objekte in Reihenfolge liegen:
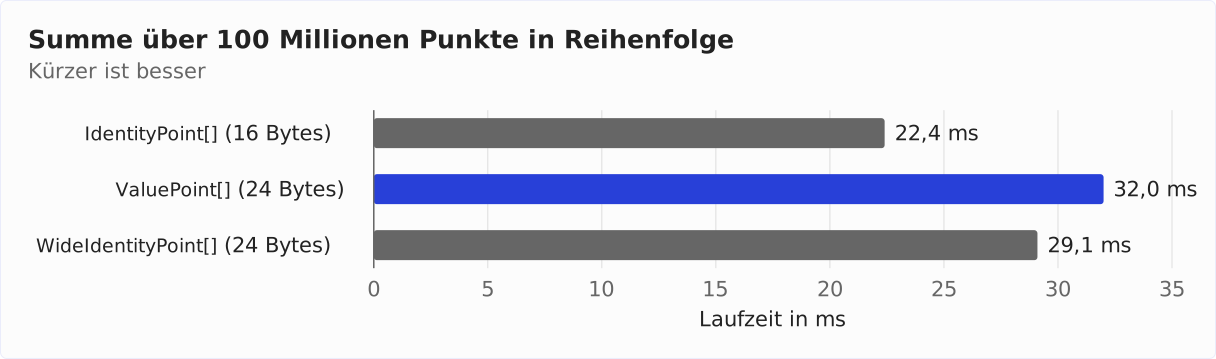
Ein Value Object, das nicht flach liegt, macht die Schleife langsamer als ein gewöhnlicher Record: Bei Objekten in Reihenfolge braucht sie 43 % länger. Gut zwei Drittel davon erklärt die Größe – der gleich große WideIdentityPoint ist 30 % langsamer als IdentityPoint. Den Rest kosten die Null-Prüfungen: Wie beim flachen Integer[] prüft der kompilierte Code bei jedem ValuePoint ausdrücklich, ob er null ist.
Bei verstreuten Objekten sind alle drei gleich schnell (372 bis 376 ms), denn fast jedes Objekt kommt ohnehin aus dem Hauptspeicher. Anders bei einer Million Elementen, die zum großen Teil in die Caches passen: Dort braucht die Schleife über die verstreuten ValuePoints gut die Hälfte länger als über die IdentityPoints (964 statt 608 µs).
Schneller wird also nur, was die JVM flach ablegen kann – und das ist dieselbe Bedingung, unter der Value Objects Speicher sparen.
Eigene Klassen umstellen – Checkliste
Solange Value Objects ein Preview-Feature sind, gehören sie nicht in Produktionscode. Vorbereiten kannst du deine Klassen aber schon jetzt. Eine Klasse ist ein guter Kandidat, wenn sie unveränderliche Daten darstellt und niemand ihre Instanzen unterscheiden muss. Auch abstrakte Klassen ohne Zustand gehören dazu: Sie sollten ihren Unterklassen keine Identität aufzwingen.
Records erfüllen die Bedingungen zwar von Haus aus, trotzdem sollte nicht jeder Record ein Value Record werden. Ein Record ohne value bleibt eine Identity Class, und das ist weiterhin die richtige Wahl, wenn Code auf seinen Instanzen synchronisiert oder sie in einer WeakHashMap hält. Oder wenn seine Komponenten zu groß sind, als dass die JVM ihn flach ablegen könnte: Dann belegt ein Value Record oft mehr Speicher als ein gewöhnlicher – immer dann, wenn für den Null-Marker kein Padding-Byte frei ist –, und Schleifen über ihn werden langsamer (siehe Messung).
Bevor du value an eine Klasse schreibst, solltest du die folgenden Punkte prüfen:
- Öffentliche Konstruktoren: Verlässt sich Code darauf, dass
newein neues, unterscheidbares Objekt liefert? Mit Valhalla istnew Money(5) == new Money(5)true. Das JDK hat die Konstruktoren der Wrapper-Klassen deshalb schon vor Jahren deprecated und empfiehlt Factory-Methoden wieInteger.valueOf(). - Synchronisation: Synchronisiert irgendwo Code auf Instanzen der Klasse, wirft er nach der Umstellung eine
IdentityExceptionoder kompiliert nicht mehr. equals()undhashCode(): Überschreibt die Klasse sie nicht, ändern beide ihr Verhalten. Überschreibe sie vor der Umstellung, damit ihr Ergebnis nicht von der Identität abhängt.- Weak References und Caches: Bibliotheken, die Objekte in einer
WeakHashMapoder hinter einerWeakReferencehalten, scheitern mit einerIdentityException. Ein Beispiel ist JOL (Java Object Layout) in Version 0.17, das jedes untersuchte Objekt in eineWeakReferencepackt und deshalb Value Objects nicht analysieren kann. - Serialisierung: Eine serialisierbare Value Class, die kein Record ist, braucht
writeReplace()undreadResolve(). - Deep Reflection: Frameworks, die Felder per Reflection setzen, statt den Konstruktor aufzurufen, scheitern an Value Objects.
- Konstruktoren: Verwendet ein Konstruktor
this, bevor alle Felder gesetzt sind, kompiliert er nicht mehr und muss umgebaut werden – das gilt mit Preview-Features auch für alle Records. - Größe: Passen die Felder mit einem Byte Null-Marker in 8 Bytes, legt die JVM die Objekte in Feldern und Arrays flach ab. Sind sie größer, belegen sie in veränderlichen Feldern und Arrays oft mehr Speicher als vorher und machen Schleifen langsamer.
- Konkrete Typen: Felder, Arrays und Parameter vom Typ
ObjectoderTverhindern Flattening und Scalarization. - Neu kompilieren: Klassen, die Value Classes verwenden, sollten neu kompiliert werden, damit die Value Classes in ihrem Attribut
LoadableDescriptorsstehen.
Für Bibliotheken wichtig: Ist eine Klasse schon final oder abstrakt und sind alle ihre Felder final – und wird diese Klasse dann auf eine Value Class umgestellt, dann müssen Anwendungen, die diese Klasse verwenden, nicht neu kompiliert werden. Sie laufen weiter, nur ohne Flattening, bis sie neu kompiliert sind (Punkt 10). Eine konkrete Klasse ohne final dagegen wird durch value implizit final – Unterklassen, die davon abgeleitet wurden, laden dann nicht mehr.
Und noch eine Warnung: Value Objects schützen keine geheimen Daten. Das Ergebnis von == und System.identityHashCode() hängt bei einem Value Object von dessen Feldwerten ab – wer beides auf fremde Objekte anwendet, kann so Rückschlüsse auf ihren Inhalt ziehen.
Wie es mit Valhalla weitergeht
Value Objects sind das erste von fünf Feature-Sets, die die Projektseite nennt. Die Tabelle zeigt ihren Stand am 14. November 2026:
| Feature-Set | JEP | Status |
|---|---|---|
| Value Objects | JEP 401, JEP 539 | integriert in Java 28 (Preview) |
| Null-Restricted Storage | Entwurf 8316779 | Draft |
| Array Enhancements | – | kein JEP |
| Unifying Primitives and Classes | JEP 402 | Draft |
| Parametric JVM | JEP 218 | Candidate, zuletzt geändert 2017 |
Null-Restricted Value Class Types
Als Nächstes nennt die Projektseite den Null-Restricted Storage, beschrieben im Entwurf Null-Restricted Value Class Types. Mit ihnen soll man eine Variable als Point! deklarieren können: Sie darf dann nie null sein. Für eine solche Variable braucht die JVM keinen Null-Marker – und ein Point(int x, int y) passt in 8 Bytes. Die JVM berechnet diese Layouts schon heute: NULL_FREE_ATOMIC_FLAT hat für Point 8 Bytes, für ShortPoint und Integer je 4 Bytes statt 8.
Das ! ist die aktuelle Arbeitssyntax, aber noch nicht festgelegt. Ein Prototyp, den das Valhalla-Team im Januar 2026 vorgestellt hat, erlaubt ! inzwischen an jedem Referenztyp, nicht nur an Value Classes – ausdrücklich als Zwischenstand, nicht als endgültige Fassung. Ein zweiter Entwurf, Null-Restricted and Nullable Types, sieht zusätzlich Foo? für Typen vor, die null bewusst zulassen.
Null-freie Arrays schon heute messen
Was null-freie Layouts bringen, lässt sich mit Java 28 schon messen. Eine Syntax für Integer! gibt es zwar noch nicht, doch die JVM kann null-freie Arrays bereits anlegen – über die JDK-interne Klasse jdk.internal.value.ValueClass, die nur mit --add-exports java.base/jdk.internal.value=ALL-UNNAMED zugänglich ist:
Integer[] integers = (Integer[]) ValueClass.newNullRestrictedAtomicArray(
    Integer.class, 100_000_000, 0);
Das dritte Argument, 0, ist der Wert, mit dem die JVM alle Elemente vorbelegt – mit null kann ein null-freies Array ja nicht beginnen. Damit habe ich den Benchmark aus dem Abschnitt Laufzeit erweitert (NullRestrictedArraySumBenchmark im selben Repository). Die Grafik zeigt die Werte für hundert Millionen Elemente in Reihenfolge; Point[] steht ohne Preview-Features für den gewöhnlichen Record IdentityPoint, mit Preview-Features für den ValuePoint:
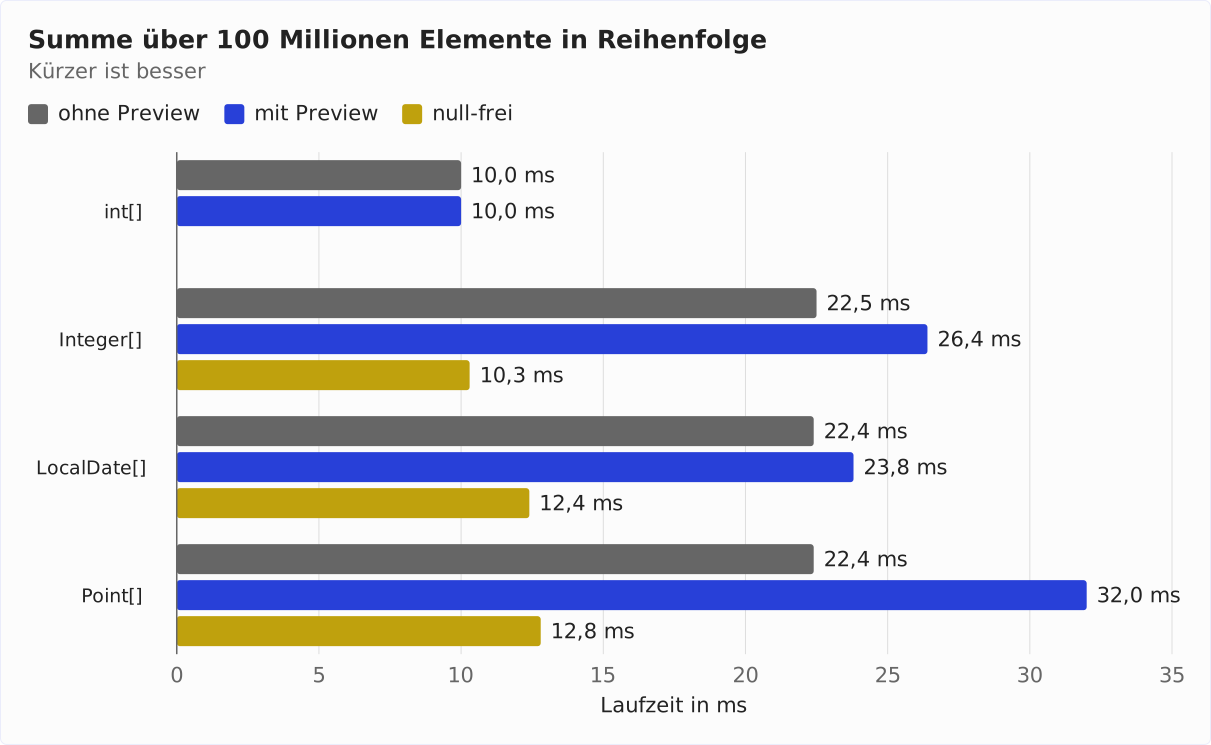
Ohne Null-Marker fällt die Prüfung bei jedem Element weg, und die Schleifen laufen fast doppelt bis zweieinhalbmal so schnell wie über die nullable flachen Arrays. Das null-freie Integer[] belegt nur noch 4 Bytes pro Element und ist so schnell wie int[]. Und Point liegt ohne Null-Marker mit 8 Bytes flach im Array: Die Schleife braucht 12,8 statt 32,0 ms – und ist damit auch schneller als über den gewöhnlichen Record mit 22,4 ms.
Primitive Typen und Generics
JEP 402 (Enhanced Primitive Boxing) soll primitive Typen näher an Referenztypen rücken – z. B. List<int> statt List<Integer> erlauben. Zur Laufzeit liegen die Werte aber weiterhin als Integer-Objekte in der Liste; der Compiler boxt sie beim Aufruf von add() und get(), ohne dass Integer im Code steht. Und JEP 218 (Generics over Primitive Types) soll generische Klassen wie List<T> für Value Classes spezialisieren, sodass auch ein T-Feld flach liegen kann.
Weitere offene Punkte
Auf Valhalla wartet außerdem die Vector API. Sie ist seit Java 16 ein Incubator-Feature, in Java 27 in der zwölften Runde. Für Java 28 gab es am 14. November 2026 noch keinen JEP.
Offen ist noch das Atomaritätsproblem aus dem Abschnitt Null-Marker und die 8-Byte-Grenze (veränderliche Felder und Array-Elemente legt die JVM nur flach ab, wenn sie sie in einem einzigen Zugriff schreiben kann – heute also mit höchstens 8 Bytes). JEP 401 nennt zwei Wege zu größeren flachen Feldern: 16 Bytes große atomare Felder auf Hardware, die das unterstützt, oder Value Classes, die auf Atomarität verzichten. Das Valhalla-Team setzt auf den zweiten Weg, denn Value Objects können jede Grenze für atomare Zugriffe überschreiten – so begründet es Brian Goetz in seiner Mail „On atomicity and tearing“.
Für diesen Verzicht gibt es im JDK schon die interne Annotation jdk.internal.vm.annotation.LooselyConsistentValue, aber noch keine Klasse in java.base trägt sie, und auf Sprachebene hat sie keine Entsprechung.
Fazit
- Value Objects sind Objekte ohne Identität. Mit
--enable-previewsind in Java 28 30 JDK-Klassen Value Classes, darunterInteger,OptionalundLocalDate. Eigene deklarierst du mitvalue classodervalue record. ==vergleicht Value Objects anhand ihrer Felder, rekursiv und Bit für Bit. Für Werte bleibtequals()der richtige Vergleich.- Ohne Identität gehen
synchronized,wait()/notify(), Weak References und Deep Reflection nicht mehr. Serialisierbare Value Classes, die keine Records sind, brauchenwriteReplace()undreadResolve(). - Konstruktoren von Value Classes setzen alle Felder vor dem Aufruf von
super(); die JVM erzwingt das mit JEP 539. Mit Preview-Features gilt das für alle Records – nicht nur für Value Records. - Die JVM legt Value Objects flach in veränderlichen Feldern und Arrays ab, wenn sie zusammen mit einem Byte Null-Marker in 8 Bytes passen, und hält sie im kompilierten Code in Registern. Eine Million
LocalDates belegen dann 8 statt 20 MB. - Flache Arrays machen Schleifen schneller, wenn die Objekte verstreut im Heap liegen: Eine Schleife über hundert Millionen verstreut angelegter
LocalDates braucht mit Preview-Features 23,5 statt 373 ms. Liegen die Objekte ohnehin hintereinander, ist das flache Array nicht schneller. - Passt ein Value Object zusammen mit seinem Null-Marker nicht in 8 Bytes, legt die JVM es nicht flach ab. Es belegt dann oft mehr Speicher als ein gewöhnliches Objekt und macht Schleifen langsamer: Eine Million
Point(int x, int y)belegen 28 statt 20 MB, und die Schleife darüber braucht bis zu 59 % länger.
Ich empfehle dir, Value Objects jetzt mit dem Early-Access-Build auszuprobieren und deinen Code mit der Checkliste vorzubereiten: equals() statt ==, keine Synchronisation auf value-based Klassen, Factory-Methoden statt öffentlicher Konstruktoren. Umstellen solltest du erst, wenn Value Objects final sind – und dann gezielt die kleinen Klassen, die die JVM flach ablegen kann.
Wenn dir dieser Artikel gefallen hat, freue ich mich über eine Bewertung auf meinem ProvenExpert-Profil.