Moderne Prozessoren führen nicht nur eine Addition auf einmal aus, sondern vier, acht oder sogar 64 – mit einem einzigen Befehl. Die Java Vector API gibt dir aus Java heraus Zugriff auf diese Befehle. Sie liegt seit Java 16 als Incubator-Modul jdk.incubator.vector im JDK; Java 27 enthält ihre zwölfte Incubator-Runde.
Mit der Klasse java.util.Vector, der synchronisierten Liste aus Java 1.0, hat die Vector API nichts zu tun.
In diesem Artikel erfährst du:
- Was SIMD ist und was die Vector API daraus macht
- Was der JIT-Compiler ohne die Vector API vektorisiert – und was nicht
- Wie du zwei Arrays mit der Vector API addierst, mit Rest-Schleife oder mit Maske
- Aus welchen Bausteinen die API besteht: Species, Shapes, Masken, Operatoren und Shuffles
- Wie du mit Vektoren rechnest, vergleichst, reduzierst, filterst, umsortierst und umwandelst
- Wie eine Kosinus-Ähnlichkeit und eine Byte-Suche mit der Vector API aussehen
- Welchen Maschinencode der C2-Compiler aus der Vector API erzeugt
- Wann Vektoren als Objekte auf dem Heap landen und wann nicht
- Wie viel schneller deine Schleifen mit der Vector API werden – und wann sie langsamer werden
- Warum die API seit Java 16 im Incubator steckt und was sie mit Project Valhalla zu tun hat
- Wann sich die Vector API für dich lohnt
Alle Beispielprogramme, die Benchmarks und den Maschinencode findest du im GitHub-Repository java-vector-api. Die Ausgaben in diesem Artikel stammen von Java 27 (Build 27+35) auf einem Apple M5 Pro.
Was ist die Vector API?
Ein gewöhnlicher Rechenbefehl verarbeitet einen einzelnen Wert. Man nennt solche Werte und Befehle skalar. Ein Vektorbefehl verarbeitet dagegen mehrere Werte auf einmal: Er addiert z. B. vier float-Paare, wo ein skalarer Befehl nur ein Paar addiert. Das Prinzip heißt SIMD (Single Instruction, Multiple Data).
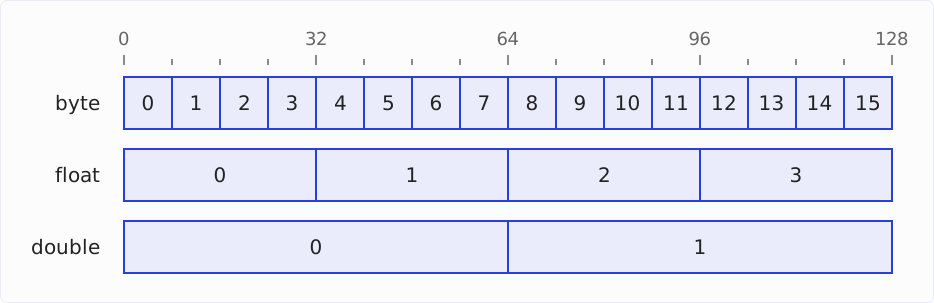
Die Werte liegen dazu nebeneinander in einem Vektorregister der CPU, das je nach Prozessor 128, 256 oder 512 Bit breit ist. Jeden Platz in einem solchen Register nennt man Lane (Spur). Wie groß eine Lane ist und wie viele Lanes ein Register hat, steht nicht fest: Es hängt vom Datentyp der Werte ab, die gerade darin liegen. Ein 128-Bit-Register hat z. B. 16 Lanes zu je 8 Bit für byte-Werte, vier Lanes zu je 32 Bit für float-Werte oder zwei Lanes zu je 64 Bit für double-Werte.
Die Grafik zeigt ein 128-Bit-Register in diesen drei Aufteilungen, die Skala oben zählt die Bits:
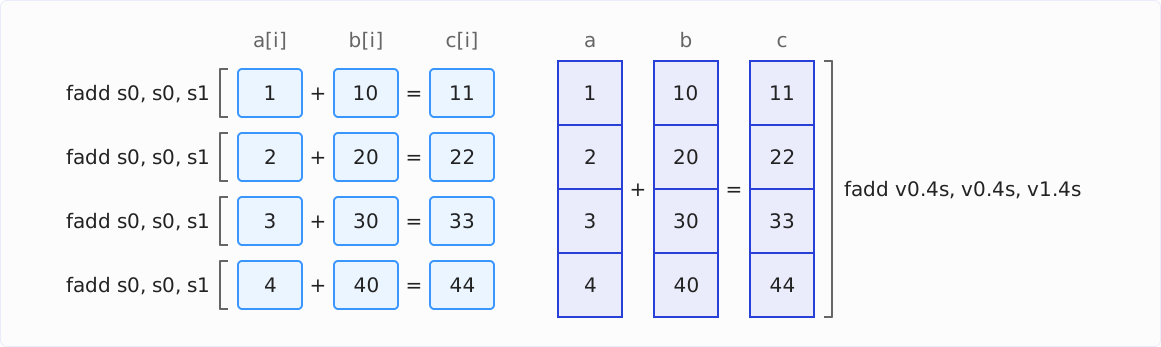
Die folgende Grafik zeigt links vier skalare Additionen mit dem ARM-Befehl fadd s0, s0, s1, rechts dieselben vier Additionen als einen Vektorbefehl fadd v0.4s, v0.4s, v1.4s. s0 und s1 sind Register für je einen 32-Bit-Gleitkommawert, v0 und v1 sind 128-Bit-Vektorregister, und die Endung .4s liest sie als vier Lanes zu je 32 Bit. Das Ziel steht bei beiden Befehlen vorn: fadd s0, s0, s1 addiert s0 und s1 und schreibt das Ergebnis nach s0.
Beide verbreiteten CPU-Architekturen haben solche Befehle: x86-Prozessoren haben die Streaming SIMD Extensions (SSE) und die Advanced Vector Extensions (AVX, AVX2, AVX-512), ARM-Prozessoren haben NEON und die Scalable Vector Extension (SVE).
Ohne die Vector API setzt nur der JIT-Compiler diese Befehle ein: Er übersetzt eine Schleife von selbst in Vektorbefehle, aber nur, wenn sie bestimmte Bedingungen erfüllt – mehr dazu im Abschnitt „Was vektorisiert der JIT-Compiler von selbst?“. Die Vector API, definiert durch JDK Enhancement Proposal 338 und zuletzt JEP 537, lässt dich solche Berechnungen direkt in Java hinschreiben. Der JEP nennt dafür diese Ziele:
- Klare, knappe API: Eine Berechnung lässt sich so schreiben, dass sie nicht von der Vektorgröße der CPU abhängt – derselbe Code läuft mit 128 wie mit 512 Bit breiten Registern.
- Plattformunabhängig: Die API ist nicht an eine CPU-Architektur gebunden. Wo Portabilität und Optimierung für eine bestimmte CPU kollidieren, gewinnt die Portabilität.
- Zuverlässige Übersetzung auf x64 und AArch64: Der C2-Compiler der HotSpot-JVM übersetzt die Vektoroperationen auf x64, der 64-Bit-Variante von x86, in SSE- und AVX-Befehle und auf AArch64, der 64-Bit-Architektur von ARM, in NEON- und SVE-Befehle.
- Graceful Degradation: Unterstützt die CPU eine Operation nicht, funktioniert der Code trotzdem, nur langsamer.
- Anschluss an Project Valhalla: Die Vektorklassen sollen zu Value Classes werden. Dazu mehr im Abschnitt „Warum ist die Vector API noch im Incubator?“.
Die Vector API ausprobieren
Die Vector API ist ein Incubator-Modul: eine API, die im JDK enthalten ist, um Feedback zu sammeln, und die sich bis zur Fertigstellung noch ändern kann. Wird sie fertiggestellt, bekommt sie ein neues Package; dann musst du mindestens deine import-Anweisungen anpassen (JEP 11).
Ein Incubator-Modul ist nicht automatisch sichtbar. Du musst es beim Kompilieren und beim Ausführen mit --add-modules jdk.incubator.vector hinzufügen:
javac --add-modules jdk.incubator.vector AddArrays.java
java --add-modules jdk.incubator.vector AddArrays
Mit dem Source-Code-Launcher geht es in einem Schritt:
java --add-modules jdk.incubator.vector AddArrays.javaDie JVM quittiert das bei jedem Start mit dieser Warnung:
WARNING: Using incubator modules: jdk.incubator.vectorWas vektorisiert der JIT-Compiler von selbst?
Der C2-Compiler der HotSpot-JVM übersetzt einfache Schleifen auch ohne die Vector API in Vektorbefehle. Diese Auto-Vectorization heißt in HotSpot SuperWord und ist standardmäßig aktiv (VM-Option -XX:+UseSuperWord).
Die folgende Methode (im Repository: jit/JitDemo.java) addiert zwei int-Arrays elementweise:
void addScalar(int[] a, int[] b, int[] c) {
  for (int i = 0; i < a.length; i++) {
    c[i] = a[i] + b[i];
  }
}
C2 macht daraus auf dem M5 Pro eine Schleife aus Vektorbefehlen. Hier ein Ausschnitt aus der Ausgabe von -XX:CompileCommand=print:
ldur  q16, [x12, #0xc]        ; vier ints laden
ldur  q17, [x13, #0xc]        ; vier ints aus dem anderen Array laden
add   v16.4s, v16.4s, v17.4s  ; vier Additionen mit einem Befehl
add   x11, x4, x11
stur  q16, [x11, #0xc]        ; vier ints nach c schreiben
q16 und q17 sind 128-Bit-Register, v16.4s heißt: dasselbe Register, gelesen als vier 32-Bit-Lanes. C2 hat die Schleife außerdem achtfach abgerollt: Diese Gruppe aus Laden, Addieren und Speichern steht im Schleifenrumpf achtmal hintereinander, ein Schleifendurchlauf addiert also 32 int-Werte.
Was die Auto-Vectorization deinem Code bringt, kannst du selbst herausfinden: Führ ihn einmal normal und einmal mit -XX:-UseSuperWord aus und vergleiche die Laufzeiten. Für die Array-Addition steht das Ergebnis im Abschnitt „Zwei Arrays addieren“.
Wo die Auto-Vectorization an ihre Grenze stößt, zeigt eine Schleife, die vorzeitig abbricht, sobald sie etwas gefunden hat. Die folgende Methode, ebenfalls aus jit/JitDemo.java, sucht das erste Vorkommen eines Bytes:
int indexOfScalar(byte[] data, byte b) {
  for (int i = 0; i < data.length; i++) {
    if (data[i] == b) return i;
  }
  return -1;
}
Diese Schleife lässt C2 in Java 27 skalar. Sie ist ebenfalls achtfach abgerollt, aber jedes Byte bekommt seinen eigenen Ladebefehl, seinen eigenen Vergleich und seinen eigenen bedingten Sprung:
ldrsb  w14, [x12, #0xc]  ; Byte 0 laden
cmp    w14, w3           ; mit b vergleichen
b.eq   #0x1229d5dc0      ; gefunden: Schleife verlassen
ldrsb  w14, [x12, #0xd]  ; Byte 1 laden
cmp    w14, w3
b.eq   #0x1229d5db0
...
Der JEP beschreibt das Problem so: Welche Schleifen die Auto-Vectorization erkennt, ist begrenzt und hängt von der Form des Codes ab. Schon eine kleine Umstellung kann dazu führen, dass eine Schleife nicht mehr vektorisiert wird. Besonders schwer wird es bei komplexen Zugriffsmustern, Umsortierungen zwischen Lanes, Masken und verzweigter Kontrolle. Selbst im JDK brauchten deshalb Methoden wie Arrays.hashCode() eigens geschriebene Vektorunterstützung.
Mit der Vector API schreibst du die Vektorisierung dagegen selbst hin – und C2 übersetzt sie zuverlässig. Wie die Byte-Suche damit aussieht und was C2 daraus macht, zeige ich im Abschnitt „Was der JIT-Compiler aus der Vector API macht“.
Erste Schritte: zwei Arrays addieren
Das erste Beispiel, das Programm AddArrays (im Repository: firststeps/AddArrays.java), addiert zwei float-Arrays mit der Vector API. Die Arrays haben je zehn Elemente:
import jdk.incubator.vector.*;

static final VectorSpecies<Float> SPECIES = FloatVector.SPECIES_PREFERRED;

void main() {
  float[] a = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
  float[] b = {10, 20, 30, 40, 50, 60, 70, 80, 90, 100};

  IO.println("Lanes:      " + SPECIES.length());
  IO.println("Loop bound: " + SPECIES.loopBound(a.length));

  float[] c = new float[a.length];
  addWithTailLoop(a, b, c);
  IO.println("Tail loop:  " + Arrays.toString(c));
}

void addWithTailLoop(float[] a, float[] b, float[] c) {
  int i = 0;
  int upperBound = SPECIES.loopBound(a.length);
  for (; i < upperBound; i += SPECIES.length()) {
    FloatVector va = FloatVector.fromArray(SPECIES, a, i);
    FloatVector vb = FloatVector.fromArray(SPECIES, b, i);
    FloatVector vc = va.add(vb);
    vc.intoArray(c, i);
  }
  for (; i < a.length; i++) {
    c[i] = a[i] + b[i];
  }
}
Die Methode addWithTailLoop() geht so vor:
SPECIESlegt fest, mit welcher Art von Vektor wir rechnen:float-Werte in der Vektorgröße, die die CPU bevorzugt. Was eine Species genau ist, steht im Abschnitt „Die Bausteine der Vector API“.SPECIES.length()liefert die Anzahl der Lanes, also wie vielefloat-Werte in einen Vektor passen. Um diesen Wert rückt die Schleifeiin jedem Durchlauf weiter.SPECIES.loopBound(a.length)rundet die Array-Länge auf ein Vielfaches der Lane-Anzahl ab. Bis zu diesem Index arbeitet die Vektorschleife das Array in ganzen Vektoren ab; was dahinter liegt, füllt keinen ganzen Vektor mehr.FloatVector.fromArray()lädt so viele Elemente ab Indexiin einen Vektor, wie die Species Lanes hat.va.add(vb)addiert die beiden Vektoren Lane für Lane.vc.intoArray(c, i)schreibt das Ergebnis ab Indexizurück in das Arrayc.- Die zweite, skalare Schleife verarbeitet schließlich den Rest, der nicht mehr in einen ganzen Vektor passt.
Auf dem M5 Pro gibt das Programm Folgendes aus:
Lanes:      4
Loop bound: 8
Tail loop:  [11.0, 22.0, 33.0, 44.0, 55.0, 66.0, 77.0, 88.0, 99.0, 110.0]
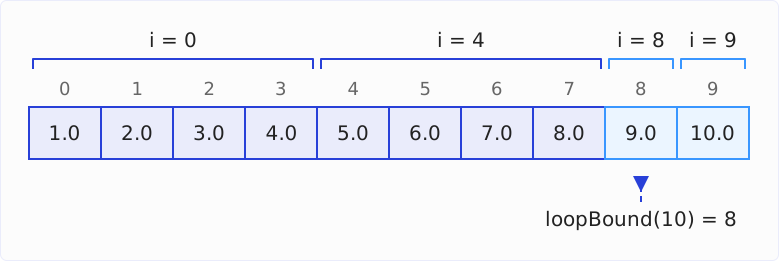
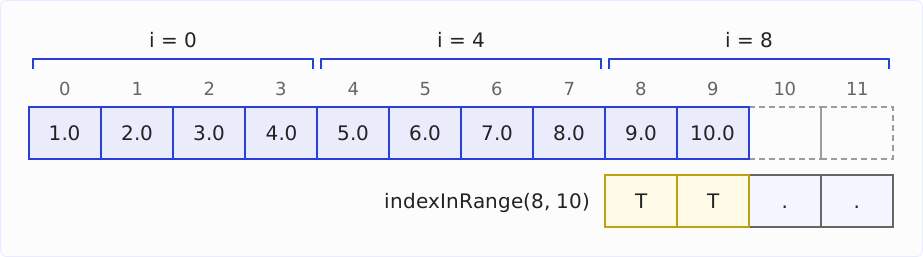
Die bevorzugte Species hat hier vier Lanes. Die Vektorschleife läuft also zweimal (für die Indizes 0 bis 3 und 4 bis 7) und addiert dabei acht Elemente, die Rest-Schleife verarbeitet die Indizes 8 und 9. Die Grafik zeigt diese Aufteilung, die Elemente der Rest-Schleife heller eingefärbt:
Mit Maske statt Rest-Schleife
Die Rest-Schleife lässt sich auch vermeiden: Der letzte Durchlauf lädt und schreibt dann nur die Lanes, die noch im Array liegen. Dafür gibt es Masken – je Lane ein boolean, der festlegt, ob eine Operation diese Lane bearbeitet. Die folgende Methode steht ebenfalls in firststeps/AddArrays.java:
static final VectorSpecies<Float> SPECIES = FloatVector.SPECIES_PREFERRED;

void addWithMask(float[] a, float[] b, float[] c) {
  for (int i = 0; i < a.length; i += SPECIES.length()) {
    VectorMask<Float> m = SPECIES.indexInRange(i, a.length);
    FloatVector va = FloatVector.fromArray(SPECIES, a, i, m);
    FloatVector vb = FloatVector.fromArray(SPECIES, b, i, m);
    FloatVector vc = va.add(vb);
    vc.intoArray(c, i, m);
  }
}
SPECIES.indexInRange(i, a.length) liefert eine Maske, die genau die Lanes einschaltet, deren Index kleiner als a.length ist. In den ersten beiden Durchläufen sind alle vier Lanes eingeschaltet. Im dritten Durchlauf, bei i = 8, nur die ersten beiden, die Lanes für die Indizes 8 und 9. Die Lanes für die Indizes 10 und 11 liegen hinter dem Array-Ende und sind daher ausgeschaltet. Dank der Maske greifen fromArray() und intoArray() dort nicht zu und werfen keine IndexOutOfBoundsException.
Die Grafik zeigt die drei Vektordurchläufe für das Array mit zehn Elementen. Den letzten beschränkt die Maske aus indexInRange(8, 10) auf zwei Lanes. T steht dabei für eine eingeschaltete Lane (true), . für eine ausgeschaltete – so gibt auch toString() eine Maske aus:
Im Programm firststeps/AddArrays.java ruft main() auch diese Methode auf, mit denselben Arrays a und b:
float[] d = new float[a.length];
addWithMask(a, b, d);
IO.println("Mask:       " + Arrays.toString(d));
Das Ergebnis ist dasselbe wie mit der Rest-Schleife:
Mask: [11.0, 22.0, 33.0, 44.0, 55.0, 66.0, 77.0, 88.0, 99.0, 110.0]Die Masken-Variante ist kürzer, aber nicht immer schneller. Der JEP empfiehlt sie grundsätzlich, schränkt aber ein: Auf CPUs ohne sogenannte Predicate-Register (Register, die eine Maske direkt aufnehmen) ist sie in der Regel langsamer, und selbst auf CPUs mit Predicate-Registern können maskierte Operationen langsamer sein als unmaskierte. Predicate-Register haben AVX-512 und SVE, NEON und AVX2 haben keine.
Auf dem M5 Pro mit NEON zeigt die Messung das deutlich, und zwar in zwei Stufen. Ist die Array-Länge ein Vielfaches der Lane-Anzahl, ist die Maske in jedem Durchlauf voll; dann braucht die Addition ab 100 Elementen 21 bis 71 % länger als mit Rest-Schleife. Bleibt ein Rest, braucht der letzte Durchlauf eine Teilmaske. Dann legt jeder Durchlauf Vektorobjekte auf dem Heap an, nicht nur der letzte, und die Addition dauert ein Vielfaches – bei 1.003 Elementen 48-mal so lange.
Auf dem i7-12700H mit AVX2 legt C2 keine Objekte an, die Maske kostet aber auch dort: Mit voller Maske braucht die Addition von 1.000 Elementen 30 % länger als mit Rest-Schleife, mit zusätzlich einer Teilmaske am Ende dauert sie bei 1.003 Elementen knapp dreimal so lange.
Warum müssen wir die Schleife selbst schreiben?
Ob mit Rest-Schleife oder mit Maske – die Schleife über das Array musst du selbst schreiben. Eine Methode „addiere diese beiden Arrays“ gibt es in der Vector API nicht. Eine ausdrückliche Begründung dafür habe ich weder in den JEPs noch auf der Mailingliste der Entwickler gefunden. Aber die Entwickler sehen die handgeschriebene Schleife selbst als offenes Problem:
- Schon der erste JEP, JEP 338, nennt die Berechnung der Schleifengrenze eine häufige Fehlerquelle und die Rest-Schleife doppelten Code. Für die Schleifengrenze gibt es seitdem
loopBound(), den doppelten Code verschiebt der JEP auf spätere Arbeiten. - Die Masken-Variante würde der aktuelle JEP 537 für alle Plattformen empfehlen – nur sei sie heute nicht immer optimal. C2 könnte den letzten Durchlauf abtrennen und die Maske aus der Schleife entfernen; das bleibe aber ein Bereich für weitere Untersuchungen. Was das heute kostet, hast du gerade gesehen: Auf dem M5 Pro dauerte die Addition von 1.003 Elementen mit Teilmaske 48-mal so lange wie mit Rest-Schleife.
- Eine höhere Abstraktionsebene war von Anfang an das Ziel. Auf einem Treffen des JIT-Compiler-Teams im Januar 2017 nannte Vladimir Ivanov als „Ultimate Goal“ Code wie
Vector<int,?>.map(arr, i -> i + 1): eine Methode, die einen Lambda-Ausdruck auf ein ganzes Array anwendet. Die Folie nennt drei Voraussetzungen dafür: Value Types, Generics mit primitiven Typen wieVector<int>und Lambda-Ausdrücke, in die der JIT-Compiler hineinsehen kann, um ihre Rechnung in Vektorbefehle zu übersetzen. Im August 2018 schrieb er auf der Mailingliste panama-dev, solche Ansätze hätten es „aus verschiedenen Gründen“ noch nicht in die Vector API geschafft.
Value Types und Generics mit primitiven Typen sind heute Teil von Project Valhalla, auf das die Vector API ohnehin wartet. Bis dahin ist sie die untere Schicht: Sie gibt dir die Vektorbefehle in die Hand, Schleife und Rest organisierst du vorerst selbst.
Wie eine höhere Abstraktionsebene darauf aussehen kann, zeigte Paul Sandoz, einer der Autoren der Vector API, in seinem Vortrag „Java for AI“ auf der JavaOne 2025: eine Matrix-API, die elementweise Operationen als Lambda-Ausdruck annimmt. Die Vector-API-Fassung dahinter sei derzeit von Hand geschrieben; künftig könne Code Reflection den Lambda-Ausdruck automatisch vektorisieren.
Die Bausteine der Vector API
Im ersten Beispiel kamen schon fast alle Typen der Vector API vor. Hier sind sie im Überblick.
Vector und die Elementtypen
Ein Vektor ist eine Instanz der abstrakten Klasse Vector<E>. Der Typparameter E ist der Wrapper-Typ des Elementtyps – z. B. Float für float-Werte –, denn Generics funktionieren in Java (noch) nicht mit primitiven Typen.
Für jeden der sechs unterstützten Elementtypen gibt es eine abstrakte Unterklasse: ByteVector, ShortVector, IntVector, LongVector, FloatVector und DoubleVector. Sie enthalten die Methoden, deren Signatur den primitiven Typ nennt – z. B. fromArray(VectorSpecies<Float>, float[], int) oder reduceLanes(), das einen float zurückgibt. char- und boolean-Vektoren gibt es nicht.
Die konkreten Klassen dahinter – FloatVector128, IntVector256 und so weiter – sind nicht öffentlich. Instanzen bekommst du ausschließlich über Factory-Methoden wie fromArray(), zero() oder broadcast().
VectorShape und VectorSpecies
Die Shape eines Vektors ist seine Größe in Bit. Das Enum VectorShape hat fünf Konstanten: S_64_BIT, S_128_BIT, S_256_BIT, S_512_BIT und S_Max_BIT – die größte Shape, die die CPU unterstützt. S_Max_BIT ist eine eigene Konstante, deren Größe die JVM erst beim Start festlegt: auf dem M5 Pro 128 Bit, auf einem x86-Prozessor mit AVX2 256 Bit. Sie muss nicht einer der anderen vier Größen entsprechen: ARM-CPUs mit SVE können Vektorregister bis 2.048 Bit haben, und die Dokumentation der Vector API nennt sogar 384 Bit als mögliche Größe.
Elementtyp (int, long, float usw.) und Shape (Größe in Bit) zusammen ergeben die Species (Interface VectorSpecies<E>). Aus ihr folgt die Lane-Anzahl: Eine 256-Bit-Species für float z. B. hat acht Lanes, eine 128-Bit-Species für byte 16 Lanes. Jede Vektorklasse bietet die Species als Konstanten an, z. B. FloatVector.SPECIES_256 oder IntVector.SPECIES_MAX.
SPECIES_PREFERRED ist die Species, die die JVM auf der aktuellen CPU für am schnellsten hält. Damit schreibst du Code, der auf jeder CPU die volle Registerbreite nutzt. Das Programm PreferredSpecies (im Repository: species/PreferredSpecies.java) gibt sie für alle sechs Elementtypen aus:
List<VectorSpecies<?>> species =
    List.of(
        ByteVector.SPECIES_PREFERRED,
        ShortVector.SPECIES_PREFERRED,
        IntVector.SPECIES_PREFERRED,
        LongVector.SPECIES_PREFERRED,
        FloatVector.SPECIES_PREFERRED,
        DoubleVector.SPECIES_PREFERRED);

for (VectorSpecies<?> s : species) {
  int bits = s.vectorBitSize();
  IO.println(s.elementType() + ": " + bits + " bits, " + s.length() + " lanes");
}
IO.println("Largest shape: " + VectorShape.S_Max_BIT.vectorBitSize() + " bits");
Auf dem M5 Pro liegt jede bevorzugte Species bei 128 Bit – der Breite der NEON-Register:
byte: 128 bits, 16 lanes
short: 128 bits, 8 lanes
int: 128 bits, 4 lanes
long: 128 bits, 2 lanes
float: 128 bits, 4 lanes
double: 128 bits, 2 lanes
Largest shape: 128 bits
Auf dem Intel Core i7-12700H mit AVX2 liefert dasselbe Programm 256 Bit breite Species:
byte: 256 bits, 32 lanes
short: 256 bits, 16 lanes
int: 256 bits, 8 lanes
long: 256 bits, 4 lanes
float: 256 bits, 8 lanes
double: 256 bits, 4 lanes
Largest shape: 256 bits
Derselbe Java-Code verarbeitet dort also pro Befehl doppelt so viele Elemente wie auf dem M5 Pro. Ob der i7 dadurch auch schneller rechnet, zeigt der Abschnitt „Messung“.
Eine Species speicherst du am besten in einer static final-Konstante, wie in allen Beispielen dieses Artikels. Das Javadoc von VectorSpecies erlaubt auch lokale Variablen und Parameter, warnt aber: In anderen Feldern oder in Arrays kann eine Species Performance kosten.
VectorMask
Eine Maske (VectorMask<E>) enthält für jede Lane einen boolean. Du hast schon gesehen, wie indexInRange() eine Maske erzeugt. Häufiger entsteht sie aus einem Vergleich (compare()), und viele Operationen nehmen eine Maske als zusätzliches Argument, um nur bestimmte Lanes zu bearbeiten. Ihre toString()-Ausgabe schreibt T für eine eingeschaltete und . für eine ausgeschaltete Lane: Mask[TT..].
Auf CPUs mit Predicate-Registern landet eine Maske direkt in einem solchen Register. Auf den anderen bildet C2 sie in einem gewöhnlichen Vektorregister nach.
VectorOperators und lanewise()
Für die häufigsten Operationen haben die Vektorklassen eigene Methoden: add(), sub(), mul(), div(), min(), max(), neg(), abs() und einige mehr. Alle anderen Operationen rufst du über die allgemeine Methode lanewise() auf – mit einer Konstante aus der Klasse VectorOperators als erstem Argument, z. B. v.lanewise(VectorOperators.SQRT). So bleibt die Zahl der Methoden überschaubar, obwohl VectorOperators in Java 27 insgesamt 69 Operatoren und 40 Typumwandlungen definiert.
Nicht jeder Operator passt zu jedem Elementtyp. SQRT, FMA und die Winkelfunktionen wie SIN gibt es nur für float und double, Bit-Operatoren wie AND, OR und LSHL nur für ganzzahlige Typen. Weil lanewise() jeden Operator annimmt, fällt ein Fehler erst zur Laufzeit auf: Auf einem IntVector wirft lanewise(SQRT) diese Exception:
java.lang.UnsupportedOperationException: SQRT: inapplicable floating point operatorBei den eigenen Methoden merkt es schon der Compiler: IntVector hat gar keine Methode fma().
VectorShuffle
Ein Shuffle (VectorShuffle<E>) ist eine Liste von Lane-Indizes. Er beschreibt, aus welcher Lane des Quellvektors jede Lane des Ergebnisses ihren Wert holt. Damit verschiebst du Werte zwischen Lanes – das zeigt der Abschnitt „Umsortieren mit rearrange() und selectFrom()“.
Operationen, die Lane für Lane arbeiten, heißen in der API lane-wise; Operationen über mehrere Lanes hinweg, wie das Umsortieren oder das Aufsummieren aller Lanes, heißen cross-lane.
Operationen an Beispielen
Die folgenden Beispiele verwenden 128-Bit-Species, damit ihre Ausgabe auf jeder CPU gleich ist. In eigenem Code solltest du in der Regel SPECIES_PREFERRED nehmen.
Rechnen
Das erste Beispiel (im Repository: operations/Arithmetic.java) zeigt die Rechenoperationen an zwei Vektoren mit je vier float-Werten:
import static jdk.incubator.vector.VectorOperators.*;

import jdk.incubator.vector.*;

static final VectorSpecies<Float> SPECIES = FloatVector.SPECIES_128;

void main() {
  FloatVector a = FloatVector.fromArray(SPECIES, new float[] {1, 4, 9, 16}, 0);
  FloatVector b = FloatVector.fromArray(SPECIES, new float[] {2, 3, -4, 5}, 0);

  IO.println("a + b         = " + a.add(b));
  IO.println("a * b         = " + a.mul(b));
  IO.println("a * 10        = " + a.mul(10));

  // Fused Multiply-Add: a * b + 100 in einem Schritt
  FloatVector hundred = FloatVector.broadcast(SPECIES, 100);
  IO.println("a * b + 100   = " + a.fma(b, hundred));

  // alle übrigen Operatoren über lanewise()
  IO.println("sqrt(a)       = " + a.lanewise(SQRT));
  IO.println("abs(b)        = " + b.lanewise(ABS));
  IO.println("max(a, b)     = " + a.lanewise(MAX, b));
}
Die Ausgabe:
a + b         = [3.0, 7.0, 5.0, 21.0]
a * b         = [2.0, 12.0, -36.0, 80.0]
a * 10        = [10.0, 40.0, 90.0, 160.0]
a * b + 100   = [102.0, 112.0, 64.0, 180.0]
sqrt(a)       = [1.0, 2.0, 3.0, 4.0]
abs(b)        = [2.0, 3.0, 4.0, 5.0]
max(a, b)     = [2.0, 4.0, 9.0, 16.0]
Zu beachten:
a.mul(10)nimmt einen Skalar. Die API verteilt ihn auf alle Lanes und multipliziert jede Lane vonamit 10.FloatVector.broadcast(SPECIES, 100)macht dieses Verteilen ausdrücklich: Es erzeugt einen Vektor, in dem jede Lane den Wert 100 hat, also[100.0, 100.0, 100.0, 100.0]. Das Beispiel braucht ihn, weil esfma()nur mit zwei Vektoren oder mit zwei Skalaren gibt – für den Vektorbund die Zahl 100 muss die 100 erst zum Vektor werden.fma()steht für Fused Multiply-Add: Multiplikation und Addition in einem Befehl, mit nur einer Rundung am Ende.abs()undmax()gibt es auch als eigene Methoden. Die beidenlanewise()-Aufrufe zeigen nur, dasslanewise()für jeden Operator funktioniert.
Vergleichen und blend(): Bedingungen ohne Sprung
Eine if-Anweisung entscheidet für jeden Wert einzeln, welcher Zweig läuft. In einem Vektor müssten die Lanes dann verschiedene Wege gehen, und das kann ein Vektorbefehl nicht. Die Vector API geht deshalb anders vor: Sie prüft die Bedingung für alle Lanes auf einmal, hält das Ergebnis in einer Maske fest und wählt dann für jede Lane anhand der Maske den Wert aus – den Ersatzwert, wo die Bedingung zutrifft, sonst den ursprünglichen Wert.
Das folgende Beispiel (im Repository: operations/CompareAndBlend.java) ersetzt alle negativen Werte durch 0 – skalar wäre das values[i] < 0 ? 0 : values[i]:
import static jdk.incubator.vector.VectorOperators.*;

import jdk.incubator.vector.*;

static final VectorSpecies<Float> SPECIES = FloatVector.SPECIES_128;

void main() {
  float[] values = {-1.5f, 2.0f, -0.5f, 3.0f, 4.0f, -2.0f, 0.0f, 1.0f};
  float[] result = new float[values.length];

  for (int i = 0; i < values.length; i += SPECIES.length()) {
    FloatVector v = FloatVector.fromArray(SPECIES, values, i);
    VectorMask<Float> negative = v.compare(LT, 0);
    FloatVector clamped = v.blend(0, negative);

    IO.println(v + " -> mask " + negative + " -> " + clamped);
    clamped.intoArray(result, i);
  }

  IO.println(Arrays.toString(result));
}
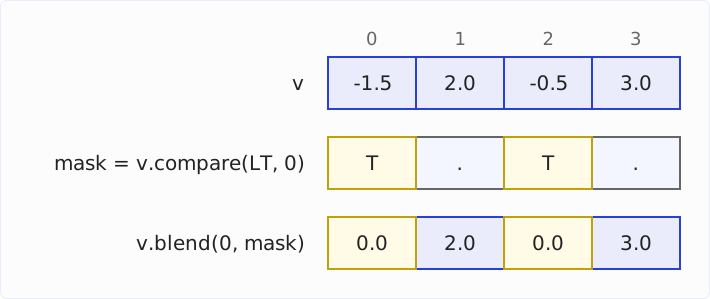
v.compare(LT, 0) prüft für jede Lane, ob ihr Wert kleiner als 0 ist – LT steht für „less than“ –, und liefert eine Maske mit T für jede negative Lane. Die übrigen Vergleiche heißen entsprechend EQ (equal, gleich), NE (not equal, ungleich), LE (less than or equal, kleiner oder gleich), GT (greater than, größer) und GE (greater than or equal, größer oder gleich).
v.blend(0, negative) übernimmt in jede Lane, deren Masken-Bit gesetzt ist, den Wert 0 und lässt die übrigen Lanes unverändert:
[-1.5, 2.0, -0.5, 3.0] -> mask Mask[T.T.] -> [0.0, 2.0, 0.0, 3.0]
[4.0, -2.0, 0.0, 1.0] -> mask Mask[.T..] -> [4.0, 0.0, 0.0, 1.0]
[0.0, 2.0, 0.0, 3.0, 4.0, 0.0, 0.0, 1.0]
Die Grafik zeigt die drei Stufen für den ersten Vektor:
Für genau diesen Fall gäbe es auch v.max(0). Das Muster aus compare() und blend() funktioniert aber für jede Bedingung und jeden Ersatzwert.
Reduktionen
Eine Reduktion fasst alle Lanes eines Vektors zu einem einzigen Wert zusammen, z. B. zur Summe oder zum Maximum. Dafür muss sie Werte verschiedener Lanes miteinander verrechnen. Eine solche Cross-Lane-Operation ist teurer als eine Lane-wise-Operation, bei der jede Lane für sich bleibt.
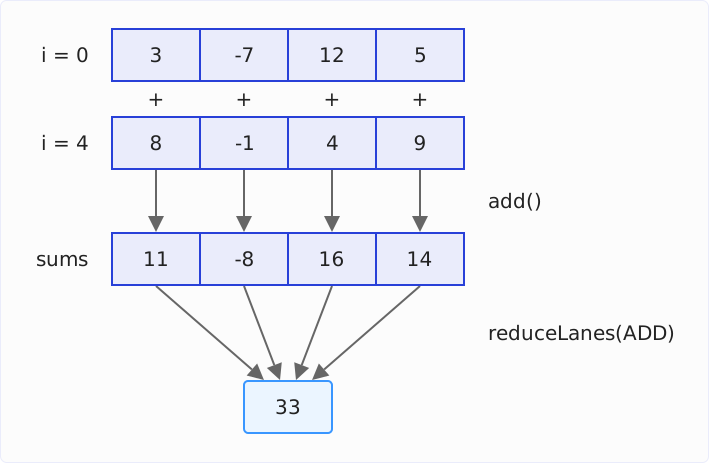
Für die Summe eines Arrays reduzierst du deshalb nicht in jedem Schleifendurchlauf. Die Schleife addiert stattdessen jeden geladenen Vektor Lane für Lane auf einen Summen-Vektor. Bei vier Lanes sammelt Lane 0 so die Elemente 0, 4, 8 usw., Lane 1 die Elemente 1, 5, 9 usw. Erst nach der Schleife fasst eine einzige Reduktion die vier Teilsummen zu einem Ergebnis zusammen.
Die Grafik zeigt die beiden Stufen an den ersten acht Elementen des folgenden Programms. Die Schleife addiert zwei Vektoren Lane für Lane auf den Summen-Vektor sums, danach fasst reduceLanes(ADD) dessen vier Lanes zu 33 zusammen:
Das folgende Programm (im Repository: operations/Reductions.java) berechnet auf diese Weise die Summe und das Maximum von zehn int-Werten:
import static jdk.incubator.vector.VectorOperators.*;

import jdk.incubator.vector.*;

static final VectorSpecies<Integer> SPECIES = IntVector.SPECIES_128;

void main() {
  int[] values = {3, -7, 12, 5, 8, -1, 4, 9, 2, 6};

  // Lane für Lane sammeln, erst am Ende zu einem Skalar reduzieren
  IntVector sums = IntVector.zero(SPECIES);
  IntVector maxima = IntVector.broadcast(SPECIES, Integer.MIN_VALUE);
  int i = 0;
  for (; i < SPECIES.loopBound(values.length); i += SPECIES.length()) {
    IntVector v = IntVector.fromArray(SPECIES, values, i);
    sums = sums.add(v);
    maxima = maxima.max(v);
  }
  IO.println("Lane sums:   " + sums);
  IO.println("Lane maxima: " + maxima);

  int sum = sums.reduceLanes(ADD);
  int max = maxima.reduceLanes(MAX);
  IO.println("Reduced:     sum " + sum + ", maximum " + max);

  for (; i < values.length; i++) {
    sum += values[i];
    max = Math.max(max, values[i]);
  }
  IO.println("With tail:   sum " + sum + ", maximum " + max);
}
Nach der Schleife hält jede Lane die Teilsumme bzw. das Teilmaximum jedes vierten Elements. reduceLanes(ADD) und reduceLanes(MAX) fassen die vier Lanes zusammen – die Summe ist die 33 aus der Grafik. Die Rest-Schleife verarbeitet danach die Elemente 8 und 9, also 2 und 6, und erhöht die Summe auf 41:
Lane sums:   [11, -8, 16, 14]
Lane maxima: [8, -1, 12, 9]
Reduced:     sum 33, maximum 12
With tail:   sum 41, maximum 12
Eine Reduktion nimmt auch eine Maske und fasst dann nur die Lanes zusammen, die die Maske einschaltet. Das folgende Programm (im Repository: operations/MaskedReduction.java) summiert so nur die positiven Werte eines Vektors:
import static jdk.incubator.vector.VectorOperators.*;

import jdk.incubator.vector.*;

static final VectorSpecies<Integer> SPECIES = IntVector.SPECIES_128;

void main() {
  IntVector v = IntVector.fromArray(SPECIES, new int[] {3, -7, 12, 5}, 0);

  // Eine Reduktion nimmt auch eine Maske: nur die positiven Werte summieren
  VectorMask<Integer> positive = v.compare(GT, 0);
  IO.println("Vector:       " + v);
  IO.println("Mask:         " + positive);
  IO.println("Positive sum: " + v.reduceLanes(ADD, positive));
}
v.compare(GT, 0) schaltet die Lanes mit positiven Werten ein, und reduceLanes(ADD, positive) addiert nur diese. Die Lane mit -7 bleibt außen vor:
Vector:       [3, -7, 12, 5]
Mask:         Mask[T.TT]
Positive sum: 20
Filtern mit compress() und expand()
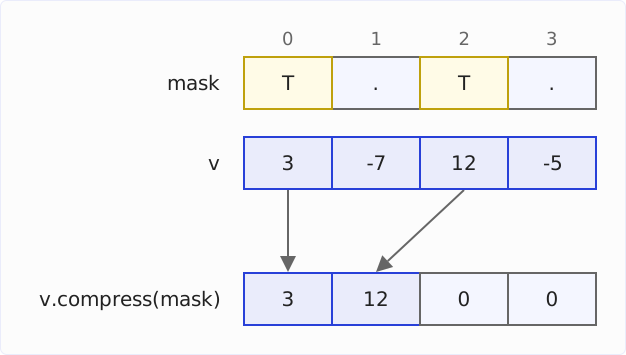
compress() schiebt die Lanes, deren Masken-Bit gesetzt ist, lückenlos an den Anfang des Vektors und füllt den Rest mit 0. Das folgende Programm (im Repository: operations/Compress.java) filtert damit alle positiven Werte aus einem Array:
import static jdk.incubator.vector.VectorOperators.*;

import jdk.incubator.vector.*;

static final VectorSpecies<Integer> SPECIES = IntVector.SPECIES_128;

void main() {
  int[] values = {3, -7, 12, -5, -8, 1, 4, 9, 2, -6, 0, 11};

  // Filter: alle positiven Werte lückenlos nach result kopieren
  int[] result = new int[values.length];
  int count = 0;
  for (int i = 0; i < values.length; i += SPECIES.length()) {
    IntVector v = IntVector.fromArray(SPECIES, values, i);
    VectorMask<Integer> positive = v.compare(GT, 0);
    IntVector packed = v.compress(positive);
    IO.println(v + " -> compress " + positive + " -> " + packed);

    // schreibt alle vier Lanes; die Nullen am Ende überschreibt die nächste Runde
    packed.intoArray(result, count);
    count += positive.trueCount();
    IO.println("  result: " + Arrays.toString(result) + ", count: " + count);
    IO.println();
  }
  IO.println(Arrays.toString(Arrays.copyOf(result, count)));
}
intoArray() schreibt immer alle vier Lanes, auch die Nullen am Ende. Der Zähler count rückt aber nur um die Anzahl der gesetzten Masken-Bits vor (trueCount()), sodass die nächste Runde die Nullen wieder überschreibt. Das zeigen die result-Zeilen der Ausgabe: Nach der ersten Runde stehen an den Positionen 2 und 3 Nullen, in der zweiten Runde schreibt das Programm dort 1 und 4 hin:
[3, -7, 12, -5] -> compress Mask[T.T.] -> [3, 12, 0, 0]
  result: [3, 12, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0], count: 2

[-8, 1, 4, 9] -> compress Mask[.TTT] -> [1, 4, 9, 0]
  result: [3, 12, 1, 4, 9, 0, 0, 0, 0, 0, 0, 0], count: 5

[2, -6, 0, 11] -> compress Mask[T..T] -> [2, 11, 0, 0]
  result: [3, 12, 1, 4, 9, 2, 11, 0, 0, 0, 0, 0], count: 7

[3, 12, 1, 4, 9, 2, 11]
Die Grafik zeigt die erste Runde, oben die Maske, darunter den Vektor und die Pfeile zum Ergebnis:
expand() ist die Umkehrung von compress(): Es verteilt die ersten Lanes eines Vektors der Reihe nach auf die Positionen, deren Masken-Bit gesetzt ist, und füllt die übrigen Lanes mit 0. Das folgende Programm (im Repository: operations/Expand.java) macht damit das compress() aus der Grafik rückgängig:
import jdk.incubator.vector.*;

static final VectorSpecies<Integer> SPECIES = IntVector.SPECIES_128;

void main() {
  // expand() ist die Umkehrung von compress(): Es verteilt die ersten Lanes
  // auf die Positionen der Maske und füllt die übrigen Lanes mit 0
  IntVector packed = IntVector.fromArray(SPECIES, new int[] {3, 12, 0, 0}, 0);
  VectorMask<Integer> mask =
      VectorMask.fromArray(SPECIES, new boolean[] {true, false, true, false}, 0);
  IO.println(packed + " -> expand " + mask + " -> " + packed.expand(mask));
}
Die Ausgabe:
[3, 12, 0, 0] -> expand Mask[T.T.] -> [3, 0, 12, 0]Die Grafik zeigt, wie die ersten beiden Lanes auf die Positionen 0 und 2 wandern:
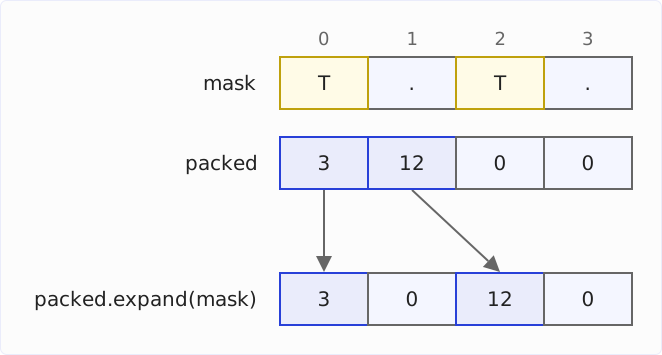
Die Positionen stellt expand() wieder her, die Werte nicht: Wo compress() die -7 und die -5 verworfen hatte, steht jetzt 0.
compress() und expand() gibt es seit Java 19 (JEP 426).
Umsortieren mit rearrange() und selectFrom()
rearrange() sortiert die Lanes eines Vektors um. Wohin welche Lane kommt, bestimmt ein Shuffle – eine Liste von Lane-Indizes, siehe Abschnitt „VectorShuffle“: Lane i des Ergebnisses bekommt den Wert aus der Lane, deren Index an Position i des Shuffles steht.
Das folgende Programm (im Repository: operations/Rearrange.java) dreht mit rearrange() einen Vektor um und rotiert ihn dann um eine Lane nach links:
import jdk.incubator.vector.*;

static final VectorSpecies<Integer> SPECIES = IntVector.SPECIES_128;

void main() {
  IntVector v = IntVector.fromArray(SPECIES, new int[] {10, 20, 30, 40}, 0);

  // rearrange(): Lane i des Ergebnisses holt sich die Lane, die an Position i steht
  VectorShuffle<Integer> reverse = VectorShuffle.fromValues(SPECIES, 3, 2, 1, 0);
  IO.println(v + " -> rearrange " + reverse + " -> " + v.rearrange(reverse));

  VectorShuffle<Integer> rotate = VectorShuffle.iota(SPECIES, 1, 1, true);
  IO.println(v + " -> rearrange " + rotate + " -> " + v.rearrange(rotate));
}
VectorShuffle.iota(SPECIES, 1, 1, true) erzeugt die Indizes 1, 2, 3, 4 – das letzte Argument true lässt sie am Ende umlaufen, aus 4 wird 0:
[10, 20, 30, 40] -> rearrange Shuffle[3, 2, 1, 0] -> [40, 30, 20, 10]
[10, 20, 30, 40] -> rearrange Shuffle[1, 2, 3, 0] -> [20, 30, 40, 10]
selectFrom() dreht die Rollen um: Der Vektor, auf dem du die Methode aufrufst, enthält die Indizes, das Argument ist die Tabelle, aus der gelesen wird. So wird ein Vektor zur Lookup-Tabelle. Das folgende Programm (im Repository: operations/SelectFrom.java) wandelt damit 16 Halbbytes (Werte von 0 bis 15) in einem Schritt in Hexadezimalziffern um:
import jdk.incubator.vector.*;

static final VectorSpecies<Byte> SPECIES = ByteVector.SPECIES_128;

void main() {
  // selectFrom(): Der Vektor enthält die Indizes, das Argument ist die Tabelle
  byte[] digits = "0123456789abcdef".getBytes(StandardCharsets.US_ASCII);
  ByteVector table = ByteVector.fromArray(SPECIES, digits, 0);
  byte[] nibbles = {12, 10, 15, 14, 11, 10, 11, 14, 0, 0, 0, 0, 0, 0, 0, 1};
  ByteVector indexes = ByteVector.fromArray(SPECIES, nibbles, 0);
  byte[] hex = new byte[16];
  indexes.selectFrom(table).intoArray(hex, 0);
  IO.println(new String(hex, StandardCharsets.US_ASCII));
}
Jede der 16 Lanes von indexes hat ein Zeichen aus table gewählt:
cafebabe00000001Seit Java 24 (JEP 489) laufen Indizes bei selectFrom() und rearrange() um, statt eine Exception auszulösen – ein Index außerhalb der Lanes wird also modulo der Lane-Anzahl umgerechnet, bei 16 Lanes wird aus 17 die Lane 1. Der JEP nennt die beiden Operationen seitdem deutlich schneller.
Seitdem gibt es auch eine Variante von selectFrom() mit zwei Tabellenvektoren: indexes.selectFrom(v1, v2) liest aus v1 und v2 wie aus einer Tabelle doppelter Länge. Bei 16 Lanes wählen die Indizes 0 bis 15 aus v1, die Indizes 16 bis 31 aus v2.
Typen und Breiten umwandeln
Bei einer Umwandlung zwischen Elementtypen ändert sich oft die Größe: 16 byte-Werte füllen 128 Bit, 16 int-Werte brauchen 512 Bit. convertShape() liefert das Ergebnis daher in Teilen. Bleibt die Größe gleich, wie bei int nach float (beide 32 Bit), genügt convert(), das die Shape beibehält.
reinterpretShape(species, part) wandelt dagegen keine Werte um, sondern liest dieselben Bits als Vektor der angegebenen Species – auch mit einer anderen Shape. Ist der Zielvektor kleiner, wählt part den Ausschnitt; ist er größer, landen die Bits in einem Teil davon, und der Rest wird 0. Für den häufigen Fall, dass die Shape gleich bleibt, gibt es Kurzformen wie reinterpretAsInts().
Das folgende Programm (im Repository: operations/Conversions.java) zeigt alle drei: Es wandelt einen byte-Vektor in vier int-Vektoren mit je 128 Bit um, vier int-Werte in float-Werte und liest den byte-Vektor schließlich als vier int-Werte:
import static jdk.incubator.vector.VectorOperators.*;

import jdk.incubator.vector.*;

static final VectorSpecies<Byte> BYTES = ByteVector.SPECIES_128;
static final VectorSpecies<Integer> INTS = IntVector.SPECIES_128;

void main() {
  byte[] data = new byte[16];
  for (int i = 0; i < data.length; i++) {
    data[i] = (byte) (i * 20); // byte hat ein Vorzeichen: ab 140 negativ
  }
  ByteVector bytes = ByteVector.fromArray(BYTES, data, 0);
  IO.println("Bytes: " + bytes);

  // 16 Bytes werden 16 ints = 512 Bit, also vier Teile zu je 128 Bit
  for (int part = 0; part < 4; part++) {
    Vector<Integer> ints = bytes.convertShape(B2I, INTS, part);
    IO.println("Part " + part + ": " + ints);
  }

  // gleiche Lane-Anzahl, gleiche Shape: int -> float, Teil 0 genügt
  IntVector i = IntVector.fromArray(INTS, new int[] {1, 2, 3, 16_777_217}, 0);
  IO.println(i + " -> " + i.convert(I2F, 0));

  // dieselben 128 Bit, als vier ints gelesen
  IO.println("Reinterpreted: " + bytes.reinterpretAsInts());
}
Die Ausgabe:
Bytes: [0, 20, 40, 60, 80, 100, 120, -116, -96, -76, -56, -36, -16, 4, 24, 44]
Part 0: [0, 20, 40, 60]
Part 1: [80, 100, 120, -116]
Part 2: [-96, -76, -56, -36]
Part 3: [-16, 4, 24, 44]
[1, 2, 3, 16777217] -> [1.0, 2.0, 3.0, 1.6777216E7]
Reinterpreted: [1009259520, -1938267056, -590826336, 739771632]
Zu beachten:
bytes.convertShape(B2I, INTS, part)nimmt drei Argumente: den Operator, die Species des Ergebnisses und die Nummer des Teils.INTSlegt also Elementtyp und Größe des Zielvektors fest – hier 128 Bit, und deshalb brauchen wir für die 16 umgewandelten Werte vier solcher Vektoren.B2Iist der Operator für die Umwandlung vonbytenachint. Das Vorzeichen bleibt dabei erhalten: Aus dembyte-116 wird derint-116.- Die Umwandlung mit
I2Ffolgt den Java-Regeln: 16.777.217 hat in einemfloatkeine exakte Darstellung und wird zu 16.777.216 gerundet. - Die Werte in der letzten Zeile haben mit den Bytes nur noch die Bits gemeinsam – je vier Bytes bilden einen
int.
Der JEP rät, Operationen sparsam einzusetzen, die die Shape ändern können, weil sie Portabilität und Performance kosten können. Wo es eine Variante gibt, die die Shape beibehält, ist sie vorzuziehen: convert() statt convertShape() und die Kurzformen wie reinterpretAsInts() statt reinterpretShape(). Die Kurzformen lesen laut Javadoc dieselben Bits in derselben Shape – sie gehören also nicht zu den Operationen, vor denen der JEP warnt.
Vektoren aus Off-Heap-Speicher: MemorySegment
Vektoren lassen sich nicht nur aus Arrays laden, sondern auch aus einem MemorySegment der Foreign Function & Memory API. Das folgende Beispiel (im Repository: operations/MemorySegments.java) legt 1.000 long-Werte außerhalb des Heaps an und summiert sie:
import static jdk.incubator.vector.VectorOperators.*;

import java.lang.foreign.*;
import java.nio.ByteOrder;
import jdk.incubator.vector.*;

static final VectorSpecies<Long> SPECIES = LongVector.SPECIES_PREFERRED;

void main() {
  int count = 1_000;
  try (Arena arena = Arena.ofConfined()) {
    // Speicher außerhalb des Heaps, an der Vektorgröße ausgerichtet
    long vectorBytes = SPECIES.vectorByteSize();
    MemorySegment segment = arena.allocate(count * (long) Long.BYTES, vectorBytes);
    for (int i = 0; i < count; i++) {
      segment.setAtIndex(ValueLayout.JAVA_LONG, i, i + 1L);
    }

    // der Offset ist in Bytes angegeben, nicht in Elementen
    long bound = SPECIES.loopBound(count) * (long) Long.BYTES;
    ByteOrder order = ByteOrder.nativeOrder();
    LongVector sums = LongVector.zero(SPECIES);
    long offset = 0;
    for (; offset < bound; offset += vectorBytes) {
      LongVector v = LongVector.fromMemorySegment(SPECIES, segment, offset, order);
      sums = sums.add(v);
    }
    long sum = sums.reduceLanes(ADD);
    for (; offset < segment.byteSize(); offset += Long.BYTES) {
      sum += segment.get(ValueLayout.JAVA_LONG, offset);
    }
    IO.println("Sum of 1 to " + count + ": " + sum);
  }
}
Zu beachten:
SPECIES.vectorByteSize()liefert die Größe eines Vektors in Bytes – 16 auf dem M5 Pro, 32 auf dem i7. Um diesen Wert rückt die zweite Schleife den Offset weiter.Long.BYTESist die Größe eineslongin Bytes, also 8.count * (long) Long.BYTESergibt damit die Größe des Speicherbereichs in Bytes, hier 8.000. Der Cast auflongsorgt dafür, dass die Multiplikation inlongrechnet und bei sehr großen Mengen nicht imint-Bereich überläuft.arena.allocate()nimmt als erstes Argument die Größe in Bytes und als zweites die Ausrichtung: Die Startadresse des Segments ist ein Vielfaches vonvectorBytes. Laut JEP 426 kann diese Ausrichtung auf manchen Architekturen das Laden und Speichern beschleunigen.fromMemorySegment()erwartet den Offset in Bytes, nicht als Index, und die Byte-Reihenfolge der Daten.
Die Ausgabe:
Sum of 1 to 1000: 500500Seit Java 19 lädt die Vector API Vektoren aus einem MemorySegment; die früheren Methoden für byte[] und ByteBuffer fielen dafür weg, denn ein MemorySegment lässt sich aus beiden erzeugen.
Zwei vollständige Beispiele
Die bisherigen Beispiele zeigen einzelne Operationen. Die folgenden beiden lösen je eine vollständige Aufgabe – so, wie sie in einer echten Anwendung vorkommt.
Kosinus-Ähnlichkeit
Die Kosinus-Ähnlichkeit misst, wie ähnlich die Richtungen zweier Vektoren sind: 1 heißt gleiche Richtung, 0 heißt senkrecht. Suchsysteme vergleichen damit Embeddings – Zahlenvektoren mit Hunderten oder Tausenden Dimensionen, die die Bedeutung eines Textes beschreiben.
Die Formel braucht drei Summen: das Skalarprodukt der beiden Vektoren und die Quadratsummen jedes einzelnen Vektors. Das Programm examples/CosineSimilarity.java berechnet die Kosinus-Ähnlichkeit zweimal: skalar und mit der Vector API. Die skalare Fassung berechnet die drei Summen in einer Schleife:
float cosineScalar(float[] a, float[] b) {
  float dot = 0;
  float normA = 0;
  float normB = 0;
  for (int i = 0; i < a.length; i++) {
    dot += a[i] * b[i];
    normA += a[i] * a[i];
    normB += b[i] * b[i];
  }
  return (float) (dot / (Math.sqrt(normA) * Math.sqrt(normB)));
}
Die Vector-API-Fassung sammelt die drei Summen in drei Vektoren und reduziert sie nach der Schleife:
static final VectorSpecies<Float> SPECIES = FloatVector.SPECIES_PREFERRED;

float cosineVector(float[] a, float[] b) {
  FloatVector dot = FloatVector.zero(SPECIES);
  FloatVector normA = FloatVector.zero(SPECIES);
  FloatVector normB = FloatVector.zero(SPECIES);
  int i = 0;
  for (; i < SPECIES.loopBound(a.length); i += SPECIES.length()) {
    FloatVector va = FloatVector.fromArray(SPECIES, a, i);
    FloatVector vb = FloatVector.fromArray(SPECIES, b, i);
    dot = va.fma(vb, dot); // dot += va * vb, Lane für Lane
    normA = va.fma(va, normA);
    normB = vb.fma(vb, normB);
  }
  float d = dot.reduceLanes(ADD);
  float na = normA.reduceLanes(ADD);
  float nb = normB.reduceLanes(ADD);
  for (; i < a.length; i++) {
    d += a[i] * b[i];
    na += a[i] * a[i];
    nb += b[i] * b[i];
  }
  return (float) (d / (Math.sqrt(na) * Math.sqrt(nb)));
}
va.fma(vb, dot) multipliziert va mit vb und addiert dot – in einem Befehl je Lane. Das Programm CosineSimilarity aus dem Beispiel-Repository ruft beide Methoden mit denselben zwei Vektoren aus je 1.000 Zufallszahlen auf:
Scalar: 0.9671541
Vector: 0.9671549
Die beiden Ergebnisse unterscheiden sich ab der siebten Nachkommastelle. Das ist kein Fehler: Die skalare Schleife addiert die Produkte streng von vorn nach hinten. Die Vektorfassung addiert sie in vier Teilsummen – eine je Lane – und fasst diese am Ende zusammen. Bei Gleitkommazahlen hängt das Ergebnis von der Reihenfolge der Additionen ab, und fma() rundet zusätzlich nur einmal statt zweimal.
Die Vector API garantiert ausdrücklich nicht, dass Gleitkommarechnungen mit Vektoren dasselbe Ergebnis liefern wie die skalare Rechnung (JEP 537, „Non-Goals“). Für eine Ähnlichkeitssuche spielt die siebte Stelle keine Rolle. Brauchst du bitgenau reproduzierbare Ergebnisse, musst du in der Reihenfolge der skalaren Schleife rechnen.
Bytes zählen und suchen
Das zweite Beispiel (im Repository: examples/ByteSearch.java) arbeitet mit Text: Es zählt die Zeilenumbrüche in einem Byte-Array und sucht das erste Vorkommen eines Zeichens. Bei byte-Werten verarbeitet ein 128-Bit-Vektor 16 Elemente auf einmal.
Die Methode count() vergleicht jeden Vektor mit dem gesuchten Byte und zählt die Treffer der Maske:
static final VectorSpecies<Byte> SPECIES = ByteVector.SPECIES_PREFERRED;

int count(byte[] data, byte b) {
  int count = 0;
  int i = 0;
  for (; i < SPECIES.loopBound(data.length); i += SPECIES.length()) {
    ByteVector v = ByteVector.fromArray(SPECIES, data, i);
    count += v.compare(EQ, b).trueCount();
  }
  for (; i < data.length; i++) {
    if (data[i] == b) count++;
  }
  return count;
}
Die Methode indexOf() verwendet dieselbe Konstante SPECIES und bricht ab, sobald ein Vektor einen Treffer enthält:
int indexOf(byte[] data, byte b) {
  int i = 0;
  for (; i < SPECIES.loopBound(data.length); i += SPECIES.length()) {
    ByteVector v = ByteVector.fromArray(SPECIES, data, i);
    VectorMask<Byte> found = v.compare(EQ, b);
    if (found.anyTrue()) {
      return i + found.firstTrue();
    }
  }
  for (; i < data.length; i++) {
    if (data[i] == b) return i;
  }
  return -1;
}
anyTrue() prüft, ob mindestens ein Masken-Bit gesetzt ist, firstTrue() liefert die Lane des ersten gesetzten Bits. Das Programm ByteSearch ruft beide Methoden auf einem dreizeiligen Text auf und vergleicht das Ergebnis mit String.indexOf():
Lines:          3
First 'J' at:   41
Expected:       41
First '#' at:   -1
Skalar implementiert ist diese Suche genau die vorzeitig abbrechende Schleife, die C2 von sich aus nicht vektorisiert (siehe „Was vektorisiert der JIT-Compiler von selbst?“).
Was der JIT-Compiler aus der Vector API macht
Die Vector API hat zwei Implementierungen:
- Die erste ist reiner Java-Code in der JDK-Klassenbibliothek: Ein Vektor ist ein Objekt, das seine Werte in einem Array hält, und jede Operation ist eine Schleife über dieses Array.
- Die zweite Implementierung steckt im C2-Compiler: Er erkennt die Methoden der API als Intrinsics (Methoden, für die der Compiler eigenen Maschinencode erzeugt) und übersetzt sie in Vektorbefehle der CPU, auf der die Anwendung läuft. Die Vektorobjekte auf dem Heap verschwinden dabei, die Werte liegen nur noch in Vektorregistern – sofern die Vektoren die Methode nicht verlassen (mehr dazu im Abschnitt „Wann Vektoren doch auf dem Heap landen“).
Diese Intrinsics gibt es nur in C2 – den Client-Compiler C1 zu unterstützen, ist ausdrücklich kein Ziel (JEP 537, „Non-Goals“). Eingeschaltet werden sie, sobald die JVM das Modul jdk.incubator.vector lädt: Dann setzt sie die experimentelle VM-Option -XX:+EnableVectorSupport auf true.
Das Programm JitDemo aus dem Beispiel-Repository ruft die beiden skalaren Methoden aus dem Abschnitt „Was vektorisiert der JIT-Compiler von selbst?“ (addScalar() für die int-Addition und indexOfScalar() für die Byte-Suche) und ihre Vector-API-Gegenstücke so oft auf, bis C2 alle vier kompiliert hat. Die drei int-Arrays und das byte-Array haben je 1.000 Elemente. Das gesuchte Byte steht an der letzten Stelle, sodass die Suche das ganze Array durchläuft. Das Skript print-assembly.sh gibt dann den Maschinencode aus.
Die Addition: kein Unterschied
Die in JitDemo verwendete Vector-API-Fassung der int-Addition ist so aufgebaut wie addWithTailLoop() aus den ersten Schritten: Eine Hauptschleife addiert die Arrays vektorweise, eine skalare Schleife danach die restlichen Elemente, die keinen ganzen Vektor mehr füllen.
C2 erzeugt für die Hauptschleife denselben Code wie für die skalare Schleife. Er hat sie achtfach abgerollt: Ihr Rumpf besteht aus acht gleichen Gruppen von Befehlen, und jede Gruppe addiert einen Vektor aus a und einen aus b und schreibt das Ergebnis nach c. Der folgende Ausschnitt zeigt die erste und die achte Gruppe:
ldur   q16, [x16, #0xc]         ; vier ints aus a laden
ldur   q17, [x17, #0xc]         ; vier ints aus b laden
add    v16.4s, v16.4s, v17.4s   ; vier Additionen mit einem Befehl
add    x14, x4, x14
stur   q16, [x14, #0xc]         ; vier ints nach c schreiben
...
ldur   q16, [x16, #0x7c]        ; achte Gruppe: Werte 28-31
ldur   q17, [x17, #0x7c]
add    v16.4s, v16.4s, v17.4s
stur   q16, [x14, #0x7c]
add    w15, w15, #0x20          ; i += 32
cmp    w15, w13
b.lt   #0x1229dbb10
Eine Gruppe besteht aus drei Schritten:
- Zwei
ldur-Befehle laden je vierint-Werte ausaundbin die 128-Bit-Registerq16undq17. add v16.4s, v16.4s, v17.4saddiert die vier Lanes mit einem Befehl.sturschreibt die vier Summen nachc.
Ein Vektor enthält also vier int-Werte. Mit seinen acht Gruppen verarbeitet ein Schleifendurchlauf acht Vektoren, also 32 int-Werte.
Für eine Schleife, die C2 ohnehin vektorisiert, bringt die Vector API also nichts. Du schreibst mehr Code für dasselbe Ergebnis – in der Messung ist die Vector-API-Fassung sogar langsamer.
Die Byte-Suche: 64 statt acht Bytes pro Durchlauf
Anders bei der Byte-Suche. Die Vector-API-Fassung indexOfVector() entspricht der Methode indexOf() aus dem Beispiel ByteSearch. Ihre Hauptschleife sieht so aus (gekürzt um die zweite bis vierte Prüfung):
add    x10, x2, w0, sxtw
ldur   q16, [x10, #0xc]               ; Bytes 0-15 laden
ldur   q18, [x10, #0x3c]              ; Bytes 48-63 laden
ldur   q19, [x10, #0x1c]              ; Bytes 16-31 laden
ldur   q20, [x10, #0x2c]              ; Bytes 32-47 laden
cmeq   v21.16b, v16.16b, v17.16b      ; 16 Bytes mit b vergleichen
cmeq   v20.16b, v20.16b, v17.16b
cmeq   v19.16b, v19.16b, v17.16b
cmeq   v16.16b, v18.16b, v17.16b
addv   b18, v21.16b                   ; anyTrue(): Lanes aufsummieren
umov   w8, v18.b[0]
cmp    w8, wzr
b.ne   #0x126a25940                   ; Treffer: Schleife verlassen
...
add    w0, w0, #0x40                  ; i += 64
cmp    w0, w14
b.lt   #0x126a25760
C2 hat die Schleife vierfach abgerollt. v17 enthält das gesuchte Byte in allen 16 Lanes. cmeq vergleicht 16 Bytes mit einem Befehl und setzt jede Lane mit Treffer auf 0xFF. Für anyTrue() addiert addv die 16 Lanes zu einem Byte, und ein bedingter Sprung prüft, ob es ungleich 0 ist.
Die Hauptschleife von indexOfVector() besteht aus 28 Befehlen, genau wie die Schleife von indexOfScalar(), die C2 nicht vektorisiert, sondern nur achtfach abgerollt hat (siehe „Was vektorisiert der JIT-Compiler von selbst?“). Die skalare Schleife verarbeitet damit acht Bytes, die Vektorschleife 64 – achtmal so viele Bytes pro Befehl. Wie viel davon bei der Laufzeit ankommt, zeigt der Abschnitt „Messung“.
Wann Vektoren doch auf dem Heap landen
C2 kann die Vektorobjekte nur wegoptimieren, solange sie die Methode nicht verlassen – solange sie also nur lokale Variablen sind und ihr Ergebnis in ein Array zurückgeschrieben wird. Speicherst du einen Vektor in einem Feld oder einem Array von Vektoren, muss ihn die JVM als echtes Objekt auf dem Heap anlegen.
Das Programm Allocations (im Repository: jit/Allocations.java) zeigt das. Es misst mit ThreadMXBean.getCurrentThreadAllocatedBytes(), wie viele Bytes pro Vektoroperation auf dem Heap angelegt werden – einmal für eine Schleife, die das Ergebnis mit intoArray() zurückschreibt, und einmal für eine Schleife, die die Ergebnisvektoren in einem Array vom Typ IntVector[] speichert:
static final VectorSpecies<Integer> SPECIES = IntVector.SPECIES_128;

int[] a = new int[1_024];
int[] b = new int[1_024];
int[] c = new int[1_024];
IntVector[] kept = new IntVector[1_024 / 4];

void add() {
  for (int i = 0; i < a.length; i += SPECIES.length()) {
    IntVector va = IntVector.fromArray(SPECIES, a, i);
    IntVector vb = IntVector.fromArray(SPECIES, b, i);
    va.add(vb).intoArray(c, i);
  }
}

void addAndKeep() {
  for (int i = 0; i < a.length; i += SPECIES.length()) {
    IntVector va = IntVector.fromArray(SPECIES, a, i);
    IntVector vb = IntVector.fromArray(SPECIES, b, i);
    kept[i / 4] = va.add(vb);
  }
}
Mit C2 legt add() nichts auf dem Heap an, addAndKeep() 48 Bytes pro Vektor:
add():        0 bytes per vector
addAndKeep(): 48 bytes per vector
Die 48 Bytes sind ein Objekt der Klasse IntVector128 und ein int-Array mit den vier Werten, auf das es verweist.
Das ist der Grund, warum die Vector API auf Project Valhalla wartet: Als Value Classes hätten Vektoren keine Identität mehr. Die JVM dürfte ihre Werte dann auch in Feldern und Arrays direkt ablegen, ohne eigenes Objekt auf dem Heap – und nicht nur dann, wenn C2 sieht, dass ein Vektor die Methode nie verlässt. Die 48 Bytes pro Vektor in addAndKeep() könnten so entfallen.
Startest du dasselbe Programm mit -XX:TieredStopAtLevel=1, kompiliert die JVM nur mit C1. Dann läuft die Java-Implementierung, und für jeden Vektor wird ein Objekt auf dem Heap angelegt – für die zwei geladenen Vektoren und den Ergebnisvektor, dreimal 48 Bytes:
add():        144 bytes per vector
addAndKeep(): 144 bytes per vector
Messung
Das Beispiel-Repository enthält drei JMH-Benchmarks, jeweils für Arrays mit 7, 16, 100, 1.000 und 100.000 Elementen:
AddBenchmarkaddiert zweifloat-Arrays: skalar mit Auto-Vectorization, skalar ohne Auto-Vectorization (-XX:-UseSuperWord), mit der Vector API und Rest-Schleife und mit der Vector API und Maske.IndexOfBenchmarksucht ein Byte, das an der letzten Position steht: skalar und mit der Vector API.DotProductBenchmarkberechnet das Skalarprodukt zweierfloat-Arrays: skalar mit einer und mit vier Summen, mit der Vector API undfma()mit einem und mit vier Summen-Vektoren.
Gemessen habe ich auf zwei Rechnern: einem MacBook Pro mit Apple M5 Pro (ARM, NEON, 128 Bit breite Vektorregister) und einem Dell XPS 17 mit Intel Core i7-12700H (x86, AVX2, 256 Bit). AVX-512 hat dieser Prozessor nicht. Ein Vektor fasst auf dem M5 Pro also vier float-Werte, auf dem i7 acht.
Doppelt so schnell macht das den i7 nicht. Für die Byte-Suche in 1.000 Elementen braucht er mit der Vector API 13,6 ns, der M5 Pro 12,7 ns; für das Skalarprodukt mit vier Summen-Vektoren 38,8 gegen 42,0 ns. Die beiden Rechner unterscheiden sich in mehr als der Vektorbreite, und der Dell misst zudem in einer virtuellen Maschine. Die folgenden Abschnitte vergleichen deshalb die Fassungen auf demselben Rechner, nicht die Rechner untereinander.
Die Tabellen zeigen die Zeit pro Aufruf in Nanosekunden, je Benchmark zuerst für den M5 Pro, dann für den i7.
Zwei Arrays addieren
AddBenchmark addiert zwei float-Arrays in vier Fassungen. Das Diagramm zeigt für beide Rechner, wie lange drei davon im Verhältnis zur skalaren Schleife mit Auto-Vectorization brauchen – über 1 sind sie langsamer, unter 1 schneller.
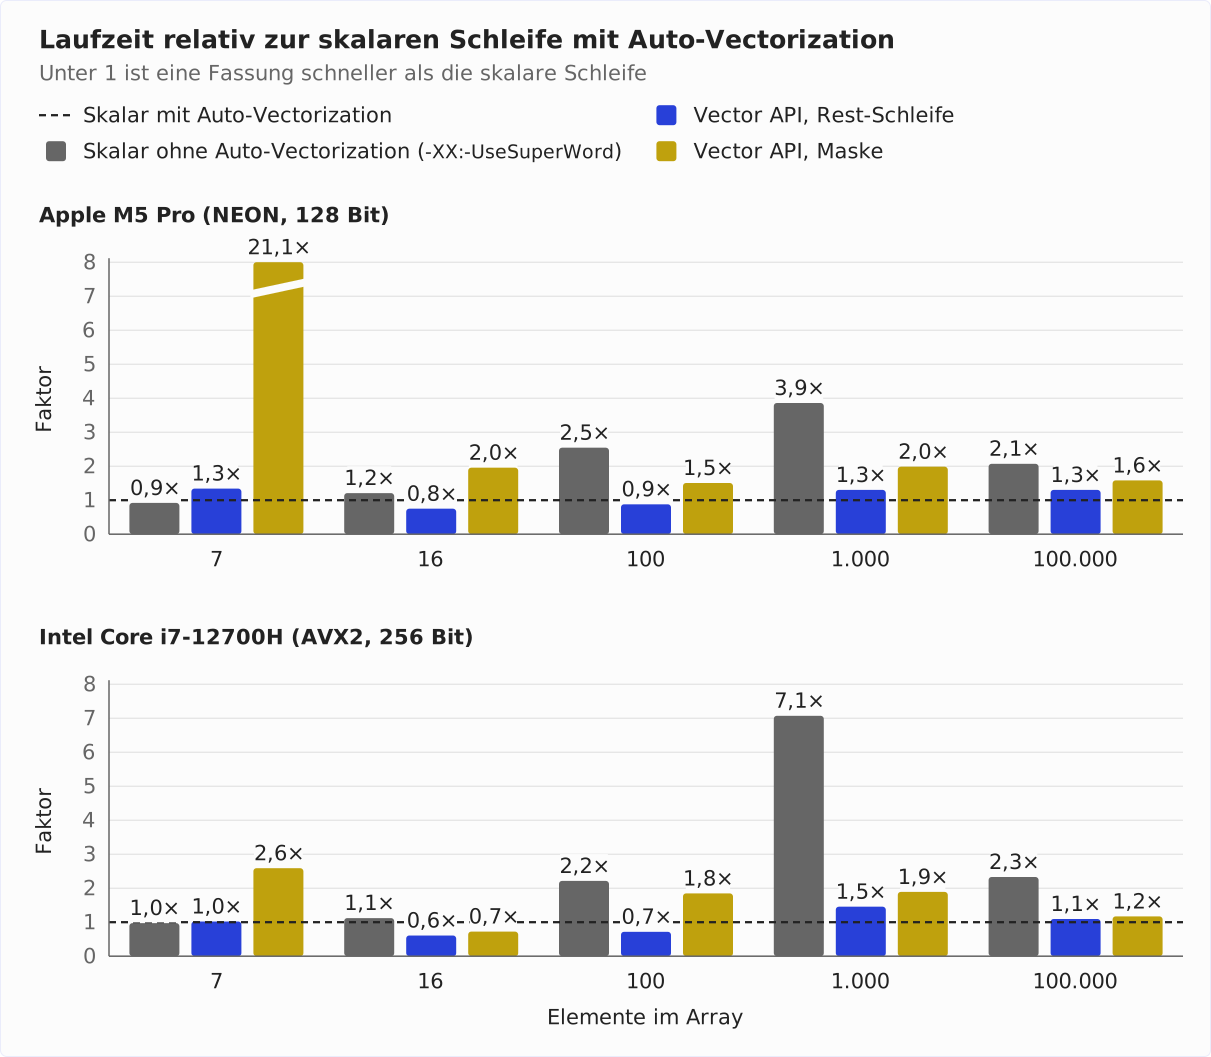
Die genauen Zeiten in Nanosekunden zeigen die beiden Tabellen, zuerst für den M5 Pro:
| Elemente | Skalar mit Auto-Vectorization | Skalar ohne Auto-Vectorization | Vector API, Rest-Schleife | Vector API, Maske |
|---|---|---|---|---|
| 7 | 2,3 | 2,1 | 3,1 | 49,2 |
| 16 | 3,0 | 3,7 | 2,3 | 6,0 |
| 100 | 7,0 | 17,8 | 6,2 | 10,5 |
| 1.000 | 45,8 | 176,8 | 59,7 | 90,9 |
| 100.000 | 9.113 | 18.865 | 11.873 | 14.408 |
Auf dem i7-12700H:
| Elemente | Skalar mit Auto-Vectorization | Skalar ohne Auto-Vectorization | Vector API, Rest-Schleife | Vector API, Maske |
|---|---|---|---|---|
| 7 | 3,5 | 3,4 | 3,5 | 9,0 |
| 16 | 5,0 | 5,6 | 3,1 | 3,6 |
| 100 | 11,0 | 24,2 | 7,9 | 20,2 |
| 1.000 | 32,7 | 231,2 | 47,6 | 61,8 |
| 100.000 | 10.900 | 25.386 | 11.936 | 12.768 |
Ab 100 Elementen macht sich die Auto-Vectorization deutlich bemerkbar: Ohne sie dauert die Addition von 100 Elementen auf dem M5 Pro 2,5-mal so lange, auf dem i7 2,2-mal. Bei 1.000 Elementen ist es das 3,9- bzw. 7,1-Fache. Bei 100.000 Elementen ist es auf beiden Rechnern gut das Doppelte.
Die Vector API bringt nichts zusätzlich. Bis 100 Elemente liegt sie mal vor, mal hinter der skalaren Schleife. Bei 1.000 Elementen braucht sie auf dem M5 Pro sogar bis zu 30 % länger, auf dem i7 46 % länger – obwohl C2 für die Vector API dieselbe Hauptschleife erzeugt wie bei der Auto-Vectorization. Den Unterschied macht auf beiden Rechnern die Ausrichtung im Speicher – Details dazu in der Infobox.
Maske oder Rest-Schleife?
Auf dem M5 Pro braucht die Masken-Variante bei jeder Größe länger als die mit Rest-Schleife: bei 100 bis 100.000 Elementen 21 bis 71 % länger, bei 7 Elementen fast 16-mal so lange. Bei 16 Elementen streut sie zudem – zwei der drei Forks lagen bei 3,1 ns, einer bei 11,6 ns.
16, 100, 1.000 und 100.000 sind Vielfache von vier, dort ist die Maske in jedem Durchlauf voll. Trotzdem kostet jeder Durchlauf zusätzliche Arbeit: die Maske berechnen, beim Laden mit ihr mischen und vor dem Speichern prüfen, ob alle Lanes eingeschaltet sind.
Bei 7 Elementen braucht der zweite Durchlauf eine Teilmaske für drei Lanes. Die kann C2 auf dem M5 Pro nicht in Vektorbefehle übersetzen: Für maskiertes Speichern und für maskiertes Laden über das Array-Ende hinaus braucht C2 Predicate-Befehle, und die nutzt der Compiler auf ARM nur mit SVE. Statt der Vektorbefehle läuft die Java-Implementierung. Das Diagnose-Log von C2 (-XX:+PrintIntrinsics) meldet dann:
** not supported: op=storeMasked vlen=4 etype=float mismatched_ms=0Wie teuer das bei verschiedenen Array-Größen wird, zeigt eine Zusatzmessung mit 7 bis 100.003 Elementen, bei denen der letzte Durchlauf jeweils eine Teilmaske braucht. Sie enthält noch eine dritte Variante, vectorMaskedTail() aus AddBenchmark.java: Ihre Hauptschleife läuft ohne Maske bis loopBound(), und nur die Elemente dahinter verarbeitet ein einziger maskierter Durchlauf statt der Rest-Schleife:
if (i < a.length) {
  VectorMask<Float> m = SPECIES.indexInRange(i, a.length);
  FloatVector va = FloatVector.fromArray(SPECIES, a, i, m);
  FloatVector vb = FloatVector.fromArray(SPECIES, b, i, m);
  va.add(vb).intoArray(c, i, m);
}
Das Diagramm zeigt für beide Rechner, wie lange die beiden Masken-Fassungen im Verhältnis zur Rest-Schleife brauchen:
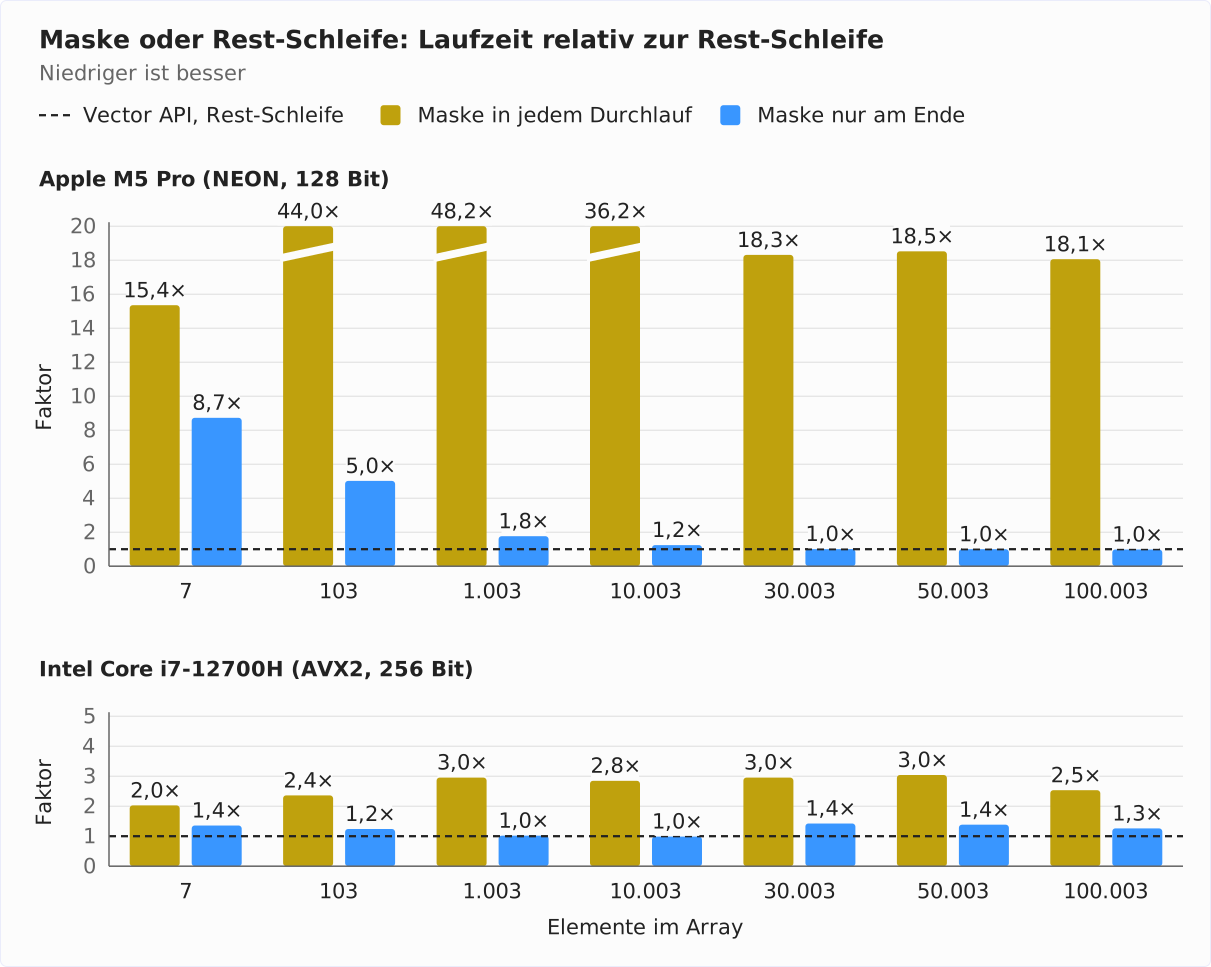
Die genauen Zeiten in Nanosekunden zeigen die beiden Tabellen, zuerst für den M5 Pro:
| Elemente | Rest-Schleife | Maske in jedem Durchlauf | Maske nur am Ende |
|---|---|---|---|
| 7 | 3,0 | 46,1 | 26,2 |
| 103 | 6,7 | 296,0 | 33,8 |
| 1.003 | 55,2 | 2.659 | 97,3 |
| 10.003 | 560 | 20.304 | 695 |
| 30.003 | 3.271 | 59.894 | 3.294 |
| 50.003 | 5.402 | 100.076 | 5.388 |
| 100.003 | 10.955 | 197.839 | 10.791 |
Mit Maske in jedem Durchlauf dauert die Addition von 1.003 bzw. 100.003 Elementen 48- bzw. 18-mal so lange, und sie legt pro Aufruf 32.240 bzw. 3.200.241 Bytes auf dem Heap an – rund 128 Bytes pro Schleifendurchlauf. Wo, zeigt eine Aufzeichnung mit Java Flight Recorder: bei fromArray() und add(), also für die geladenen Vektoren und ihre Summe – und zwar auch in den Durchläufen mit voller Maske.
Mit Maske nur am Ende bleibt der Schaden auf den einen Durchlauf mit Teilmaske beschränkt: Er legt 176 Bytes an und kostet bei bis zu 1.003 Elementen 23 bis 42 ns. Ab 30.003 Elementen fällt das nicht mehr ins Gewicht, bei nur 7 Elementen dauert die Addition hingegen knapp neunmal so lange wie mit Rest-Schleife.
Das ist die Graceful Degradation aus den Zielen des JEP: Der Code funktioniert, nur langsamer. Auf ARM-CPUs ohne SVE nimmst du deshalb die Rest-Schleife.
Maske auf dem i7
Auf dem i7-12700H sieht es anders aus:
| Elemente | Rest-Schleife | Maske in jedem Durchlauf | Maske nur am Ende |
|---|---|---|---|
| 7 | 3,6 | 7,2 | 4,8 |
| 103 | 8,4 | 19,7 | 10,4 |
| 1.003 | 50,7 | 149,6 | 51,6 |
| 10.003 | 936 | 2.664 | 925 |
| 30.003 | 2.707 | 7.998 | 3.851 |
| 50.003 | 4.609 | 14.015 | 6.373 |
| 100.003 | 11.674 | 29.560 | 14.708 |
AVX2 hat ebenfalls keine Predicate-Register, aber C2 übersetzt maskiertes Laden und Speichern dort in Vektorbefehle (vmaskmovps). Auf dem Heap landet nichts. Billig ist die Maske in jedem Durchlauf trotzdem nicht: Der Maschinencode zeigt, dass C2 die Schleife dann nicht abrollt und auch bei voller Maske maskiert lädt. Mit voller Maske braucht die Addition von 1.000 Elementen 30 % länger als mit Rest-Schleife (Tabelle oben im Abschnitt „Zwei Arrays addieren“), mit zusätzlich einer Teilmaske am Ende bei 1.003 Elementen knapp dreimal so lange.
Die Maske nur am Ende kostet bis 10.003 Elemente wenig. Ab 30.003 Elementen braucht sie dagegen 26 bis 42 % länger als die Rest-Schleife, obwohl ihre Hauptschleife dieselbe ist. Ohne Rest, bei 100.000 und 100.008 Elementen, sind beide gleich schnell. Auf dem M5 Pro tritt dieser Effekt nicht auf. Die Ursache dafür habe ich nicht gefunden.
Meine Empfehlung für beide Architekturen: Nimm die Rest-Schleife. Die Maske in jedem Durchlauf kostet auf beiden Rechnern, und die Maske nur am Ende bringt nirgends einen messbaren Vorteil.
Ein Byte suchen
IndexOfBenchmark sucht in einem byte-Array ein Byte, das an der letzten Position steht. Das Diagramm zeigt für beide Rechner, wie viel schneller die Vector-API-Fassung ist als die skalare Schleife: Der Faktor ist die Laufzeit der skalaren Schleife geteilt durch die der Vector API.
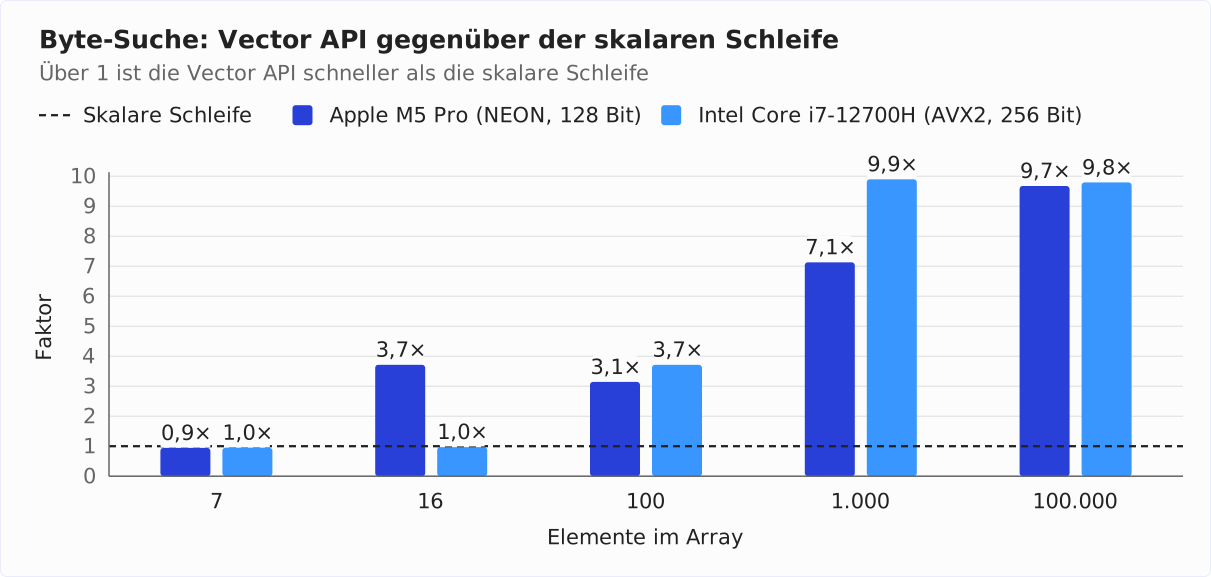
Die genauen Zeiten in Nanosekunden zeigen die beiden Tabellen, zuerst für den M5 Pro:
| Elemente | Skalar | Vector API | Faktor |
|---|---|---|---|
| 7 | 1,4 | 1,5 | 0,9 |
| 16 | 2,6 | 0,7 | 3,7 |
| 100 | 9,6 | 3,1 | 3,1 |
| 1.000 | 90,4 | 12,7 | 7,1 |
| 100.000 | 10.930 | 1.130 | 9,7 |
Auf dem i7-12700H:
| Elemente | Skalar | Vector API | Faktor |
|---|---|---|---|
| 7 | 2,0 | 2,1 | 1,0 |
| 16 | 3,4 | 3,5 | 1,0 |
| 100 | 14,5 | 3,9 | 3,7 |
| 1.000 | 134,8 | 13,6 | 9,9 |
| 100.000 | 13.455 | 1.374 | 9,8 |
Hier spielt die Vector API ihre Stärke aus: Ab 1.000 Elementen ist sie auf dem M5 Pro 7- bis 10-mal so schnell wie die skalare Schleife, auf dem i7 knapp 10-mal. Auf dem M5 Pro passt das zum Maschinencode, der für jedes Byte ein Achtel der Befehle braucht.
Bei kleinen Arrays läuft die Vektorschleife gar nicht: Ein Vektor fasst auf dem M5 Pro 16 Bytes, ein Array mit 7 Elementen füllt also keinen einzigen. Dann verarbeitet die Rest-Schleife alle Elemente und macht dieselbe Arbeit wie die skalare Fassung. Auf dem i7 fasst ein Vektor 32 Bytes, dort gilt das auch noch für 16 Elemente.
Skalarprodukt
Die skalare Schleife für das Skalarprodukt vektorisiert C2 nicht: Im Maschinencode stehen nur skalare fmul- und fadd-Befehle. Mathematisch ist die Addition assoziativ, bei Gleitkommazahlen aber nicht: Weil jedes Zwischenergebnis gerundet wird, kann eine andere Reihenfolge der Summanden ein minimal anderes Ergebnis liefern. Deshalb darf C2 die Summanden nicht umordnen. Mit der Vector API ordnest du sie selbst um und nimmst die Abweichung in den letzten Stellen in Kauf.
Warum eine einzige Summe die CPU warten lässt
Dass C2 die Additionen in ihrer im Java-Code vorgegebenen Reihenfolge ausführen muss, hat eine zweite Folge: Jede Addition in sum muss auf das Ergebnis der vorigen Addition warten. Das klingt selbstverständlich, kostet aber Zeit: Eine moderne CPU kann in jedem Takt mehrere neue Additionen beginnen, doch jede braucht einige Takte, bis ihr Ergebnis vorliegt. Unabhängige Additionen laufen deshalb überlappend. Hängt jede vom Ergebnis der vorigen ab, kann die nächste erst starten, wenn die vorige fertig ist – und die meiste Zeit wartet die CPU:
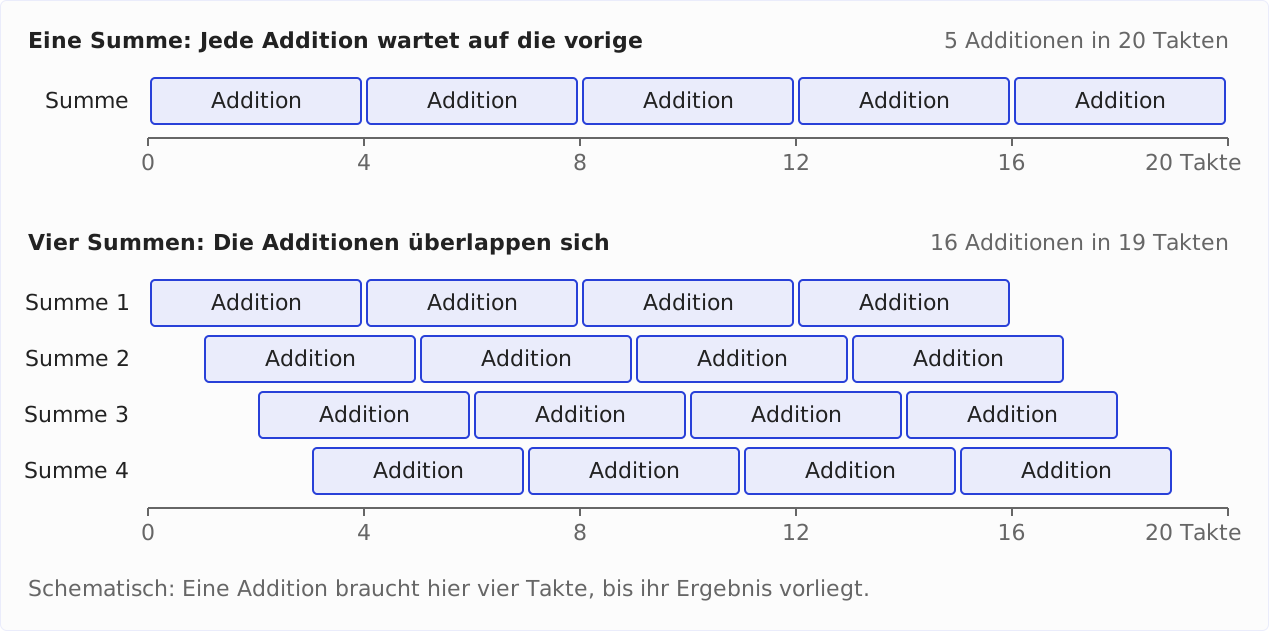
Mit einer einzigen Summe misst der Benchmark deshalb vor allem, wie lange eine Addition dauert – und nicht, wie schnell die CPU Elemente lädt und multipliziert. In der Vector-API-Fassung vector() wartet ebenfalls jede Addition auf die vorige, nur mit Vektoren: Jedes fma() addiert in denselben Vektor sums und braucht dafür das Ergebnis des vorigen fma().
Zwei weitere Fassungen brechen diese Kette voneinander abhängiger Additionen auf. Die skalare, scalarFourSums() (im Repository: DotProductBenchmark.java), verteilt die Elemente reihum auf vier float-Summen:
for (; i < a.length - 3; i += 4) {
  sum0 += a[i] * b[i];
  sum1 += a[i + 1] * b[i + 1];
  sum2 += a[i + 2] * b[i + 2];
  sum3 += a[i + 3] * b[i + 3];
}
Die vier Additionen eines Durchlaufs hängen nicht voneinander ab, die CPU kann sie überlappend ausführen. Nach der Schleife addiert die Methode die vier Summen und verarbeitet die bis zu drei übrigen Elemente skalar. Damit ändert auch sie die Reihenfolge der Additionen. Vektorisieren dürfte C2 sie sogar: Jede der vier Summen könnte in einer eigenen Lane laufen, mit genau denselben Additionen in derselben Reihenfolge. Im Maschinencode bleibt sie trotzdem skalar.
vectorFourAccumulators() macht dasselbe mit der Vector API und verteilt die Arbeit auf vier unabhängige Summen-Vektoren:
for (; i < upperBound; i += 4 * lanes) {
  sums0 = fma(i, sums0);
  sums1 = fma(i + lanes, sums1);
  sums2 = fma(i + 2 * lanes, sums2);
  sums3 = fma(i + 3 * lanes, sums3);
}
Die Hilfsmethode fma(i, sums) lädt je einen Vektor aus a und b ab Index i und gibt va.fma(vb, sums) zurück. Nach der Schleife verarbeitet eine zweite Schleife die übrigen ganzen Vektoren, dann addiert die Methode die vier Summen-Vektoren und reduziert das Ergebnis mit reduceLanes(ADD).
Ergebnisse
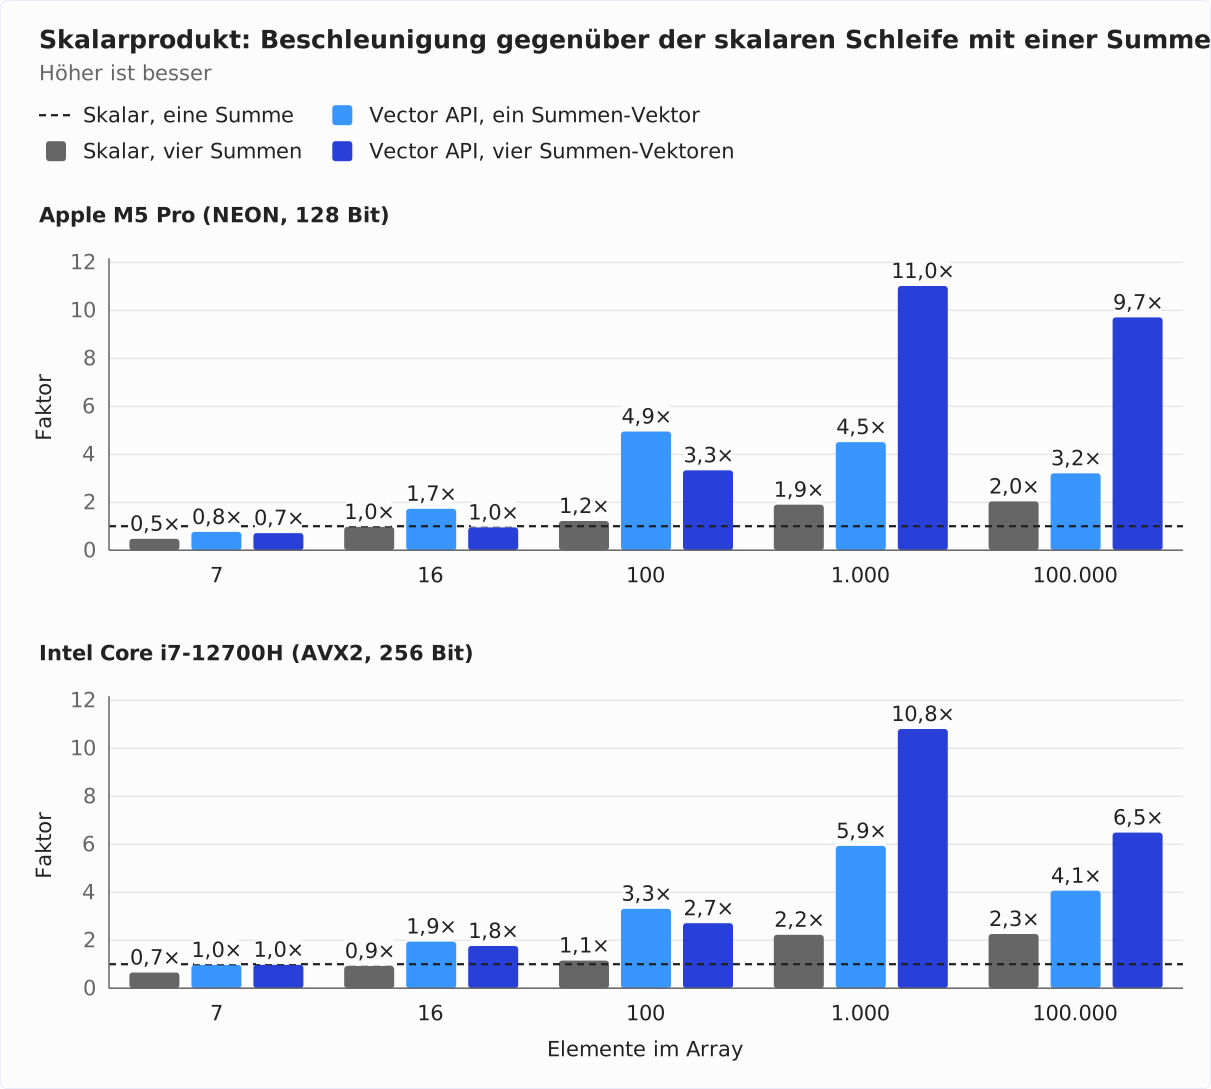
Das Diagramm zeigt für beide Rechner, wie viel schneller die drei anderen Fassungen sind als die skalare Schleife mit einer Summe:
Die genauen Zeiten in Nanosekunden zeigen die beiden Tabellen, zuerst für den M5 Pro:
| Elemente | Skalar, eine Summe | Skalar, vier Summen | Vector API, ein Summen-Vektor | Vector API, vier Summen-Vektoren |
|---|---|---|---|---|
| 7 | 1,9 | 4,0 | 2,5 | 2,7 |
| 16 | 3,3 | 3,4 | 1,9 | 3,5 |
| 100 | 22,8 | 18,7 | 4,6 | 6,8 |
| 1.000 | 462,5 | 244,1 | 102,6 | 42,0 |
| 100.000 | 54.332 | 26.708 | 16.962 | 5.601 |
Auf dem i7-12700H:
| Elemente | Skalar, eine Summe | Skalar, vier Summen | Vector API, ein Summen-Vektor | Vector API, vier Summen-Vektoren |
|---|---|---|---|---|
| 7 | 3,4 | 5,2 | 3,5 | 3,5 |
| 16 | 4,8 | 5,2 | 2,5 | 2,7 |
| 100 | 24,5 | 21,4 | 7,4 | 9,1 |
| 1.000 | 418,6 | 188,3 | 70,6 | 38,8 |
| 100.000 | 45.224 | 20.032 | 11.128 | 6.976 |
Das Diagramm zeigt drei Effekte:
- Vector API mit einem Summen-Vektor (hellblau): Ab 100 Elementen ist sie auf dem M5 Pro 3,2- bis 4,9-mal so schnell wie die skalare Schleife mit einer Summe, auf dem i7 3,3- bis 5,9-mal.
- Vier Summen statt einer helfen ab 1.000 Elementen beiden Techniken: Die skalare Schleife wird etwa doppelt so schnell (grau, 1,9- bis 2,3-mal). Die Vector API mit vier Summen-Vektoren (dunkelblau) erreicht auf dem M5 Pro das 9,7- bis 11,0-Fache, auf dem i7 das 6,5- bis 10,8-Fache.
- Bei kleinen Arrays lohnen sich vier Summen nicht: Mit 7 Elementen ist die skalare Schleife mit vier Summen auf dem M5 Pro nur halb so schnell wie mit einer (0,5), und mit 16 Elementen ist die Vector API mit vier Summen-Vektoren dort langsamer als mit einem (1,0 gegen 1,7).
Fair ist der Vergleich zwischen Fassungen mit gleich vielen Summen, also zwischen dem dunkelblauen und dem grauen Balken: Ab 1.000 Elementen ist die Vector API mit vier Summen-Vektoren auf dem M5 Pro 4,8- bis 5,8-mal so schnell wie die skalare Schleife mit vier Summen, auf dem i7 2,9- bis 4,9-mal.
Fallstricke – Checkliste
Die folgenden Punkte entscheiden, ob dein Vector-API-Code schnell wird:
- Species als
static final: In anderen Feldern oder in Arrays kann eine Species laut Javadoc vonVectorSpeciesPerformance kosten. - Vektoren nicht speichern: Ein Vektor in einem Feld, einem Array oder einer Collection wird zum Heap-Objekt – 48 Bytes für einen 128-Bit-
IntVector. Halte Vektoren in lokalen Variablen und schreib Ergebnisse in Arrays oder Memory-Segmente zurück. - C2 muss laufen: Ohne C2 läuft die Java-Implementierung. Das betrifft die Aufwärmphase, Konfigurationen mit
-XX:TieredStopAtLevel=1und JVMs ohne C2. - Reduzieren nach der Schleife:
reduceLanes()gehört hinter die Schleife, nicht hinein – in der Schleife sammelst du Lane für Lane. - Masken mit Bedacht: Auf ARM-CPUs ohne SVE, z. B. dem M5 Pro, übersetzt C2 eine Teilmaske nicht in Vektorbefehle. Die Addition von 1.003 Elementen dauerte dort mit Maske 48-mal so lange wie mit Rest-Schleife, auf dem i7 mit AVX2 knapp dreimal so lange. Nimm die Rest-Schleife, solange du die Maske nicht auf deiner Ziel-CPU gemessen hast.
- Mehrere Summen-Vektoren: Addierst du in einer Schleife in einen einzigen Vektor, wartet jede Operation auf die vorige. Mit vier Summen-Vektoren brauchte das Skalarprodukt von 100.000 Elementen auf dem M5 Pro nur ein Drittel der Zeit. Vergleichst du mit einer skalaren Schleife, gib ihr ebenso viele Summen – sonst misst du die Wartezeit mit.
- Gleitkomma-Ergebnisse vergleichen: Vektorisierte Summen weichen in den letzten Stellen von der skalaren Summe ab. Tests brauchen eine Toleranz.
- Immer messen: Für Schleifen, die C2 von selbst vektorisiert, erzeugt die Vector API denselben Maschinencode – und brauchte in der Messung sogar länger, bei 1.000 Elementen bis zu 30 % auf dem M5 Pro und 46 % auf dem i7. Den Gewinn gibt es nur, wo die Auto-Vectorization nicht greift.
Warum ist die Vector API noch im Incubator?
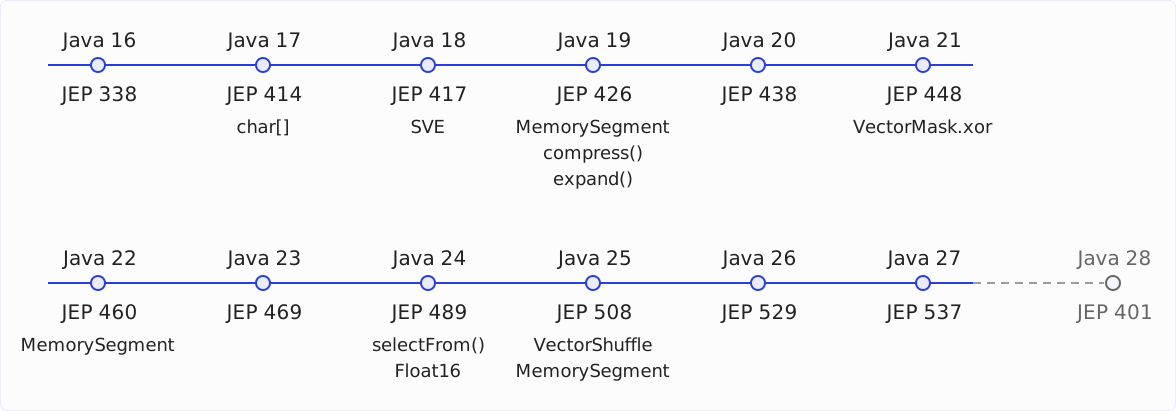
Die Vector API ist seit Java 16 im JDK, mit Java 27 in der zwölften Incubator-Runde. Die folgende Tabelle zeigt alle Runden mit den wichtigsten Änderungen, die ihr JEP nennt. Wo „keine“ steht, blieb die API gleich, und es änderte sich höchstens die Implementierung:
| Java | JEP | Wichtigste Änderungen |
|---|---|---|
| 16 | 338 | erste Version |
| 17 | 414 | Operationen für char[] (z. B. für UTF-8-Dekodierung), vorzeichenlose Vergleiche, byte-Vektoren aus und in boolean[] |
| 18 | 417 | Unterstützung für ARM SVE |
| 19 | 426 | Laden und Speichern über MemorySegment, compress() und expand(), neue Bit-Operationen |
| 20 | 438 | keine |
| 21 | 448 | xor für Masken |
| 22 | 460 | MemorySegments auf Arrays jedes primitiven Typs |
| 23 | 469 | keine |
| 24 | 489 | selectFrom() mit zwei Tabellen, umlaufende Indizes, sättigende Arithmetik (Überlauf bleibt am Rand des Wertebereichs), Klasse Float16 (s. u.) |
| 25 | 508 | VectorShuffle mit MemorySegment |
| 26 | 529 | keine |
| 27 | 537 | keine |
Die Grafik zeigt dieselben Runden als Zeitstrahl. Am rechten Ende steht Java 28 mit JEP 401 – keine Runde der Vector API, sondern die erste Preview der Value Objects, auf die sie wartet:
Der Grund für die lange Incubator-Zeit ist Project Valhalla. Seit Java 20 (JEP 438) nennt der JEP den Anschluss an Valhalla einen entscheidenden Teil der Fertigstellung, und seit Java 23 (JEP 469) steht in jedem JEP derselbe Plan: Die Vector API bleibt im Incubator, bis die nötigen Features von Project Valhalla als Preview verfügbar sind. Dann wird die API auf sie umgestellt und selbst zur Preview.
Was Valhalla für die Vector API ändert, hast du im Abschnitt „Wann Vektoren doch auf dem Heap landen“ gesehen: Heute sind Vector und seine Unterklassen value-based – Klassen, deren Identität du nicht nutzen sollst, die aber noch eine haben. Als Value Classes hätten sie keine mehr. Langfristig sollen außerdem spezialisierte Generics Typen wie Vector<int> ermöglichen; dann wären IntVector und die anderen typspezifischen Unterklassen laut JEP vielleicht überflüssig.
Die erste Valhalla-Preview ist seit dem 7. August 2026 im JDK: JEP 401: Value Objects (Preview) ist für Java 28 integriert. Was die Value Objects dieser Preview können, zeigt der Artikel Project Valhalla: Value Objects in Java 28.
Für die Vector API gibt es für Java 28 bisher keinen JEP (Stand: 17. November 2026). Der Feature Freeze von Java 28 ist am 3. Dezember 2026.
Float16
Seit Java 24 enthält das Modul die Klasse Float16 für 16-Bit-Gleitkommazahlen nach IEEE 754 (binary16). Auch Float16 ist value-based und soll zur Value Class werden, sobald Valhalla verfügbar ist. Seit Java 25 vektorisiert C2 Addition, Subtraktion, Multiplikation, Division, Quadratwurzel und Fused Multiply-Add auf Float16-Werten auf x64-CPUs, die das unterstützen (JEP 508).
Vektoren aus Float16-Werten gibt es in Java 27 noch nicht. Im Early-Access-Build 23 von Java 28 steckt dagegen schon eine öffentliche Klasse Float16Vector. Sie kam am 11. Juni 2026 in den JDK-Quellcode, eine Woche nach dem Feature Freeze von Java 27. Einen JEP, der sie beschreibt, gibt es noch nicht.
Wann lohnt sich die Vector API?
Die Vector API lohnt sich, wenn drei Dinge zusammenkommen:
- Die Arbeit steckt in einer Schleife über primitive Arrays oder Speichersegmente – Zahlen, Bytes, Pixel, Messwerte.
- C2 vektorisiert diese Schleife nicht von selbst. Das betrifft Schleifen mit vorzeitigem Abbruch wie die Byte-Suche, Bedingungen, die du mit
compare()undblend()ausdrücken kannst, Umsortierungen zwischen Lanes und Filter mitcompress(). - Du hast gemessen, dass diese Schleife einen spürbaren Teil der Laufzeit deiner Anwendung ausmacht – und dass die Vector-API-Fassung schneller ist.
Für alles andere lohnt sich die Vector API nicht: Für eine Schleife, die C2 ohnehin vektorisiert, erzeugt sie denselben Code. Und für Code, der mit Objekten, Collections oder Strings arbeitet, gibt es keine Vektoren.
Bevor du die API in Produktionscode einsetzt, solltest du die Kehrseite kennen: Sie ist aktuell noch ein Incubator-Modul. Jede Java-Version kann sie ändern, spätestens mit der Fertigstellung ändert sich das Package, und jeder Start braucht --add-modules jdk.incubator.vector.
Dass sich das trotzdem lohnen kann, zeigen zwei Projekte, die die API heute einsetzen:
- Apache Lucene berechnet mit ihr Skalarprodukt, Kosinus-Ähnlichkeit und quadrierte Distanz zwischen Vektoren (Klasse
PanamaVectorUtilSupport). - Elasticsearch, das auf Lucene aufbaut, schaltet diese SIMD-Fassungen seit Version 8.9 standardmäßig ein, damit seine Vektorsuche die Ähnlichkeiten schneller berechnet (Elastic-Blog, Juni 2023). Für viele Distanzberechnungen nutzt Elasticsearch inzwischen allerdings eigenen C++-Code, den es über die Foreign Function & Memory API aufruft: Die Vector API habe für
float-Skalarprodukte gut funktioniert, handoptimierter C++-Code bleibe aber im Vorteil (Elastic-Blog, April 2026).
Ich empfehle dir: Schreib zuerst die skalare Schleife und miss sie. Greift die Auto-Vectorization nicht und liegt die Schleife im heißen Pfad, schreib eine Vector-API-Fassung daneben und miss erneut. Halte die skalare Fassung als Fallback und für Tests bereit – so kannst du die Vector API jederzeit wieder entfernen, falls sich die API ändert.
Fazit
Die Vector API gibt dir in Java direkten Zugriff auf die SIMD-Befehle, die sonst nur der JIT-Compiler nutzt. Eine Schleife über ein Array wird zur Schleife über Vektoren, die je nach CPU 128, 256 oder 512 Bit verarbeiten; Masken ersetzen Bedingungen, Shuffles verschieben Werte zwischen Lanes, und compress() filtert ohne Sprung.
Der Maschinencode zeigt, wo das etwas bringt und wo nicht: Bei der Addition zweier Arrays erzeugt C2 mit und ohne Vector API dieselbe Schleife mit vier int-Additionen pro Befehl. Bei der Byte-Suche, die C2 skalar lässt, verarbeitet die Vector-API-Fassung achtmal so viele Daten mit der gleichen Anzahl an Befehlen.
Die Messungen auf dem M5 Pro und dem i7-12700H bestätigen das: Die Byte-Suche ist ab 1.000 Elementen 7- bis 10-mal so schnell wie die skalare Schleife, das Skalarprodukt ab 1.000 Elementen 2,9- bis 5,9-mal so schnell wie eine skalare Schleife mit ebenso vielen Summen. Die Addition dagegen wird mit der Vector API auf keinem der beiden Rechner schneller. Mit Maske wird sie auf beiden sogar langsamer, auf dem M5 Pro um ein Vielfaches, sobald der letzte Durchlauf eine Teilmaske braucht.
Fertig ist die API erst, wenn Project Valhalla die Vektorklassen zu Value Classes macht. Mit Java 28 kommt die erste Valhalla-Preview ins JDK. Laut JEP wird die Vector API dann auf Value Classes umgestellt und selbst zur Preview – für Java 28 gibt es dafür bisher keinen JEP.
Was soll ich als Nächstes vertiefen? Das erfahre ich am besten durch dein Feedback: Eine Bewertung auf meinem ProvenExpert-Profil zeigt mir, welche Themen dir wichtig sind – und motiviert mich, weitere Artikel zu schreiben.