In der Artikelserie über Sortieralgorithmen kommen wir nach drei relativ leicht zu verstehenden Sortierverfahren (Insertion Sort, Selection Sort, Bubble Sort) zu den komplexeren – dafür aber auch deutlich effizienteren Algorithmen.
Wir beginnen mit Quicksort („Sort“ ist hier kein separates Wort, also nicht „Quick Sort“). Dieser Artikel:
- beschreibt den Quicksort-Algorithmus,
- zeigt dessen Quellcode in Java,
- erklärt, wie man die Zeitkomplexität von Quicksort herleitet,
- testet, ob die Performance der Java-Implementierung mit dem erwarteten Laufzeitverhalten übereinstimmt,
- stellt mehrere Algorithmus-Optimierungen vor (Kombination mit Insertion Sort und Dual-Pivot Quicksort)
- und misst und vergleicht auch deren Geschwindigkeit.
Die Quellcodes der Artikelserie findest du in meinem GitHub-Repository.
Quicksort Algorithmus
Quicksort funktioniert nach dem „Teile-und-herrsche“-Prinzip („divide and conquer“):
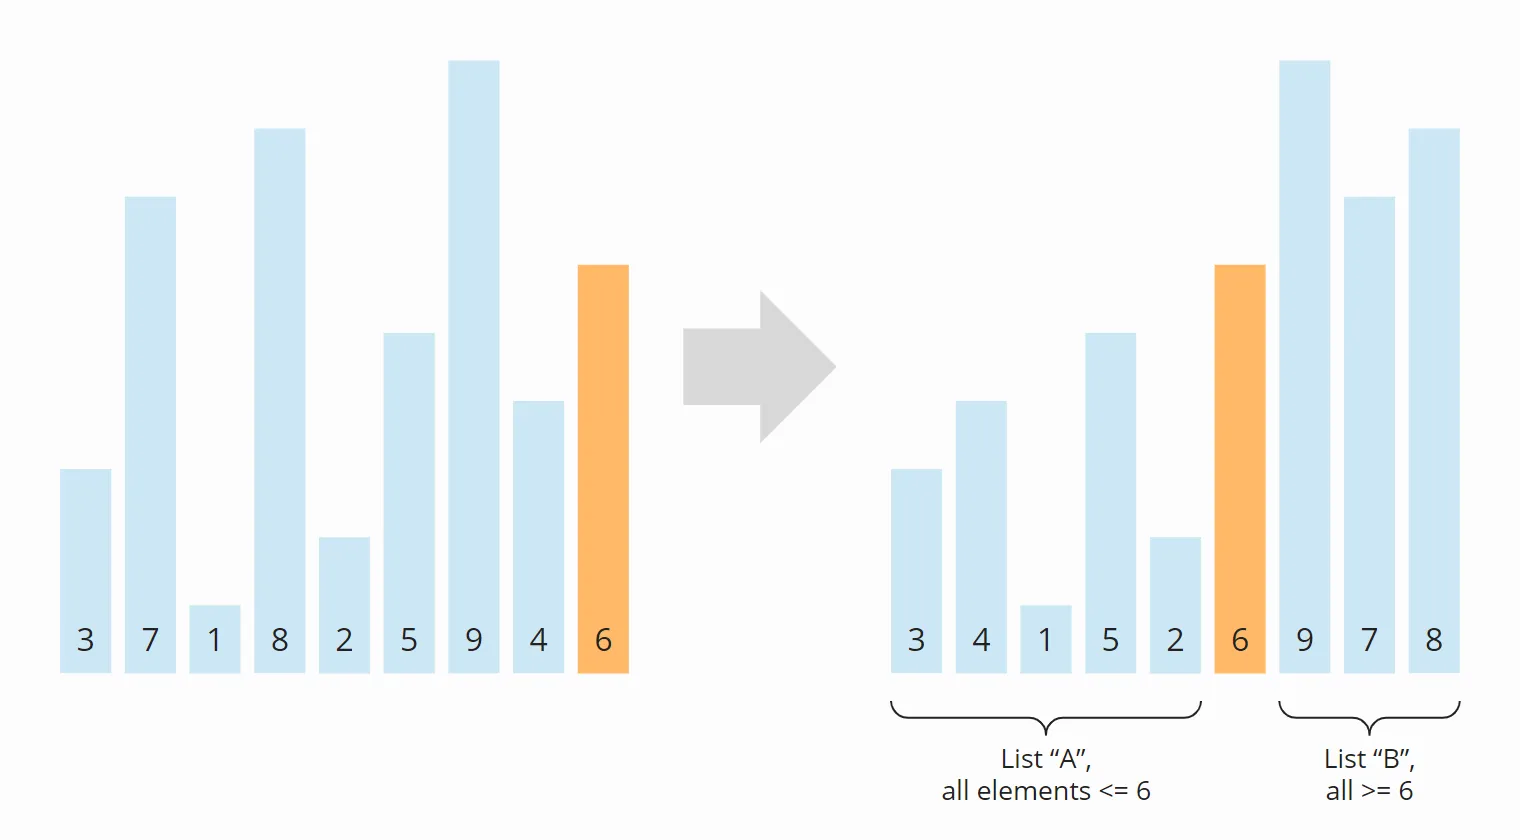
Als Erstes teilen wir die zu sortierenden Elemente auf zwei Bereiche auf – einen mit kleinen Elementen (im folgenden Beispiel „A“) und einen mit großen Elementen (im Beispiel „B“).
Welche Elemente klein sind und welche groß, entscheidet dabei das sogenannte Pivot-Element. Das Pivot-Element kann ein beliebiges Element aus dem Eingabe-Array sein. (Welches man wählt, bestimmt die Pivot-Strategie, dazu später mehr.)
Das Array wird nun so umsortiert, dass
- die Elemente, die kleiner als das Pivot-Element sind, im linken Bereich landen,
- die Elemente, die größer als das Pivot-Element sind, im rechten Bereich landen,
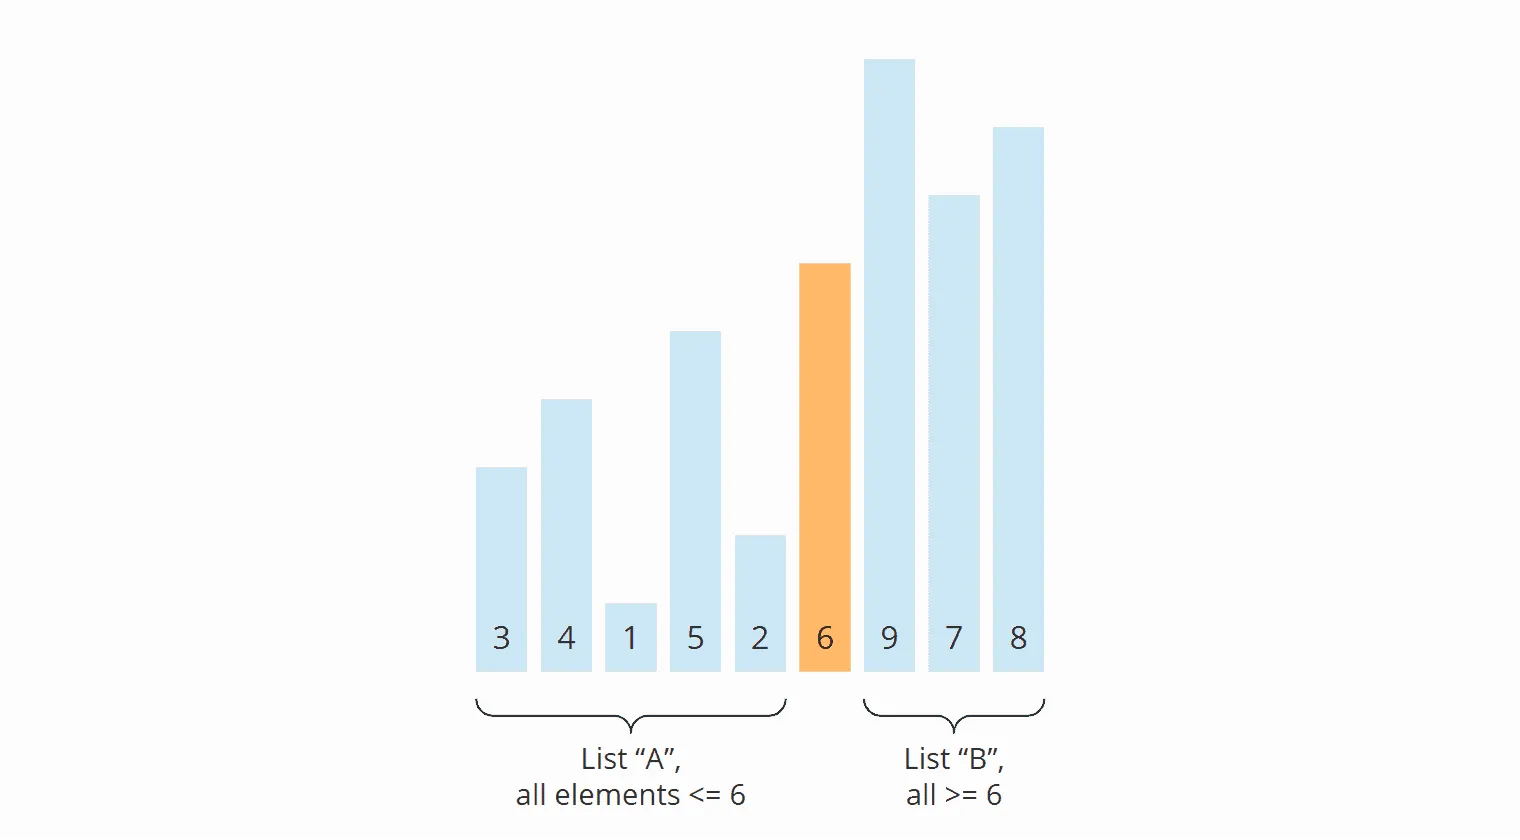
- und dass das Pivot-Element zwischen den zwei Bereichen positioniert wird – und damit automatisch an seiner endgültigen Position.
In folgendem Beispiel werden die Elemente [3, 7, 1, 8, 2, 5, 9, 4, 6] auf diese Art umsortiert. Als Pivot-Element habe ich das letzte Element des unsortierten Eingabe-Arrays gewählt (die orange gefärbte 6):
Dieses Aufteilen auf zwei Teil-Arrays nennt man Partitionieren. Wie die Partitionierung genau funktioniert, erfährst du im nächsten Abschnitt. Vorher zeige ich dir, wie der übergeordnete Algorithmus weitergeht.
Die Teil-Arrays links und rechts des Pivot-Elements sind nach der Partitionierung weiterhin unsortiert. Die Teil-Arrays werden nun ebenfalls partitioniert. Das Pivot-Element aus dem vorherigen Schritt, die 6, habe ich halbtransparent dargestellt, um die zwei Teil-Arrays besser erkennen zu können:
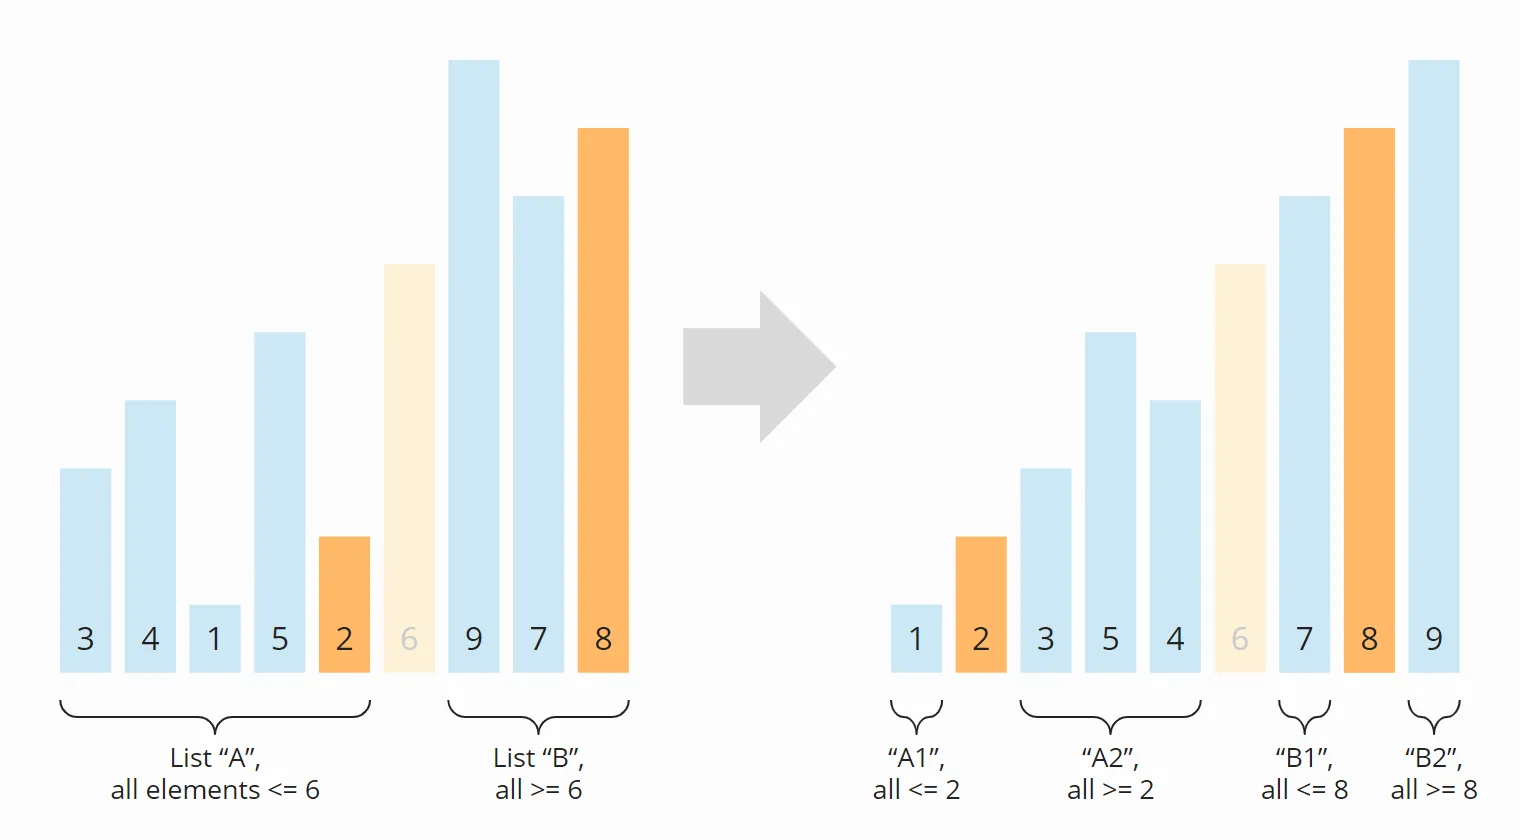
Nach der erneuten Partitionierung haben wir vier Bereiche: Aus A sind A1 und A2 entstanden; aus B sind B1 und B2 hervorgegangen. Die Bereiche A1, B1 und B2 bestehen aus nur noch einem Element und gelten damit als sortiert („beherrscht“ im Sinne von „Teile und herrsche“). Jetzt müssen wir nur noch das Teil-Array A2 partitionieren:
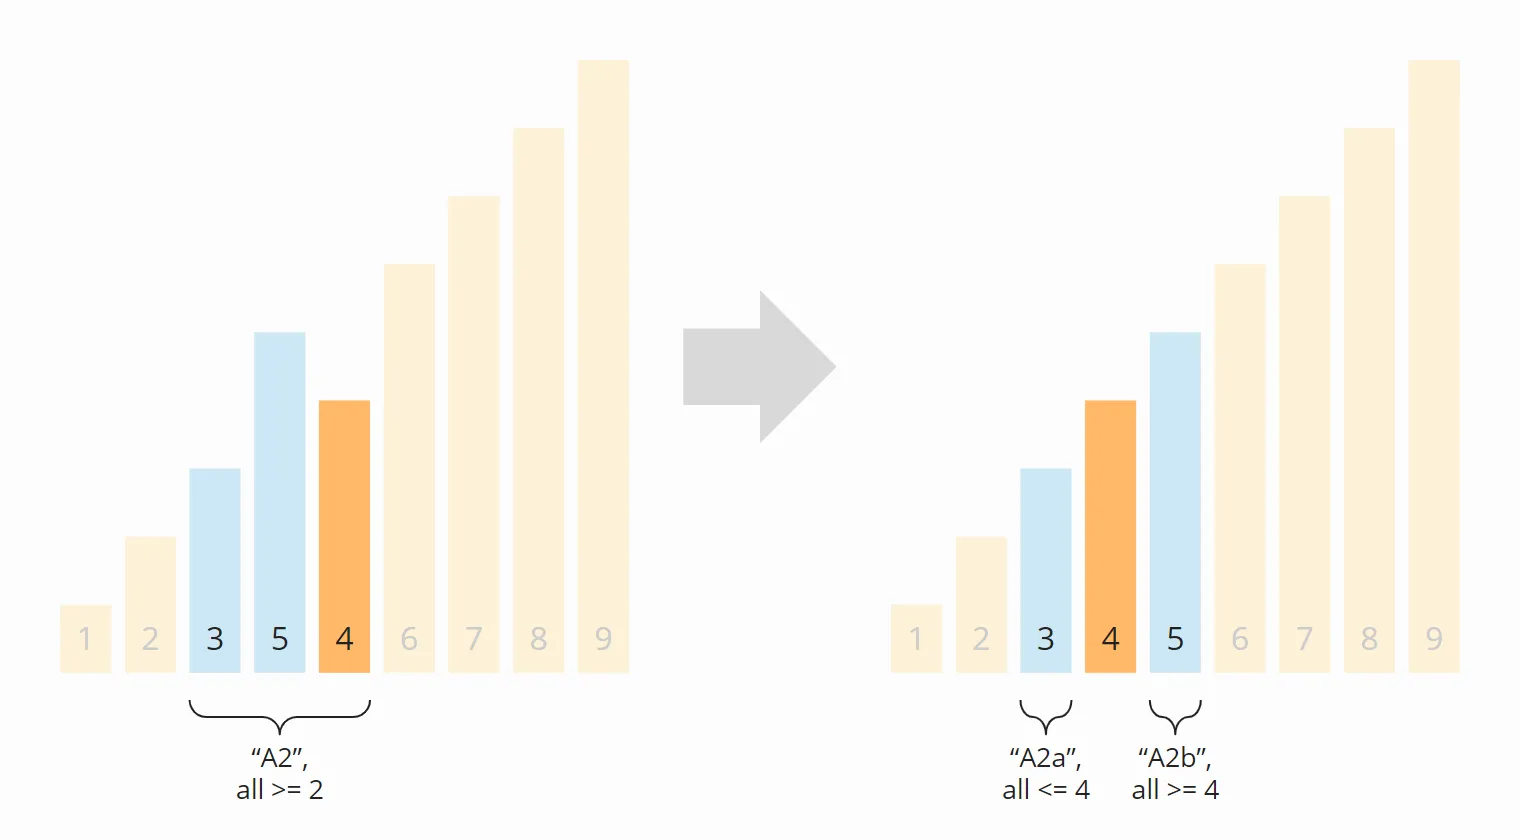
Die zwei in diesem Schritt aus A2 entstandenen Partitionen A2a und A2b haben wieder die Länge 1 und gelten damit als sortiert. Somit sind alle Teil-Arrays sortiert – und damit auch das gesamte Array:
Der Algorithmus ist damit beendet.
Wie die Aufteilung eines Arrays in zwei Bereiche funktioniert – die Partitionierung – erkläre ich im nächsten Abschnitt.
Quicksort Partitionierung
Die Aufteilung des Arrays in zwei Partitionen erfolgt, in dem wir von links beginnend nach Elementen suchen, die größer als das Pivot-Element sind, und von rechts beginnend nach Elementen, die kleiner sind als das Pivot-Element.
Diese Elemente werden dann jeweils vertauscht. Dies wiederholen wir solange, bis die linke und rechte Suchposition aufeinander getroffen oder aneinander vorbeigelaufen sind.
Im Beispiel von oben funktioniert das wie folgt:
- Das erste Element von links, das größer als das Pivot-Element 6 ist, ist die 7.
- Das erste Element von rechts, das kleiner als die 6 ist, ist die 4.
- Wir vertauschen die 7 und die 4.
Die 3 befand sich bereits auf der richtigen Seite (kleiner als 6, also links). Ich habe sie schwächer eingefärbt, da wir sie nicht weiter betrachten müssen.
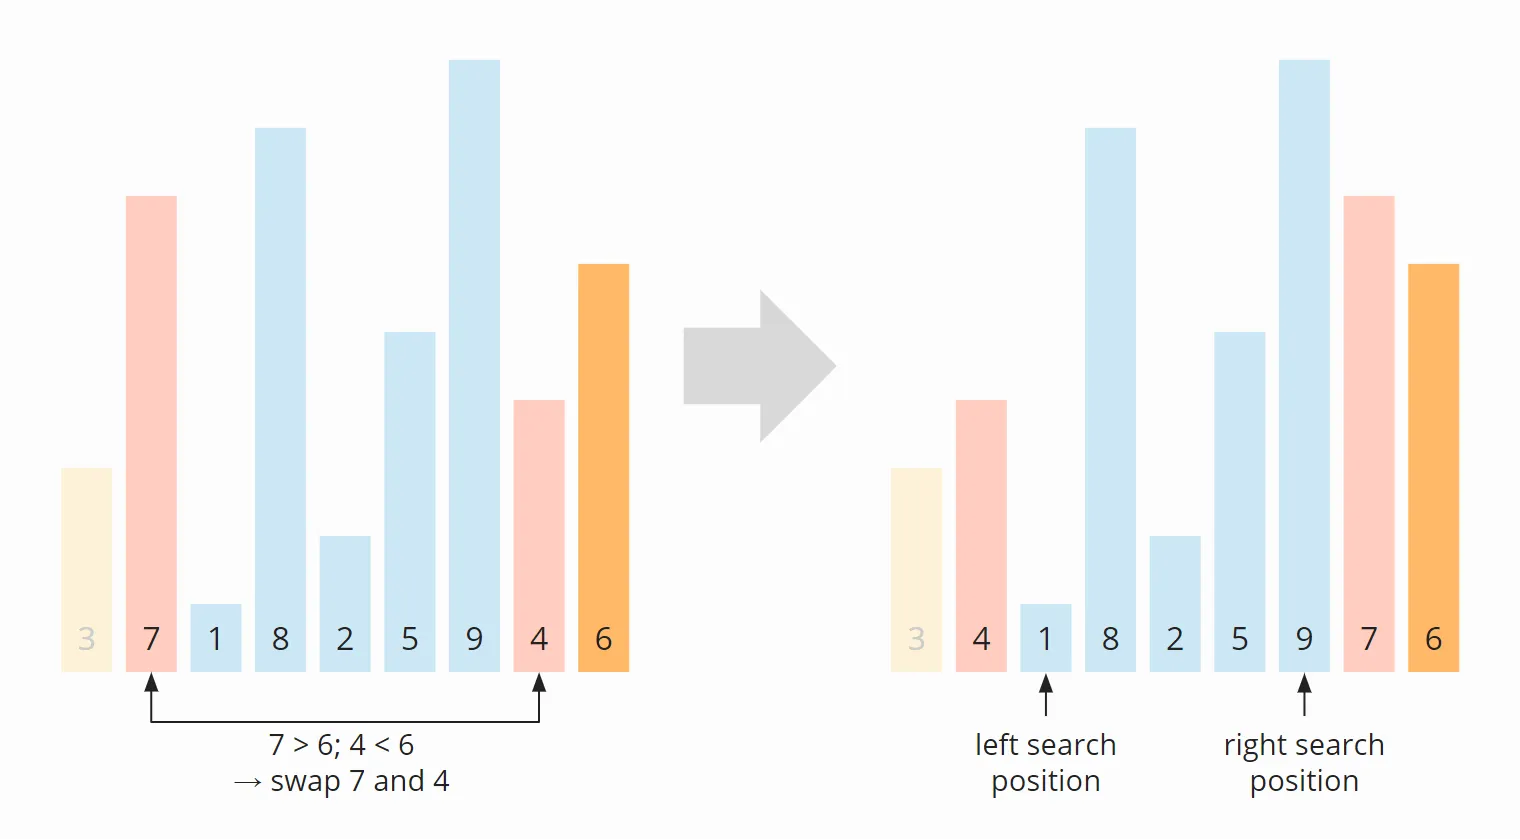
Wir suchen weiter und finden von links aus die 8 (die 1 ist schon auf der richtigen Seite, da kleiner als 6) und von rechts aus die 5 (die 9 ist ebenfalls bereits auf der richtigen Seite, da größer als 6). Wir vertauschen die 8 und die 5:
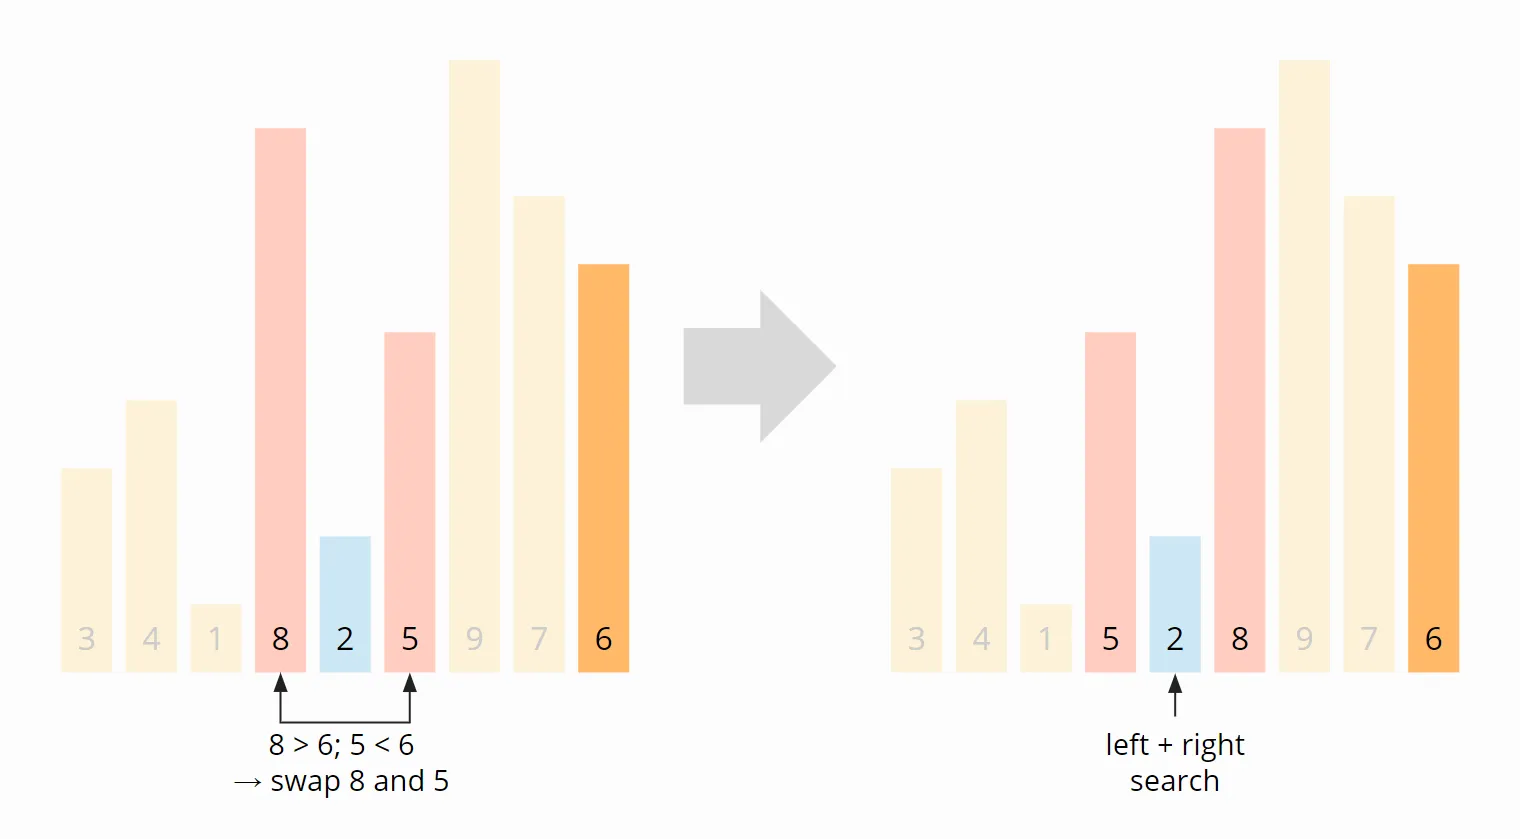
Nun treffen sich die linke und rechte Suchposition an der 2. Das Vertauschen endet hier. Da die 2 kleiner ist als das Pivot-Element, schieben wir den Suchzeiger noch eine Position nach rechts, auf die 8, so dass alle Elemente ab dieser Position größer oder gleich dem Pivot-Element sind und alle Elemente davor kleiner:
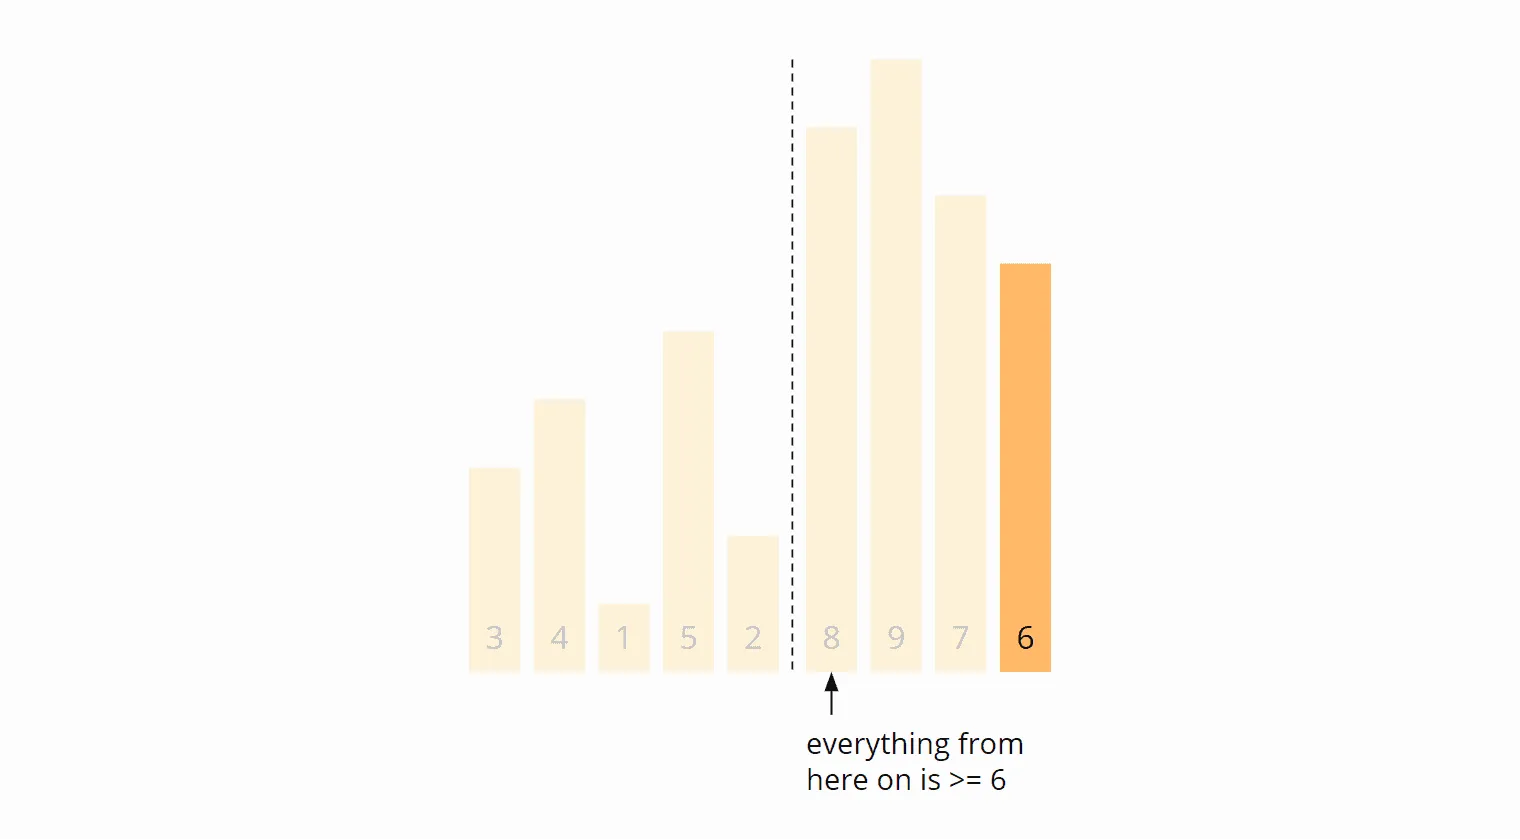
Damit das Pivot-Element am Anfang der rechten Partition steht, vertauschen wir noch die 8 mit der 6:
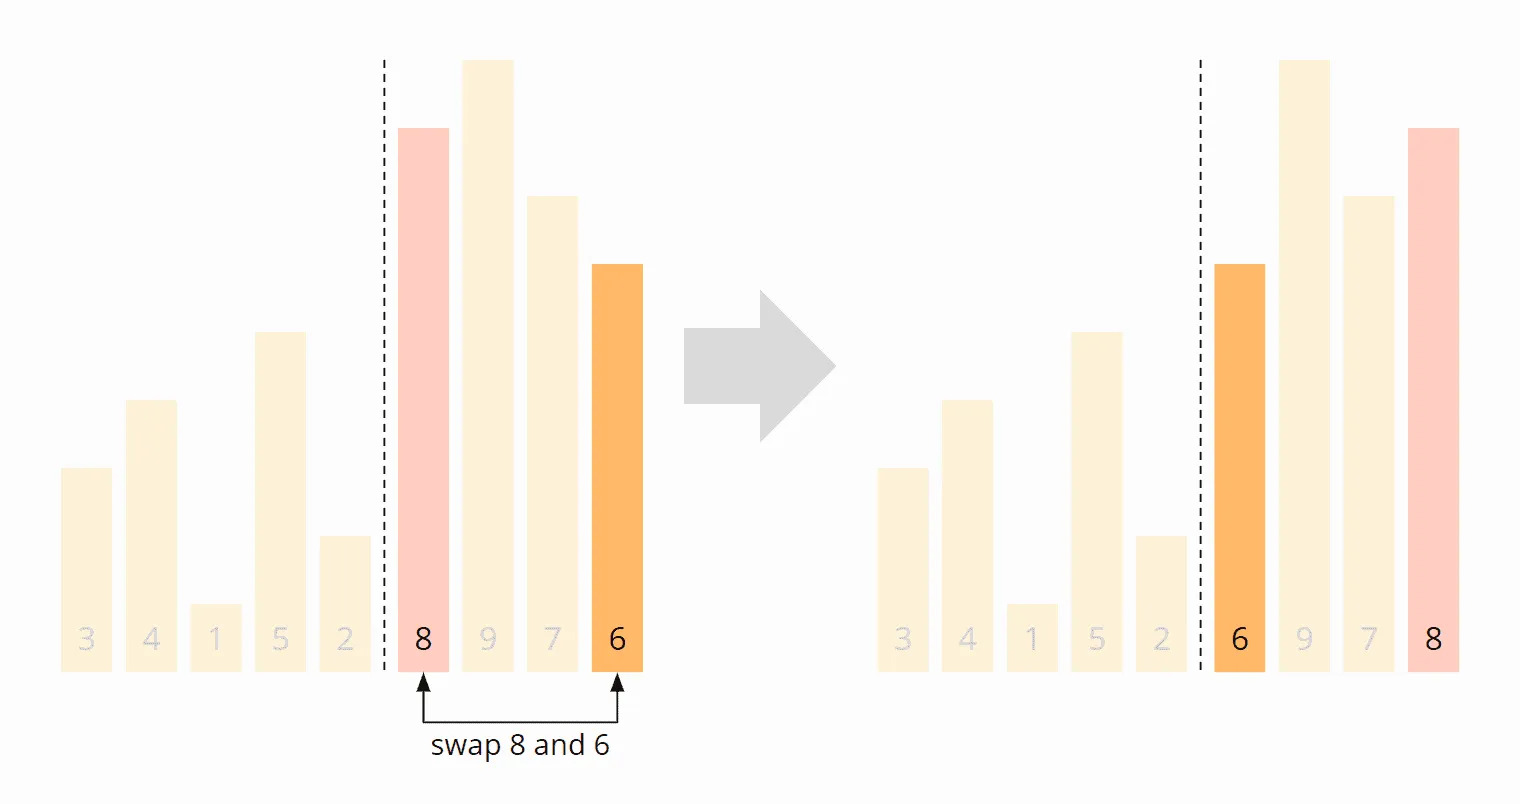
Die Partitionierung ist abgeschlossen: Die 6 befindet sich an der richtigen Position, die Zahlen links von der 6 sind kleiner und die Zahlen rechts davon größer. Wir haben also den Stand erreicht, der im vorangegangenen Abschnitt nach der ersten Partitionierung gezeigt wurde:
Das Pivot-Element
„Pivot“ ist französisch und bedeutet „Dreh- und Angelpunkt“.
Im vorangegangenen Beispiel habe ich jeweils das letzte Element eines (Teil-)Arrays als Pivot-Element ausgewählt. Diese Strategie hat den Vorteil, dass sie den Algorithmus besonders einfach macht; sie kann sich aber negativ auf die Performance auswirken.
Vorteil der Pivot-Strategie „letztes Element“
Der Vorteil ist, wie oben erwähnt, ein vereinfachter Algorithmus:
Da das Pivot-Element bei dieser Strategie garantiert im rechten Bereich liegt, brauchen wir es bei den Vergleichs- und Tauschoperationen nicht zu berücksichtigen. Außerdem können wir im letzten Schritt der Partitionierung bedenkenlos das erste Element des rechten Bereichs mit dem Pivot-Element vertauschen, um dieses an seine finale Position zu setzen.
Nachteil der Pivot-Strategie „letztes Element“
In der Praxis führt die Strategie zu Problemen bei vorsortierten Eingabedaten. Bei einem aufsteigend sortierten Array wäre das Pivot-Element in jeder Iteration das größte Element.
Damit würde das Array nicht mehr in zwei möglichst gleich große Partitionen aufgeteilt werden, sondern in eine leere (da kein Element größer ist als das Pivot-Element) und eine der Länge n-1 (mit allen Elementen außer dem Pivot-Element).
Dies würde sich negativ auf die Performance auswirken (s. Abschnitt „Quicksort Zeitkomplexität“).
Bei absteigend sortierten Eingabedaten wäre das Pivot-Element immer das kleinste Element, so dass die Partitionierung ebenfalls immer eine leere Partition und eine der Größe n-1 erzeugen würde.
Alternative Pivot-Strategien
Alternative Strategien für die Auswahl des Pivot-Elements sind z. B.:
- das mittlere Element,
- ein zufälliges Element,
- der Median aus drei, fünf oder mehr Elementen.
Wählt man auf eine dieser Arten das Pivot-Element aus, erhöht sich die Wahrscheinlichkeit, dass die aus der Partitionierung hervorgehenden Teil-Arrays möglichst gleich groß sind.
Wie sich die Wahl der Pivot-Strategie auf die Performance auswirkt, werde ich im Laufe des Artikels erklären.
Warum nicht der Median?
Im optimalen Fall teilt das Pivot-Element das Array in zwei gleich große Hälften. Warum wählt man dann nicht einfach den Median aller Elemente als Pivot-Element?
Aus folgendem Grund: Um den Median zu bestimmen, müsste man das Array erst einmal sortieren. Wir definieren aber gerade erst den Sortieralgorithmus – wir stehen also vor einem klassischen Henne-Ei-Problem.
Quicksort Java Quellcode
Der folgende Java-Quellcode (Klasse QuicksortSimple im GitHub-Repository) verwendet der Einfachheit halber als Pivot-Element immer das rechte Element eines zu sortierenden (Teil-)Arrays.
Wie oben erläutert, ist dies keine gute Wahl, wenn die Eingabedaten bereits sortiert sein könnten. Diese Variante macht den Code aber zunächst einfacher zu verstehen.
public class QuicksortSimple {

  public void sort(int[] elements) {
    quicksort(elements, 0, elements.length - 1);
  }

  private void quicksort(int[] elements, int left, int right) {
    // End of recursion reached?
    if (left >= right) {
      return;
    }

    int pivotPos = partition(elements, left, right);
    quicksort(elements, left, pivotPos - 1);
    quicksort(elements, pivotPos + 1, right);
  }

  public int partition(int[] elements, int left, int right) {
    int pivot = elements[right];

    int i = left;
    int j = right - 1;
    while (i < j) {
      // Find the first element >= pivot
      while (elements[i] < pivot) {
        i++;
      }

      // Find the last element < pivot
      while (j > left && elements[j] >= pivot) {
        j--;
      }

      // If the greater element is left of the lesser element, switch them
      if (i < j) {
        ArrayUtils.swap(elements, i, j);
        i++;
        j--;
      }
    }

    // i == j means we haven't checked this index yet.
    // Move i right if necessary so that i marks the start of the right array.
    if (i == j && elements[i] < pivot) {
      i++;
    }

    // Move pivot element to its final position
    if (elements[i] != pivot) {
      ArrayUtils.swap(elements, i, right);
    }
    return i;
  }

}
Erklärung des Quellcodes:
Die Methode sort() ruft quicksort() auf und übergibt das Array sowie die Start- und Endpositionen.
Die Methode quicksort() ruft zuerst die Methode partition() auf, um das Array zu partitionieren. Daraufhin ruft sie sich selbst rekursiv auf – einmal für das Teil-Array links des Pivot-Elements und einmal für das Teil-Array rechts des Pivot-Elements. Die Rekursion endet, wenn quicksort() für ein Sub-Array der Länge 1 oder 0 aufgerufen wird.
Die Methode partition() partitioniert das Array und gibt die Position des Pivot-Elements zurück. Die Variable i stellt den linken Suchzeiger dar, die Variable j den rechten Suchzeiger. Die einzelnen Schritte der partition()-Methode sind im Code dokumentiert – sie entsprechen den Schritten des Beispiels aus dem Abschnitt „Quicksort Partitionierung“.
Quellcode für alternative Pivot-Strategien
Wollen wir nicht das rechte, sondern ein anderes Element als Pivot-Element verwenden, muss der Algorithmus erweitert werden. Es gibt drei Varianten:
Algorithmus-Variante 1
Die einfachste Variante ist es, das gewählte Pivot-Element vorab mit dem rechten Element zu tauschen. In diesem Fall kann der restliche Quellcode unverändert bleiben.
Eine entsprechende Implementierung findest du in der Klasse QuicksortVariant1 im GitHub-Repository. In dieser Variante wird vor jeder Partitionierung die Methode findPivotAndMoveRight() aufgerufen, die entsprechend der gewählten Strategie das Pivot-Element auswählt und mit dem Element ganz rechts vertauscht.
Mögliche Pivot-Strategien sind im Enum PivotStrategy definiert und lauten:
RANDOM: ein zufälliges Element wird ausgewählt.LEFT: das linke Element wird ausgewählt.RIGHT: das rechte Element wird ausgewählt (entspricht letztendlich der oben abgedruckten Variante „QuicksortSimple“).MIDDLE: das mittlere Element wird ausgewählt.MEDIAN3: der Median aus drei Elementen des Arrays wird als Pivot-Element ausgewählt.
Algorithmus-Varianten 2 und 3
Es geht auch ohne den Vorabtausch – mit zwei Varianten, die das Pivot-Element anders behandeln:
- Variante 2 bezieht das Pivot-Element in den Tauschvorgang ein und merkt sich dessen Positionsänderung. Damit liegt es vor dem letzten Schritt der Partitionierung garantiert im rechten Bereich und kann ohne weitere Prüfung an seine finale Position getauscht werden. Quellcode:
QuicksortVariant2 - Variante 3 lässt das Pivot-Element während der Partitionierung liegen und tauscht nur Elemente, die größer sind, mit solchen, die kleiner sind. Dafür muss im letzten Schritt geprüft werden, in welchem der beiden Bereiche das Pivot-Element gelandet ist. Quellcode:
QuicksortVariant3
Beide sind in den Messungen weiter unten langsamer als Variante 1 – ich führe sie hier vor allem der Vollständigkeit halber auf.
Quicksort Zeitkomplexität
Klicke auf den folgenden Link für eine Einführung in „Zeitkomplexität“ und „O-Notation“ (mit Beispielen und Diagrammen).
Wir bezeichnen im Folgenden die Anzahl der zu sortierenden Elemente mit n.
Zeitkomplexität im best case
Quicksort erreicht optimale Performance, wenn wir die Arrays und Teil-Arrays immer wieder in zwei gleich große Partitionen aufteilen.
Denn dann brauchen wir bei einer Verdopplung der Anzahl der Elemente n nur eine einzige zusätzliche Stufe von Partitionierungen p. Folgendes Diagramm zeigt, dass bei vier Elementen zwei Partitionierungsstufen benötigt werden und bei acht Elementen nur eine mehr:
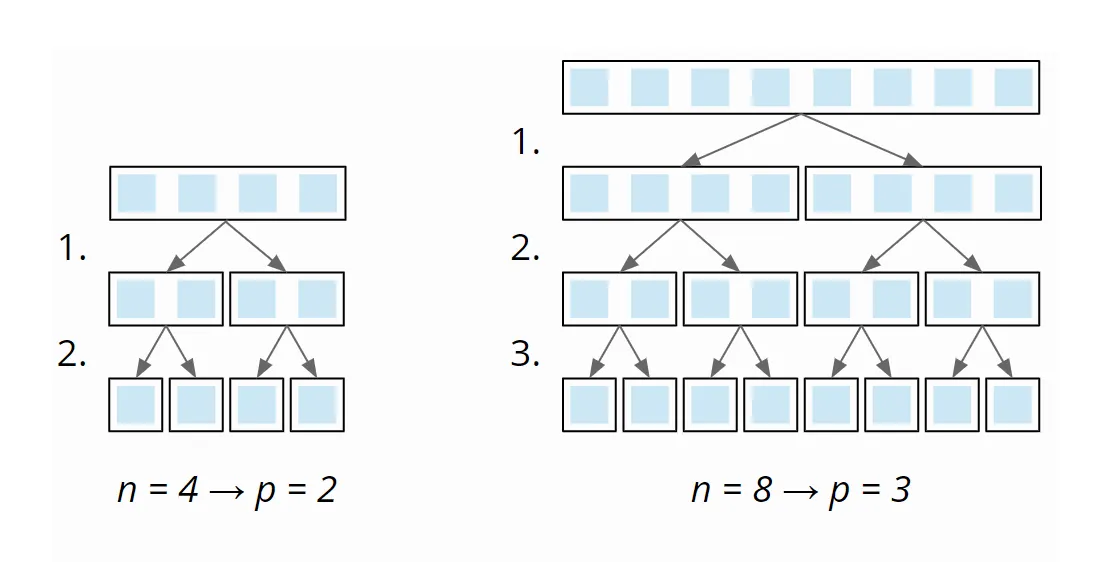
Wir haben also eine Anzahl an Partitionierungsstufen von log₂ n.
Auf jeder Partitionierungsstufe müssen wir insgesamt n Elemente auf linke und rechte Partition aufteilen (auf der ersten Ebene 1 × n, auf der zweiten 2 × n/2, auf der dritten 4 × n/4, usw.):
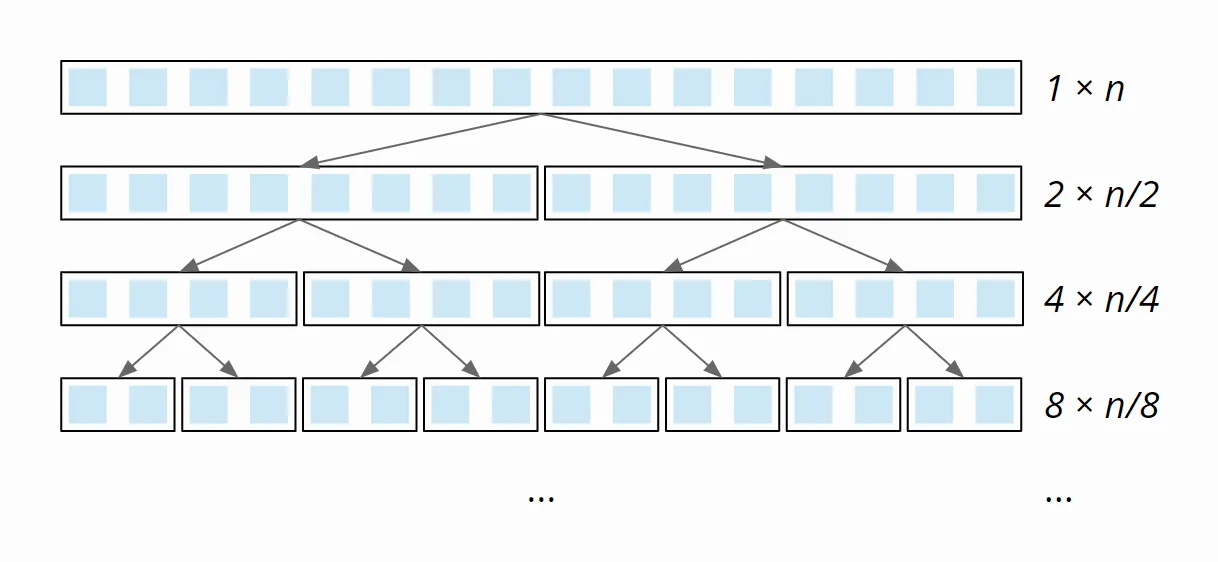
Diese Aufteilung erfolgt – aufgrund der einzelnen Schleife innerhalb der Partitionierung – mit linearem Aufwand: Bei Verdoppelung der Array-Größe verdoppelt sich auch der Partitionierungs-Aufwand. Der Gesamtaufwand ist daher auf allen Partitionierungsstufen gleich.
Wir haben also n Elemente mal log₂ n Partitionierungsstufen. Damit gilt:
Die Zeitkomplexität von Quicksort beträgt im best case: O(n log n).
Zeitkomplexität im average case
Die durchschnittliche Zeitkomplexität lässt sich leider nicht ohne komplizierte Mathematik herleiten. Diese würde den Rahmen dieses Artikels sprengen. Ich verwiese hier auf den englischsprachigen Wikipedia-Artikel.
Dieser kommt zu dem Schluss, dass die durchschnittliche Anzahl der Vergleichsoperationen 1,39 n × log₂ n beträgt – wir befinden uns also nach wie vor im quasilinearen Aufwand; es gilt:
Die Zeitkomplexität von Quicksort beträgt auch im average case: O(n log n).
Zeitkomplexität im worst case
Wenn das Pivot-Element immer das kleinste oder größte Element des (Teil-)Arrays ist (z. B. weil unsere Eingabedaten bereits sortiert sind und wir als Pivot-Element immer das letzte wählen), würde das Array nicht in zwei etwa gleich große Partitionen aufgeteilt werden, sondern in eine der Länge 0 (da kein Element größer als das Pivot-Element ist) und eine der Länge n-1 (alle Elemente bis auf das Pivot-Element).
Damit bräuchten wir n Partitionierungsstufen mit einem Partitionierungsaufwand der Größe n, n-1, n-2, usw:
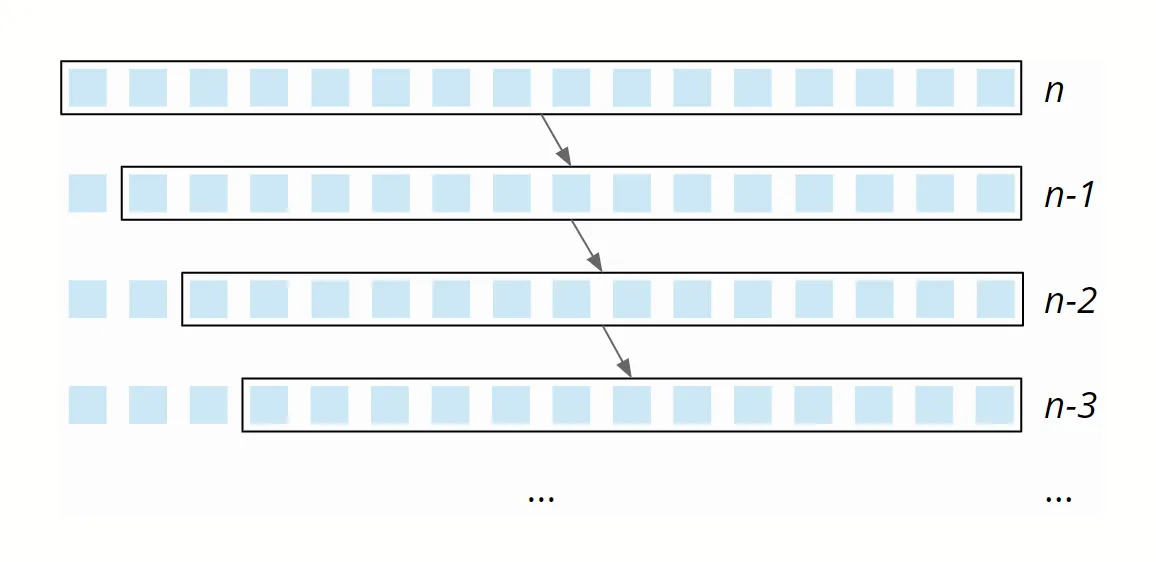
Der Partitionierungsaufwand sinkt linear von n bis 0 – im Mittel beträgt er also ½ n. Bei n Partitionierungsstufen beträgt der Gesamtaufwand also n × ½ n = ½ n². Es gilt somit:
Die Zeitkomplexität von Quicksort beträgt im worst case: O(n²).
In der Praxis würde der Versuch, ein aufsteigend oder absteigend vorsortiertes Array mit der Pivot-Strategie „rechtes Element“ zu sortieren, sehr schnell an einem StackOverflowError scheitern, da die Rekursion so tief gehen müsste wie das Array groß ist.
Der zweite worst case: viele gleiche Elemente
Vorsortierte Daten sind nicht der einzige Fall, in dem Quicksort quadratisch wird. Was passiert eigentlich, wenn ein Array sehr viele gleiche Elemente enthält?
Schauen wir uns dazu die partition()-Methode noch einmal an. Der linke Suchzeiger hält beim ersten Element, das größer oder gleich dem Pivot-Element ist – bei lauter gleichen Elementen also sofort ganz links. Der rechte Suchzeiger sucht das letzte Element, das kleiner als das Pivot-Element ist – und findet keines. Heraus kommt eine leere linke Partition und eine rechte der Länge n-1: exakt der worst case aus dem vorherigen Abschnitt.
Der entscheidende Unterschied: Hier hilft keine Pivot-Strategie. Ob mittleres Element, Zufall oder Median aus drei Elementen – wenn alle Elemente gleich sind, ist jedes Pivot-Element gleichzeitig das größte und das kleinste.
Und das ist kein theoretisches Problem. Ich habe die Klasse QuicksortSimple von oben mit Arrays getestet, die nur aus Nullen bestehen – hier sind die Messwerte:
| n | lauter gleiche Elemente | zufällige Elemente |
|---|---|---|
| 1.000 | 0,083 ms | 0,036 ms |
| 10.000 | 6,809 ms | 0,404 ms |
| 100.000 | StackOverflowError | 4,816 ms |
| 1.000.000 | StackOverflowError | 57,587 ms |
Bei zehnfacher Elementzahl steigt die Laufzeit für zufällige Werte auf das Elffache – für gleiche Elemente hingegen auf das Achtzigfache. Das ist der quadratische Aufwand, und ab 100.000 Elementen ist die Rekursion so tief, dass es zum StackOverflowError kommt.
Die übliche Lösung heißt 3-Wege-Partitionierung, bekannt auch als „Dutch National Flag“ nach dem gleichnamigen Problem von Edsger Dijkstra. Statt in zwei Bereiche teilt man in drei: kleiner, gleich und größer als das Pivot-Element. Der mittlere Bereich ist damit fertig sortiert und wird nicht weiter betrachtet. Ein Array aus lauter gleichen Elementen ist so nach einer einzigen Partitionierung erledigt.
Introsort: den worst case abschalten
Beide worst cases haben dieselbe Ursache – die Rekursion wird zu tief. Genau da kann man ansetzen, ohne den Algorithmus selbst anzufassen.
Die Idee heißt Introsort (für „introspective sort“): Der Algorithmus zählt mit, wie tief er bereits abgestiegen ist. Überschreitet die Rekursionstiefe einen Grenzwert – üblicherweise in der Größenordnung von 2 × log₂ n –, sortiert er den restlichen Teilbereich mit Heapsort zu Ende. Heapsort ist auch im worst case in O(n log n) und braucht keinen zusätzlichen Stack.
Das Ergebnis: im Normalfall die Geschwindigkeit von Quicksort, im worst case die Garantie von Heapsort. Der Preis ist ein Zähler, der bei jedem rekursiven Aufruf erhöht wird – in den Messungen nicht nachweisbar.
Genau so verhindert Arrays.sort() im JDK, dass die Laufzeit jemals quadratisch wird. Mehr dazu im Abschnitt „Was Arrays.sort() daraus gemacht hat“.
Weitere Eigenschaften von Quicksort
Als weitere Eigenschaften werden in diesem Kapitel die Platzkomplexität von Quicksort betrachtet, die Stabilität sowie die Parallelisierbarkeit.
Platzkomplexität von Quicksort
Für jede Rekursionsstufe brauchen wir zusätzlichen Speicher auf dem Stack. Im average und best case ist die maximale Rekursionstiefe durch O(log n) begrenzt (s. Abschnitt „Zeitkomplexität“).
Im worst case ist die maximale Rekursionstiefe n.
Der Algorithmus kann allerdings durch Endrekursion insoweit optimiert werden, dass immer nur die kleinere Partition durch Rekursion weiterverarbeitet wird und die größere durch Iteration.
Da die kleinere Teilpartition maximal halb so groß ist wie die Ausgangspartition (andernfalls wäre sie nicht die kleinere, sondern die größere Teilpartition), kommt es mit Endrekursion auch im worst case maximal zu einer Rekursionstiefe von log₂ n.
Der zusätzliche Speicherbedarf pro Rekursionsstufe ist konstant. Somit gilt:
Die Platzkomplexität von Quicksort ist im best und average case und – bei Einsatz von Endrekursion auch im worst case – O(log n).
Stabilität von Quicksort
Durch die Art und Weise, wie Elemente innerhalb der Partitionierung auf die Teilbereiche aufgeteilt werden, können Elemente mit gleichem Key ihre ursprüngliche Reihenfolge ändern.
Hier ein simples Beispiel: Partitioniert werden soll das Array [7, 8, 7, 2, 6] mit der Pivot-Strategie „Rechtes Element“. (Die zweite 7 habe ich als 7’ gekennzeichnet, um sie von der ersten unterscheiden zu können.)
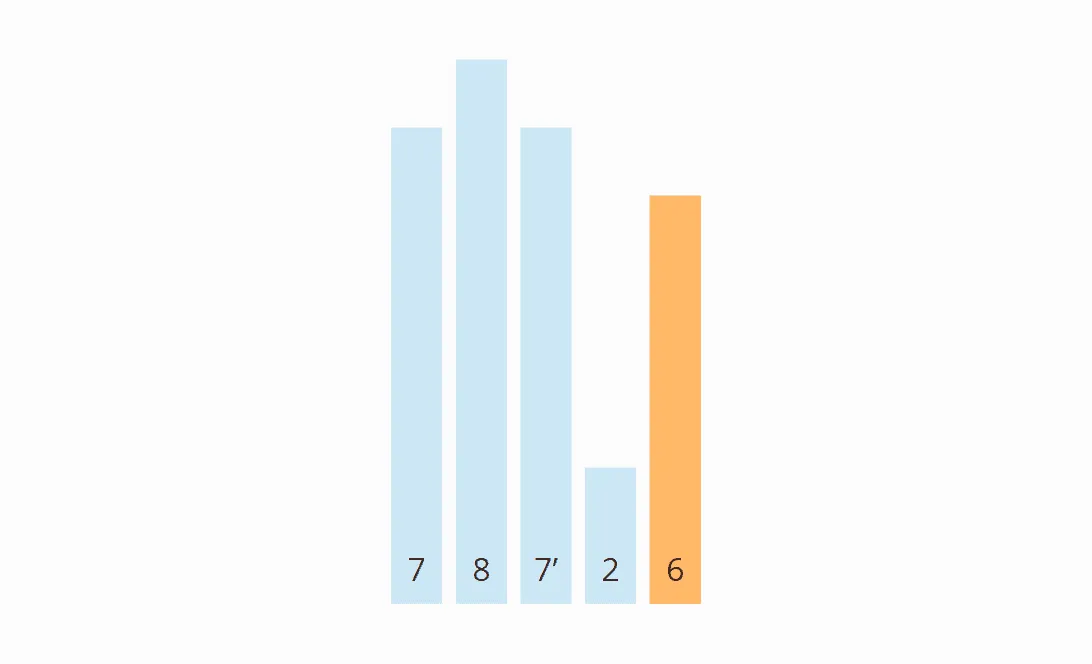
Das erste Element von links, das größer als die 6 ist, ist die erste 7. Das erste Element von rechts, das kleiner als die 6 ist, ist die 2. Es müssen also die erste 7 und die 2 vertauscht werden:
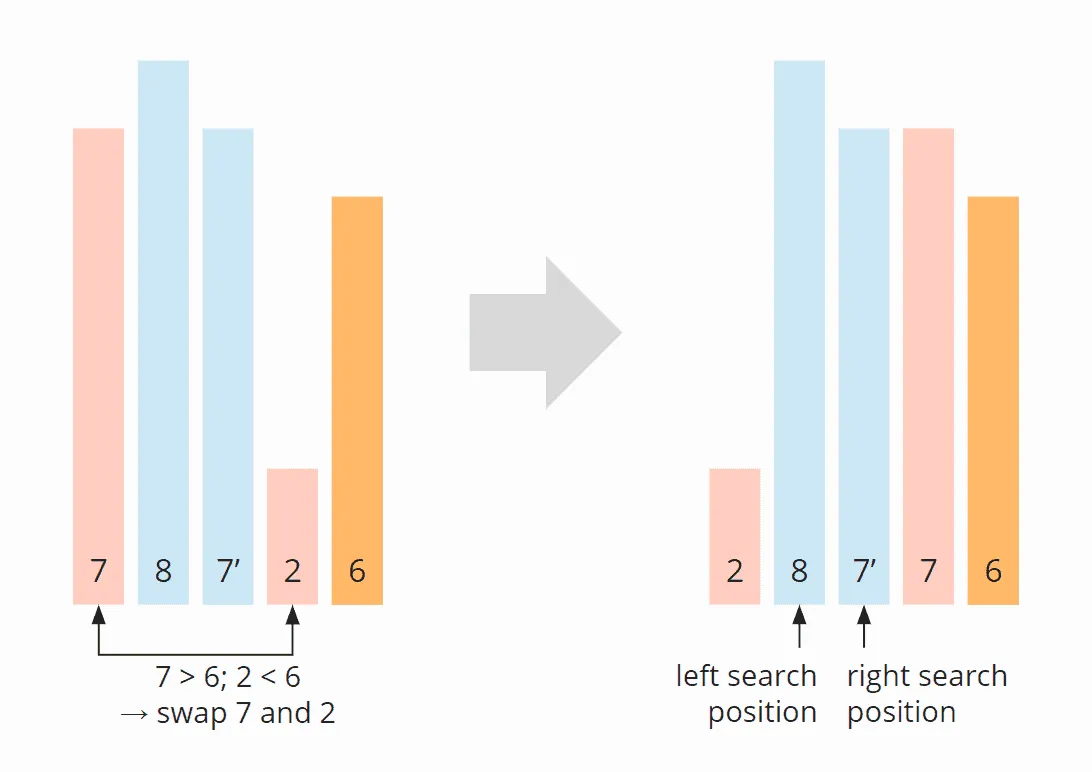
Die erste 7 befindet sich danach nicht mehr vor, sondern hinter der zweiten 7 (7’). Dies bleibt auch so, nachdem das erste Element der rechten Partition (die 8) mit dem Pivot-Element (der 6) vertauscht wurde:
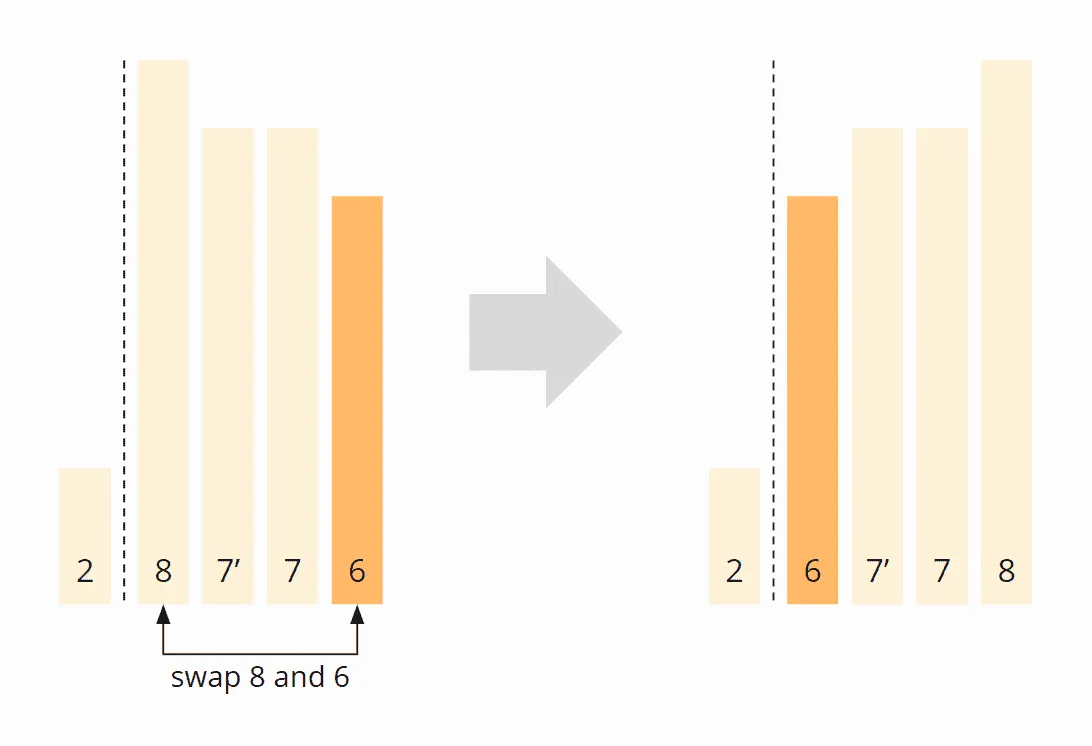
Quicksort ist demzufolge nicht stabil.
Parallelisierbarkeit von Quicksort
Es gibt verschiedene Varianten Quicksort zu parallelisieren.
Zum einen lassen sich mehrere Partitionen parallel weiter partitionieren. Bei dieser Variante kann jedoch die erste Partitionierungsstufe gar nicht parallelisiert werden, in der zweiten Stufe können nur zwei Cores ausgelastet werden, in der dritten nur vier, usw.
Es gibt mehrere andere, ausgefeiltere Varianten; eine Zusammenfassung findest du in diesem englischsprachigen Artikel über paralleles Quicksort.
Selbst implementieren musst du das übrigens nicht: Das JDK liefert mit Arrays.parallelSort() eine parallele Variante mit. Sie verwendet dieselbe Dual-Pivot-Implementierung wie Arrays.sort(), verteilt die Teil-Arrays aber über den Common ForkJoinPool. Bei 4.096 Elementen oder weniger sortiert sie sequenziell – darunter ist der Verwaltungsaufwand größer als der Gewinn.
Java Quicksort Laufzeit
Nach so viel Theorie zurück zur Praxis!
Mit dem Programm UltimateTest können wir die tatsächliche Performance von Quicksort (und allen anderen Algorithmen dieser Artikelserie) messen. Das Programm geht dabei wie folgt vor:
- Es sortiert Arrays der Größe 1.024, 2.048, 4.096, usw. bis maximal 536.870.912 (= 229), bricht dabei allerdings ab, wenn ein einzelner Sortiervorgang 20 Sekunden oder länger benötigt.
- Es wendet den Sortieralgorithmus auf unsortierte Eingabedaten, aufsteigend sortierte und absteigend sortierte Eingabedaten an.
- Es durchläuft zunächst zwei Warmup-Phasen, um dem HotSpot-Compiler ausreichend Zeit zu geben, den Code zu optimieren.
- Das Ganze wird so oft wiederholt, bis der Prozess beendet wird.
Laufzeit-Messung der Quicksort-Algorithmus-Varianten
Zunächst müssen wir entscheiden, welche Algorithmus-Variante wir ins Rennen schicken wollen, um den Test nicht ausufern zu lassen. Dafür kombiniert das Programm CompareQuicksorts alle Varianten mit allen Pivot-Strategien und sortiert mit jeder Kombination 50-mal etwa 5,5 Millionen Elemente. Ich habe dieses Programm dreimal laufen lassen – warum, dazu gleich mehr.
Hier ist das Ergebnis, sortiert nach Laufzeit – angegeben ist jeweils der Median aus drei Programmläufen:
| Variante | Pivot-Strategie | Median |
|---|---|---|
| QuicksortVariant2 | RIGHT | 304,5 ms |
| QuicksortSimple | RIGHT | 311,9 ms |
| QuicksortVariant2 | MIDDLE | 312,2 ms |
| QuicksortVariant1 | RIGHT | 317,8 ms |
| QuicksortVariant3 | RIGHT | 320,9 ms |
| QuicksortVariant1 | MIDDLE | 322,5 ms |
| QuicksortVariant3 | MIDDLE | 322,9 ms |
| QuicksortVariant2 | MEDIAN3 | 332,2 ms |
| QuicksortVariant2 | RANDOM | 338,2 ms |
| QuicksortVariant1 | MEDIAN3 | 339,7 ms |
| QuicksortVariant1 | RANDOM | 343,8 ms |
| QuicksortVariant3 | RANDOM | 347,2 ms |
| QuicksortVariant3 | MEDIAN3 | 351,5 ms |
Ein Ergebnis lässt sich klar ablesen: Die Pivot-Strategie „rechtes Element“ ist die schnellste – in jedem der drei Läufe und für jede Algorithmus-Variante. Dicht dahinter liegt „mittleres Element“, mit spürbarem Abstand folgen MEDIAN3 (den Median aus drei Elementen zu bestimmen kostet mehr, als die bessere Aufteilung einbringt) und RANDOM (Zufallszahlen zu generieren ist teuer).
Ein zweites Ergebnis lässt sich dagegen nicht ablesen, obwohl die Tabelle es nahelegt: welche der drei Algorithmus-Varianten die schnellste ist. Genau dafür habe ich das Programm dreimal laufen lassen – und die Rangfolge der Varianten war jedes Mal eine andere:
| Kombination | Lauf 1 | Lauf 2 | Lauf 3 |
|---|---|---|---|
| QuicksortVariant3 (RIGHT) | 321,0 ms | 295,0 ms | 320,9 ms |
| QuicksortVariant1 (MIDDLE) | 323,8 ms | 311,7 ms | 322,5 ms |
| QuicksortVariant2 (MIDDLE) | 315,2 ms | 308,9 ms | 312,2 ms |
Variante 3 mit Strategie „rechtes Element“ landete einmal auf Platz 5 und einmal auf Platz 1. Die Streuung eines einzelnen Algorithmus zwischen zwei Programmläufen beträgt bis zu 9,8 % – die Unterschiede zwischen den Varianten liegen bei 2 bis 4 %. Anders gesagt: Das Rauschen ist größer als das Signal.
Für die Praxis ist das wichtiger als die Rangfolge selbst. Wenn du selbst Sortieralgorithmen misst: Ein einzelner Lauf mit 50 Iterationen sieht sehr überzeugend aus und trägt trotzdem keine Aussage über 3 % Unterschied. Wiederhole den ganzen Lauf, bevor du eine Rangfolge glaubst – auch deine eigene.
Laufzeit-Messungen für verschiedene Pivot-Strategien und Array-Größen
Für die folgenden Messungen verwende ich Algorithmus-Variante 1 (Pivot-Element wird vorab mit dem rechten Element vertauscht). Nach dem eben Gesagten ist das keine Auswahl nach Geschwindigkeit – die Varianten geben sich nichts –, sondern nach Lesbarkeit: Variante 1 ist die, deren Quellcode oben abgedruckt ist.
In den folgenden Abschnitten findest du die Ergebnisse für die verschiedenen Pivot-Strategien – dies sind nur Auszüge aus der vollständigen Größenreihe.
Messergebnisse für Pivot-Strategie „rechtes Element“
| n | unsortiert | aufsteigend | absteigend |
|---|---|---|---|
| 1.024 | 0,039 ms | 0,203 ms | 0,158 ms |
| 2.048 | 0,080 ms | 0,753 ms | 0,706 ms |
| 4.096 | 0,156 ms | 2,944 ms | 2,534 ms |
| 8.192 | 0,310 ms | 9,935 ms | 8,064 ms |
| 16.384 | 0,630 ms | 43,888 ms | 37,322 ms |
| 32.768 | 1,316 ms | StackOverflow | StackOverflow |
| ... | ... | ... | ... |
| 33.554.432 | 1.989,486 ms | StackOverflow | StackOverflow |
| 67.108.864 | 4.159,747 ms | StackOverflow | StackOverflow |
| 134.217.728 | 8.582,452 ms | StackOverflow | StackOverflow |
| 268.435.456 | 17.773,553 ms | StackOverflow | StackOverflow |
Folgendes lässt sich ablesen:
- Bei zufällig verteilten Eingabedaten verlängert sich die benötigte Zeit um etwas mehr als das doppelte, wenn sich die Größe des zu sortierenden Arrays verdoppelt. Dies entspricht der erwarteten quasilinearen Laufzeit – O(n log n).
- Bei aufsteigend oder absteigend sortierten Eingabedaten vervierfacht sich die benötigte Zeit bei verdoppelter Eingabegröße, hier haben wir also quadratische Zeit – O(n²).
- Absteigend sortierte Daten zu sortieren geht etwas schneller als aufsteigend sortierte – 2020 war es noch umgekehrt.
- Bei nur 8.192 Elementen wird für das Sortieren vorsortierter Eingabedaten bereits 32-mal so lange benötigt wie für das Sortieren unsortierter Daten.
- Bei mehr als 16.384 Elementen kommt es bei vorsortierten Eingabedaten zum gefürchteten
StackOverflowError. Wo genau die Grenze liegt, hängt von der Stack-Größe des JVM-Threads ab – 2020 lag sie auf meiner damaligen Maschine noch bei 8.192 Elementen.
Messergebnisse für Pivot-Strategie „mittleres Element“
| n | unsortiert | aufsteigend | absteigend |
|---|---|---|---|
| ... | ... | ... | ... |
| 16.777.216 | 974,181 ms | 127,894 ms | 148,088 ms |
| 33.554.432 | 2.025,438 ms | 266,506 ms | 301,227 ms |
| 67.108.864 | 4.163,633 ms | 542,873 ms | 606,758 ms |
| 134.217.728 | 8.683,208 ms | 1.138,570 ms | 1.230,980 ms |
| 268.435.456 | 17.860,617 ms | 2.275,501 ms | 2.544,645 ms |
Es lässt sich ablesen:
- Sowohl für unsortierte als auch sortierte Eingabedaten wird bei Verdoppelung der Array-Größe etwas mehr als die doppelte Zeit benötigt. Dies entspricht der erwarteten quasilinearen Laufzeit – O(n log n).
- Für bereits sortierte Eingabedaten ist der Algorithmus deutlich schneller als für zufällig angeordnete – und zwar sowohl für aufsteigend als auch für absteigend sortierte Daten.
- Der Performance-Verlust durch den Vorabtausch des mittleren mit dem rechten Element beträgt in allen Tests mit unsortierten Eingabedaten weniger als 2 %.
Messergebnisse für Pivot-Strategie „Median aus drei Elementen“
| n | unsortiert | aufsteigend | absteigend |
|---|---|---|---|
| ... | ... | ... | ... |
| 16.777.216 | 1.035,508 ms | 144,924 ms | 151,647 ms |
| 33.554.432 | 2.163,330 ms | 309,074 ms | 317,733 ms |
| 67.108.864 | 4.448,295 ms | 611,474 ms | 657,845 ms |
| 134.217.728 | 9.269,976 ms | 1.285,079 ms | 1.362,625 ms |
| 268.435.456 | 19.033,378 ms | 2.592,648 ms | 2.748,447 ms |
Es lässt sich ablesen:
- Auch hier haben wir in allen Fällen quasi-linearen Aufwand – O(n log n).
- Die Pivot-Strategie „Median aus drei Elementen“ ist durchgehend etwa 6 % langsamer als die Strategie „mittleres Element“: Der Aufwand, den Median zu bestimmen, wiegt den Gewinn durch die bessere Aufteilung nicht auf.
Überblick über alle Messergebnisse
Hier findest du die Messergebnisse noch einmal als Diagramm (absteigend sortierte Eingabedaten habe ich der Übersicht halber weggelassen):
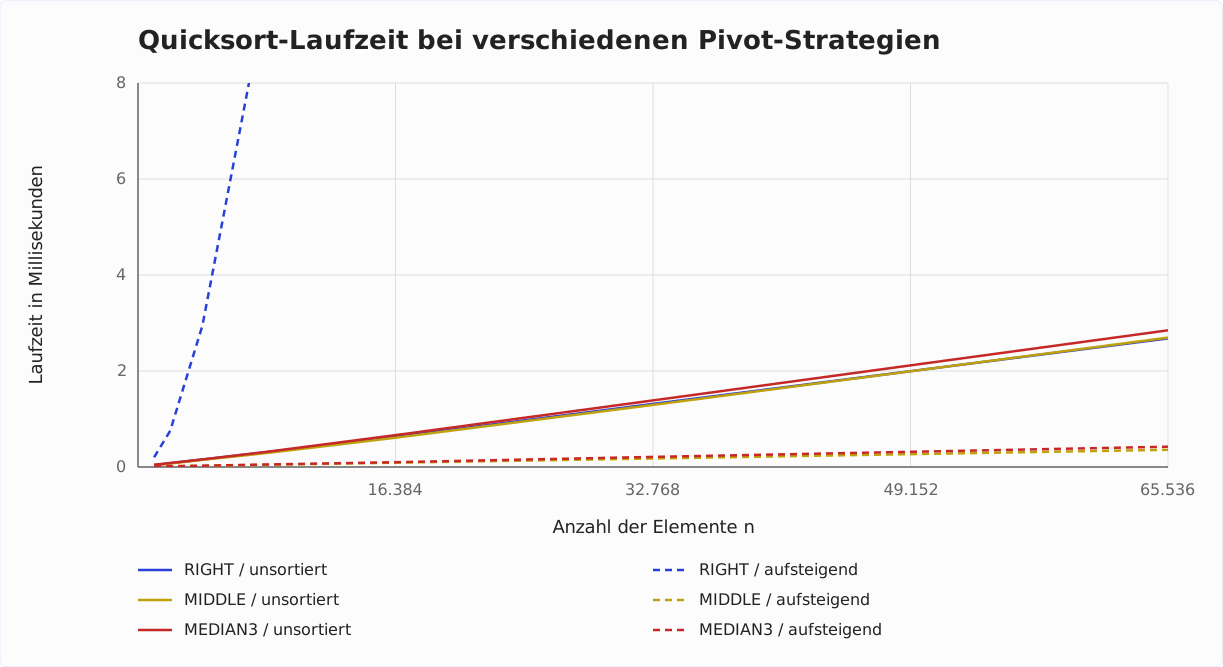
Zwei Dinge sind gut zu erkennen. Erstens verlässt die Kurve für „rechtes Element“ bei aufsteigend sortierten Daten das Diagramm nach oben – das ist der quadratische Aufwand. Zweitens liegen die drei durchgezogenen Linien für unsortierte Daten so dicht beieinander, dass sie sich überdecken: Für zufällig verteilte Eingabedaten ist es fast egal, welche Pivot-Strategie du wählst. Der Unterschied entsteht erst bei vorsortierten Daten – und dort ist „rechtes Element“ die einzige Strategie, die scheitert.
Quicksort optimiert: Kombination mit Insertion Sort
Für sehr kleine Arrays ist Insertion Sort schneller als Quicksort, daher werden in der Praxis diese Algorithmen häufig kombiniert. D. h. (Sub-)Arrays werden unterhalb einer bestimmten Größe nicht weiter partitioniert, sondern mit Insertion Sort sortiert.
Quicksort/Insertion Sort Quellcode
Die Quellcode-Änderungen gegenüber des Standard-Quicksorts sind sehr überschaubar und beschränken sich auf die quicksort()-Methode. Hier noch einmal die Methode aus dem Standard-Algorithmus:
private void quicksort(int[] elements, int left, int right) {
  // End of recursion reached?
  if (left >= right) {
    return;
  }

  int pivotPos = partition(elements, left, right);
  quicksort(elements, left, pivotPos - 1);
  quicksort(elements, pivotPos + 1, right);
}
Und hier die optimierte Variante, wobei die Variablen insertionSort und partitioningAlgorithm Instanzen des Insertion-Sort- und des Quicksort-Algorithmus sind. Hinzugekommen ist hier lediglich der mit „Threshold for insertion sort reached?“ kommentierte Code-Block in der Mitte der Methode:
private void quicksort(int[] elements, int left, int right) {
  // End of recursion reached?
  if (left >= right) {
    return;
  }

  // Threshold for insertion sort reached?
  if (right - left < threshold) {
    insertionSort.sort(elements, left, right + 1);
    return;
  }

  int pivotPos = partitioningAlgorithm.partition(elements, left, right);
  quicksort(elements, left, pivotPos - 1);
  quicksort(elements, pivotPos + 1, right);
}
Den kompletten Quellcode findest du in der Klasse QuicksortImproved im GitHub-Repository. Als Konstruktorparameter wird der Grenzwert für das Umschalten auf Insertion Sort, threshold, übergeben, sowie eine Instanz der zu verwendenden Quicksort-Variante.
Quicksort/Insertion Sort Performance
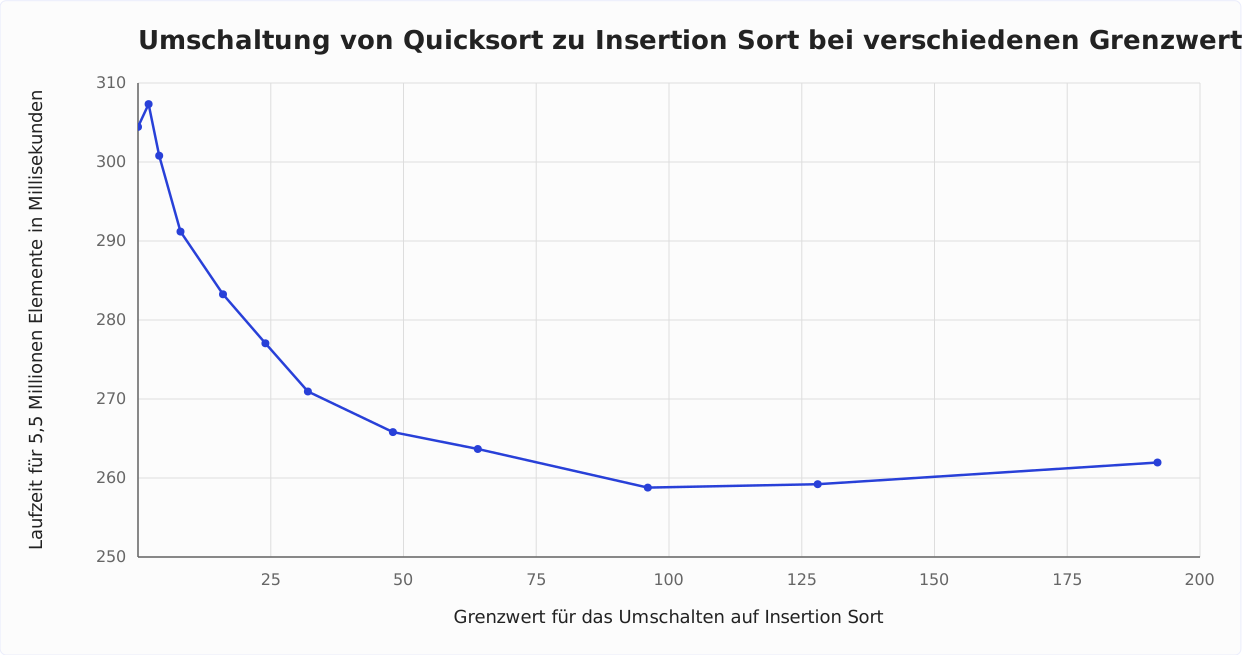
Das Programm CompareImprovedQuickSort misst die benötigte Zeit zum Sortieren von etwa 5,5 Millionen Elementen bei verschiedenen Grenzwerten für das Umschalten auf Insertion Sort.
Da das optimierte Quicksort nur Arrays ab einer gewissen Größe partitioniert, könnte der Einfluss der Pivot-Strategie und der Algorithmus-Variante eine andere Rolle spielen als bisher. Um dies zu berücksichtigen, testet das Programm die Grenzwerte für alle drei Algorithmus-Varianten sowie die Pivot-Strategien „Mitte“ und „Median aus drei Elementen“.
Wie auch in den vorangegangenen Tests performen hier Algorithmus-Variante 1 und Pivot-Strategie „Mittleres Element“ durchgehend am besten.
Hier die Messwerte für die gewählte Kombination und verschiedene Grenzwerte für das Umschalten auf Insertion Sort:
| Grenzwert | Laufzeit |
|---|---|
| 0 (= reguläres Quicksort) | 304,4 ms |
| 2 | 307,3 ms |
| 4 | 300,8 ms |
| 8 | 291,2 ms |
| 16 | 283,3 ms |
| 24 | 277,0 ms |
| 32 | 271,0 ms |
| 48 | 265,8 ms |
| 64 | 263,7 ms |
| 96 | 258,8 ms |
| 128 | 259,2 ms |
| 192 | 262,0 ms |
Hier die Messwerte in grafischer Darstellung:
Resultat:
Durch das Umschalten auf Insertion Sort für (Sub-)Arrays, die 96 oder weniger Elemente enthalten, können wir die Laufzeit von Quicksort bei 5,5 Millionen Elementen auf etwa 85 % des ursprünglichen Wertes reduzieren.
Der genaue Grenzwert ist dabei unkritisch: Zwischen 64 und 128 liegen alle Messwerte innerhalb von 2 %. Wichtig ist, überhaupt umzuschalten – der genaue Wert ist zweitrangig. (2020 lag das Optimum bei 48 – bei anderer Hardware, anderer Architektur und sechs Java-Releases Abstand ist die Verschiebung nicht überraschend.)
Wie sich der optimierte Quicksort-Algorithmus bei anderen Eingabegrößen schlägt, erfährst du im Abschnitt „Vergleich aller Quicksort-Optimierungen“.
Dual-Pivot Quicksort
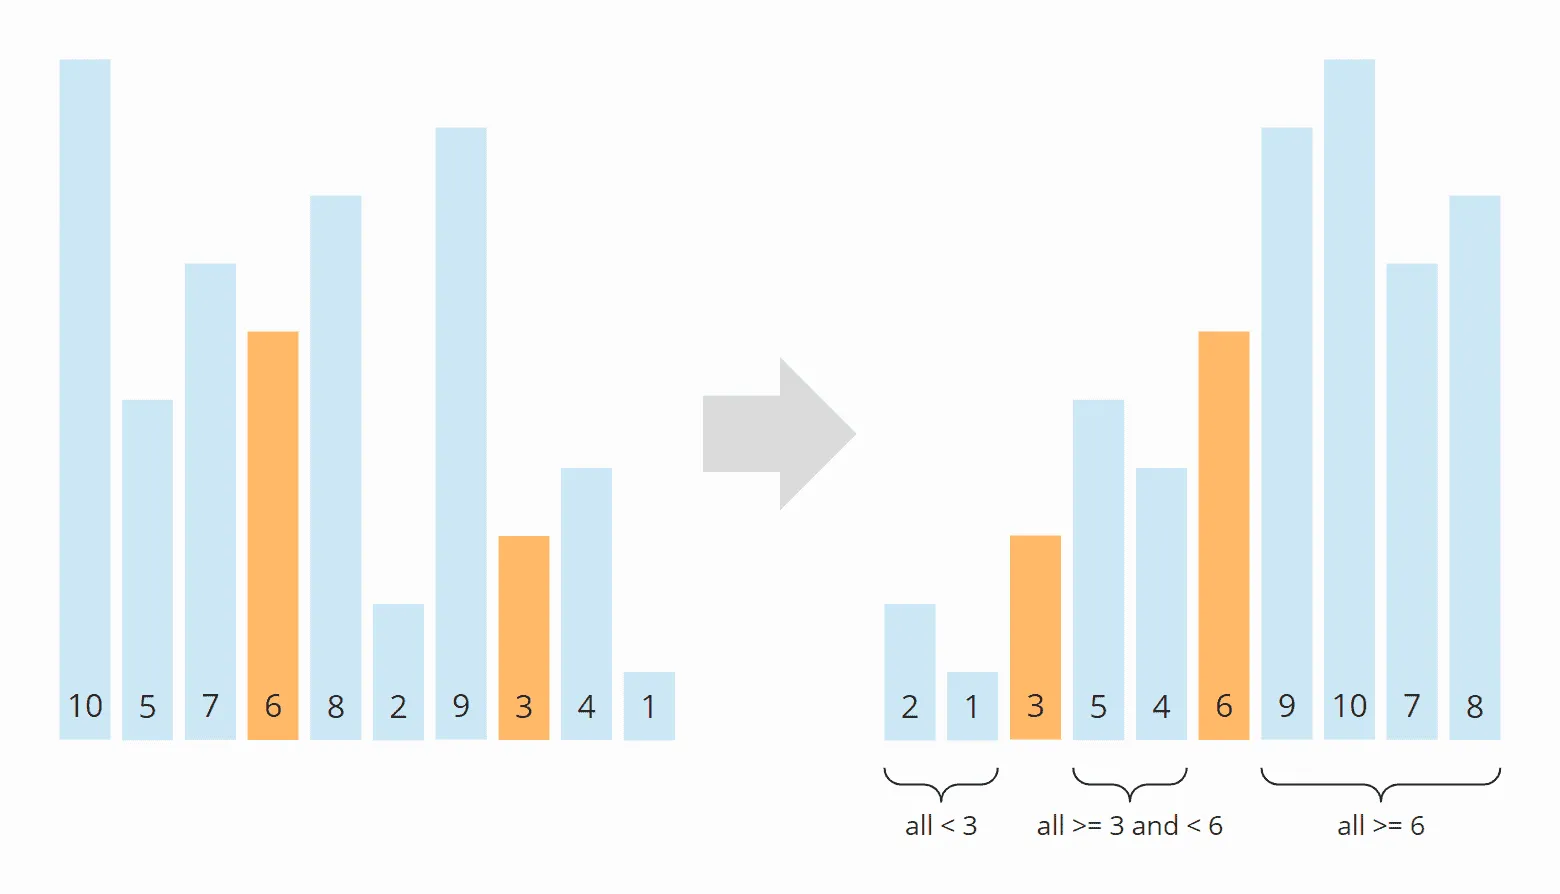
Quicksort lässt sich noch weiter optimieren, in dem man nicht ein Pivot-Element verwendet, sondern zwei. Bei der Partitionierung werden die Elemente dann aufgeteilt in:
- Elemente kleiner als das kleinere Pivot-Element,
- Elemente größer als/gleich wie das kleinere Pivot-Element und kleiner als das größere Pivot-Element,
- Elemente größer als/gleich wie das größere Pivot-Element.
Auch hier gibt es unterschiedliche Pivot-Strategien, z. B.:
- Linkes und rechtes Element: Dies führt – analog zum regulären Quicksort – dazu, dass bei sortierten Elementen zwei Partitionen leer bleiben und eine Partition n-2 Elemente enthält. Dies wiederum resultiert in quadratischem Aufwand und einem
StackOverflowErrorschon bei vergleichsweise kleinen n. - Elemente an den Position „ein Drittel“ und „zwei Drittel“: Dies ist vergleichbar mit der Strategie „Mittleres Element“ im regulären Quicksort.
Das folgende Diagramm zeigt eine beispielhafte Partitionierung mit zwei Pivot-Elementen an den „Drittel“-Positionen:
Was Arrays.sort() daraus gemacht hat
Dual-Pivot Quicksort ist der Algorithmus hinter Arrays.sort() im JDK – allerdings nur für Arrays primitiver Datentypen. Objekt-Arrays sortiert Arrays.sort() mit Timsort, einer Mergesort-Variante. Der Grund ist die Stabilität: Bei Objekten ist die ursprüngliche Reihenfolge gleicher Elemente in der Regel relevant, und Quicksort erhält sie nicht (s. Abschnitt „Stabilität von Quicksort“).
Und selbst für int[] ist die JDK-Methode seit Java 14 kein reines Dual-Pivot Quicksort mehr, sondern ein Hybrid aus mehreren Verfahren (nachzulesen in DualPivotQuicksort.java):
- Teil-Arrays mit weniger als 44 Elementen sortiert Insertion Sort – dieselbe Optimierung, die wir weiter oben selbst eingebaut haben.
- Bevor überhaupt partitioniert wird, prüft die Methode, ob das Array bereits aus wenigen sortierten Läufen („runs“) besteht. Ist das der Fall, werden diese Läufe gemergt statt partitioniert. Das ist der Grund, warum
Arrays.sort()vorsortierte Daten praktisch in Nullzeit sortiert – wir werden das im Abschnitt „Vergleich aller Quicksort-Optimierungen“ messen. - Wird die Rekursion zu tief – nach 64 Stufen –, schaltet die Methode auf Heapsort um. Das ist das Introsort-Prinzip von oben, und es schließt einen
StackOverflowErrorbeiArrays.sort()aus. - Für
byte,charundshort, also Datentypen mit kleinem Wertebereich, kommt bei ausreichend großen Arrays Counting Sort zum Einsatz.
Die Zahlen stammen aus dem JDK 26; sie sind seit Java 14 unverändert.
Dual-Pivot Quicksort Quellcode
Die quicksort()-Methode ruft sich – im Vergleich zum regulären Algorithmus – nicht für zwei, sondern für drei Partitionen rekursiv auf:
private void quicksort(int[] elements, int left, int right) {
  // End of recursion reached?
  if (left >= right) {
    return;
  }

  int[] pivotPos = partition(elements, left, right);
  int p0 = pivotPos[0];
  int p1 = pivotPos[1];
  quicksort(elements, left, p0 - 1);
  quicksort(elements, p0 + 1, p1 - 1);
  quicksort(elements, p1 + 1, right);
}
Die partition()-Methode ruft zunächst findPivotsAndMoveToLeftRight() auf, welche anhand der gewählten Pivot-Strategie die Pivot-Elemente auswählt und mit den Elementen links und rechts vertauscht (analog zum Vertauschen des Pivot-Elements mit dem rechten Elemente im regulären Quicksort).
Danach laufen wieder zwei Suchzeiger von links und rechts über das Array und vergleichen und tauschen die Elemente, so dass diese am Ende auf drei Partitionen aufgeteilt sind. Wie genau sie das tun, lässt sich anhand der sprechenden Variablennamen einigermaßen gut am Quellcode ablesen.
int[] partition(int[] elements, int left, int right) {
  findPivotsAndMoveToLeftRight(elements, left, right);
  int leftPivot = elements[left];
  int rightPivot = elements[right];

  int leftPartitionEnd = left + 1;
  int leftIndex = left + 1;
  int rightIndex = right - 1;

  while (leftIndex <= rightIndex) {

    // elements < left pivot element?
    if (elements[leftIndex] < leftPivot) {
      ArrayUtils.swap(elements, leftIndex, leftPartitionEnd);
      leftPartitionEnd++;
    }

    // elements >= right pivot element?
    else if (elements[leftIndex] >= rightPivot) {
      while (elements[rightIndex] > rightPivot && leftIndex < rightIndex) {
        rightIndex--;
      }
      ArrayUtils.swap(elements, leftIndex, rightIndex);
      rightIndex--;
      if (elements[leftIndex] < leftPivot) {
        ArrayUtils.swap(elements, leftIndex, leftPartitionEnd);
        leftPartitionEnd++;
      }
    }
    leftIndex++;
  }
  leftPartitionEnd--;
  rightIndex++;

  // move pivots to their final positions
  ArrayUtils.swap(elements, left, leftPartitionEnd);
  ArrayUtils.swap(elements, right, rightIndex);

  return new int[]{leftPartitionEnd, rightIndex};
}
Die Methode findPivotsAndMoveToLeftRight() arbeitet wie folgt:
Bei der Pivot-Strategie LEFT_RIGHT prüft sie, ob das ganz linke Element kleiner ist als das ganz rechte. Wenn nicht, werden beide vertauscht.
Bei der Strategie THIRDS werden zunächst die Elemente an den Positionen „ein Drittel“ (Variable first) und „zwei Drittel“ (Variable second) extrahiert. Danach folgt eine Reihe von if-Abfragen, die letztendlich bloß das größere der beiden Elemente nach ganz rechts setzt und das kleinere der beiden Elemente nach ganz links.
(Der Code wird dadurch so aufgebläht, dass zwei Sonderfälle berücksichtigt werden müssen: In sehr kleinen Partitionen könnte das erste Pivot-Element auf das ganz linke Element fallen und das zweite Pivot-Element auf das ganz rechte Element.)
private void findPivotsAndMoveToLeftRight(int[] elements,
                                          int left, int right) {
  switch (pivotStrategy) {
    case LEFT_RIGHT -> {
      if (elements[left] > elements[right]) {
        ArrayUtils.swap(elements, left, right);
      }
    }

    case THIRDS -> {
      int len = right - left + 1;
      int firstPos = left + (len - 1) / 3;
      int secondPos = right - (len - 2) / 3;

      int first = elements[firstPos];
      int second = elements[secondPos];

      if (first > second) {
        if (secondPos == right) {
          if (firstPos == left) {
            ArrayUtils.swap(elements, left, right);
          } else {
            // 3-way swap
            elements[right] = first;
            elements[firstPos] = elements[left];
            elements[left] = second;
          }
        } else if (firstPos == left) {
          // 3-way swap
          elements[left] = second;
          elements[secondPos] = elements[right];
          elements[right] = first;
        } else {
          ArrayUtils.swap(elements, firstPos, right);
          ArrayUtils.swap(elements, secondPos, left);
        }
      } else {
        if (secondPos != right) {
          ArrayUtils.swap(elements, secondPos, right);
        }
        if (firstPos != left) {
          ArrayUtils.swap(elements, firstPos, left);
        }
      }
    }

    default -> throw new IllegalStateException("Unexpected value: " + pivotStrategy);
  }
}
Den vollständigen Quellcode findest du in der Datei DualPivotQuicksort.
Dual-Pivot Quicksort Performance
Kurz gesagt: Dual-Pivot Quicksort ist bei einer Viertelmilliarde Elemente 3,7 % schneller als reguläres Quicksort – weniger, als der zusätzliche Aufwand im Code vermuten lässt. Deutlich mehr bringt erst die Kombination mit Insertion Sort, die ich im nächsten Abschnitt zeige.
Die vollständigen Messwerte findest du im Abschnitt „Vergleich aller Quicksort-Optimierungen“.
Dual-Pivot Quicksort kombiniert mit Insertion Sort
Genau wie das reguläre Quicksort kann auch Dual-Pivot Quicksort mit Insertion Sort kombiniert werden. Die Quellcode-Änderungen entsprechen denen für das reguläre Quicksort (s. Abschnitt „Quicksort/Insertion Sort Quellcode“). Ich gehe daher hier nicht noch einmal im Detail darauf ein.
Den Quellcode findest du in DualPivotQuicksortImproved.
Das Programm CompareImprovedDualPivotQuicksort testet den Algorithmus für verschiedene Grenzwerte für das Umschalten auf Insertion Sort.
Hier sind die Messwerte als Diagramm:
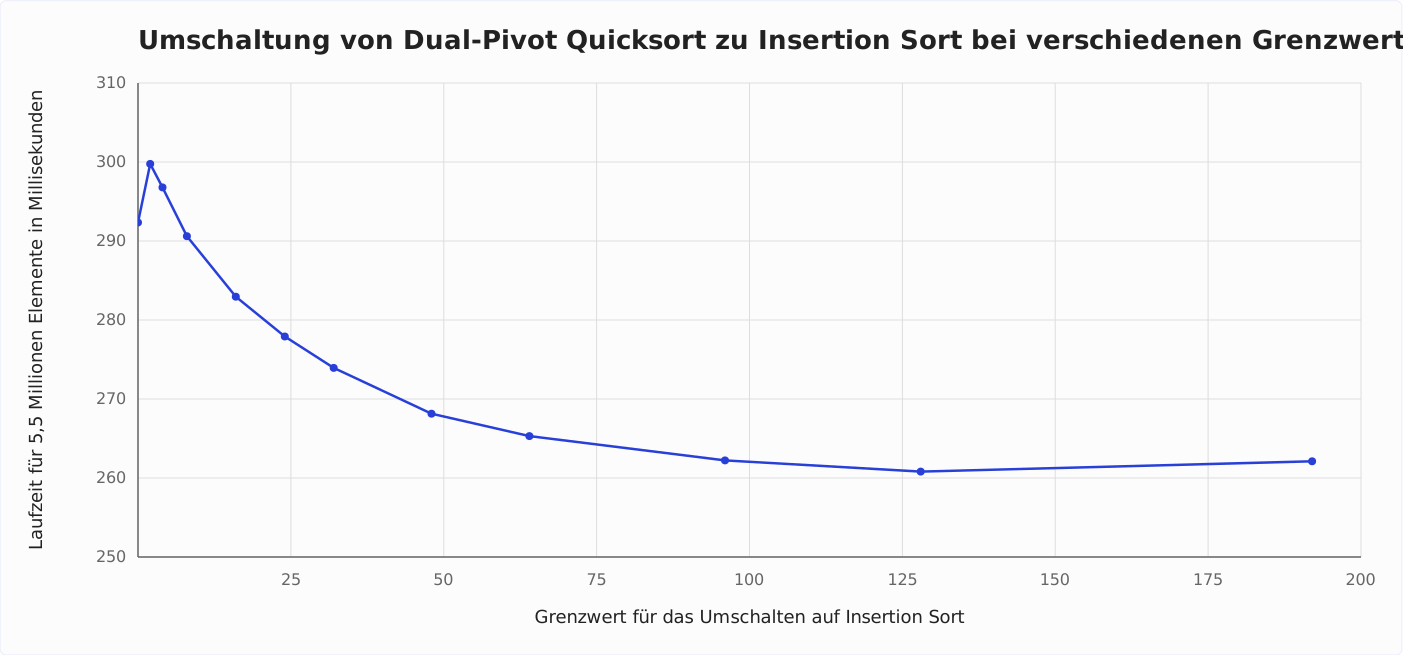
Es lohnt sich also, bei Dual-Pivot Quicksort (Sub-)Arrays mit 128 Elementen oder weniger mit Insertion Sort zu sortieren: 292,3 ms ohne Insertion Sort gegenüber 260,8 ms mit – gut 10 % schneller.
Vergleich aller Quicksort-Optimierungen
Mit dem in Abschnitt „Java Quicksort Laufzeit“ erwähnten UltimateTest vergleiche ich abschließend noch einmal die Performance folgender Algorithmen:
- Reguläres Quicksort mit Pivot-Strategie „Mittleres Element“,
- Quicksort kombiniert mit Insertion Sort und einem Schwellwert von 96,
- Dual-Pivot Quicksort mit Pivot-Strategie „Elemente an den Positionen ein Drittel und zwei Drittel“,
- Dual-Pivot Quicksort kombiniert mit Insertion Sort und einem Schwellwert von 128,
Arrays.sort()des JDK (die JDK-Entwickler:innen haben ihren Dual-Pivot Quicksort-Algorithmus so weit optimiert, dass es sich bei diesem schon bei 44 Elementen lohnt, auf Insertion Sort umzuschalten).
Das Ergebnis siehst du in folgendem Diagramm:
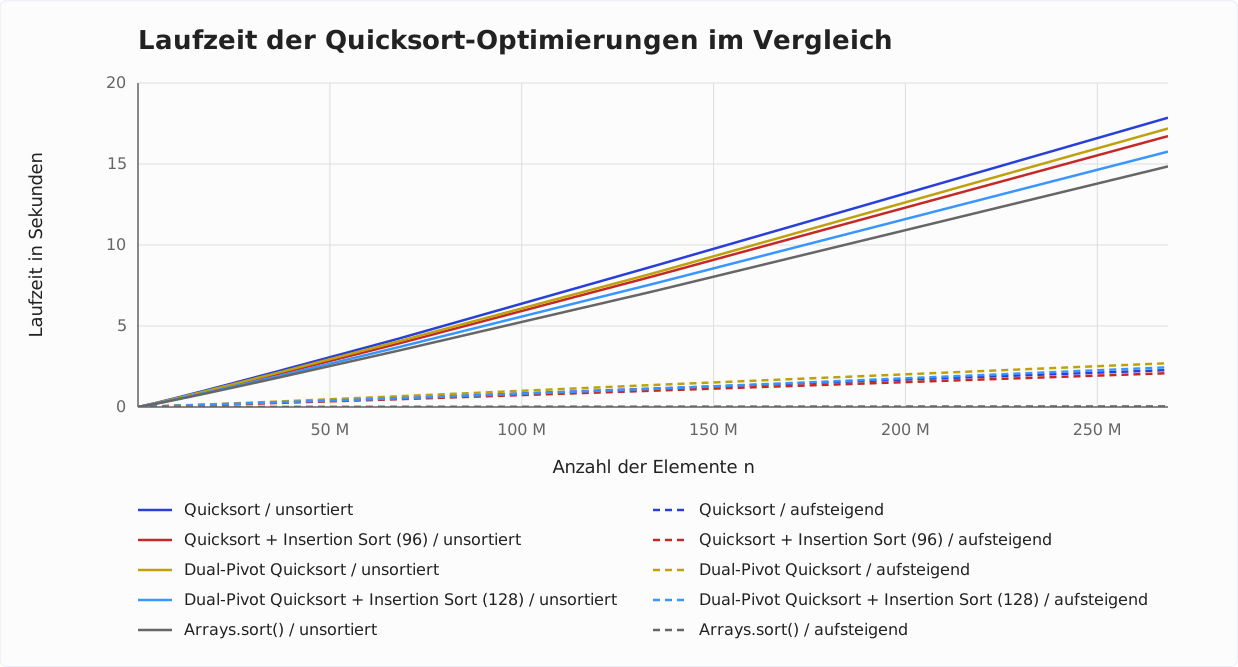
Zunächst einmal ist sehr schön der quasilineare Aufwand aller Varianten zu erkennen.
Die Performance von Dual-Pivot Quicksort ist etwas besser als die des regulären Quicksort – bei einer Viertelmilliarde Elemente 3,7 %. Deutlich mehr bringen die Kombinationen mit Insertion Sort: Dual-Pivot Quicksort mit Insertion Sort liegt 11,7 % vor dem regulären Quicksort und ist damit die schnellste Eigenimplementierung.
An die Sortiermethode des JDK kommen die Eigenimplementierungen aber nicht ganz heran – es fehlen etwa 6 %. Die JDK-Methode wurde im Laufe der Jahre hoch optimiert; was sie alles tut, steht im Abschnitt „Was Arrays.sort() daraus gemacht hat“.
Außerdem ist gut zu erkennen, dass alle Varianten vorsortierte Daten deutlich schneller sortieren als unsortierte – beim regulären Quicksort etwa um den Faktor 8. Am größten ist der Unterschied bei Arrays.sort(): 36,8 ms für eine Viertelmilliarde vorsortierter Elemente, gegenüber 14,9 Sekunden für unsortierte. Die Methode sortiert hier nicht, sie erkennt die bereits sortierten Läufe und fügt sie zusammen – die Optimierung, die oben beschrieben ist. Die zugehörige Linie im Diagramm liegt praktisch auf der Null-Linie.
Quicksort vs. Mergesort
Einen Vergleich der Laufzeiten von Quicksort und Mergesort findest du im Artikel über Mergesort.
Zusammenfassung
Quicksort ist ein effizienter, instabiler Sortieralgorithmus mit einer Zeitkomplexität von O(n log n) im best und average case und O(n²) im worst case.
Der worst case tritt in zwei Fällen ein: bei vorsortierten Eingabedaten (dagegen hilft die Pivot-Strategie) und bei sehr vielen gleichen Elementen (dagegen hilft nur eine 3-Wege-Partitionierung). Wer die Garantie braucht, kombiniert Quicksort per Introsort mit Heapsort.
Für sehr kleine n ist Quicksort langsamer als Insertion Sort und wird daher in der Praxis in der Regel mit Insertion Sort kombiniert.
Die Methode Arrays.sort() im JDK sortiert primitive Arrays mit einer Dual-Pivot Quicksort-Implementierung, die (Teil-)Arrays mit weniger als 44 Elementen an Insertion Sort abgibt, bei zu tiefer Rekursion auf Heapsort umschaltet und vorsortierte Bereiche mergt statt sie zu partitionieren. Objekt-Arrays sortiert sie dagegen mit Timsort.
Weitere Sortieralgorithmen findest du in der Übersicht aller Sortieralgorithmen und ihrer Eigenschaften im ersten Teil der Artikelserie.
War dieser Artikel hilfreich für dich? Dann freue ich mich, wenn du dir kurz Zeit für eine Bewertung auf meinem ProvenExpert-Profil nimmst.
Wenn du informiert werden möchtest, sobald der nächste Artikel erscheint, klicke hier und trage dich für den HappyCoders-Newsletter ein.